Ton agent vient de produire trois plans de réapprovisionnement. Personne ne les relira avant leur exécution : quelqu’un, ou quelque chose, doit trancher lequel est assez bon pour partir. Dans l’approche « LLM as a judge », ce quelque chose est un second appel à un modèle de langage, assis cette fois dans le fauteuil du juge. À la fin de cet article, tu sauras définir cette approche, dire ce qu’on remet au juge pour qu’il décide, repérer les postes où on l’emploie et savoir quand ne pas lui faire confiance.
Sommaire
- L’essentiel en 30 secondes
- Un LLM au tribunal : la définition
- Pourquoi un juge plutôt qu’une formule ou une armée de relecteurs
- Ce qu’on pose sur le bureau du juge
- Un juge au travail : le critique d’une chaîne logistique
- Cinq fauteuils pour un même juge
- Deux idées reçues sur le juge
L’essentiel en 30 secondes
- Le « LLM as a judge » consiste à confier la notation à un LLM : il examine une sortie et rend un verdict.
- Le juge reçoit un dossier précis : la sortie, une grille de critères, des exemples, parfois une vérité terrain, et un seuil.
- Son verdict prend une forme au choix : une note, une étiquette ou une récompense, selon ce que le système en fait.
- Le même rôle se retrouve à cinq postes différents, du choix d’un modèle à la récompense d’un agent.
- Le juge reste faillible : il manque les cas rares, et seuls des humains tranchent la créativité ou le biais.
Un LLM au tribunal : la définition
Un LLM as a judge, littéralement un « LLM comme juge », est un LLM à qui l’on demande d’examiner une sortie et de dire ce qu’il en pense, là où l’on aurait fait calculer un score ou relire une personne. On la rencontre d’abord dans l’évaluation d’un système RAG : on dispose en général d’un jeu de questions avec leur vérité terrain, et le juge dit si le pipeline a trouvé les étapes nécessaires et si la réponse générée est correcte.
Cette façon d’évaluer est récente : à côté de l’évaluation de la réponse « comme une tâche de classification », on a vu apparaître depuis peu l’idée de prendre un LLM comme juge du pipeline entier.
💡 Intuition Le juge ne rédige pas la réponse, il la lit et la note. Rien n’oblige à lui donner un modèle d’une autre espèce : on peut vérifier la cohérence d’un agent avec le même modèle, ou avec un modèle voisin.
Garde l’image du tribunal pour la suite : un juge, et en dernier recours une cour d’appel humaine.
Pourquoi un juge plutôt qu’une formule ou une armée de relecteurs
Prends un agent de support qui traite la demande de remboursement d’une tasse fêlée, commande A89268. Un bon contrôle : il demande toujours une photo du dommage avant d’invoquer l’outil issue_refund, même quand le client reformule, et il ne se contredit pas quand la conversation glisse du remboursement à l’annulation de commande. Ce genre de vérification ne se calcule pas avec une formule.
C’est là que l’évaluation par LLM trouve sa place : on demande au même modèle, ou à un modèle voisin, de vérifier la cohérence, avec quelques exemples de réponses cohérentes et pertinentes. L’intérêt est le passage à l’échelle, que des relecteurs humains seuls n’assurent pas.
Les métriques automatiques classiques ont aussi leurs angles morts. Un score unique, comme la correspondance exacte avec une référence, peut favoriser des sorties formulaïques ou peu naturelles qui manquent l’intention réelle ; et pour la génération ouverte, difficile à évaluer par des métriques standard, on se rabat sur l’inspection manuelle ou sur un LLM juge.
Le problème est plus aigu avec les LLM : détecter des hallucinations ou des contenus inappropriés est bien plus difficile que mesurer une exactitude, et c’est dans ce vide que le juge LLM s’installe.
Ce qu’on pose sur le bureau du juge
Un juge sans dossier n’a rien à juger. Dans les montages décrits, le dossier contient à peu près les mêmes pièces :
- la sortie à examiner : une réponse, un plan ou une action candidate ;
- une grille de critères fixée à l’avance, comme l’exactitude, la complétude et le ton pour une réponse, ou la faisabilité, le coût et le risque pour un plan ;
- quelques exemples de sorties jugées cohérentes et pertinentes ;
- si on en possède une, une vérité terrain à laquelle comparer ;
- un seuil de qualité, au-delà duquel la sortie est acceptée.
Ce que le juge rend dépend de ce que le système veut en faire. Trois formes reviennent :
| Forme du verdict | Exemple | Ce que le système en fait |
|---|---|---|
| Une note | une fidélité entre 0 et 1 ; un score de 1 à 10 | mesurer, ou comparer à un seuil |
| Une étiquette | un texte jugé « sûr » ou « non sûr » | classer une entrée ou une sortie |
| Une récompense ou une pénalité | le comportement d’un agent évalué pendant son entraînement | guider son apprentissage |
Les notes de type « métrique » se multiplient dans l’évaluation d’un système RAG. La fidélité mesure la cohérence factuelle de la réponse, entre 0 et 1 ; la précision du contexte regarde si les éléments pertinents remontent en haut du contexte ; le rappel des entités examine le rappel du contexte en se concentrant sur les entités. Chacune pose une question distincte au juge.
Un juge au travail : le critique d’une chaîne logistique
Comment faire noter trois plans par un LLM, puis renvoyer ses remarques à celui qui les a écrits ? Dans un montage dit acteur-critique, un premier appel génère des candidats (réponses, plans, actions) et un second, le critique, accepte ou rejette chacun selon une grille prédéfinie. Seul ce second appel nous intéresse ici : c’est lui le juge.
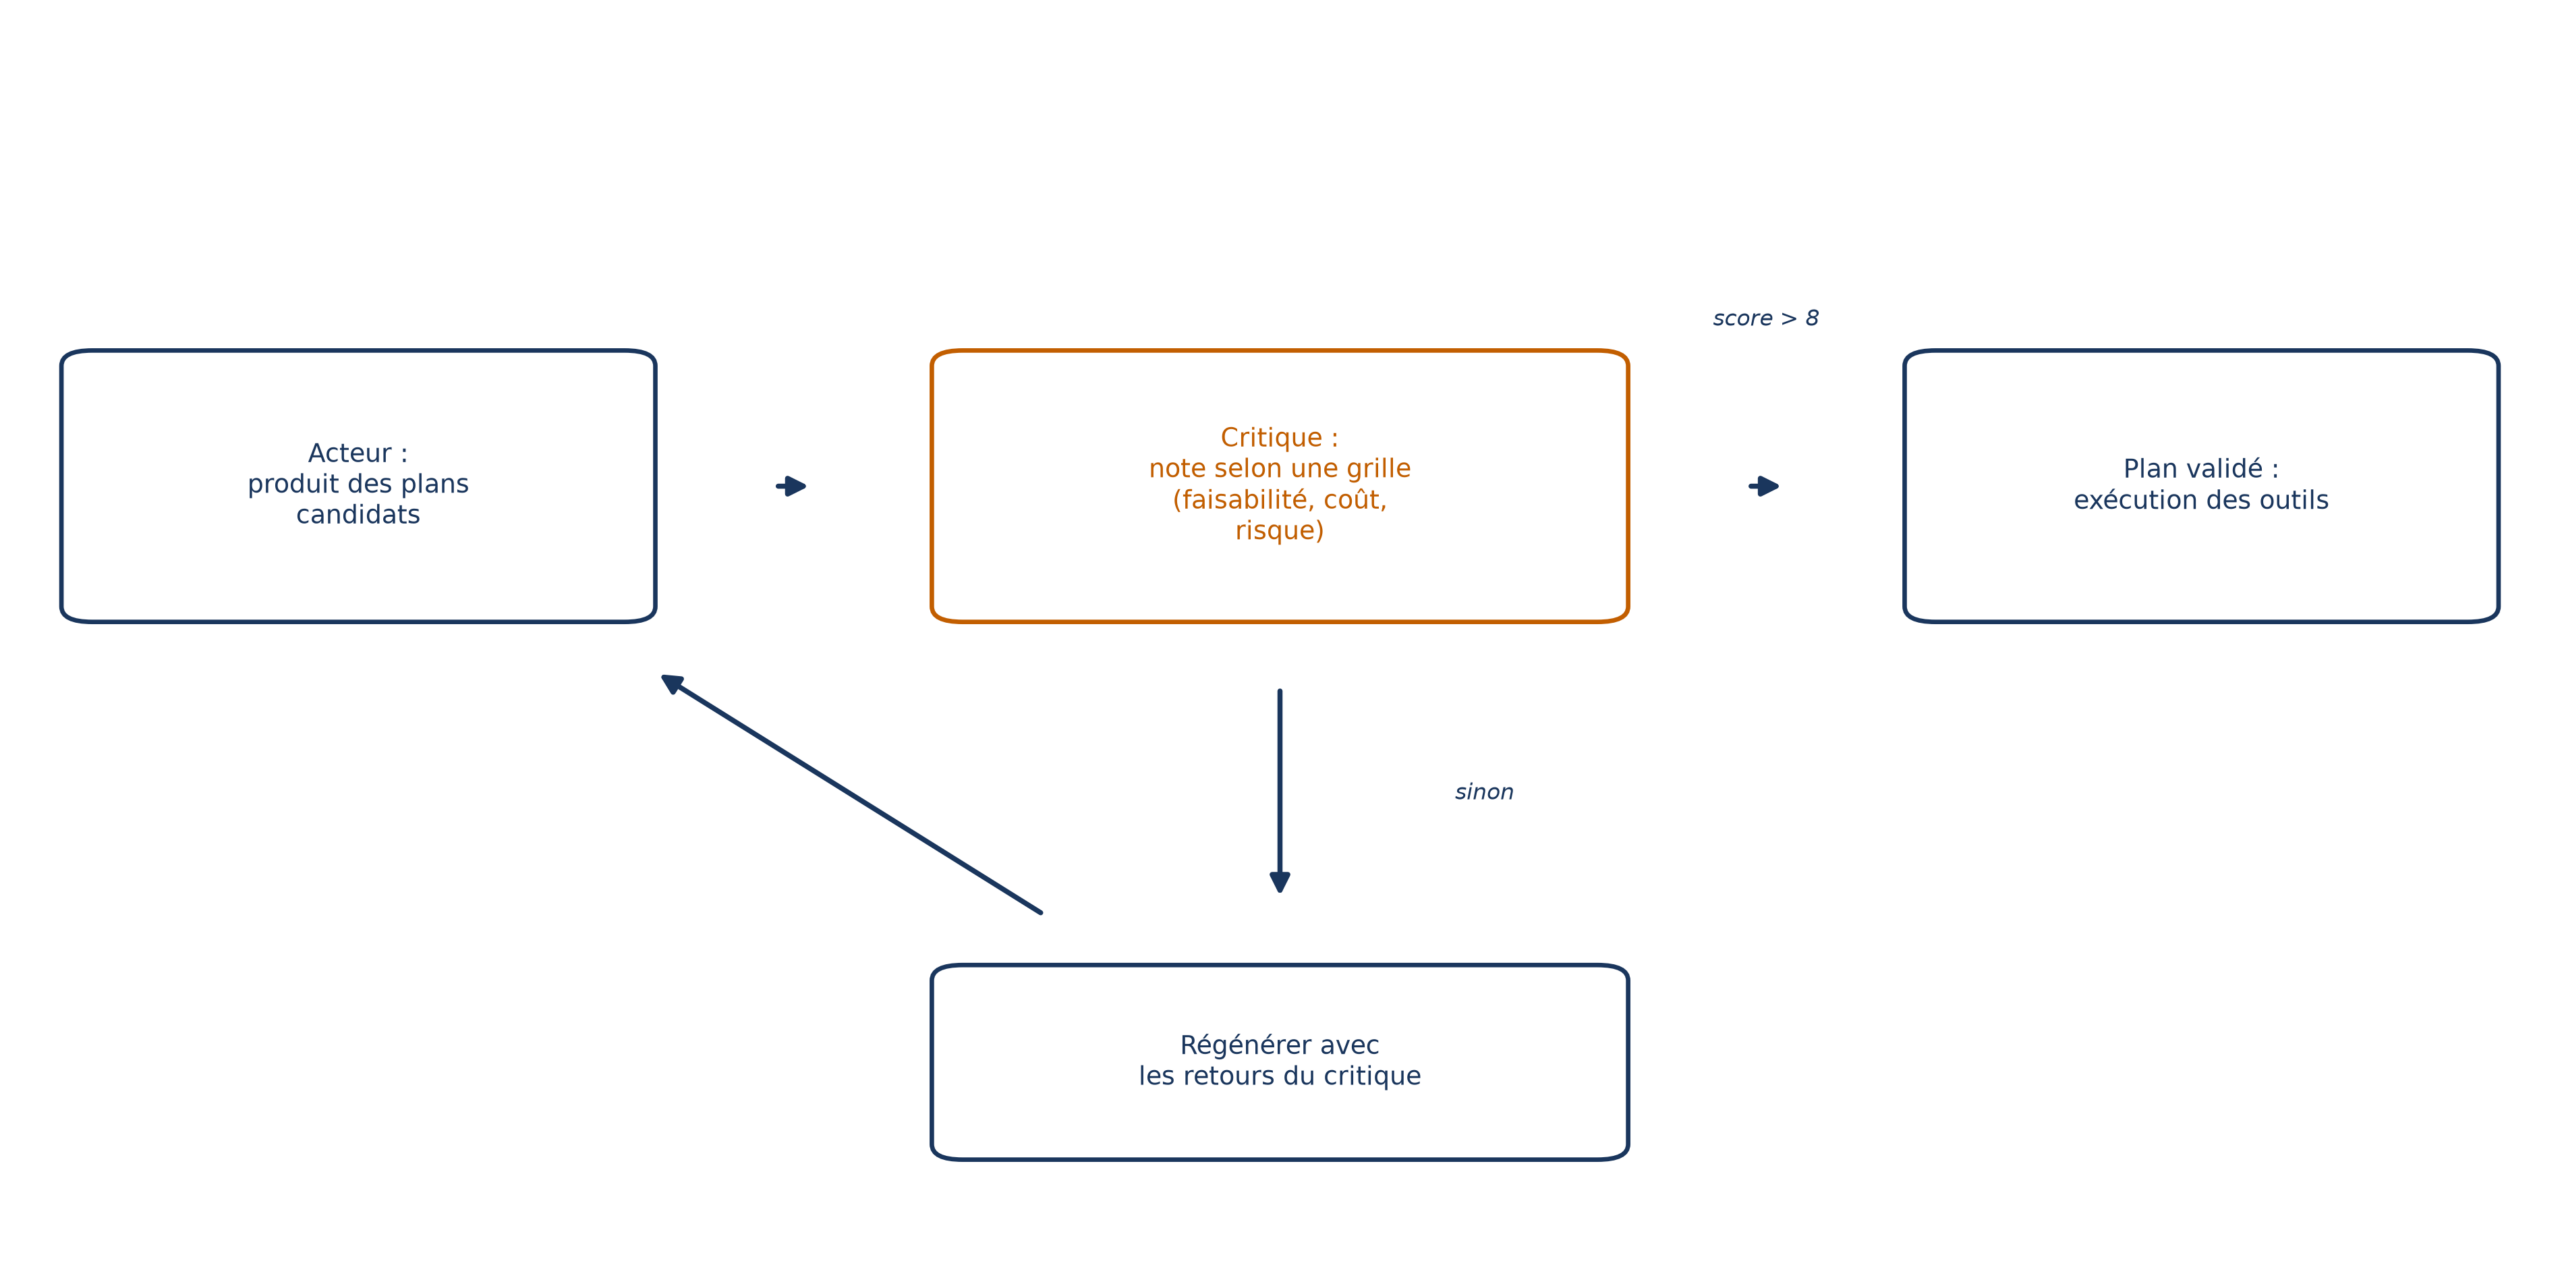
Voici le code de cet exemple de chaîne logistique, où l’acteur génère des plans de réapprovisionnement. Dans ce code, llm est le modèle de langage de l’exemple, AgentState l’état partagé entre les deux nœuds et send_fn l’outil qui envoie le plan retenu.
# Actor Node: Generates candidate plans
def actor_node(state: AgentState):
   history = state["messages"]
   actor_prompt = '''Generate 3 candidate supply chain plans
     as JSON list: [{'plan': 'description', 'tools': [...]}]'''
   response = llm.invoke([SystemMessage(content=actor_prompt)] + history)
   state["candidates"] = json.loads(response.content)
   return state

# Critic Node: Evaluates and selects/iterates
def critic_node(state: AgentState):
   candidates = state["candidates"]
   history = state["messages"]
   critic_prompt = f'''Score candidates {candidates} on scale
    1-10 for feasibility, cost, risk. Select the best if greater than
    8, else request regeneration.'''
   response = llm.invoke([SystemMessage(content=critic_prompt)] + history)
   eval = json.loads(response.content)
   if eval['best_score'] > 8:
       winning_plan = eval['selected']
       # Execute winning plan's tools (similar to specialist execution)
       messages = []
       ...
       # Send response
       send_fn.invoke({"message": winning_plan['plan']})
       return {"messages": history + messages}
   else:
       # Iterate: Add feedback to history for actor

       return {"messages": history +
               [AIMessage(content="Regenerate with improvements: " +
                eval['feedback'])]}
Tout le travail de juge tient dans critic_prompt : une échelle de 1 à 10, trois critères (faisabilité, coût, risque) et une règle de décision, garder le meilleur plan s’il dépasse 8 et sinon demander une régénération. Le code lit la réponse du critique comme un JSON : si best_score dépasse 8, le plan sélectionné part à l’exécution ; sinon, le champ feedback repart vers l’acteur avec la mention « Regenerate with improvements ».
📌 À retenir La grille et le seuil ne sont pas dans le modèle : ils sont écrits dans la consigne que tu lui donnes. Changer ce que le juge valorise revient à changer son texte.
Cinq fauteuils pour un même juge
Choisir un modèle
Quand tu hésites entre plusieurs LLM, un moyen simple de comparer la qualité des réponses est de demander à un modèle comme GPT-4, ou à tout modèle plus grand que ceux que tu testes, de les évaluer sur la qualité globale, l’exhaustivité et la véracité.
Tester avant de livrer
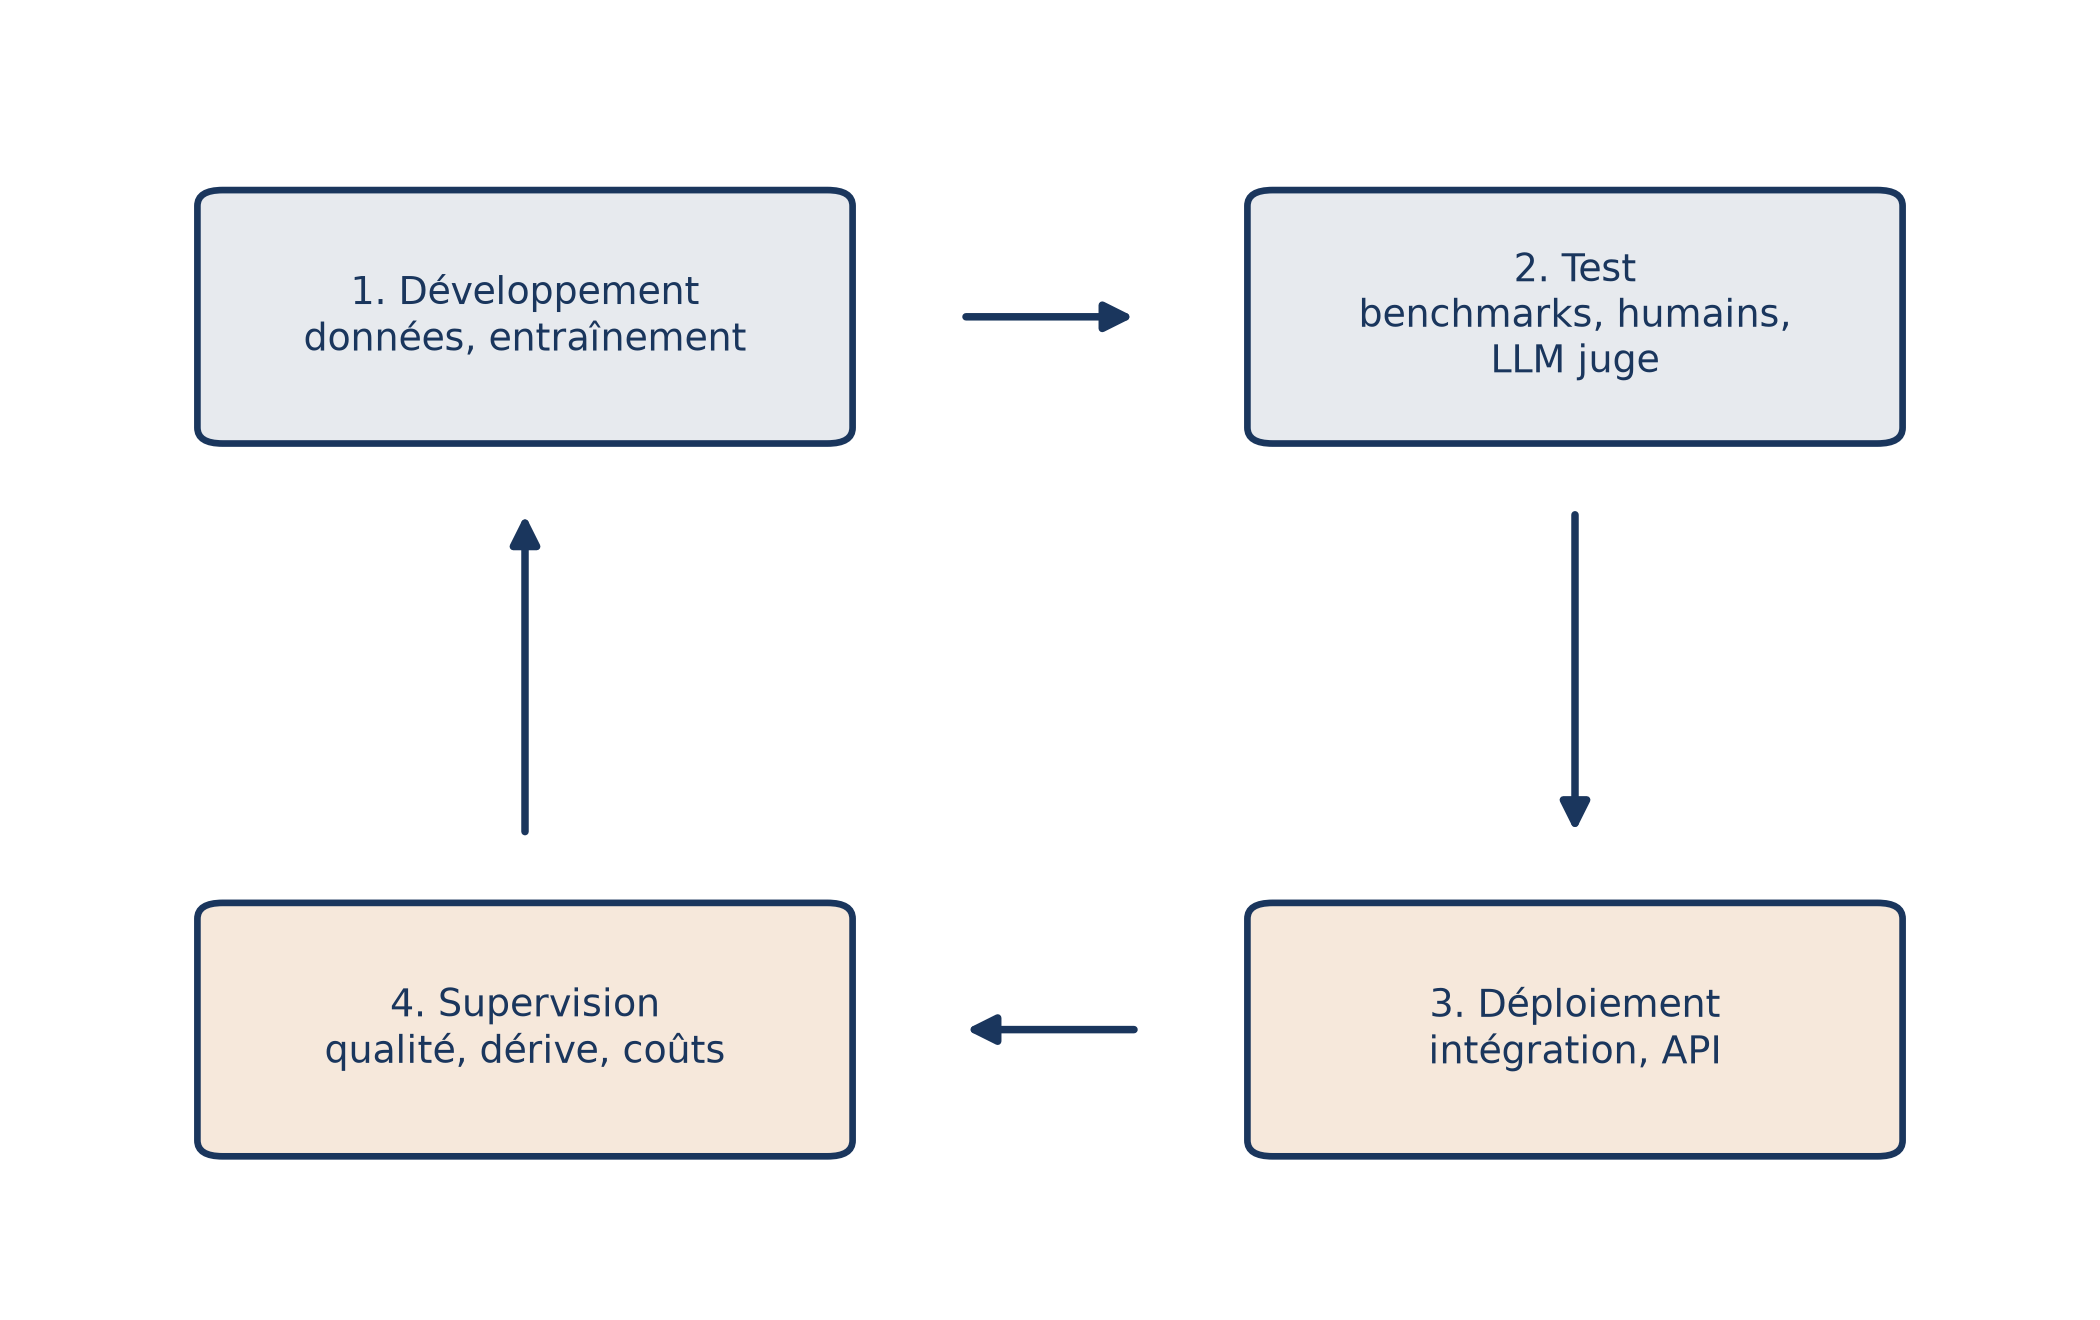
Les benchmarks standard couvrent les connaissances et la résolution de problèmes ; après l’ajustement d’un modèle, il faut évaluer le suivi d’instructions, la conversation et l’usage d’outils, et c’est là que l’inspection manuelle ou le LLM juge prennent le relais.
Vérifier un système RAG
C’est le cadre où l’approche a reçu son nom, avec les notes vues plus haut. Le juge confronte la réponse à la vérité terrain et au contexte récupéré, et chaque métrique lui pose une question séparée.
Garder la porte
Llama Guard examine l’entrée (par classification de prompts) et la sortie (par classification de réponses) pour juger si le texte est sûr ou non. Il emploie Llama 2 pour la classification, avec un LLM spécialement adapté comme juge : le fauteuil n’est donc pas réservé aux modèles généralistes.
La bibliothèque Hugging Face Evaluate en donne un autre exemple : pour étudier les biais d’un modèle, on change le genre dans un ensemble de prompts, puis un autre modèle, entraîné à cet effet, évalue la manière dont le premier les complète.
Distribuer les récompenses
Dans l’apprentissage par renforcement, un LLM peut jouer le modèle de récompense : par prompting direct, on lui donne des instructions pour évaluer le comportement d’un agent ou décider d’une récompense, ce qui imite le retour humain en temps réel. Il peut aussi écrire le code d’une fonction de récompense, ce qui rend le processus plus transparent.
Deux idées reçues sur le juge
« Si le juge approuve, c’est bon »
Un juge n’attrape que ce que son protocole de test lui fait voir. Les évaluations automatisées manquent des cas limites rares mais critiques, notamment ceux issus d’entrées ou d’interactions inédites : un agent peut réussir tous les tests standard et se comporter de façon imprévisible hors de la distribution du jeu de test.
« Le juge LLM remplace les relecteurs humains »
⚠️ Piège Seuls des humains jugent vraiment la créativité, le biais, la qualité et la présence de contenu inapproprié, même quand d’autres LLM vérifient à grande échelle. Le test d’un LLM exige donc un humain dans la boucle.
Et l’affaire ne se clôt pas au déploiement : le trafic peut croître, la langue et les connaissances évoluent (un LLM médical doit connaître les nouvelles thérapies), donc l’évaluation continue.
D’où la cour d’appel humaine : des experts relisent un échantillon des sorties pour en vérifier la justesse et la conformité éthique, et ils servent à calibrer les évaluations automatiques. Le juge LLM trie à grande échelle, l’humain garde le dernier mot.