Sur une boutique en ligne, une cliente tape « iPhone 16 » et veut exactement ce produit, pas un cousin approximatif. Un autre client écrit « téléphone de gamme moyenne avec un bon appareil photo » et n’a aucun nom de modèle en tête. Un moteur purement lexical peine sur la seconde requête, un moteur purement sémantique peut manquer la première. Voici ce que combine une recherche hybride, comment elle mélange deux listes de scores qui ne se comparent pas, et ce qu’elle laisse encore de côté.
Sommaire
- L’essentiel en 30 secondes
- Trois recherches, une même boutique
- Mots exacts ou sens : deux moteurs, deux angles morts
- La recherche hybride : deux recherches en parallèle, une fusion
- Fusionner deux scores qui ne parlent pas la même langue
- La fusion en code : deux manières de faire
- Où se loge la recherche hybride dans un pipeline
- Ce qu’elle ne fait pas : quatre idées reçues
L’essentiel en 30 secondes
- La recherche hybride lance deux recherches en parallèle, l’une par mots-clés et l’autre par sens, puis fusionne leurs résultats.
- Chaque moteur a un angle mort opposé : les mots exacts ratent les paraphrases, les vecteurs peuvent rater le terme précis.
- Les scores n’ont pas la même échelle : on les divise par leur maximum, puis on les mélange avec un poids α.
- Le poids α se règle autour de 0,3 à 0,5, et suffit à faire basculer un classement.
- Elle complète le sémantique sans le remplacer, et ne règle pas tout : certaines limites tiennent à la structure des données.
Trois recherches, une même boutique
Imagine un catalogue de plusieurs millions d’articles : électronique, mode, électroménager. Les clients y cherchent de trois façons, et chacune demande un talent différent.
- Le nom précis : « iPhone 16 ». Il faut retrouver ce mot, tel quel.
- La description vague : « téléphone de gamme moyenne avec un bon appareil photo ». Aucun mot du catalogue n’est garanti d’y figurer.
- La requête mixte : « iPhone à moins de 500 dollars ». Un nom précis et une contrainte à comprendre.
Une recherche lexicale comme BM25 a du mal avec les descriptions vagues. Une recherche sémantique peut au contraire passer à côté du produit exact. La recherche hybride réunit les deux talents : BM25 privilégie les correspondances exactes comme « iPhone », la recherche sémantique capte le sens d’une phrase comme « téléphone avec un bon appareil photo ». Elle sert alors les trois cas à la fois.
Mots exacts ou sens : deux moteurs, deux angles morts
Le moteur qui lit les lettres
La recherche par mots-clés cherche une correspondance exacte avec certains termes. Elle brille sur les termes précis (noms de produits ou d’entreprises, jargon sectoriel), mais elle est sensible aux fautes de frappe et aux synonymes, et ne saisit pas le contexte.
Sous le capot, elle repose sur un index inversé. Le texte est prétraité (découpé en mots, passé en minuscules, ramené à la racine des mots, débarrassé des mots vides), puis chaque terme est relié à la liste des passages où il apparaît. Plutôt que de relire toute la base, on suit la liste du terme recherché. Pour classer, BM25 pèse la fréquence du terme dans le passage, sa rareté dans l’ensemble du corpus et la longueur du passage. On dit qu’il produit une représentation creuse, par opposition aux vecteurs denses des modèles de type Transformer que nous verrons plus bas.
Que renvoie un tel moteur quand on lui pose une vraie question ? Voici un index BM25 sur trois répliques, interrogé par « Who is a recruit? ». corpus contient les trois phrases découpées en mots, bm25 est l’index construit dessus, et get_top_n renvoie les deux meilleures lignes.
# pip install rank_bm25

from rank_bm25 import BM25Okapi
from typing import List

corpus: List[List[str]] = [
    "Agent J is the fresh recruit with attitude".split(),
    "Agent K has years of MIB experience and a cool neuralyzer".split(),
    "The galaxy is saved by two Agents in black suits".split(),
]
# 2. Build the BM25 index
bm25 = BM25Okapi(corpus)

# 3. Perform retrieval for a fun query
query = "Who is a recruit?".split()
top_n = bm25.get_top_n(query, corpus, n=2)

print("Query:", " ".join(query))
print("Top matching lines:")
for line in top_n:
    print(" •", " ".join(line))
Cette approche est excellente pour repérer des termes exacts ou très spécifiques. Elle peut en revanche manquer les paraphrases et les liens conceptuels qui ne sont pas écrits dans le texte d’origine.
Le moteur qui lit le sens
La recherche sémantique cherche à comprendre le contexte et l’intention d’une requête : elle renvoie des résultats pertinents même s’ils ne contiennent pas les termes exacts. Son socle, ce sont les embeddings, des représentations vectorielles qui rangent les mots de sens voisin à faible distance les uns des autres.
Ces vecteurs sont petits, faits de nombres réels (denses) et gardent l’information de contexte. Mais le revers est symétrique : la recherche vectorielle trouve le sens d’une requête sans retrouver les termes exacts, parfois essentiels, par exemple en marketing.
| Par mots-clés (BM25) | Par sens (vecteurs) | |
|---|---|---|
| Ce qu’elle compare | Les termes de la requête, à l’identique | La proximité de sens |
| Représentation | Creuse | Dense |
| Forte sur | Noms de produits ou d’entreprises, jargon | Synonymes, paraphrases, intention |
| Faible sur | Fautes de frappe, synonymes, contexte | Termes exacts |
La recherche hybride : deux recherches en parallèle, une fusion
La recherche vectorielle seule est déjà un net progrès par rapport à la simple recherche plein texte, mais elle ne suffit généralement pas à garantir la qualité, la précision et la performance attendues en production. La recherche hybride exécute donc en parallèle une recherche vectorielle et une recherche plein texte, puis fusionne leurs résultats.
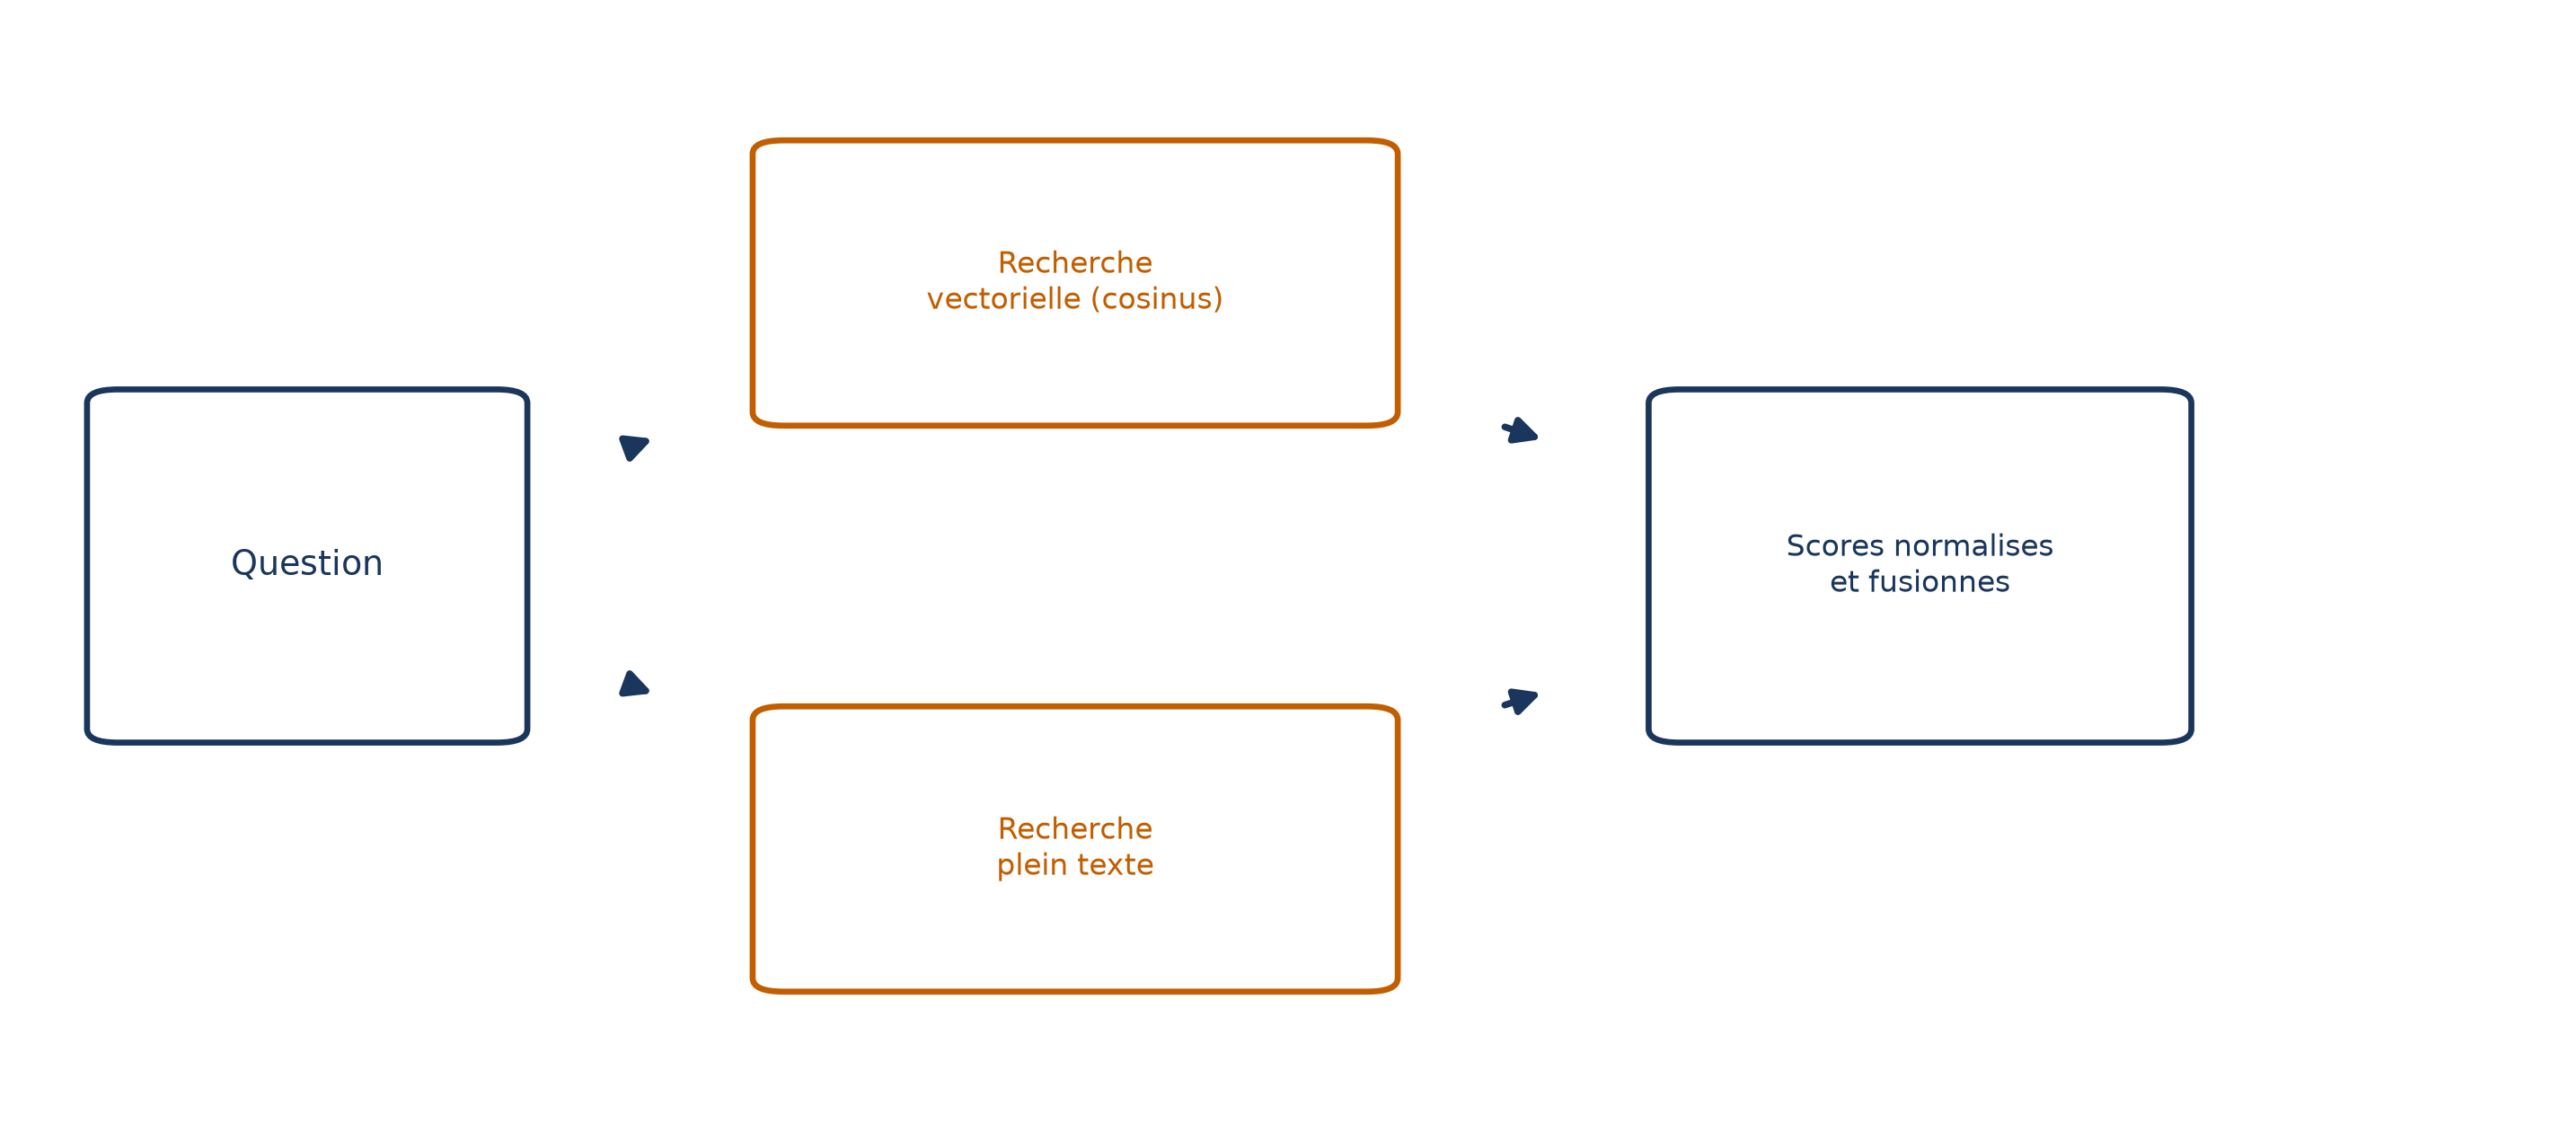
Le mélange ne se limite pas à deux méthodes. On peut aussi combiner des embeddings creux, des embeddings denses et une recherche par graphe, en fusionnant les résultats selon une pondération adaptée aux besoins de précision et de rappel.
Fusionner deux scores qui ne parlent pas la même langue
Une difficulté saute aux yeux : les deux recherches ne notent pas sur la même échelle.
💡 Intuition Deux juges notent le même plat, l’un sur 10 et l’autre sur 1 000. Additionner leurs notes brutes revient à n’écouter que le second. Pour que leurs voix comptent autant, on ramène d’abord les deux notes à une règle commune.
La première réponse consiste à diviser chaque score par le maximum de sa propre recherche. Le meilleur résultat de chaque liste reçoit alors 1, et tous les autres se situent entre 0 et 1.
La seconde est de pondérer. Le score final est une moyenne pondérée des deux scores, avec un hyperparamètre α :
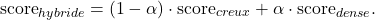
Ici  est le score de la recherche par mots-clés (BM25),
 celui de la recherche vectorielle, et α, compris entre 0 et 1, règle l’importance relative du côté dense. Avec α = 0, seule la recherche par mots-clés compte ; avec α = 1, seule la recherche vectorielle.
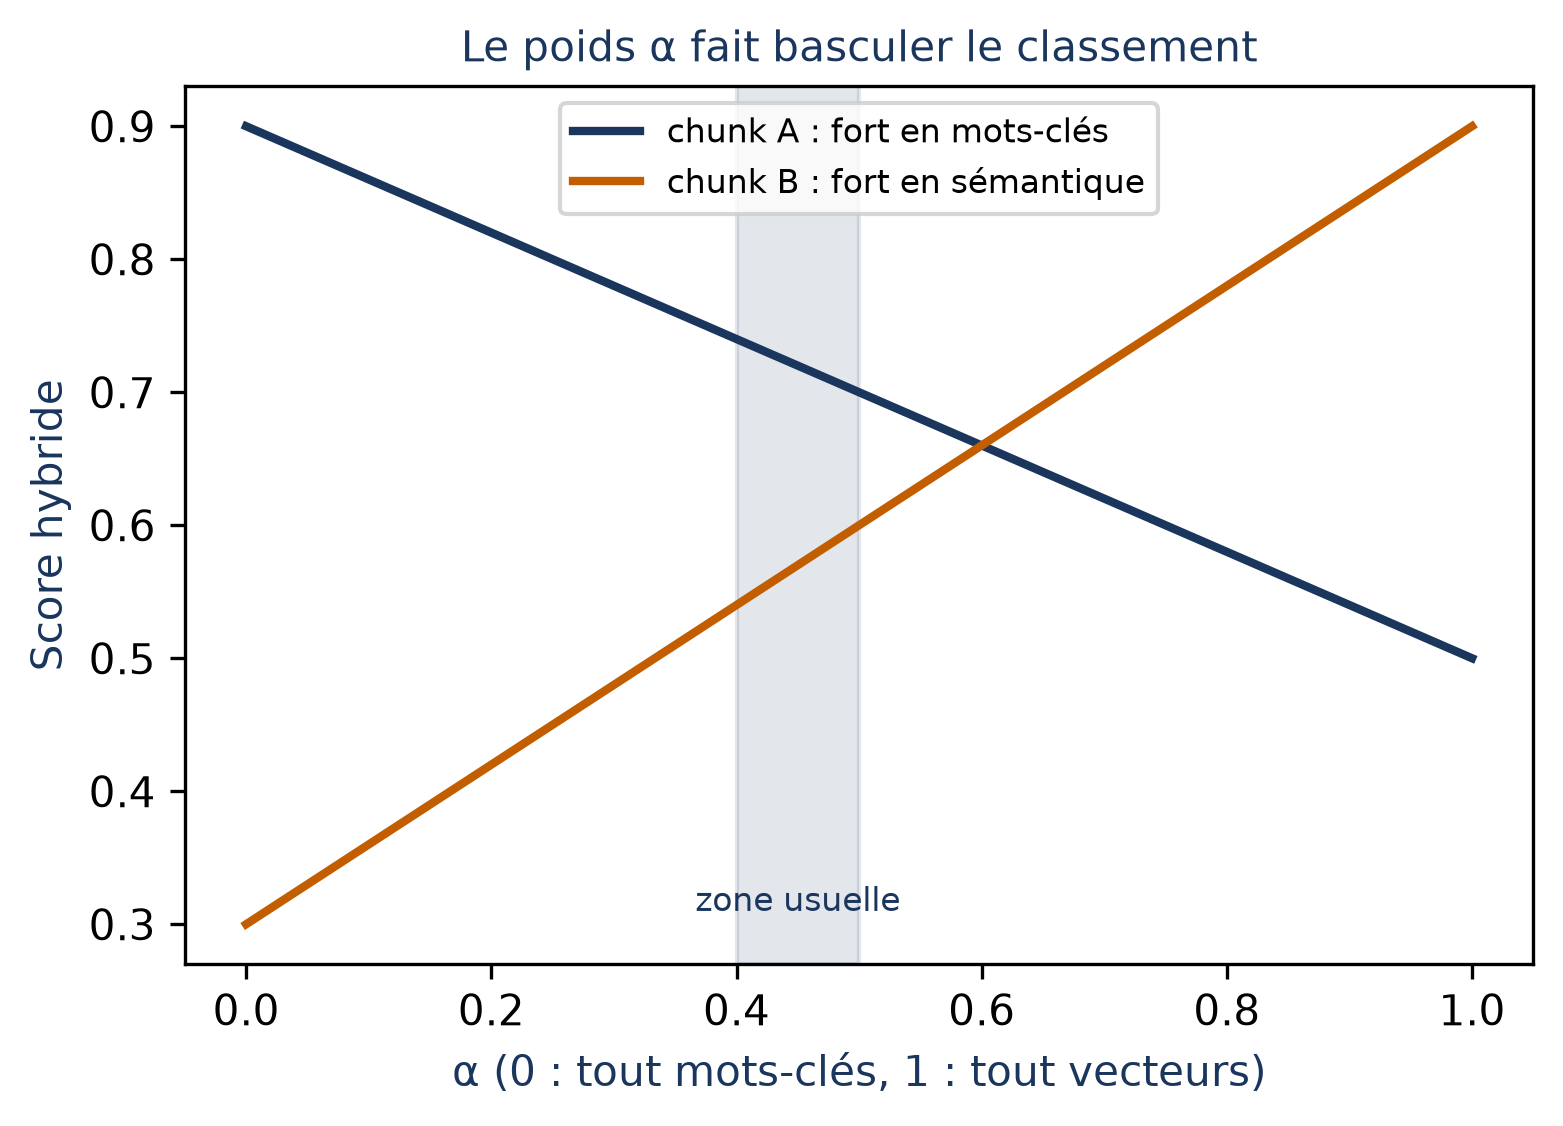
En pratique, on rencontre le plus souvent des valeurs de 0,4 ou 0,5, parfois 0,3. Ce n’est pas anodin : le poids suffit à renverser un classement.
La fusion en code : deux manières de faire
Comment obtenir cela dans une vraie base ? Voici deux façons, qui ne fusionnent pas de la même manière.
Noter puis trier ensemble (Neo4j)
Pour qu’une base de graphe fasse de la recherche par mots-clés sur le texte de ses fragments, il faut d’abord créer un index plein texte sur leur propriété text.
driver.execute_query("CREATE FULLTEXT INDEX PdfChunkFulltext FOR (c:Chunk)
ON EACH [c.text]")
La requête de fusion lance ensuite les deux recherches. La première interroge l’index vectoriel nommé pdf avec l’embedding de la question ; la seconde, l’index plein texte avec le texte de la question. Dans chacune, les scores sont divisés par leur maximum.  question_embedding
$question sont les paramètres que l’application transmet à la requête.
CALL {
    // vector index
    CALL db.index.vector.queryNodes('pdf', $k, $question_embedding)
YIELD node, score
    WITH collect({node:node, score:score}) AS nodes, max(score) AS max
    UNWIND nodes AS n
    // Normalize scores
    RETURN n.node AS node, (n.score / max) AS score
    UNION
    // keyword index
    CALL db.index.fulltext.queryNodes('ftPdfChunk', $question, {limit: $k})
    YIELD node, score
    WITH collect({node:node, score:score}) AS nodes, max(score) AS max
    UNWIND nodes AS n
    // Normalize scores
    RETURN n.node AS node, (n.score / max) AS score
}
// deduplicate nodes
WITH node, max(score) AS score ORDER BY score DESC LIMIT $k
RETURN node, score
UNION met les deux listes bout à bout, puis la dernière ligne garde le meilleur score de chaque fragment trouvé par les deux recherches, trie et coupe aux k premiers. Un fragment repéré par les deux moteurs n’apparaît donc qu’une fois, avec sa meilleure note.
⚠️ Piège Dans cette requête, l’index plein texte s’appelle
ftPdfChunk, alors que la commande précédente en crée un nomméPdfChunkFulltext. Garde le nom de l’index que tu as réellement créé, sinon la seconde recherche échoue.
Rassembler d’abord (Elasticsearch et ChromaDB)
Seconde façon, avec deux systèmes distincts : une base vectorielle ChromaDB d’un côté, Elasticsearch pour le plein texte de l’autre. La fonction ci-dessous prend une requête et un top_k. Elle s’appuie sur des objets préparés en amont : sentence_model (l’encodeur), collection (la collection ChromaDB), documents (les textes indexés), es (le client Elasticsearch) et index_name (son index).
def fusion_retrieval(query, top_k=5):
    """
    Retrieves the top_k most relevant documents using a combination of
vector-based
    and textual retrieval methods.
    Args:
        query (str): The search query.
        top_k (int): The number of top documents to retrieve.
    Returns:
        list: A list of combined results from both vector and textual
retrieval methods.
    """
    query_embedding = sentence_model.encode(query).tolist()
    vector_results = collection.query(query_embeddings=[query_
embedding], n_results=min(top_k, len(documents)))
    es_body = {
        "size": top_k,  # Move size into body
        "query": {
            "match": {
                "content": query
            }
        }
    }
    es_results = es.search(index=index_name, body=es_body)
    es_documents = [hit["_source"]["content"] for hit in es_
results['hits']['hits']]
    combined_results = vector_results['documents'][0] + es_documents
    return combined_results
Compare avec la requête précédente. Ici, la dernière ligne ne calcule aucun score commun : elle ajoute simplement la liste textuelle à la liste vectorielle. La fusion est une mise bout à bout, sans normalisation, et le classement final reste à faire ailleurs.
Où se loge la recherche hybride dans un pipeline
Dans un pipeline de recherche avancé, elle occupe l’étage « récupération et post-traitement », après la transformation et le routage de la requête, et avant le reranking et la compression du contexte.
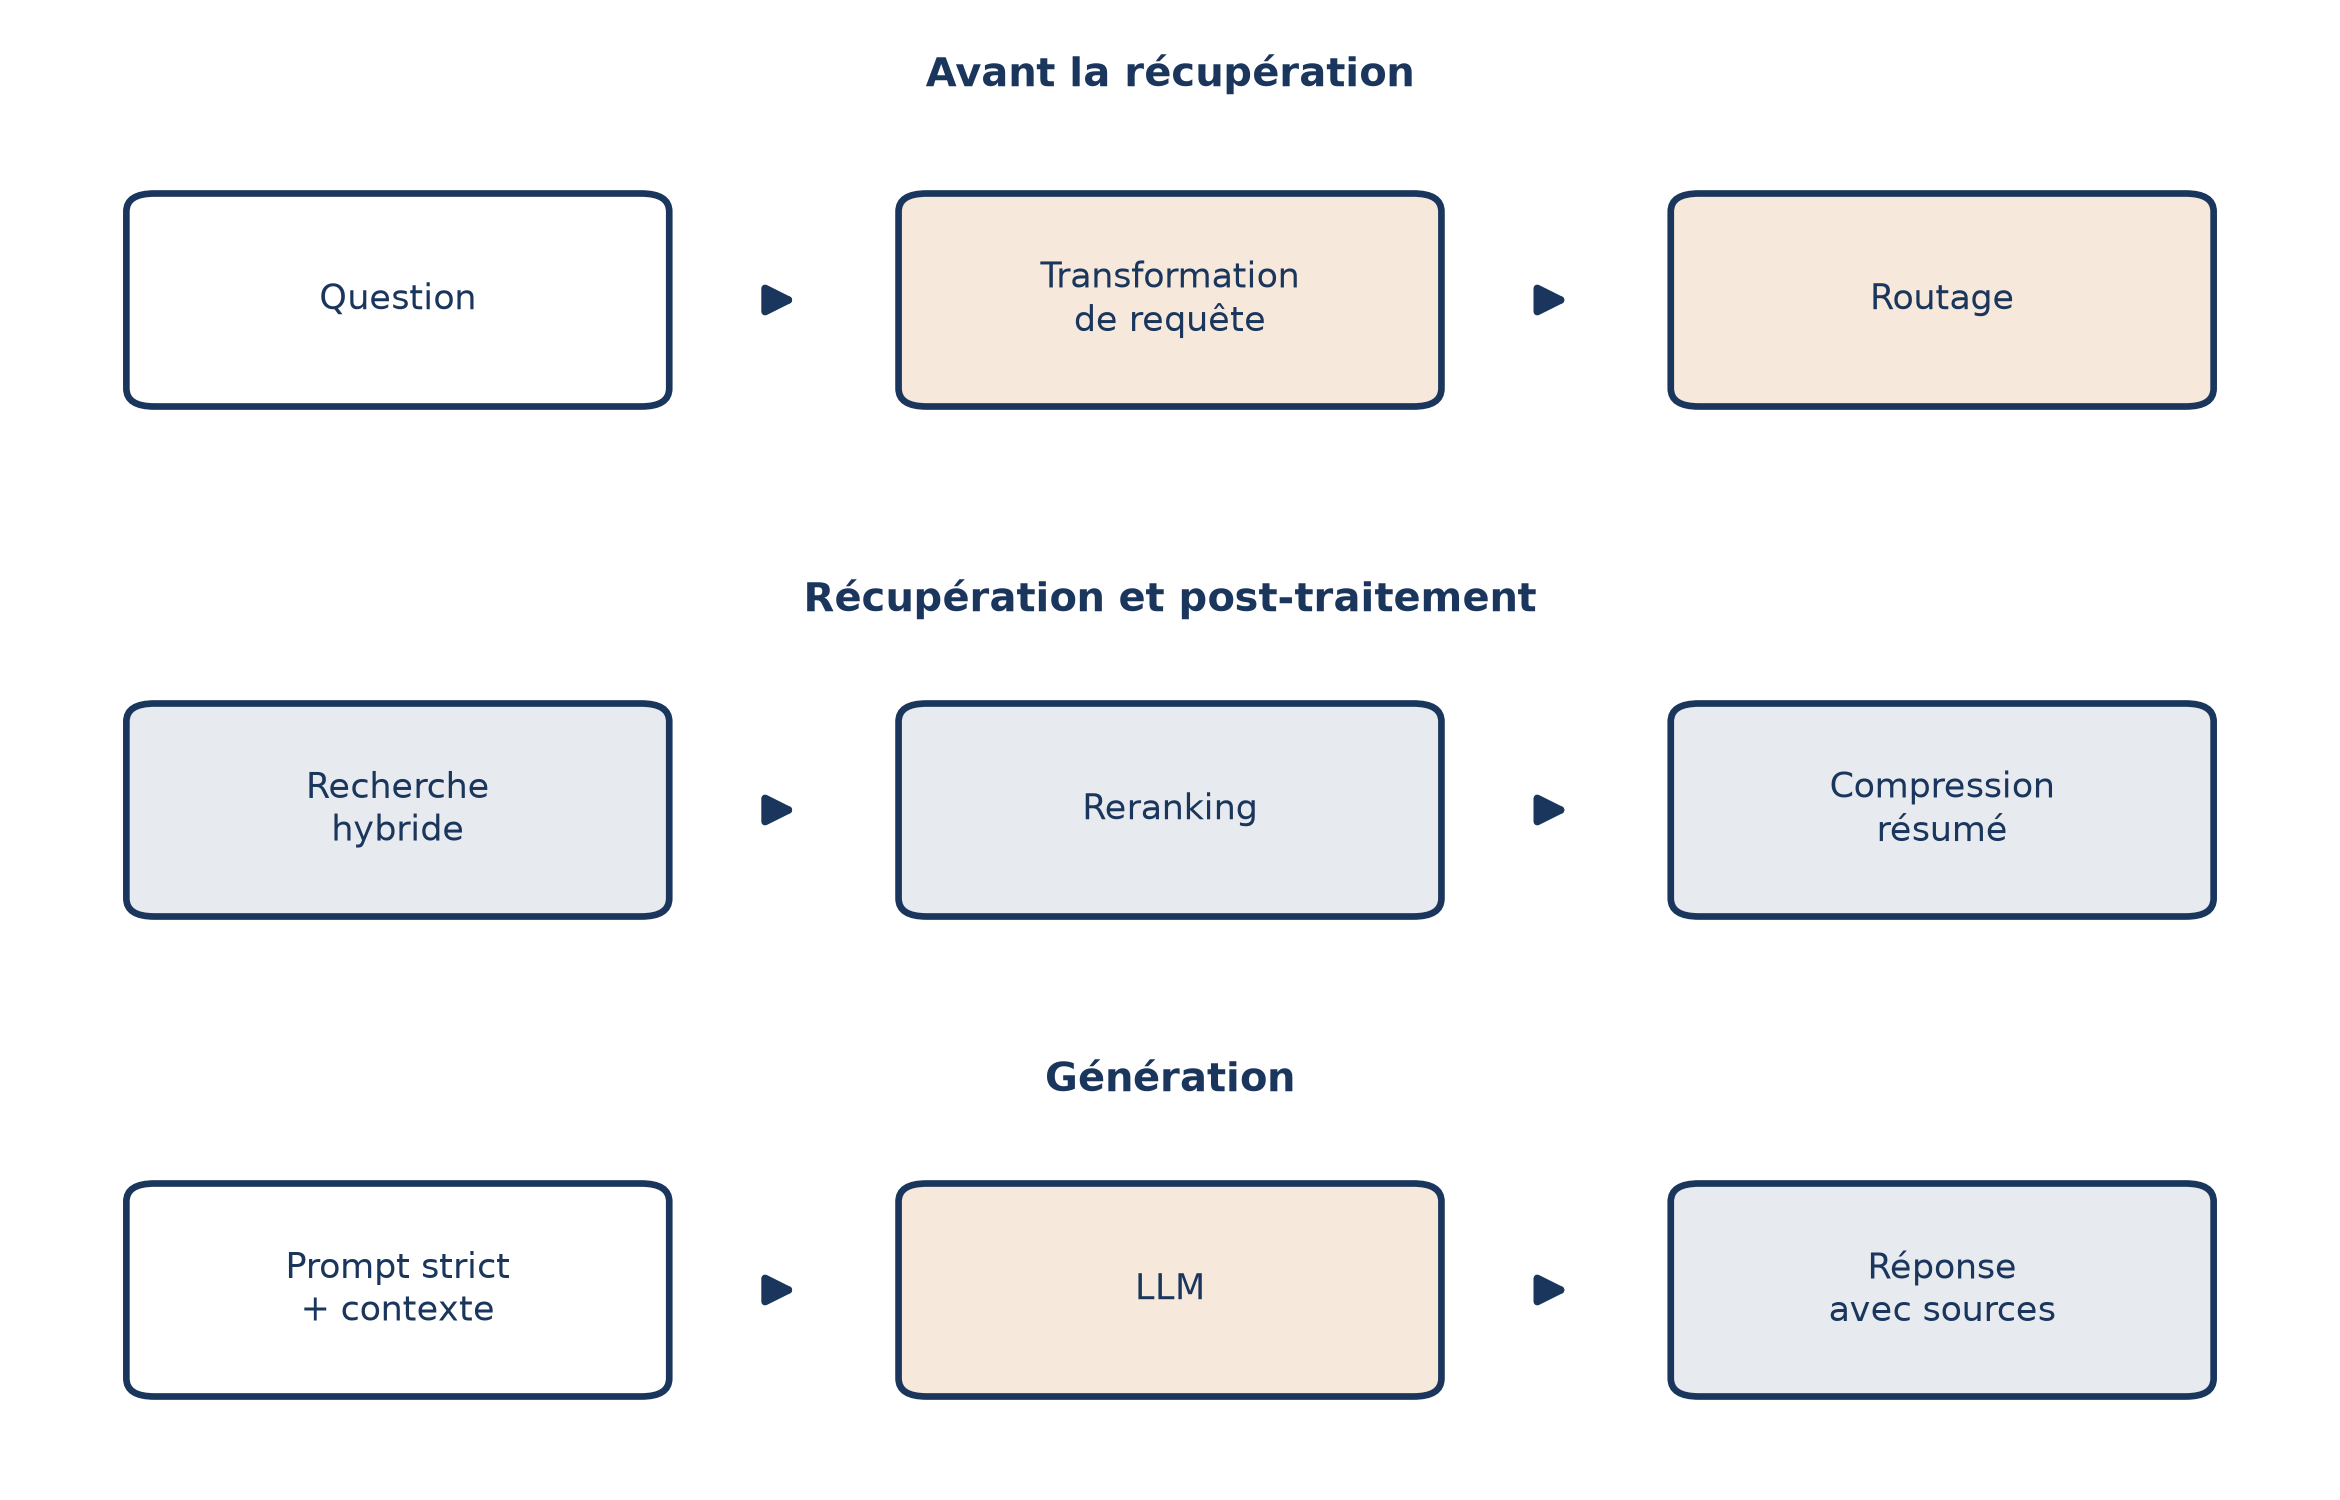
Côté outils, deux familles se rejoignent. Les plateformes de recherche textuelle historiques (Solr, Elasticsearch, OpenSearch, Apache Lucene) ont ajouté la prise en charge des vecteurs ; des bases vectorielles comme Weaviate ou Milvus proposent de combiner dense et creux ; Neo4j le permet avec deux index, comme on vient de le voir. Toutes les bases n’acceptent pas la recherche hybride ou un reranker : mieux vaut le vérifier avant de choisir.
Reste à ne pas la confondre avec deux autres façons de marier mots et sens :
| Approche | Ce qu’elle fait de la requête |
|---|---|
| Routage | Choisit une seule voie par requête, par exemple une recherche par mots-clés si elle contient un terme précis |
| Filtrer puis affiner | Garde d’abord les documents qui contiennent certains mots-clés, puis affine par la recherche sémantique |
| Hybride | Lance les deux recherches, puis fusionne les résultats |
📌 À retenir Le routage choisit, le filtre enchaîne, l’hybride mélange. Seule la recherche hybride garde en même temps le meilleur des deux listes de résultats.
Ce qu’elle ne fait pas : quatre idées reçues
« Le sémantique a rendu les mots-clés inutiles »
La recherche sémantique donne des résultats plus exacts et plus significatifs que le mot à mot, c’est vrai. Mais elle ne retrouve pas toujours les termes précis, et le moteur par mots-clés, lui, ne retrouve pas les paraphrases. Les deux se complètent, ce qui est justement la raison d’être du mélange.
« Il existe un bon réglage universel »
Les valeurs de 0,4 ou 0,5 sont des plages usuelles, pas une règle. La pondération s’adapte aux besoins de précision et de rappel du cas d’usage. Le schéma de tout à l’heure le montre : un poids différent inverse l’ordre de deux passages.
« Hybride veut dire n’importe quel mélange »
Le mot recouvre plusieurs choses. La fusion de requêtes, par exemple, étend la question en plusieurs perspectives avec un modèle de langage, lance des recherches en parallèle, puis fusionne les résultats par re-classement : elle multiplie les formulations d’une même question, elle ne combine pas deux méthodes de recherche. Et on parle aussi de recherche hybride pour mêler les données protégées d’une organisation et le contexte trouvé par une recherche sur internet, ce qui soulève d’autres questions : faut-il mettre à jour la base, comment filtrer les résultats hors sujet, quels problèmes de sécurité ?
« Une fois hybride, c’est réglé »
Combiner recherche vectorielle et recherche plein texte donne de meilleurs résultats que l’une ou l’autre seule. Mais cette approche garde des limites tant qu’elle repose uniquement sur des données non structurées : les références internes au texte ne sont pas toujours bien captées, et le contexte environnant ne suffit pas toujours à donner du sens au modèle de langage. La suite consiste à tirer parti d’une structure dans les données quand elle existe.