Pour un sac de mots, « good » et « great » sont deux colonnes distinctes d’un tableau, sans plus de lien que n’importe quelle autre paire. N’importe quel lecteur sent pourtant qu’elles se ressemblent. Les embeddings sont le procédé qui rend cette intuition à la machine : ils donnent à chaque mot, phrase ou image une adresse dans un espace où le voisinage veut dire quelque chose.
À la fin, tu sauras ce qu’est un embedding, comment un réseau de neurones apprend ces adresses en jouant à deviner un mot manquant, à quoi elles servent, et dans quels cas elles te trompent.
Sommaire
- L’essentiel en 30 secondes
- Pourquoi compter les mots ne suffit pas
- Un mot vaut ses voisins : la définition d’un embedding
- Comment un réseau apprend ces adresses
- Interroger l’espace : voisins, analogies et ratés
- À quoi ça sert, au-delà de la recherche
- Quand le vecteur dépend de la phrase
- Apprendre par contraste : les embeddings de phrases
- Pas seulement du texte : images et graphes
- Ce qu’on croit à tort des embeddings
L’essentiel en 30 secondes
- Un embedding est un vecteur dense de longueur fixe qui capte le sens d’un texte, d’une image ou d’un autre contenu.
- On l’obtient en apprenant à deviner le contexte d’un mot : les poids du réseau deviennent les vecteurs, sans étiquette à fournir.
- Deux contenus de sens proche reçoivent des adresses voisines, ce qui permet de les comparer avec de simples mathématiques.
- Les modèles actuels produisent des vecteurs contextuels : le même mot n’a plus la même adresse selon la phrase.
- Leur sens vient des cooccurrences observées : ils héritent des biais des textes et ne se comparent pas d’un modèle à l’autre.
Pourquoi compter les mots ne suffit pas
Un texte devient numérique par paliers. On part du texte brut, on passe à l’encodage one-hot (un 1 par mot, le reste à zéro), puis au sac de mots et au TF-IDF, qui comptent les fréquences par document, et l’on arrive enfin aux embeddings.
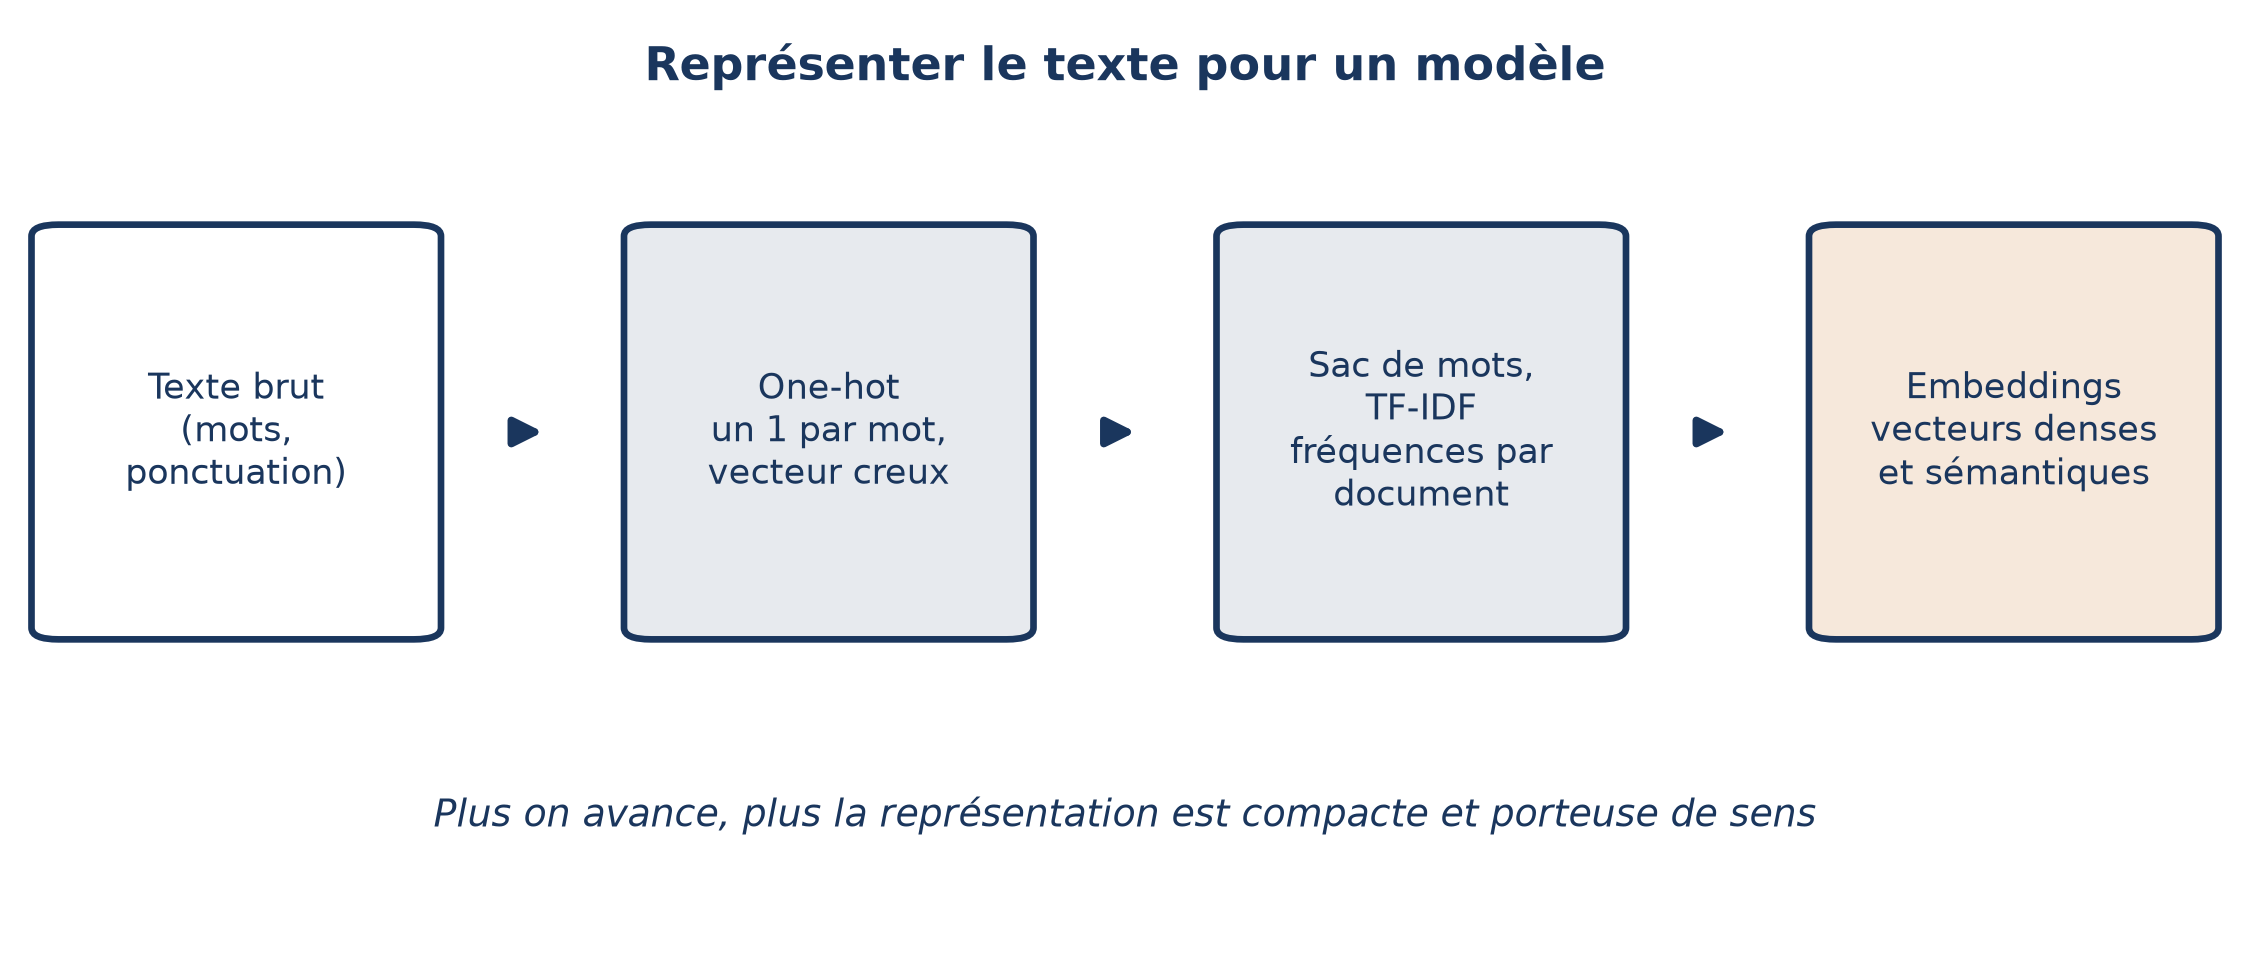
Le sac de mots a un défaut de fond : il jette en vrac les mots d’un document et ignore leur ordre. Il a aussi un défaut de taille. Le vocabulaire grandit avec le corpus, et les vecteurs avec lui, tout en restant creux, c’est-à-dire presque entièrement faits de zéros.
Un vecteur très long coûte de la mémoire et du calcul, mais aussi de la qualité : plus il est long, plus l’algorithme a de poids à apprendre et plus le surapprentissage menace. C’est le fléau de la dimension : plus il y a de caractéristiques, moins les distances entre exemples veulent dire quelque chose.
Le TF-IDF corrige une partie du problème en écrasant les mots qui reviennent partout et en valorisant ceux qui sont propres à quelques documents. Mais il laisse intacts le creux et la grande dimension : ce qu’on cherche, c’est un vecteur petit, qui garde l’information de contexte.
Un mot vaut ses voisins : la définition d’un embedding
L’issue vient d’une hypothèse de linguiste, dite distributionnelle : des mots qui se retrouvent dans les mêmes contextes ont le même sens. Inversement, un même mot change de sens avec son entourage : « je suis allé déposer de l’argent à la banque » n’a rien à voir avec « nous avons pique-niqué sur la berge de la rivière ».
On voudrait donc un tableau de vecteurs, un par mot, qui soient petits, composés de nombres réels (on dit denses) et qui conservent l’information de contexte. Leur taille ne doit pas grandir avec le vocabulaire. Leur sens est distribué : au lieu de se loger dans l’unique case à 1 du cas creux, il se répartit sur l’ensemble des composantes. Ces vecteurs s’appellent des embeddings de mots, introduits en 2013 par Mikolov avec le cadre Word2Vec.
La notion s’est ensuite généralisée. Un modèle d’embedding transforme un texte de longueur variable, ou une autre modalité comme une image, en un vecteur de longueur fixe qui capte le sens de l’entrée. Ce vecteur compte en général de quelques centaines à quelques milliers de valeurs. Dans cet espace partagé, on compare deux contenus en mesurant la distance entre leurs vecteurs.
💡 Intuition Dans un sac de mots, un mot est une case allumée parmi des milliers : on sait quel mot c’est, pas ce qu’il veut dire. Dans un embedding, un mot est un point : sa position dit de quels mots il est le voisin. Avec une seule dimension, on ne saurait pas ranger fidèlement des mots aussi différents qu’un animal, un bruit et une action ; en ajoutant des dimensions, la carte gagne en nuances.
Comment un réseau apprend ces adresses
Personne n’écrit ces vecteurs à la main. L’intuition de Word2Vec est simple : prédire un mot à partir de son contexte. On dispose d’un réseau de neurones et d’un grand corpus ; en l’entraînant à deviner quels mots se trouvent près d’un mot cible, les poids deviennent les embeddings. Le modèle est auto-supervisé : les étiquettes sont implicites, il n’y a rien à annoter.
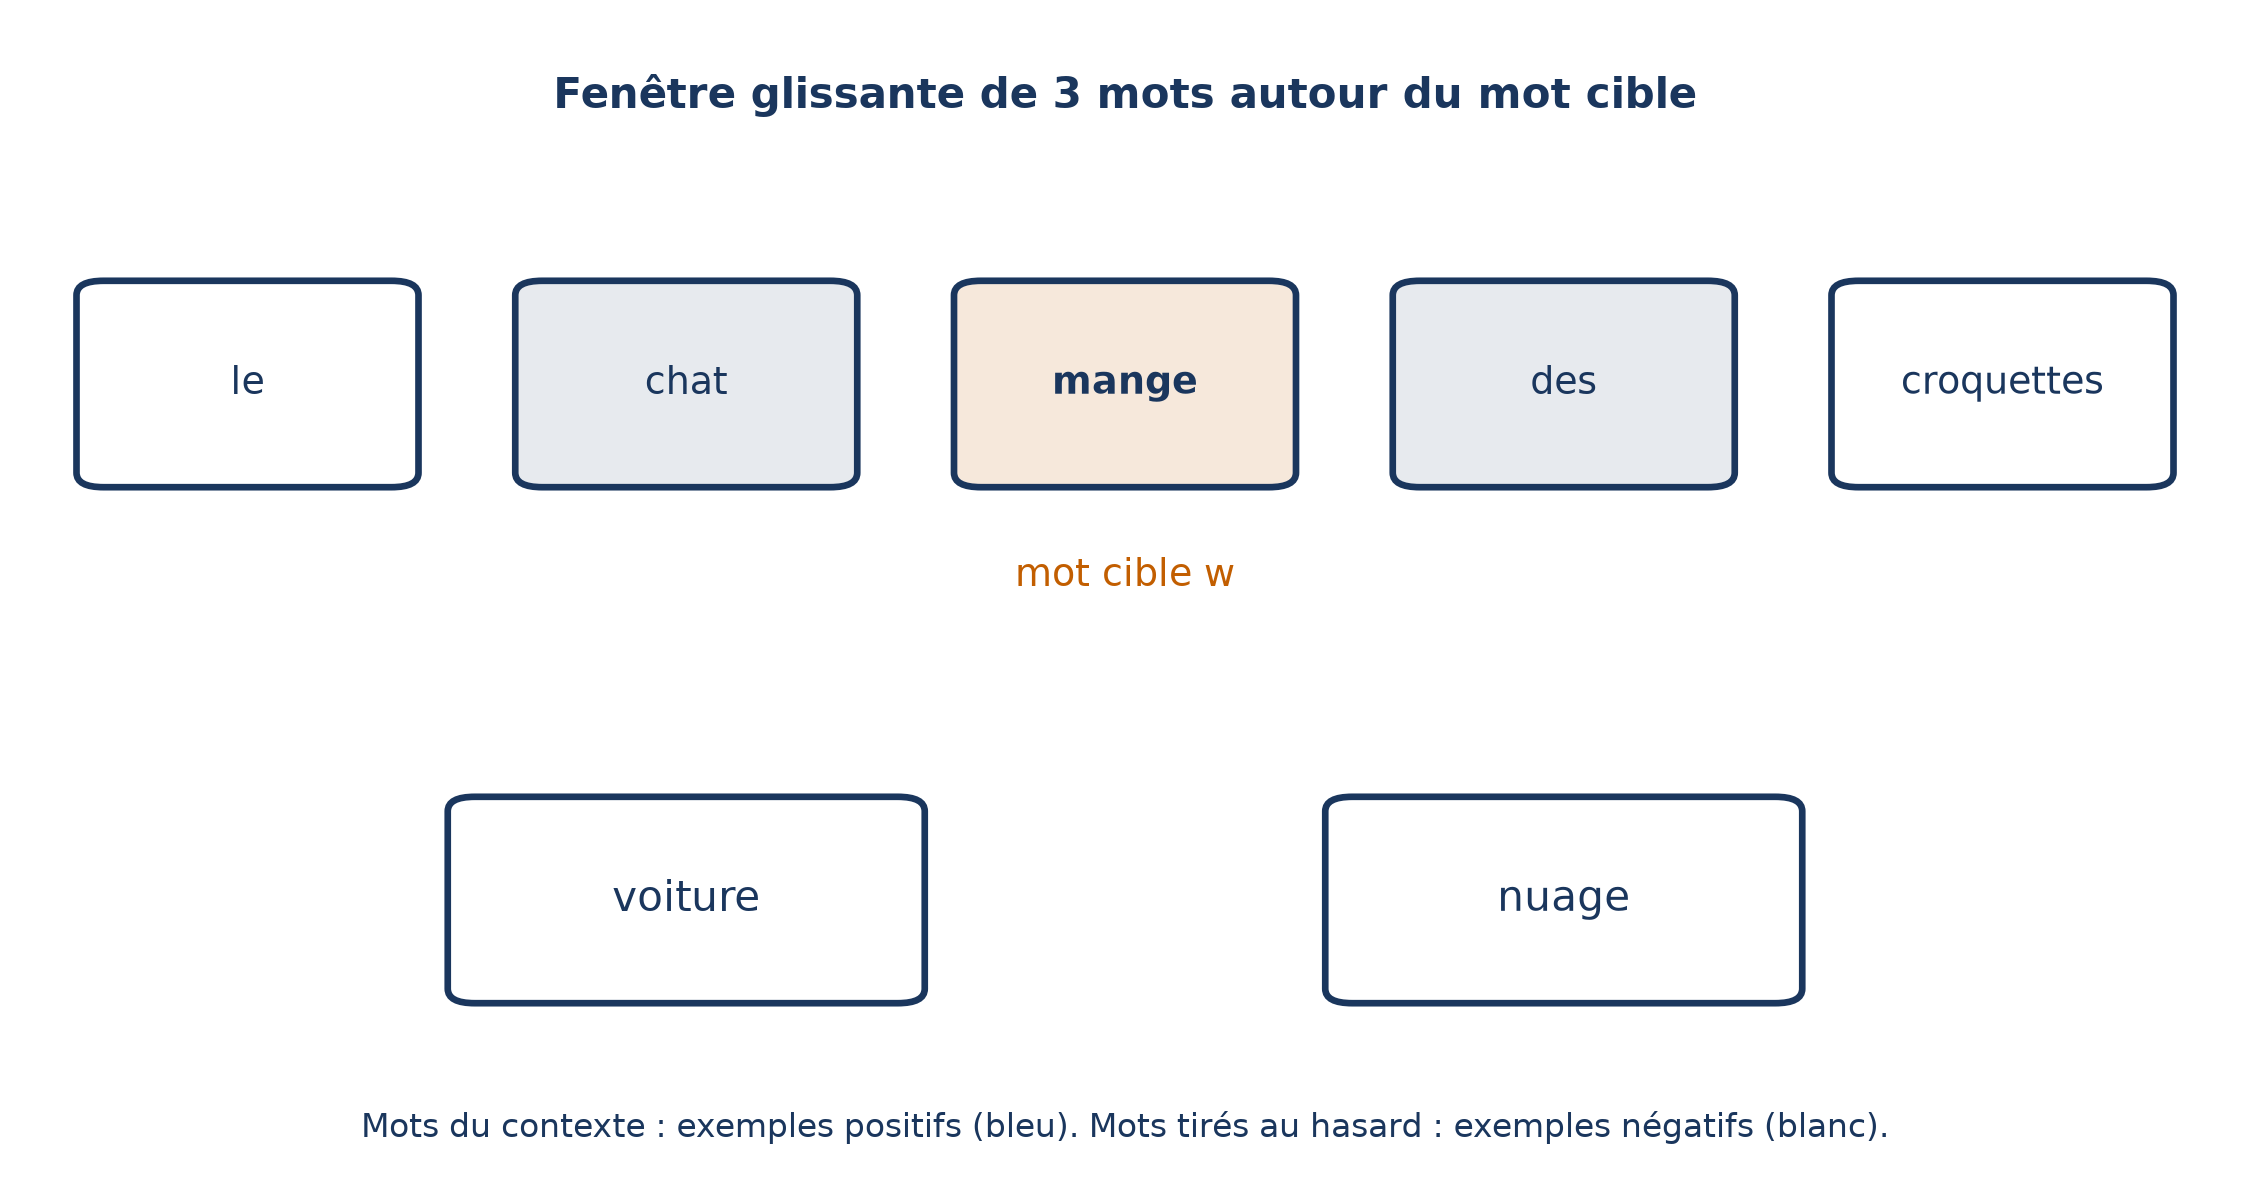
Pour aller vite, Word2Vec transforme la tâche en une question oui/non : tel mot est-il attendu dans le contexte de tel autre ? Une fenêtre se déplace le long du texte. Les mots autour du mot central sont les exemples positifs ; des mots tirés au hasard dans le vocabulaire servent d’exemples négatifs. Un classifieur de régression logistique apprend à les distinguer, et ses poids sont les embeddings.
Reste à dire comment « plausible » se mesure. Pour un mot cible  et un mot de contexte
 , on veut que la probabilité que soit dans le contexte de suive la similarité de leurs embeddings, mesurée par le produit scalaire
 transformé en probabilité par la fonction sigmoïde :
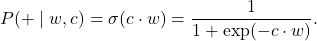
Le produit scalaire est grand quand les deux vecteurs ont des valeurs importantes dans les mêmes dimensions ; la sigmoïde l’écrase en un nombre entre 0 et 1, lisible comme une probabilité. Si les vecteurs de et se ressemblent, doit apparaître souvent près de .
Pour l’entraînement, on additionne deux termes : on veut une grande probabilité pour le vrai voisin, et une petite pour chacun des  mots tirés au hasard. En passant au logarithme, les produits deviennent des sommes, et l’on minimise l’entropie croisée :
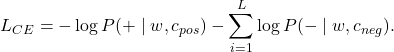
Lis-la en deux morceaux. Le premier terme est petit quand le vrai voisin  reçoit une probabilité proche de 1. La somme est petite quand les faux voisins
 reçoivent une probabilité proche de 0. Minimiser la perte, c’est donc rapprocher les mots qui cohabitent et éloigner les autres.
Un détail pratique : le modèle apprend en réalité deux matrices de vecteurs, une pour les mots cibles et une pour les mots de contexte, très proches l’une de l’autre. On n’en garde qu’une, et c’est elle qui forme l’embedding.
Trois réglages pèsent sur la qualité du résultat :
- la qualité des données : Wikipédia donne de meilleurs embeddings pour les tâches sémantiques, la presse améliore les tâches syntaxiques (un mélange est recommandé), et les réseaux sociaux peuvent introduire des biais ; une plus grande quantité de texte aide aussi, au prix d’un entraînement bien plus long ;
- la dimension : plus l’embedding est grand, meilleures sont les performances, mais 300 est un bon compromis, car au-delà le gain devient négligeable ;
- la taille de la fenêtre : une fenêtre de 2 donne des vecteurs qui identifient mieux les catégories grammaticales, de longues fenêtres conviennent mieux à une similarité large.
En Python, la bibliothèque gensim réduit tout cela à quelques lignes. list_of_tokens est la liste des phrases déjà découpées en mots.
from gensim.models import Word2Vec
model = Word2Vec(sentences=list_of_tokens,
                 sg=1,
                 vector_size=100,
                 window=5,
                 workers=4)
Le paramètre sg=1 choisit l’architecture skip-gram, qui prédit le contexte à partir du mot central. Ici, l’embedding a 100 dimensions, la fenêtre contient 5 mots, et workers=4 répartit le calcul sur 4 threads.
Interroger l’espace : voisins, analogies et ratés
Une fois les vecteurs appris, on peut les questionner. La première question est : quels sont les mots les plus proches de ? La seconde est celle des analogies, que les chercheurs représentent par un parallélogramme : puisque les mots sont des vecteurs, on les additionne et on les soustrait.
Voici le test complet, sur le modèle entraîné plus haut. Les premières lignes cherchent les trois mots les plus proches de « good » et comparent sa distance à un synonyme (« great ») et à un antonyme (« bad »). Les dernières retirent « man » de « king », ajoutent « woman », et affichent le mot le plus proche du résultat.
word_1 = "good"
syn = "great"
ant = "bad"
most_sim =model.wv.most_similar("good")
print("Top 3 most similar words to {} are :{}".format(
    word_1, most_sim[:3]))
synonyms_dist = model.wv.distance(word_1, syn)
antonyms_dist = model.wv.distance(word_1, ant)
print("Synonyms {}, {} have cosine distance: {}".format(
    word_1, syn, synonyms_dist))
print("Antonyms {}, {} have cosine distance: {}".format(
    word_1, ant, antonyms_dist))
a = 'king'
a_star = 'man'
b = 'woman'
b_star= model.wv.most_similar(positive=[a, b], negative=[a_star])
print("{} is to {} as {} is to: {} ".format(
    a, a_star, b, b_star[0][0]))
Que lire dans les résultats ? Le modèle gère mal les antonymes : leur distance à « good » ne les distingue pas nettement des synonymes. La raison est dans la définition même du voisinage, fondée sur l’apparition dans la même fenêtre de contexte : « good » et « bad » se glissent dans les mêmes phrases.
Les analogies, elles, marchent à demi : la bonne réponse n’est pas toujours la première, mais elle figure souvent parmi les trois premières. Elles réussissent bien pour des entités fréquentes (noms de villes, mots courants) et nettement moins pour des entités rares.
Ces vecteurs ont entre 100 et 1 024 dimensions, impossibles à regarder tels quels. Pour les visualiser, on les projette en deux ou trois dimensions avec l’analyse en composantes principales (PCA), le t-SNE ou, plus récemment, UMAP. UMAP préserve mieux le sens et les structures locales comme globales, ce qui donne de meilleurs groupes ; on voit alors les mots de sens voisin se regrouper.
⚠️ Piège Une carte en deux dimensions est une projection, pas l’espace lui-même : deux points qui paraissent voisins sur l’écran peuvent être éloignés dans les 100 dimensions d’origine.
À quoi ça sert, au-delà de la recherche
Un embedding est une brique, rarement une fin. On le retrouve dans la recherche et les systèmes de recommandation, mais aussi pour bâtir des mémoires d’agents. Quelques usages moins connus montrent l’étendue du principe.
Suivre l’évolution d’un mot. En entraînant des embeddings sur des corpus qui couvrent plusieurs décennies, on voit des mots comme gay, broadcast ou awful changer de voisinage sémantique d’une époque à l’autre.
Nettoyer un jeu de données. Pour préparer des exemples d’entraînement, on déduplique par similarité d’embeddings : deux textes dont les vecteurs sont presque confondus sont probablement des doublons.
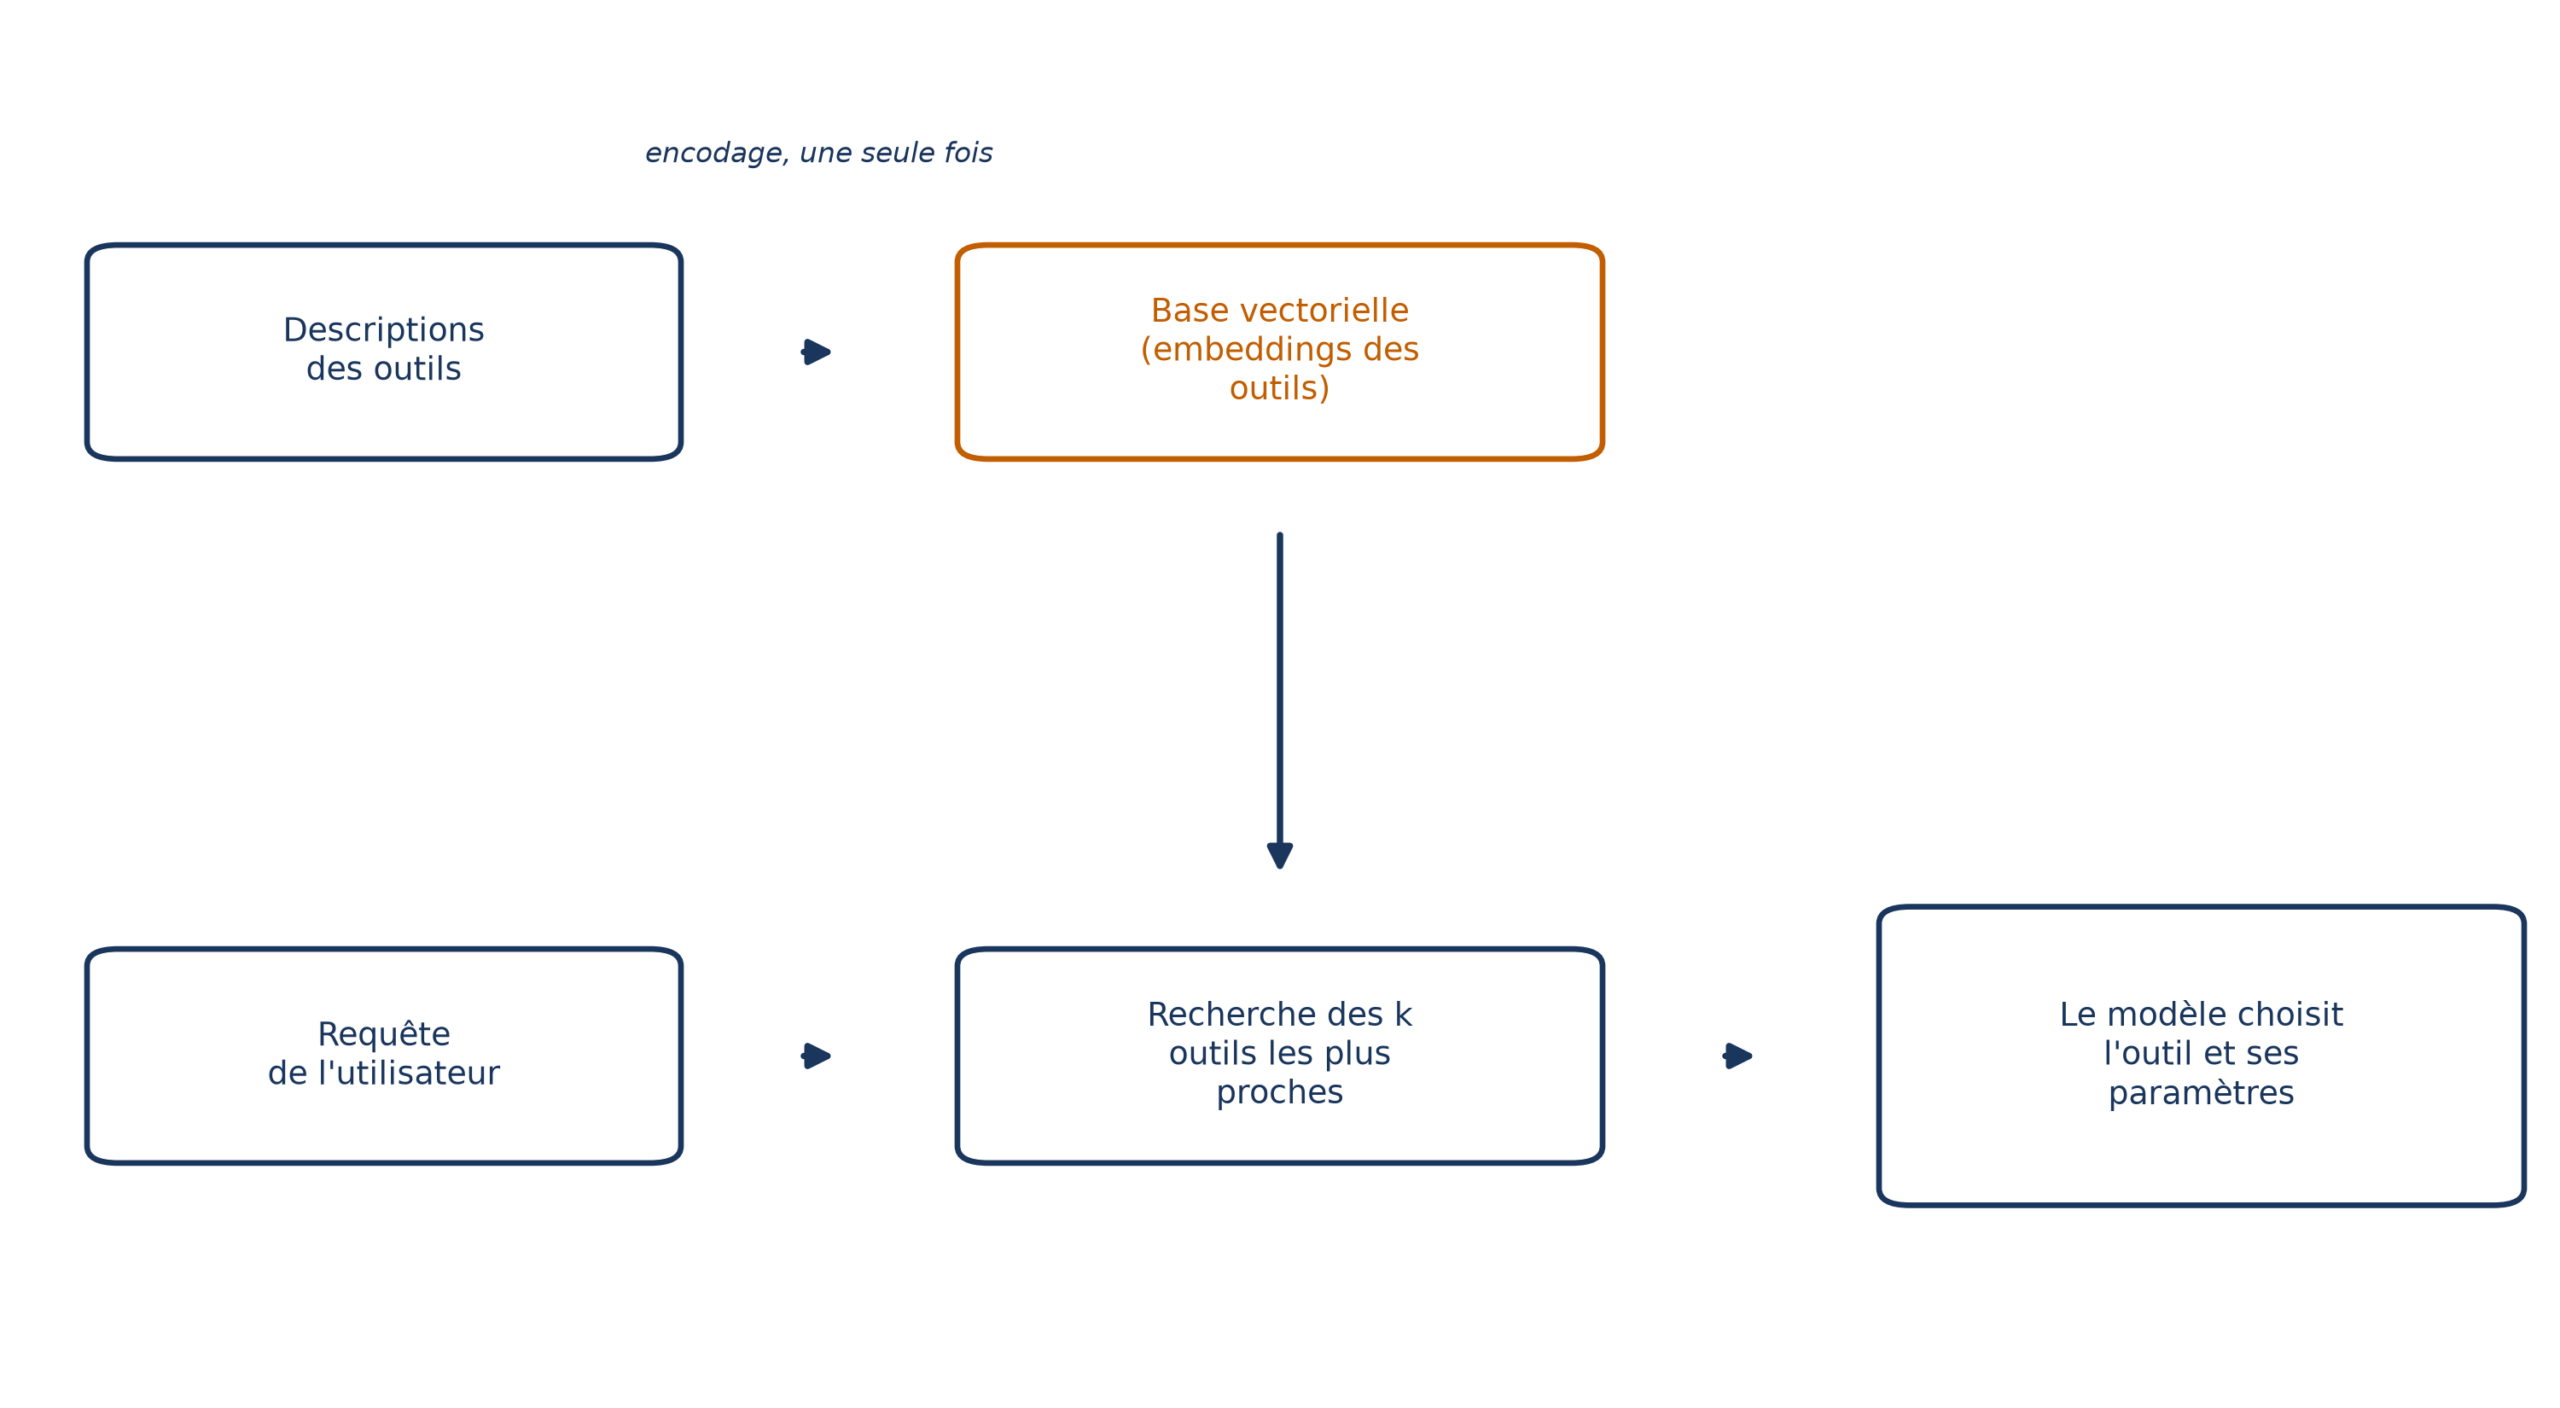
Choisir le bon outil. Un agent qui dispose de nombreux outils peut encoder une fois la description de chacun dans une base de vecteurs. À chaque requête, il encode le contexte courant avec le même modèle et retient les k outils les plus proches, parmi lesquels le modèle de langage fait son choix. C’est le motif le plus courant et le plus recommandé dans la plupart des cas : généralement plus rapide que de tout lui présenter, performant et raisonnablement extensible.
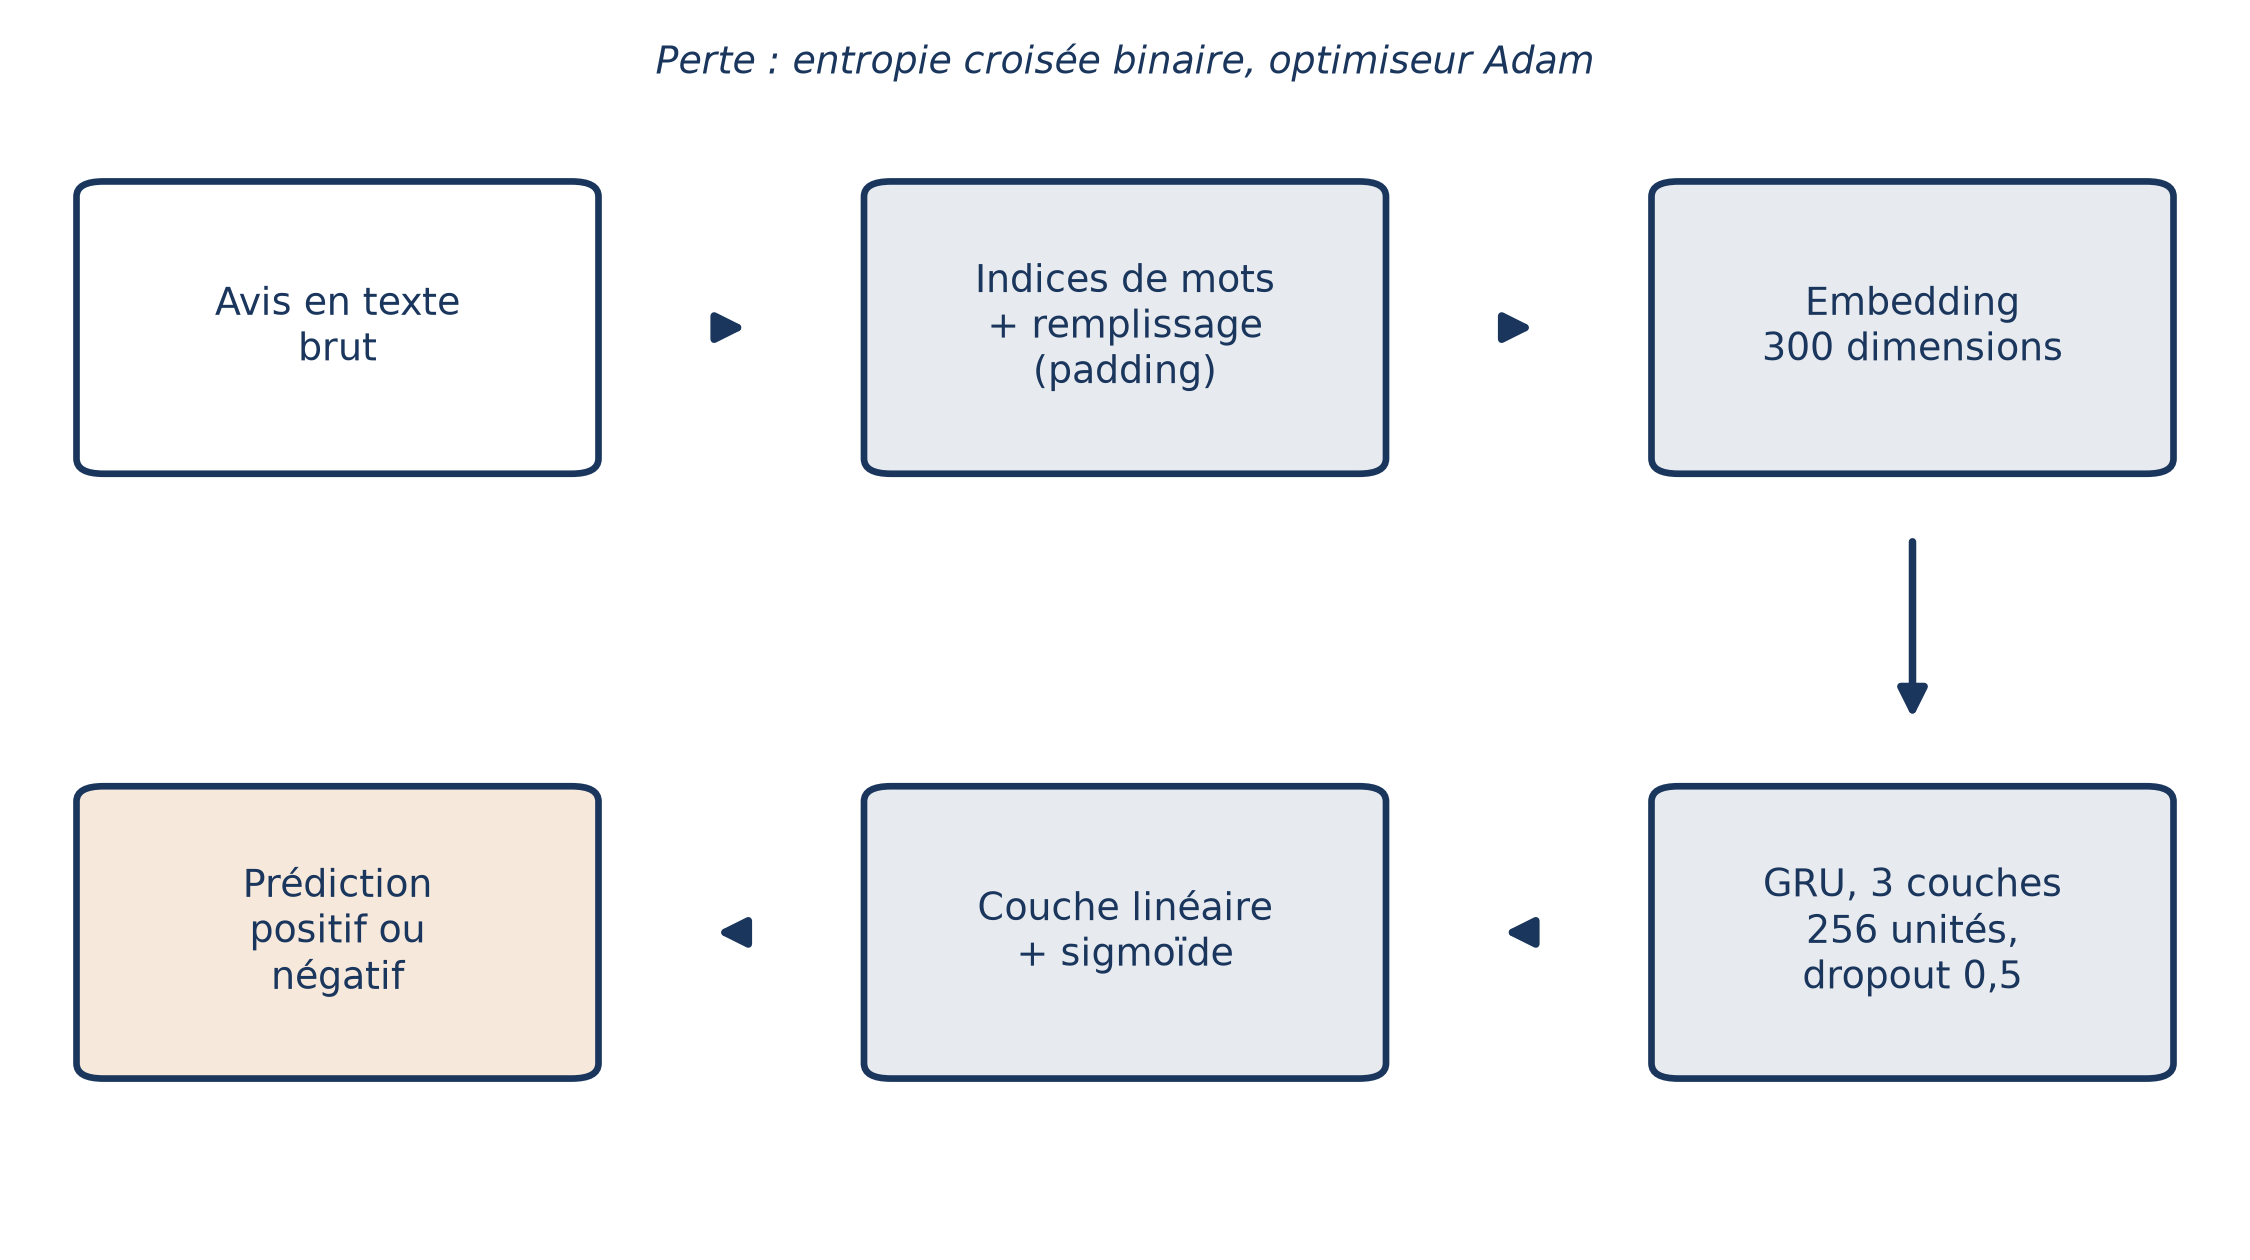
Alimenter un classifieur. On peut aussi apprendre un embedding dans un réseau, pour une tâche précise. Exemple : classer 50 000 avis de films, positifs ou négatifs, de 230 mots en moyenne. Le réseau transforme chaque avis en indices de mots, les convertit en embeddings de 300 dimensions, les passe dans trois couches GRU de 256 unités avec un dropout de 0,5, puis dans une couche linéaire suivie d’une sigmoïde.
# Hyperparameters
no_layers = 3
vocab_size = len(vocab) + 1  # extra 1 for padding
embedding_dim = 300
output_dim = 1
hidden_dim = 256
# Initialize the model
model = SentimentRNN(no_layers, vocab_size, hidden_dim,
                     embedding_dim, drop_prob=0.5)
Ici, embedding_dim = 300 fixe la taille de chaque vecteur de mot, et vocab_size le nombre de mots connus (vocab est le vocabulaire construit au prétraitement), plus une case réservée au remplissage. Après l’entraînement, si l’on projette les avis, l’embedding s’est organisé selon le sentiment : le modèle a appris à séparer avis positifs et négatifs.
Quand le vecteur dépend de la phrase
Revenons à la banque et à la berge. Un vecteur Word2Vec est fixe : il représente une somme pondérée des différents sens du mot, en proportion de leur fréquence dans le texte, une superposition linéaire. Quand on additionne ou soustrait des vecteurs pour une analogie, on travaille sur ces composantes : dans « pomme : rouge :: banane : ? », on ne retire à « pomme » que la part proche de « rouge ».
Pour qu’un même mot ait plusieurs adresses selon son contexte, on passe par un Transformer. Pour une séquence de jetons, on extrait la représentation  obtenue à la dernière couche : on obtient un vecteur de grande dimension qui désambiguïse le sens. « Banque », dans un contexte d’argent ou de rivière, reçoit des embeddings contextuels différents, ce que montre clairement une projection t-SNE de BERT.
Par commodité on prend la dernière couche, mais on propose en général de moyenner les représentations de plusieurs couches, car chaque bloc apprend une représentation différente du texte.
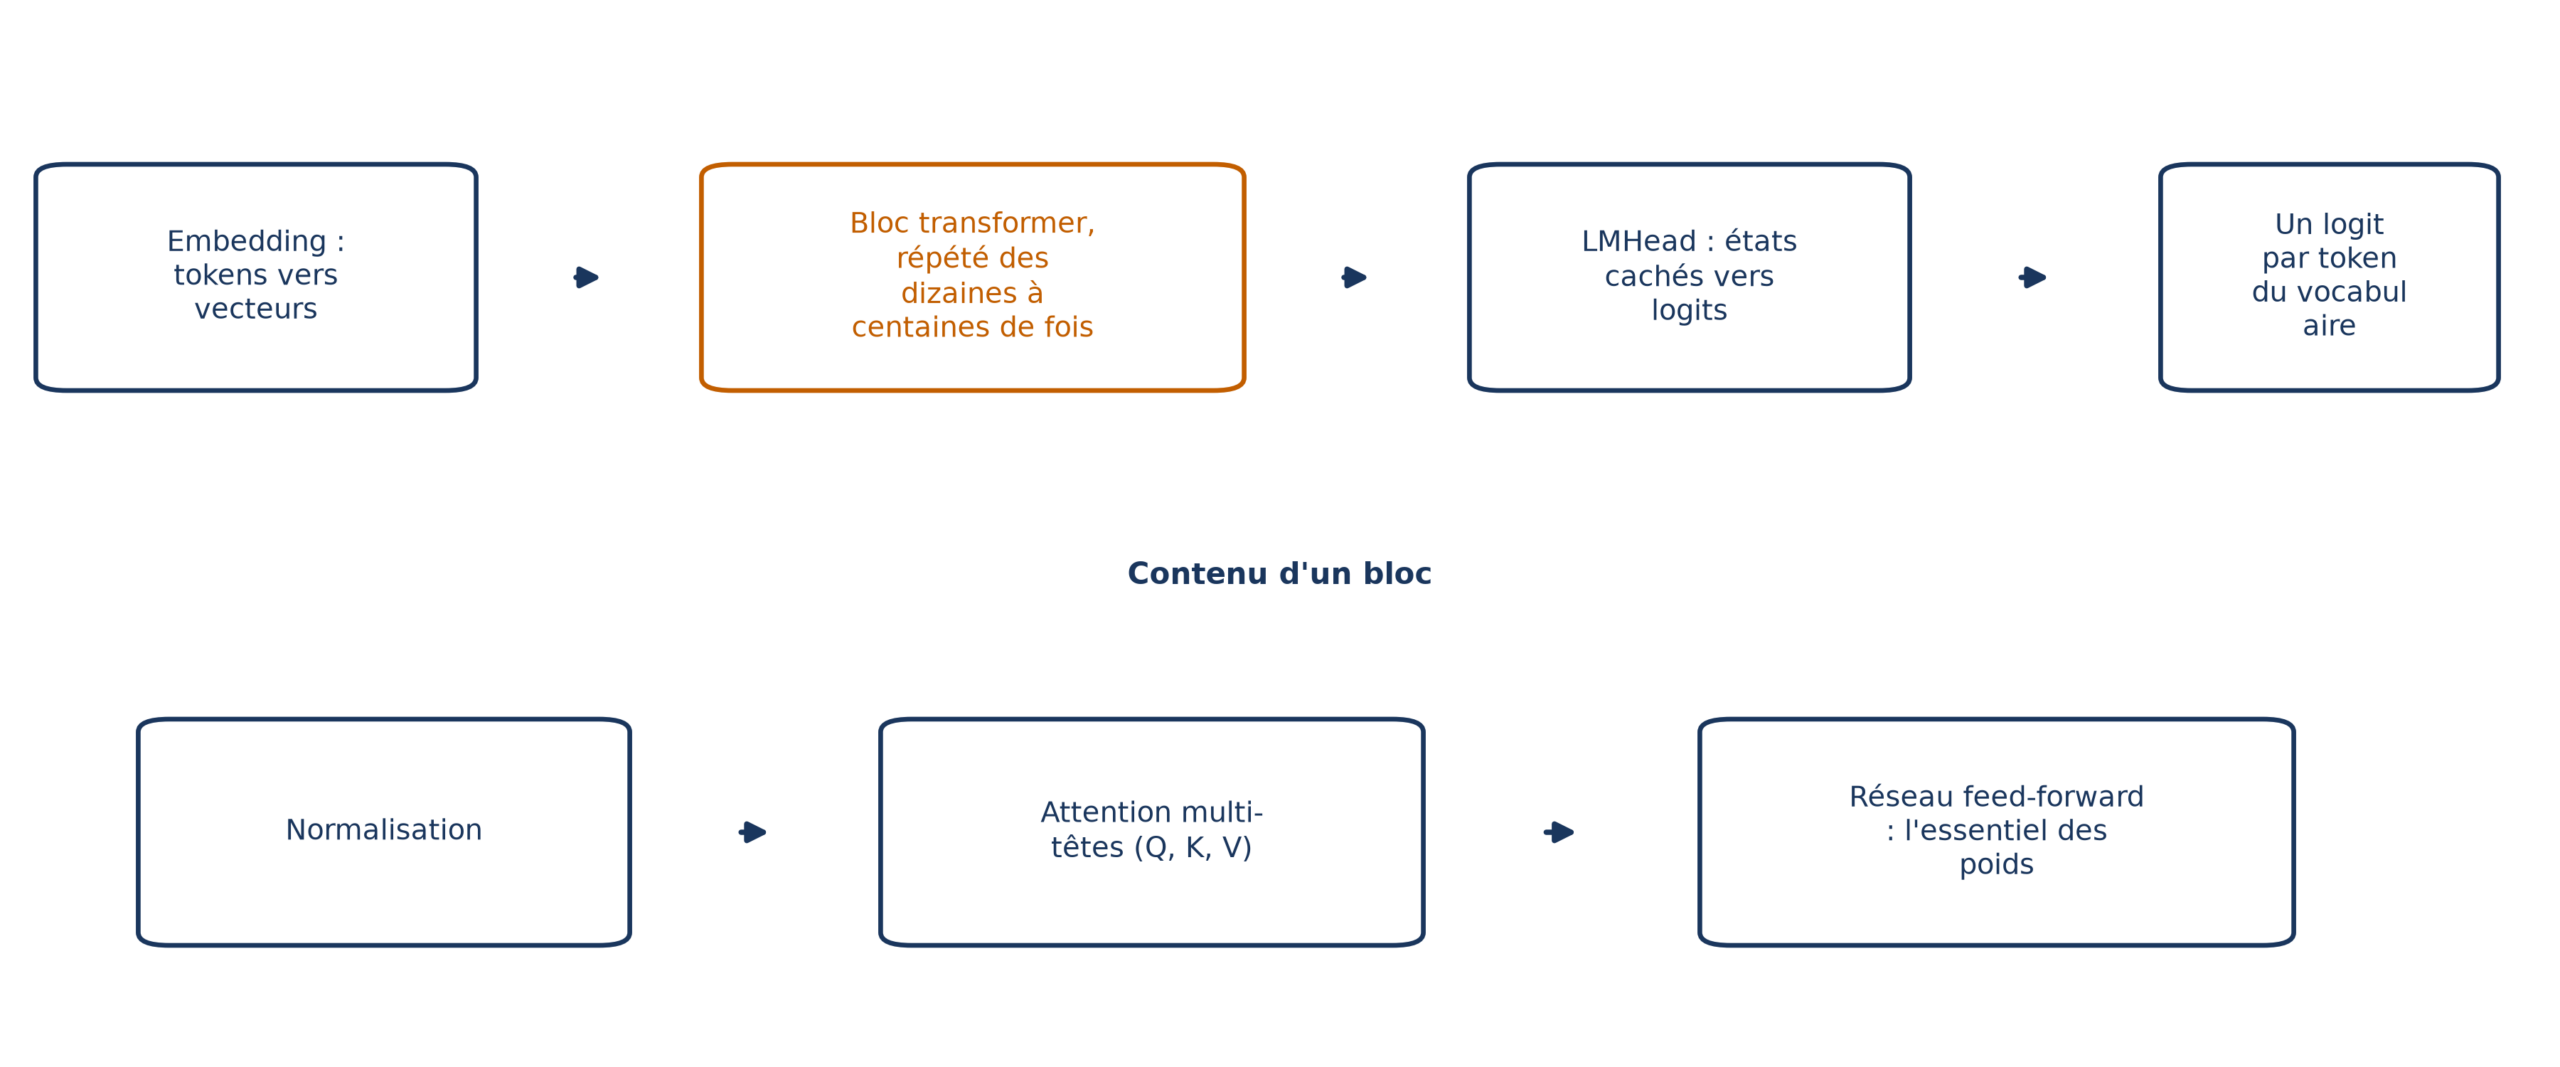
Où ce vecteur se fabrique-t-il ? Au tout début du modèle. Le texte est d’abord découpé en jetons, puis une étape d’embedding fournit un vecteur par jeton ; comme l’auto-attention ne connaît pas l’ordre, on additionne aux vecteurs un encodage de la position de chaque jeton. Un grand modèle de langage se compose ainsi de trois sortes de couches : la couche d’embedding, couche d’entrée qui prend des jetons et renvoie des embeddings ; des dizaines à centaines de blocs transformeurs ; et une couche de sortie qui produit un score par jeton du vocabulaire.
Ces vecteurs contextuels ont une particularité étrange : l’anisotropie. Pour des mots pris au hasard, leur similarité est plus élevée qu’elle ne devrait l’être. La cause : de 1 à 5 dimensions aberrantes, de grande magnitude et de variance disproportionnée, dominent le vecteur. Elles sont très corrélées à la position absolue et à la ponctuation, donc peu informatives. On les atténue par une transformation comme la normalisation par z-score.
Apprendre par contraste : les embeddings de phrases
Pour comparer des phrases entières, la devinette du mot manquant ne suffit plus. On entraîne le modèle en lui montrant des paires : une phrase doit avoir un embedding proche de celui d’un exemple positif, et éloigné de celui d’un exemple négatif. On parle d’apprentissage contrastif. Entraîner un modèle de zéro est possible, mais il vaut en général mieux prendre un LLM entraîné sans supervision et l’adapter à cette tâche.
Un jeu très utilisé est MultiNLI : 433 000 paires de phrases annotées. À partir d’une hypothèse, la seconde phrase exprime une implication, une contradiction ou ni l’une ni l’autre (neutre). Une phrase en implication sert d’exemple positif, une contradiction d’exemple négatif.
Deux fonctions de perte dominent :
- la perte de similarité cosinus vise une similarité proche de 1 pour des phrases semblables (la phrase d’origine et son exemple positif) et proche de 0 pour des phrases dissemblables ;
- la perte de classement à négatifs multiples (InfoNCE) n’utilise que des exemples positifs : pour les négatifs, on prend la phrase d’implication d’une autre phrase, et l’on maximise la similarité avec la phrase liée tout en minimisant celle avec les autres. La tâche devient une classification, avec l’entropie croisée.
Un piège guette : si les négatifs n’ont aucun rapport avec la phrase, la tâche est trop facile pour le modèle. Mieux vaut ajouter des phrases négatives liées au sujet mais qui ne sont pas la bonne réponse.
Il existe des dizaines de milliers de modèles d’embedding sur Hugging Face, mais tous reposent sur l’une de deux familles. Les modèles de type BERT, à encodeur seul, comptent généralement moins d’un milliard de paramètres et étaient conçus à l’origine pour prédire des jetons masqués. Les modèles à base de LLM, d’au plus huit milliards de paramètres, sont des modèles de langage modernes détournés pour produire des embeddings. Les seconds offrent aujourd’hui des capacités nettement supérieures, mais les premiers servent encore à des tâches simples sensibles à la latence, comme la classification.
Enfin, ajuster un embedder coûte bien moins que l’entraîner de zéro, y compris avec des données synthétiques créées par un gros LLM quand on n’a pas de jeu adapté. L’ajustement est en général supervisé, avec des exemples positifs et négatifs comme à l’entraînement d’origine.
Pas seulement du texte : images et graphes
Le principe contrastif sert aussi à relier des modalités. CLIP a été entraîné avec 400 millions de paires (image, texte) collectées sur internet. Il utilise un encodeur Transformer pour chacun des deux types de données. Une fois l’image et sa légende encodées, on compare leurs embeddings : le modèle apprend à maximiser la similarité avec la bonne légende, et à la minimiser avec les mauvaises.
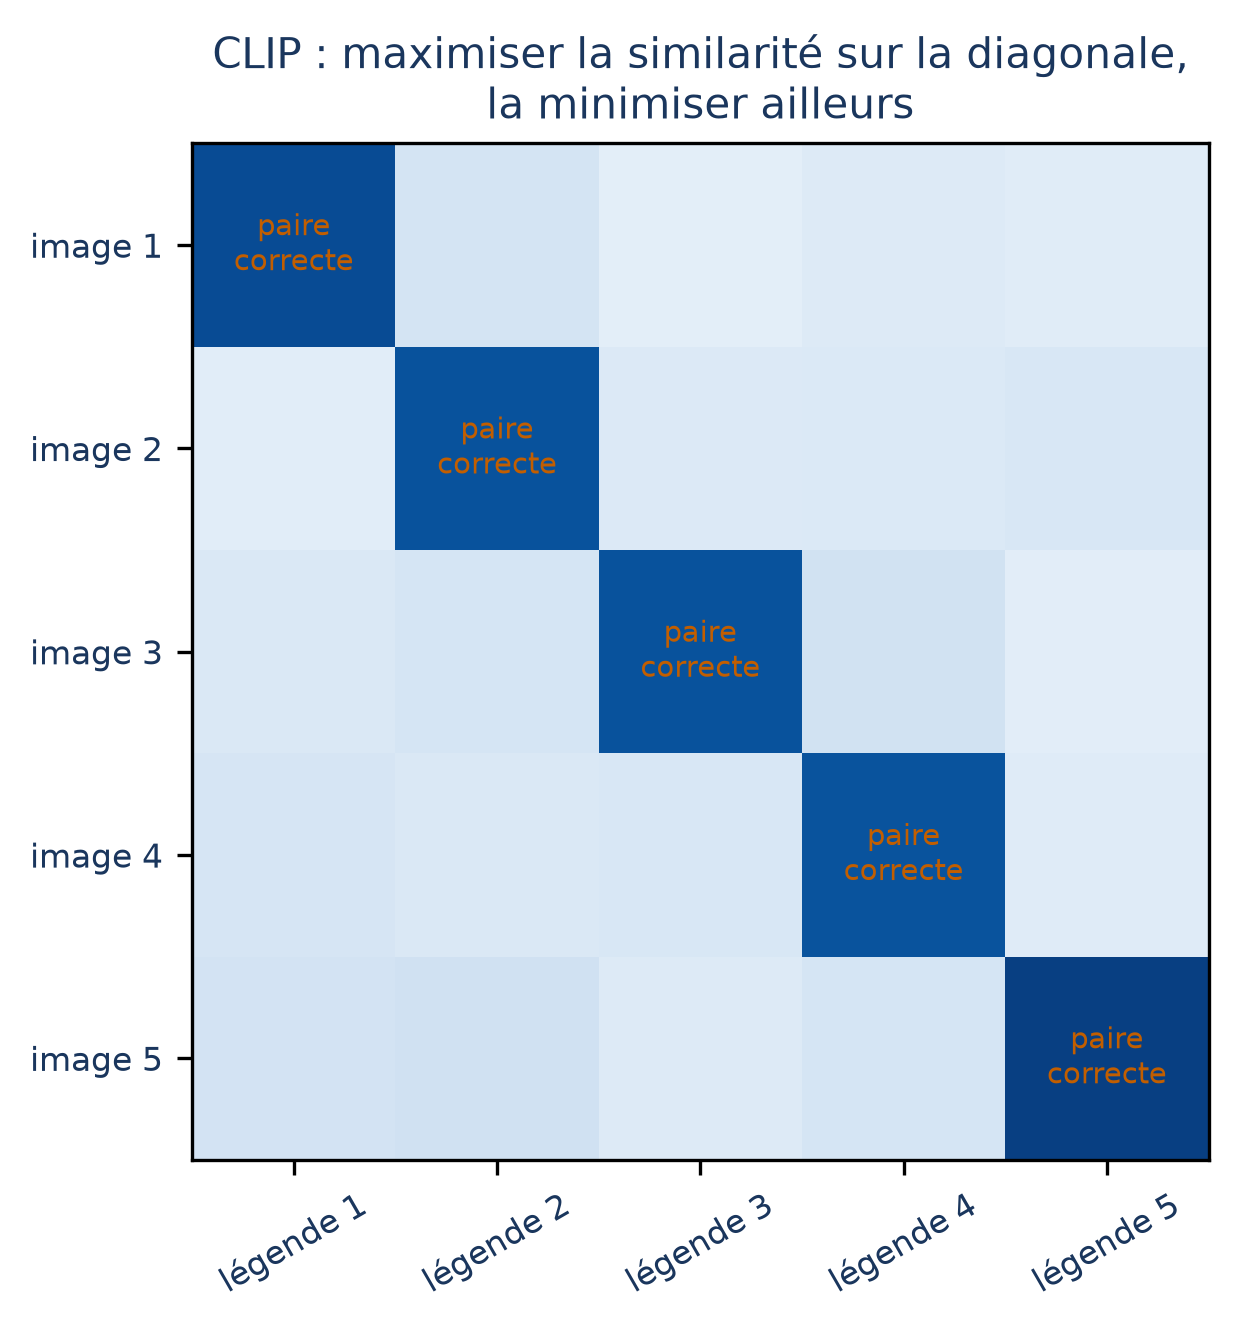
Avec les bibliothèques Hugging Face, on obtient les embeddings d’images et de légendes, puis la matrice de similarité, en quelques lignes.
from sentence_transformers import SentenceTransformer, util
model = SentenceTransformer('clip-ViT-B-32')
image_embeddings = model.encode(images, convert_to_tensor=True)
caption_embeddings = model.encode(
    captions, convert_to_tensor=True)
similarity_matrix = util.cos_sim(
    image_embeddings, caption_embeddings)
images et captions sont les listes d’images et de légendes à comparer. Un seul modèle encode les deux, et util.cos_sim renvoie la matrice des scores entre chaque image et chaque légende.
Cet espace commun rend possibles des tâches nouvelles : classer une image à partir d’un simple ensemble d’étiquettes (classification zero-shot), chercher dans de grands jeux d’images, ou les regrouper puis attribuer des mots-clés aux groupes. Il pilote même la génération d’images : dans Stable Diffusion, un encodeur de texte comme CLIP produit des embeddings proches de ceux des images correspondantes, et de l’attention croisée relie cette information au processus de génération.
On plonge enfin dans des espaces vectoriels des objets qui n’ont rien d’une phrase : les graphes de connaissances. Un modèle d’embedding de graphe apprend une projection qui préserve la structure et l’information. Avec TransE, les relations deviennent des vecteurs : pour un triplet  , il apprend un espace où
 . D’autres méthodes préservent la symétrie ou la composition des relations, ou, comme ATTH, des structures hiérarchiques dans un espace hyperbolique.
Ce qu’on croit à tort des embeddings
« Plus de dimensions, c’est toujours mieux »
Des vecteurs plus longs encodent plus d’information, mais la dimension ne change guère le temps d’inférence : elle pèse sur le stockage, la récupération et le calcul de similarité. Chaque dimension en virgule flottante demande 4 octets, ce qui peut coûter exorbitant à grande échelle.
D’où l’intérêt de comprimer. La quantification binaire garde 1 bit par dimension et réduit la mémoire jusqu’à 32 fois. La plus simple applique un seuil nul :
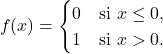
Chaque composante positive devient 1, toute autre devient 0. On compare alors les vecteurs par la distance de Hamming, adaptée aux vecteurs binaires. Cette compression donne une vitesse et un gain de mémoire sans précédent, mais coûte en général de la performance ; des versions plus fines, avec une nouvelle notation des résultats trouvés, conservent jusqu’à 96 % de la similarité. Un bon compromis consiste souvent à passer du format float32 à int8, qui représente les valeurs avec 256 niveaux, en recalibrant les vecteurs.
Une autre voie, les représentations Matriochka, place l’information la plus importante dans les premières dimensions : on peut tronquer le vecteur en gardant la performance sur les tâches aval. Pour vérifier qu’un modèle d’embedding quantifié reste fidèle, on passe les mêmes entrées dans l’original et dans la version quantifiée, puis on compare les vecteurs : il faut au moins 99 % de similarité pour être en confiance.
« Deux vecteurs de même longueur se comparent »
Les vecteurs d’un modèle d’embedding ne se comparent en général pas de façon significative à ceux d’un autre, même de même longueur : chaque modèle encode les entrées dans son propre espace sémantique. Une longueur identique ne garantit pas un repère identique.
« Un embedding peut résumer n’importe quel texte »
Aucun modèle d’embedding actuel ne gère les contextes très longs : le maximum est de 32 000 jetons. Un texte plus long doit donc être découpé avant d’être encodé.
« L’espace des embeddings est neutre »
Ces espaces reflètent les textes dont ils sont tirés. Les modèles d’embedding peuvent amplifier les biais, et l’on y a identifié l’association de contenus nocifs à des groupes et à des minorités. Les approches de débiaisage montrent un potentiel, mais restent loin d’être efficaces. La parade passe par le jeu de pré-entraînement : le désintoxiquer avant l’entraînement et varier les sources, car les textes produits aux États-Unis dominent ceux d’ailleurs.
📌 À retenir Un embedding n’est pas un sens, c’est une position apprise : celle que les voisins d’un mot, d’une phrase ou d’une image lui ont donnée pendant l’entraînement. Sa force est de rendre le sens calculable ; sa limite est qu’il ne sait rien de plus que ce que ses données lui ont montré.