Écris « Never gonna » dans la zone de saisie d’un grand modèle de langage : s’il a lu assez de culture populaire, il complète par « give you up », sans que tu lui aies rien demandé d’autre. Ce petit tour de passe-passe est le cœur d’un LLM, et il explique bien plus de choses qu’on ne l’imagine. À la fin de cette lecture, tu sauras dire ce qu’est un LLM en une phrase, comment on passe d’un simple compléteur de texte à un assistant, et ce que tu peux en attendre ou non.
Sommaire
- L’essentiel en 30 secondes
- Un LLM, c’est d’abord un jeu de complétion
- Du texte aux tokens : ce qu’un LLM lit et écrit
- De l’autocomplétion à l’assistant : trois entraînements
- Pourquoi « grand » change la nature du modèle
- Un modèle, mille tâches : ce qu’on peut lui demander
- Le même moteur, plusieurs produits
- Cinq idées reçues à lâcher
L’essentiel en 30 secondes
- Un LLM est un modèle qui prédit le token suivant, un token à la fois, en s’appuyant sur tout ce qui précède.
- Presque toute tâche (juger un sentiment, répondre, résumer) se reformule en complétion : une seule mécanique pour mille usages.
- Ce qu’il lit et écrit se compte en tokens, dans une fenêtre de contexte limitée.
- Ce sont l’instruction tuning et le RLHF qui transforment l’autocomplétion en assistant.
- Un LLM n’est pas un produit : ChatGPT est une application bâtie dessus, et le modèle peut halluciner et hériter de biais.
Un LLM, c’est d’abord un jeu de complétion
Un grand modèle de langage (LLM, pour large language model) est un modèle de prédiction du token suivant, c’est-à-dire, à peu près, du mot suivant. Il a lu des volumes massifs de texte humain, y a repéré des régularités statistiques, et sait proposer une suite plausible à un début de phrase.
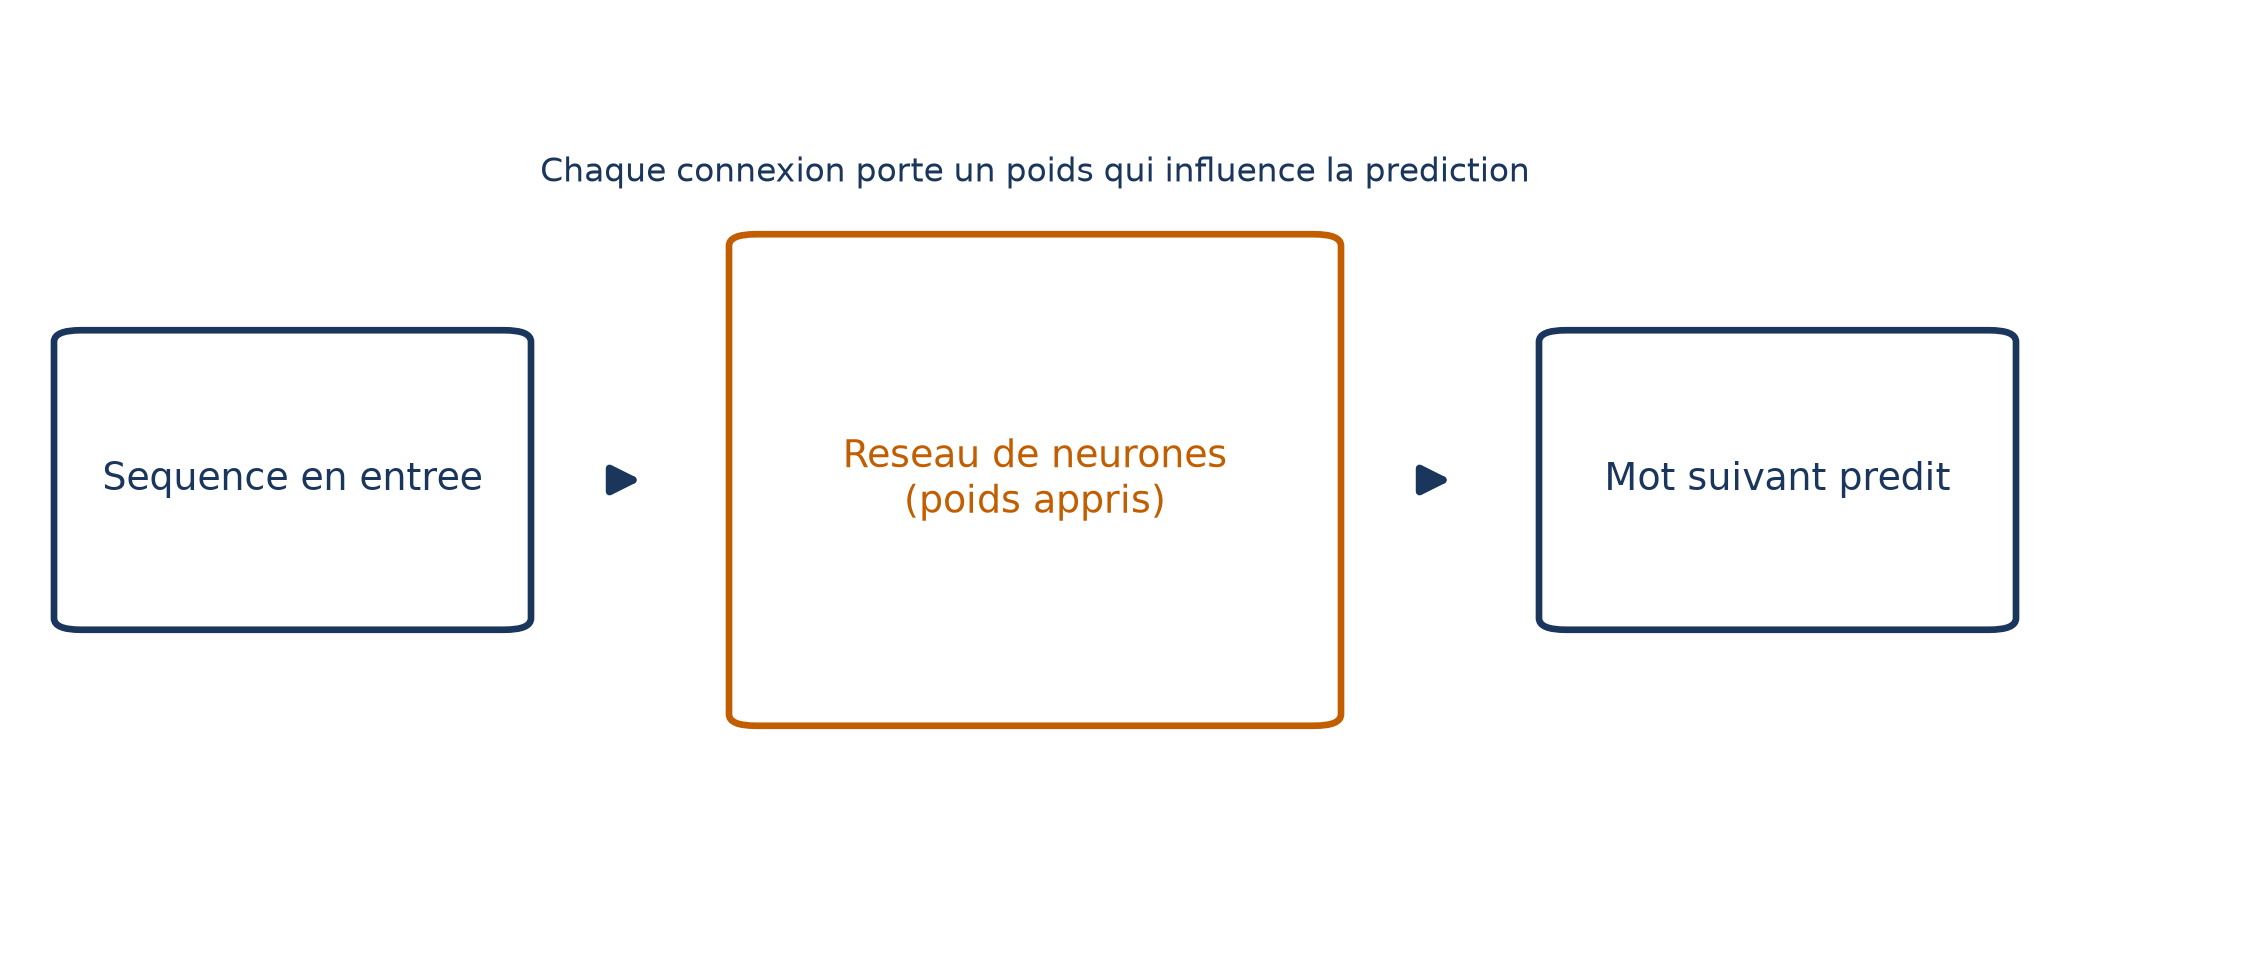
« Never gonna » en est un bon exemple : un modèle nourri de suffisamment de culture populaire répondra « give you up ». Tout le dispositif tient en trois blocs : une séquence entre, un réseau de neurones dont chaque connexion porte un poids appris pendant l’entraînement, un mot suivant prédit sort.
Ce mécanisme semble trop mince pour expliquer ce que font les assistants. Pourtant, presque toute tâche se reformule en complétion. Pour juger le sentiment d’un avis, on écrit « Le sentiment de la phrase j’aime la pizza est », puis on regarde quel token le modèle juge le plus probable ensuite : « positif » ou « négatif ».

Le trait vertical se lit « sachant que » : à gauche, le token candidat ; à droite, tout ce qui précède, soit le contexte. On compare les deux probabilités et on retient la plus forte.
Le principe se généralise. Une question devient la probabilité de la bonne réponse sachant la question, un résumé la probabilité du résumé sachant l’article d’origine : dans tous les cas, la réponse est le token le plus probable après la séquence précédente.
💡 Intuition Un LLM ne « répond » pas à ta question : il écrit la suite la plus plausible d’un texte qui commence par ta question.
Reste le mot « grand ». Pour que le modèle apprenne à la fois des connaissances et la façon de les utiliser, on l’entraîne sur des milliards de mots de sources variées : web, textes édités, articles, code publié sur GitHub, langues différentes. Cette diversité lui apporte des connaissances, mais aussi des exemples de tâches.
Du texte aux tokens : ce qu’un LLM lit et écrit
Le modèle ne manipule ni lettres ni mots entiers, mais des tokens : des nombres qui représentent des morceaux de texte. Les LLM modernes découpent en sous-mots, avec un token pour un mot courant ou un signe de ponctuation, et plusieurs tokens pour un mot rare. On les appelle aussi « jetons ».
Convertir du texte en tokens, et des tokens en texte, ne demande aucun réseau de neurones : le tokeniseur est une simple table de correspondance, et l’ensemble de cette table forme le vocabulaire du modèle. La plupart des modèles dépassent 100 000 tokens de vocabulaire ; moins un schéma de découpage exige de tokens pour écrire une sortie, plus la génération va vite.
Pour avoir un ordre de grandeur, un token vaut en moyenne les trois quarts d’un mot, soit environ quatre caractères : 1 000 tokens, environ 750 mots anglais.
Tout ce qui entre et sort pendant une requête doit tenir dans la fenêtre de contexte, le nombre maximal de tokens que le modèle peut ingérer et sur lesquels il peut porter son attention en un seul appel. C’est, en pratique, la mémoire de travail de la requête : ta question, tes consignes, l’historique de la conversation et la réponse en cours d’écriture s’y partagent la place.
Cette fenêtre a beaucoup grandi. Elle est passée de 4 000 tokens (environ 3 000 mots, 12 pages) à 8 000 (6 000 mots, 24 pages), puis à un maximum de 272 000 tokens en entrée pour GPT-5 et Claude 3.7 Sonnet, et jusqu’à un million pour Gemini 2.5, soit environ 750 000 mots. Dans le cas le plus simple, quand la fenêtre est pleine, seules les interactions les plus récentes sont conservées.
Pourquoi s’en soucier ? Avec 512 tokens de contexte, un modèle qui résume des avis n’en voit qu’un seul ; avec une fenêtre plus large, il en analyse des centaines. Un contexte long l’aide aussi à produire des résumés plus cohérents et à suivre toute une conversation.
La réponse s’écrit ensuite en boucle. Un gabarit de conversation fusionne d’abord l’entrée et ses rôles en une seule séquence, qui est tokenisée. Une première phase, le prefill, traite toute la séquence d’entrée ; la seconde, le decode, produit la réponse un token à la fois.
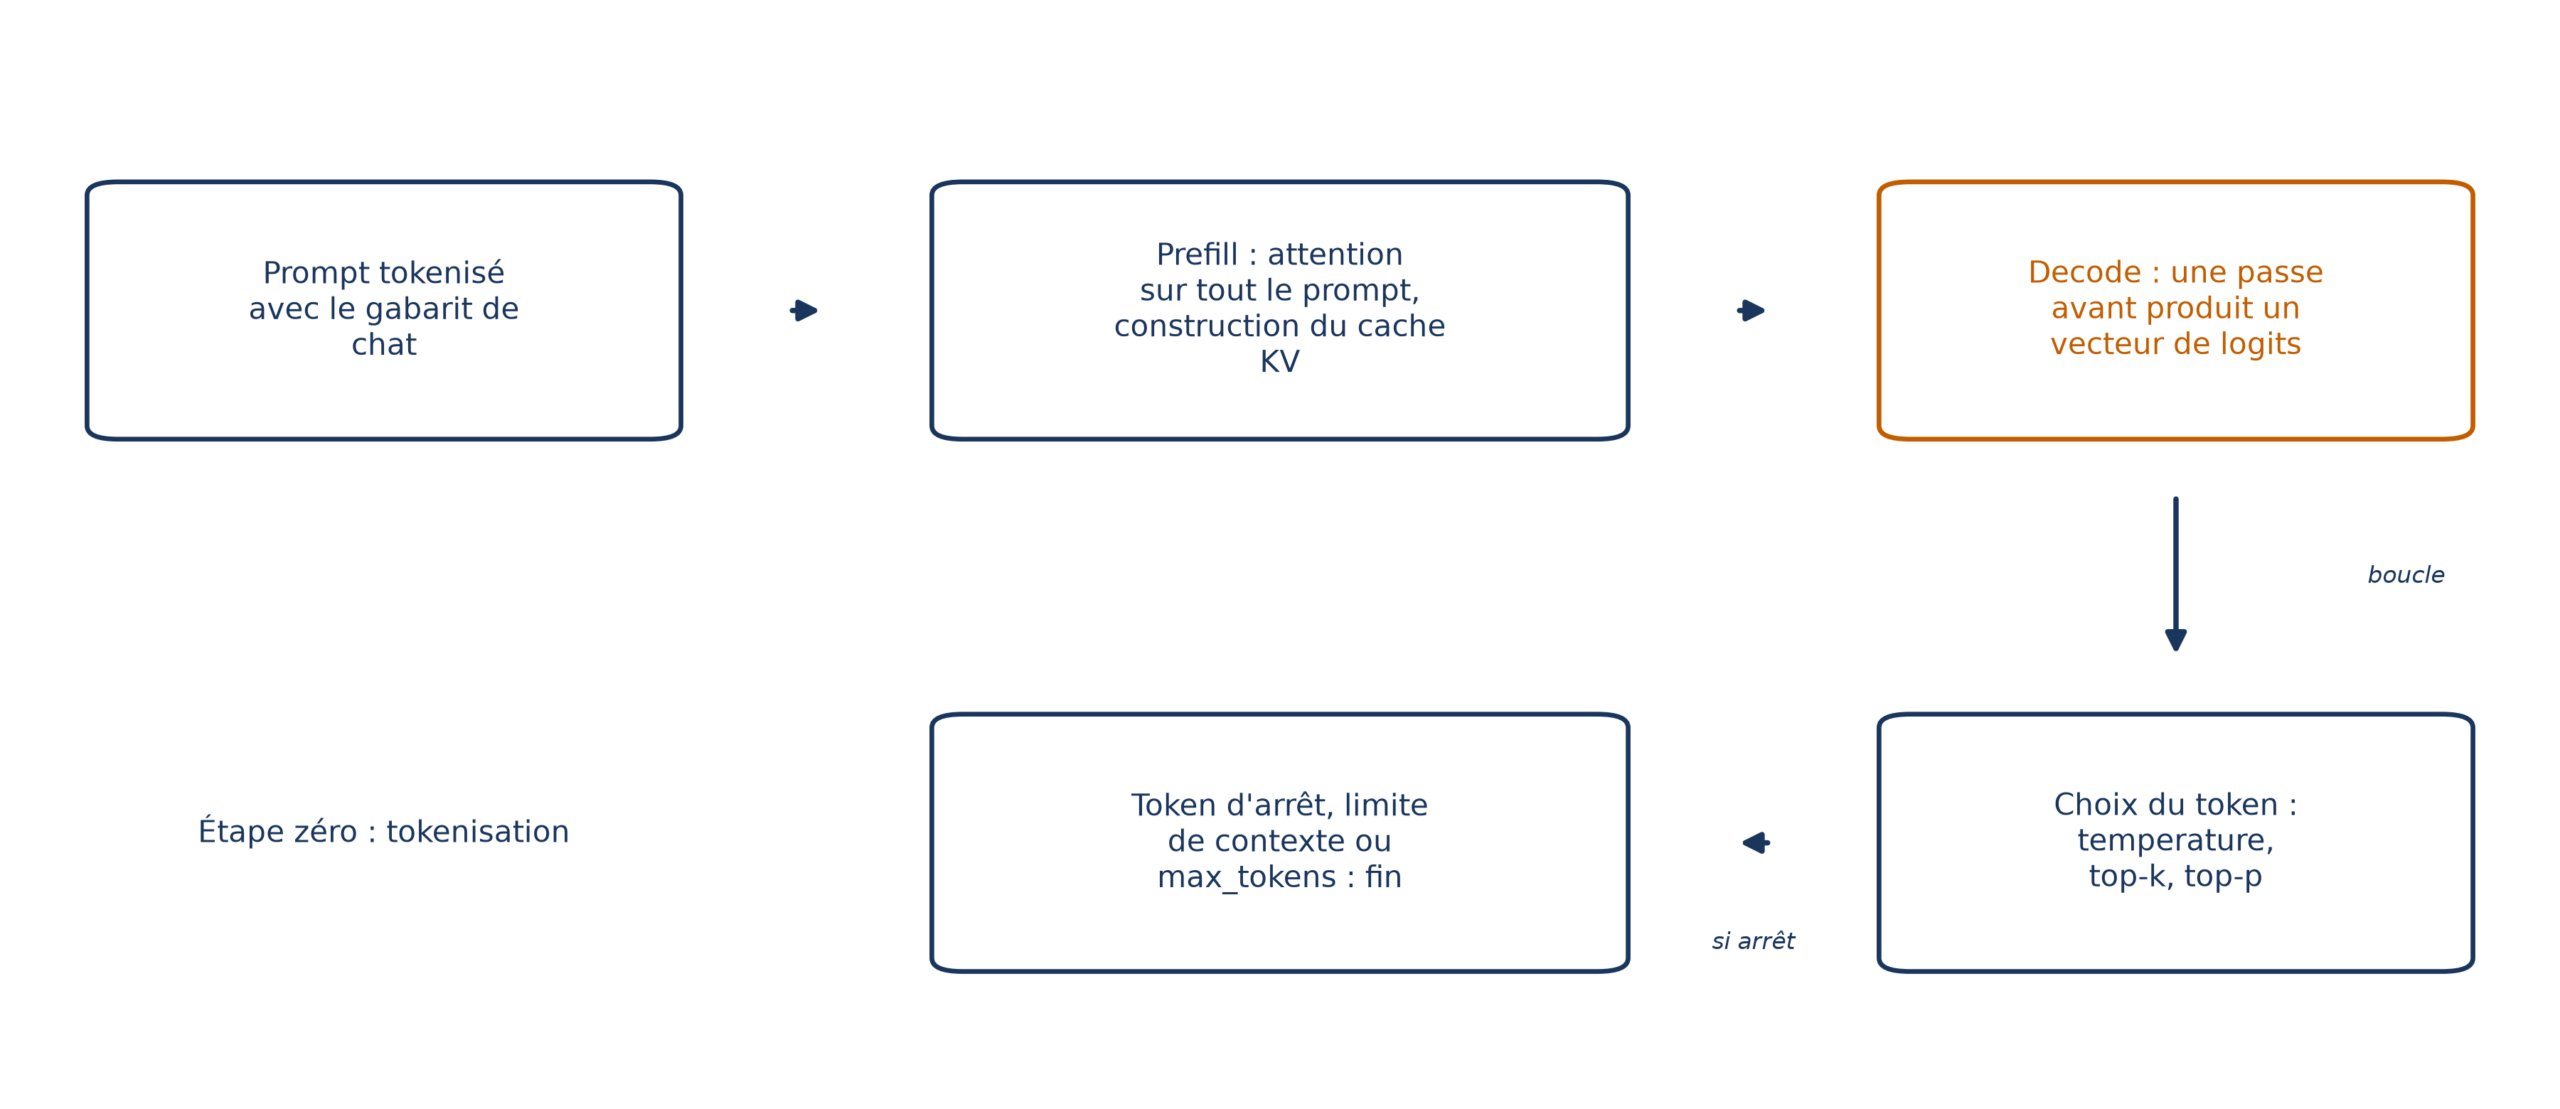
La boucle s’arrête dans trois cas : le modèle émet un token d’arrêt, une valeur spéciale qui marque la fin de la séquence de sortie ; la fenêtre de contexte est atteinte ; ou la requête a posé une limite supplémentaire avec l’argument max_tokens.
De l’autocomplétion à l’assistant : trois entraînements
Si un LLM n’est qu’un compléteur, pourquoi te répond-il au lieu de prolonger ta question par une autre question ? Parce que l’entraînement dont on vient de parler, le pré-entraînement, n’est que la première étape. À ce stade, le modèle n’est rien de plus qu’une autocomplétion sophistiquée ; avec cet objectif simple, il acquiert pourtant un vaste savoir et un large éventail de compétences.
Mais il n’a pas appris à exécuter des instructions, alors que la plupart des demandes qu’on lui adresse sont des tâches précises : rédiger un texte, créer une fonction, résumer un article.
Deuxième entraînement, l’instruction tuning : on poursuit l’apprentissage sur des paires instruction–sortie, annotées par des humains ou produites par d’autres LLM. Les jeux les plus riches couvrent jusqu’à 61 types de tâches (questions-réponses, résumé, classification, traduction, écriture créative…), et plus les tâches sont variées, meilleur est le jeu.
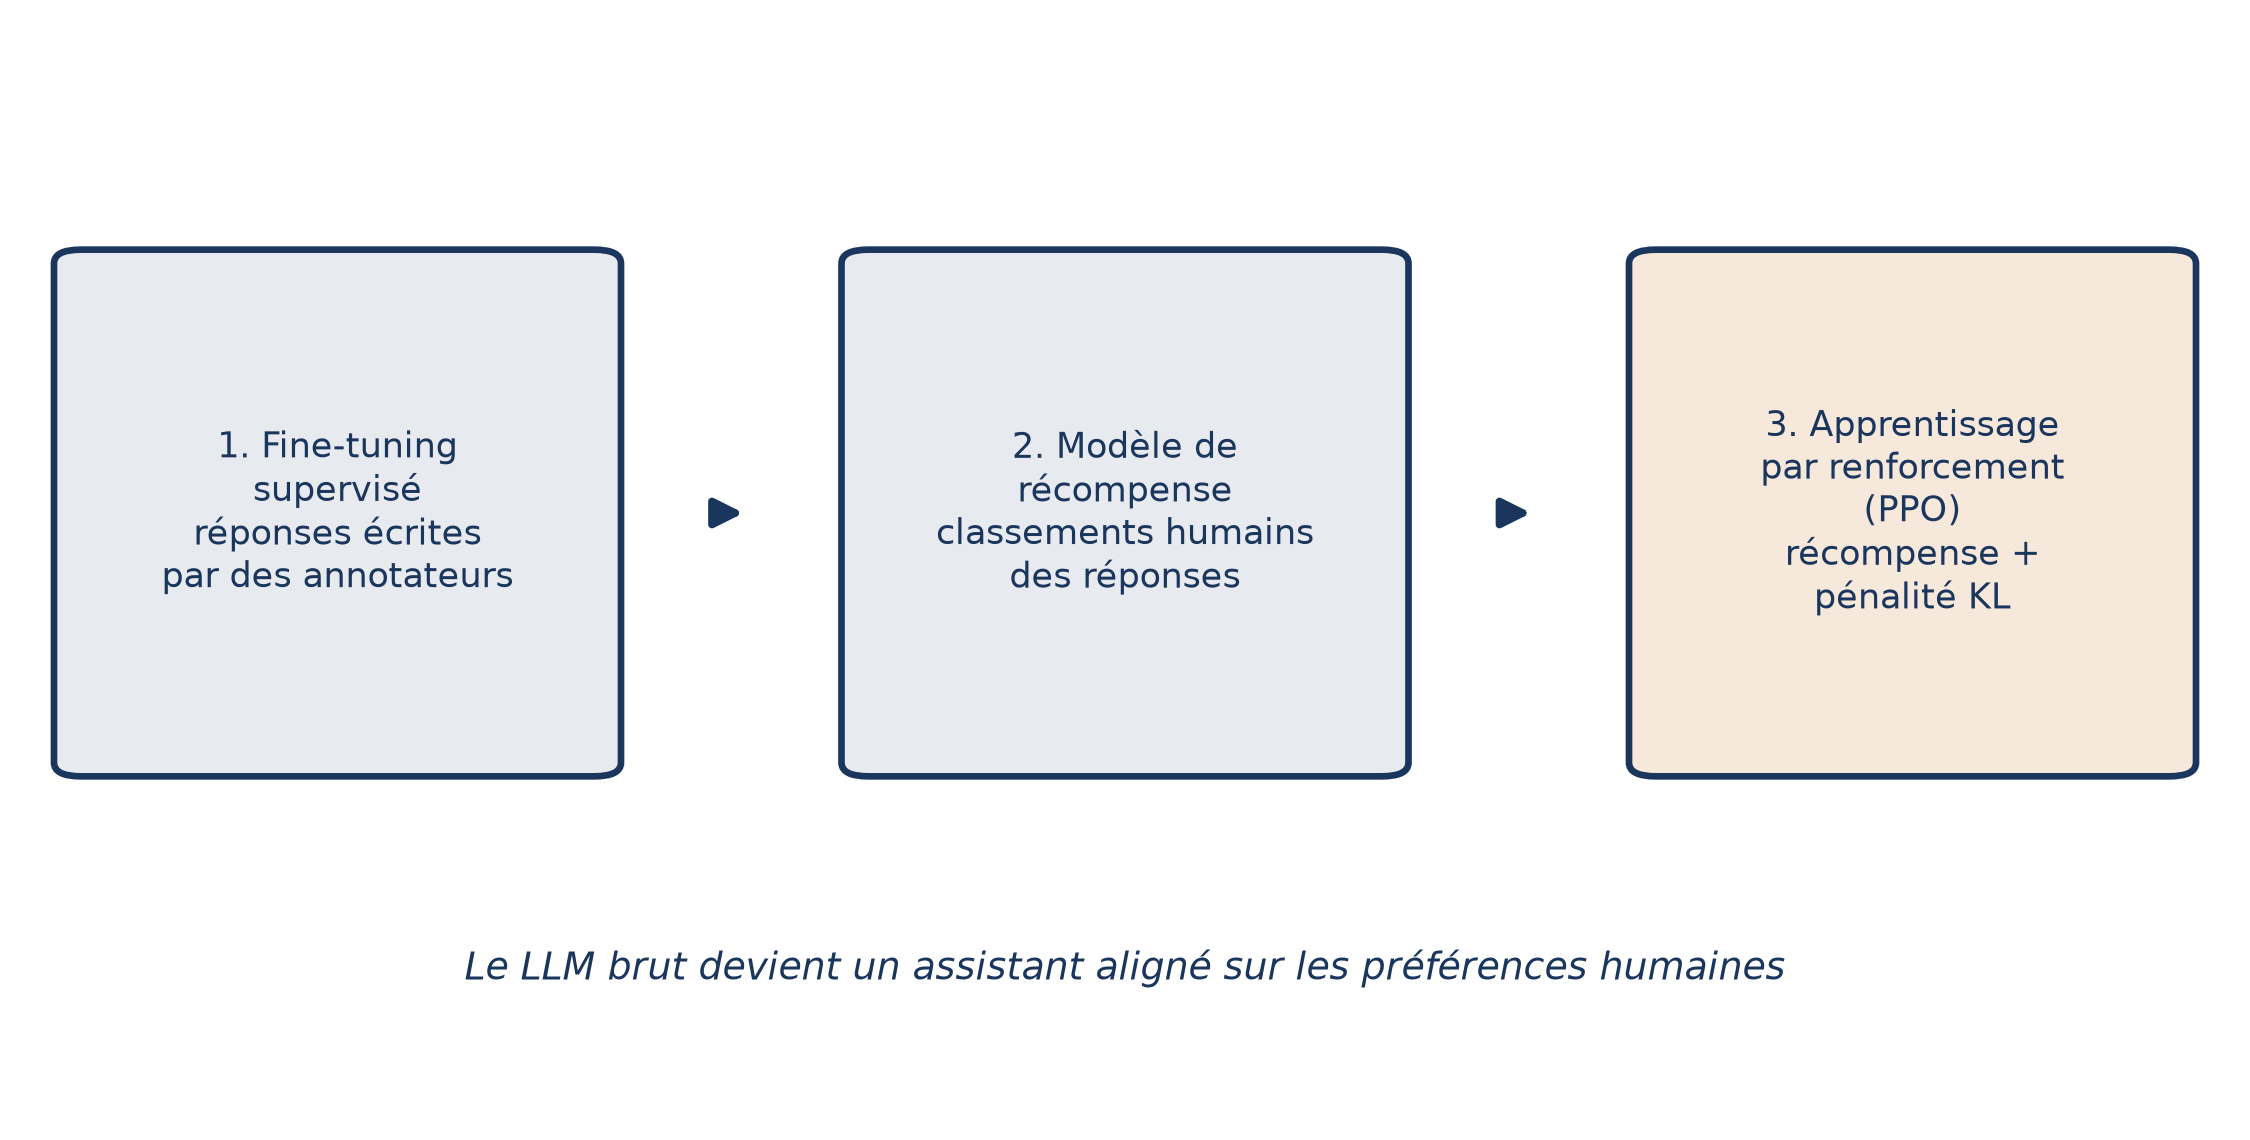
Reste un obstacle : ce qu’on attend d’un assistant (qu’il soit utile, honnête, inoffensif) est subjectif et difficile à coder dans un objectif mathématique. On a donc recours au retour humain : c’est l’apprentissage par renforcement à partir du retour humain, ou RLHF, qui se cache derrière le succès de ChatGPT. Il se déroule en trois étapes.
- Un fine-tuning supervisé : des annotateurs écrivent les sorties souhaitées pour une liste de prompts, et le modèle apprend à les imiter.
- Un modèle de récompense : le modèle génère plusieurs sorties par prompt, des annotateurs les classent de la plus à la moins préférée, et un second modèle apprend à résumer ce classement en une note unique.
- Le renforcement : une sortie est produite, la note est prédite, puis l’algorithme PPO met à jour le modèle. Une pénalité de divergence évite qu’il s’éloigne trop de son comportement d’origine, pour que le texte reste cohérent.
Cette recette est lourde : réunir des préférences humaines coûte cher, il faut des annotateurs sélectionnés pour éviter des réponses de qualité inégale, et le processus est complexe et instable. L’optimisation directe des préférences (DPO) en supprime une partie : plus de modèle de récompense, un jeu de triplets (prompt, moins bonne réponse, meilleure réponse) et une perte qui monte la probabilité de la meilleure réponse en baissant celle de la moins bonne.
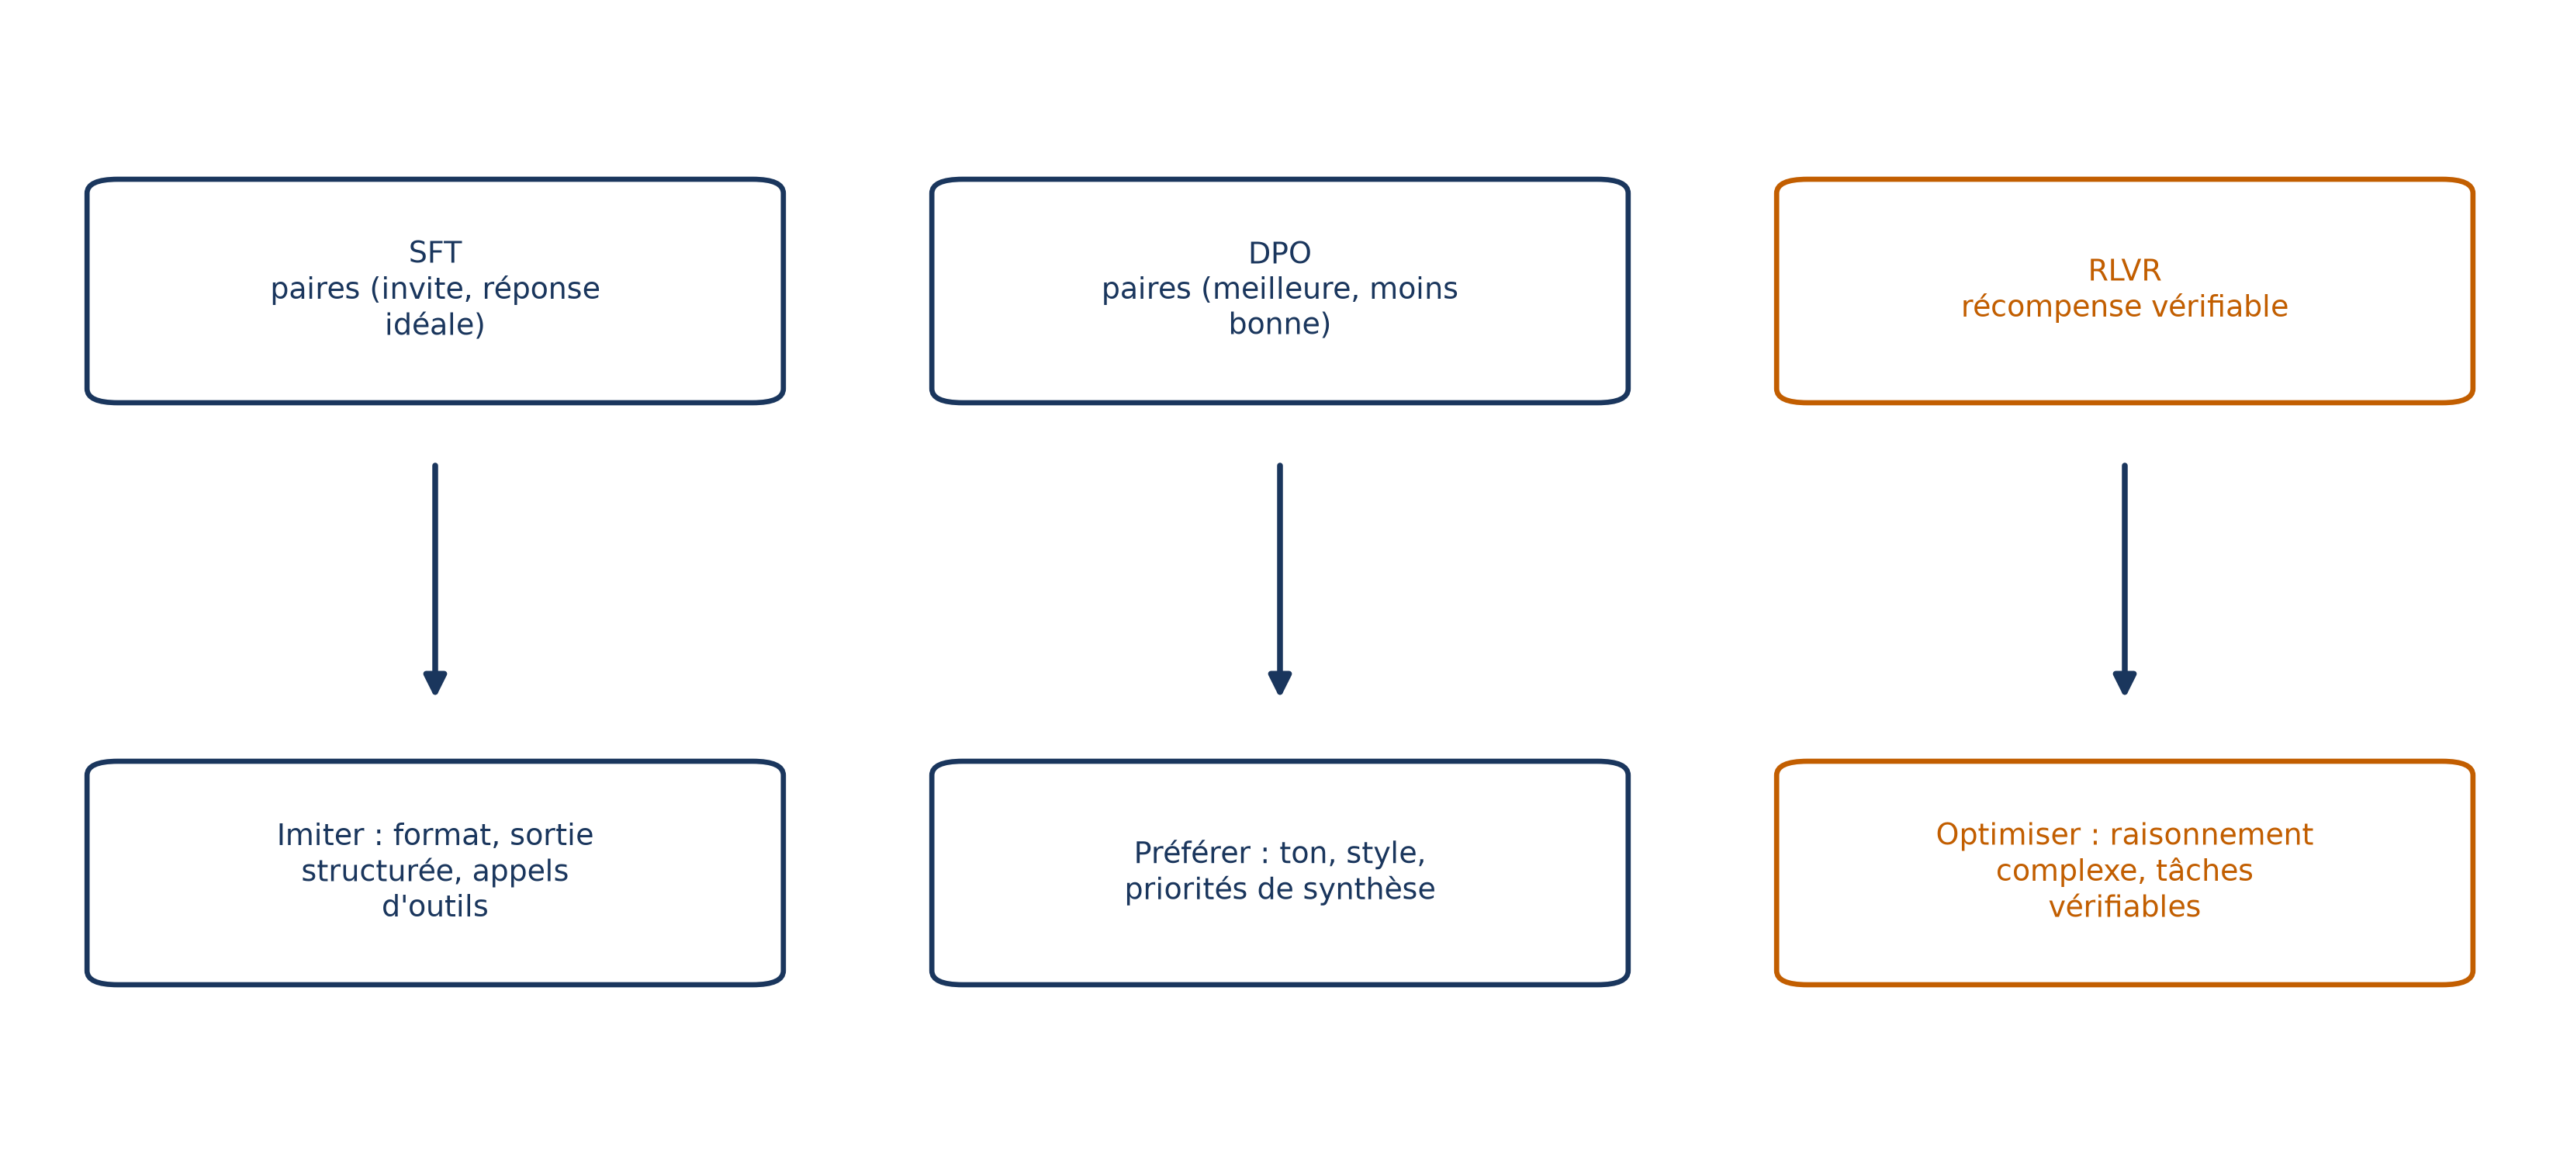
📌 À retenir Trois temps pour fabriquer un assistant : prédire (pré-entraînement), obéir (instruction tuning), être jugé utile (retour humain). C’est pourquoi réduire un LLM à une autocomplétion serait injuste : il écrit un haïku dans un style donné ou répond à une question sur le premier alunissage habité.
Les compétences conversationnelles des LLM ont ainsi progressé de façon exponentielle ces dernières années, grâce à l’alignement et à l’instruction tuning.
Pourquoi « grand » change la nature du modèle
Passer de 1 à plus de 100 milliards de paramètres n’ajoute pas seulement un peu de précision. Les chercheurs y ont observé des propriétés émergentes : des capacités absentes d’un petit modèle mais présentes dans un grand, qui apparaissent brutalement à une certaine échelle.
En dessous d’une taille critique, le modèle fait au hasard ; au-delà, il passe d’une performance quasi nulle à une performance proche de l’état de l’art, puis progresse linéairement avec la taille. C’est ce qu’on appelle une transition de phase, et on ne peut que l’observer, pas la prédire à l’avance.
💡 Intuition C’est un peu comme un enfant qui semble incapable de parler puis, passé un certain âge, articule des mots, et dont les compétences progressent ensuite régulièrement.
Chaque capacité a son seuil :
- le calcul arithmétique apparaît au-delà de 10 milliards de paramètres ;
- l’auto-évaluation, la détection de figures de style et la déduction logique, au-delà de 100 milliards ;
- le jugement causal et la reconnaissance de formes géométriques, au-delà de 500 milliards.
Passé 100 milliards, le modèle comprend aussi des instructions et les suit sans qu’on lui montre d’exemples.
⚠️ Piège Ces seuils sont contestés. Des études ultérieures montrent que les LLM possèdent ces capacités, mais qu’elles deviennent plus visibles à partir d’une certaine limite de performance, et que le succès à ces tâches semble mal mesuré. Lis donc ces chiffres comme des ordres de grandeur, pas comme des interrupteurs.
Un modèle, mille tâches : ce qu’on peut lui demander
Avant les grands modèles génératifs, bâtir une application d’apprentissage automatique exigeait d’embaucher un ingénieur ou un spécialiste des données, de collecter des exemples, puis de déployer un modèle. Un seul LLM, lui, s’adapte à une grande variété de tâches sans entraînement supplémentaire, et un modèle préentraîné de haute qualité s’obtient par un simple appel à un service hébergé.
Concrètement, il sait :
- résumer de longs documents, par exemple en analyse juridique ou en synthèse de recherche ;
- manipuler des données non structurées (courriels, journaux, rapports) ;
- écrire du code et des tests unitaires ;
- automatiser des tâches répétitives de service client.
Comment lui dit-on quoi faire ? Par le prompt, sans réentraîner quoi que ce soit. C’est l’apprentissage en contexte : le modèle met en rapport l’instruction du prompt avec ce qu’il a appris, et résout ainsi la tâche.
Si tu glisses quelques exemples de questions-réponses dans le prompt, on parle de few-shot (one-shot ou two-shot selon leur nombre), et de zero-shot s’il n’y en a aucun. Demander des étapes de raisonnement intermédiaires, la technique du chain-of-thought, améliore les résultats sur les tâches de raisonnement complexe. Le modèle sait d’ailleurs enchaîner ses idées pour résoudre des équations ou déboguer du code.
Revenons à notre pizza. Comment demander le sentiment d’une phrase depuis un programme ? Un appel suffit : tu prépares ton prompt (ta consigne et la phrase), tu l’envoies au modèle, tu lis la réponse.
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="gpt-4o-mini",
    temperature=0,
    max_tokens=None,
    timeout=None,
    max_retries=2
)
response = llm.invoke([("human", augmented_prompt)])
answer = response.content
print(answer)
Ici, augmented_prompt est une simple chaîne de texte préparée avant l’appel, avec ta question et tes consignes. model choisit le modèle ; temperature=0 rend la sortie déterministe, puisqu’on prend toujours le token le plus probable ; max_tokens=None n’ajoute aucune limite de sortie en plus de celle de la fenêtre de contexte.
Un LLM seul ne peut pourtant accomplir aucune action : il produit du texte. Pour agir, il faut le relier à des outils. Si tu demandes « quel animal y a-t-il sur l’image ? », un LLM orchestrateur déduit qu’il lui faut un classifieur d’images, l’appelle, reçoit sa sortie, puis la met en phrase : « l’animal est un poulet ».
Le même moteur, plusieurs produits
Quand tu discutes avec ChatGPT, tu n’utilises pas « un LLM » : tu utilises une interface conversationnelle construite sur des LLM comme GPT-4. La nuance compte. En septembre 2023, la fonction « Browse with Bing » a permis à ChatGPT Plus d’aller chercher des informations en direct sur le web : c’est une fonctionnalité de l’application, activée par des mécanismes de recherche, alors que le modèle sous-jacent ne possède toujours pas ces informations.
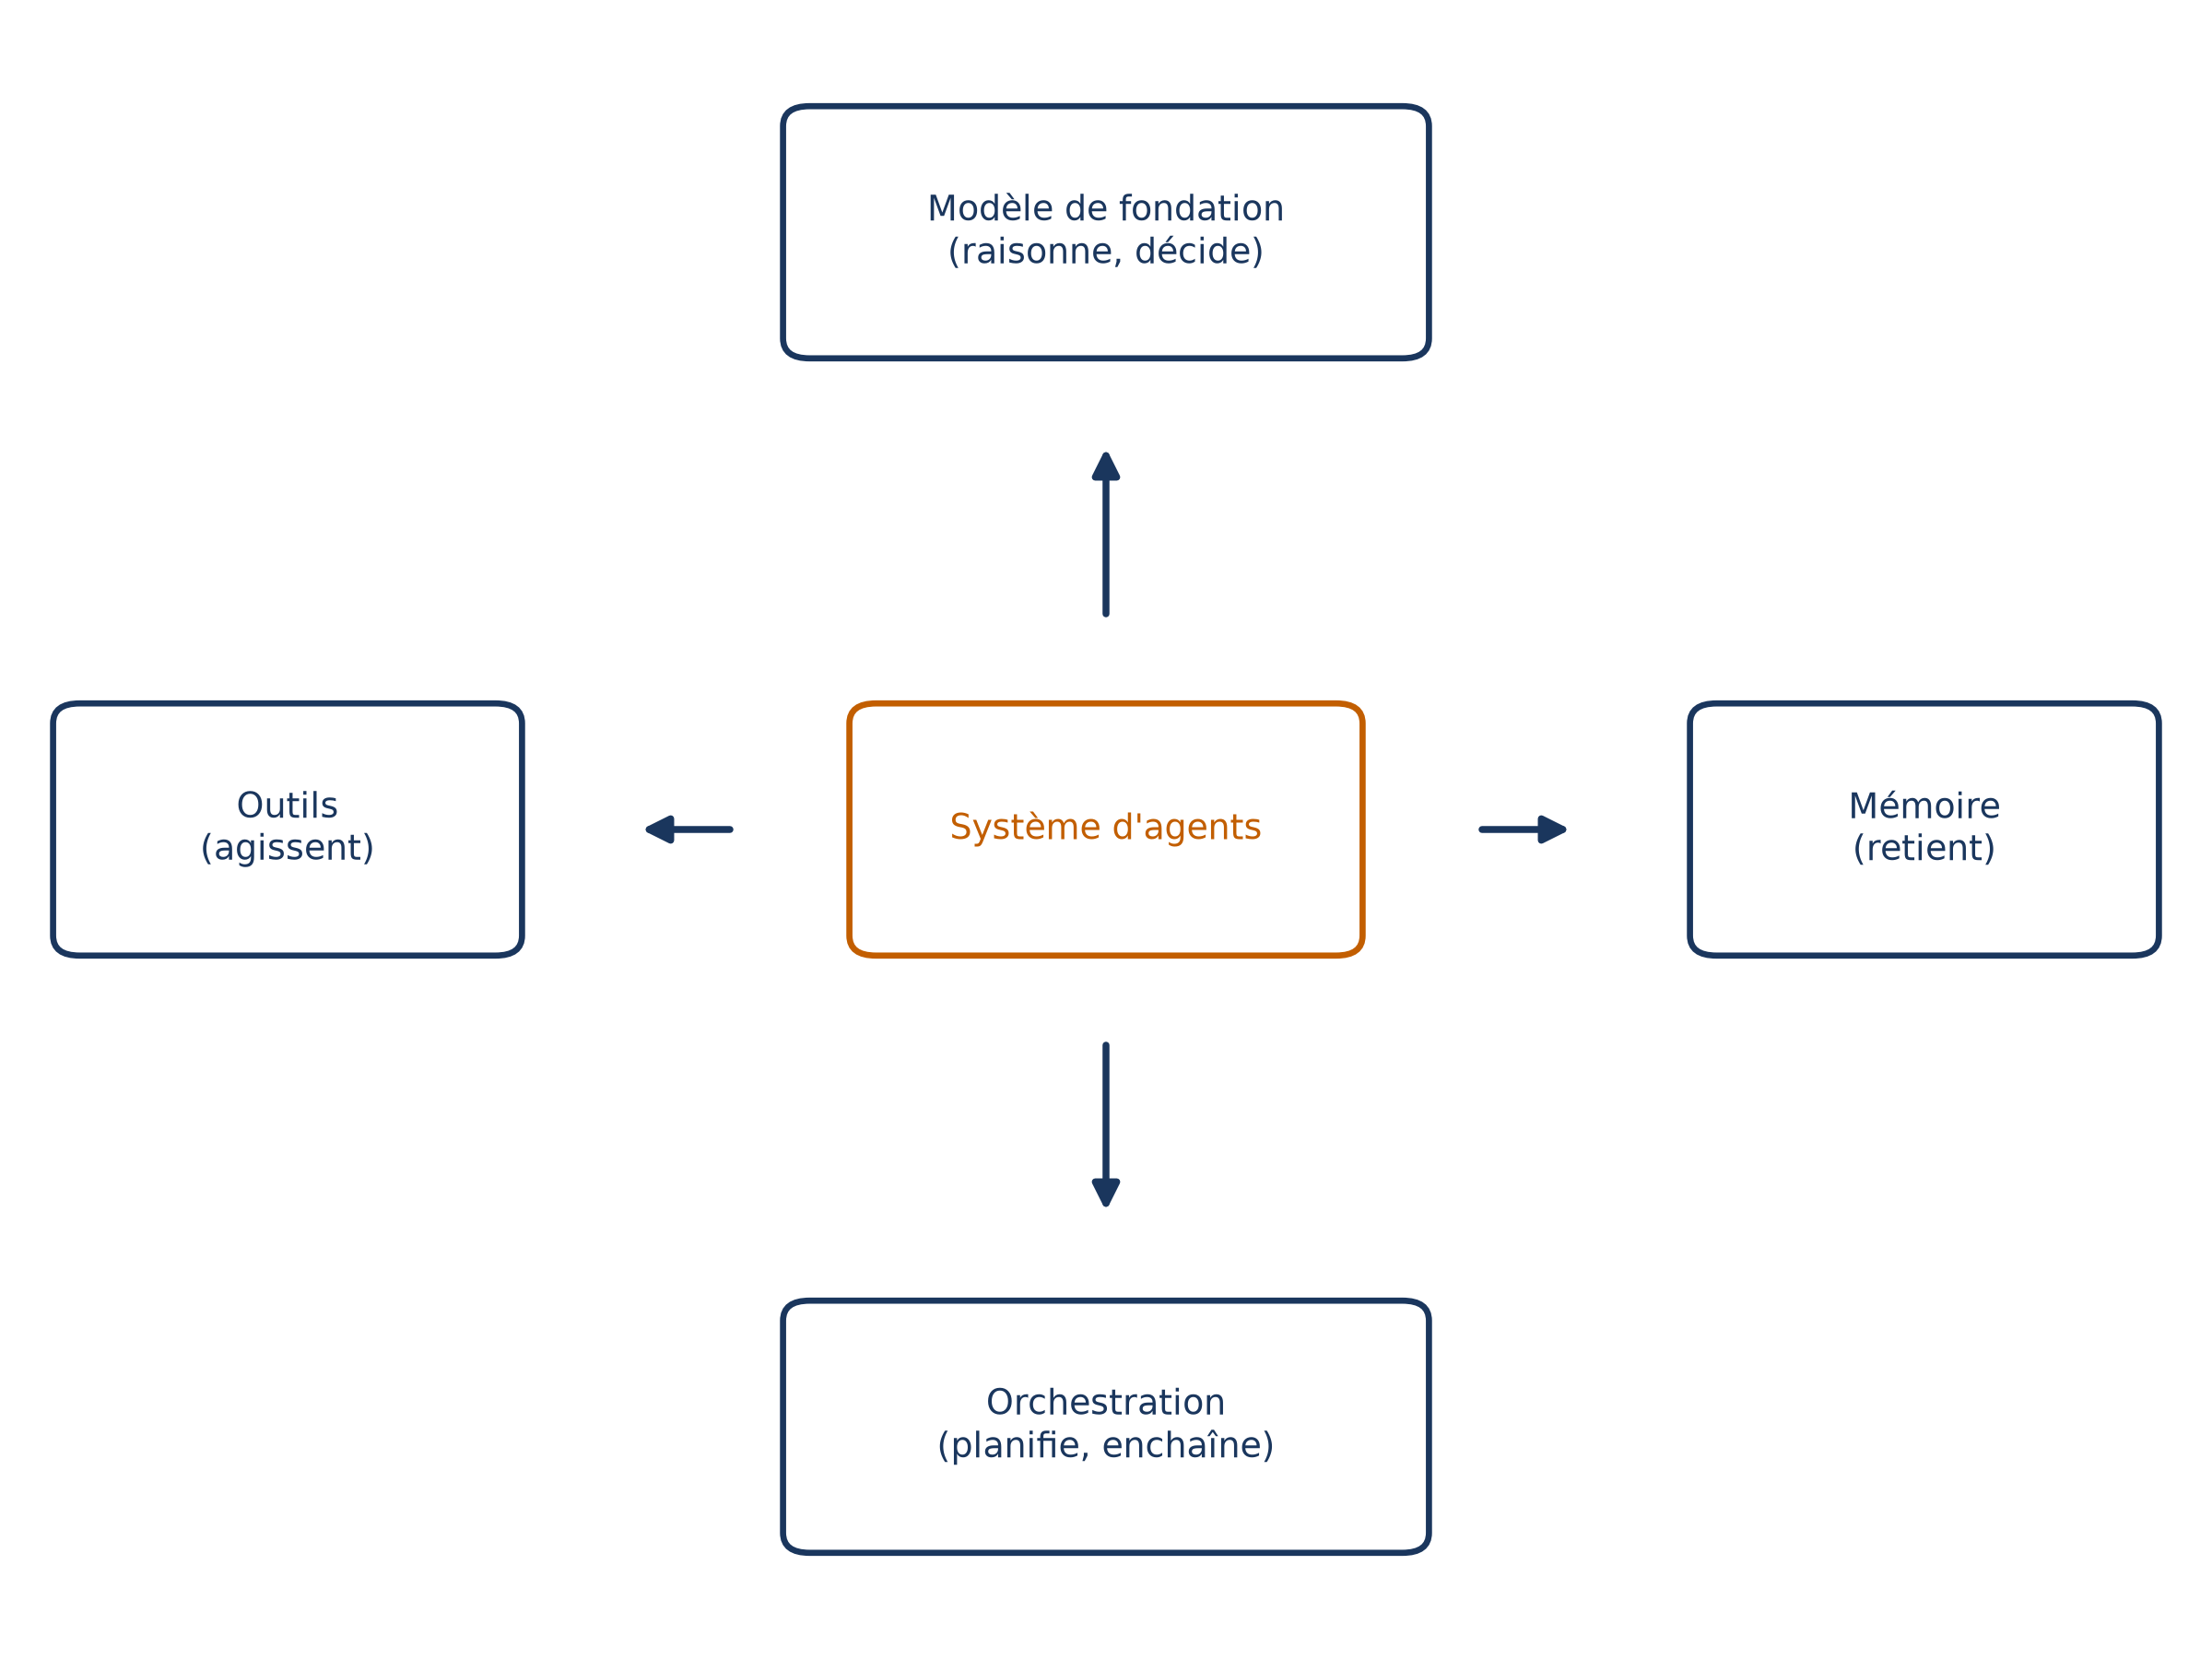
Cette case du haut porte un nom : le modèle de fondation, un grand modèle préentraîné sur d’immenses jeux de données généralistes, qui lui donnent un vaste socle de connaissances linguistiques et conceptuelles. OpenAI, Anthropic, Google, Meta et DeepSeek en proposent de pointe. Au classement HELM d’août 2025, GPT-5 mini prend la tête avec un score moyen de 0,819, suivi de près par o4-mini (0,812) et o3 (0,811) ; Qwen3, Grok 4, Claude 4 et Kimi K2 restent très compétitifs.
Reste à choisir entre deux familles, qui ne s’opposent pas sur la qualité mais sur l’accès :
| Modèles propriétaires | Modèles à poids ouverts | |
|---|---|---|
| Exemples | GPT, Gemini, Claude | Llama, Mistral, Gemma |
| Accès | par une API ; poids et données d’entraînement fermés | poids publiés : qui a le matériel peut l’exécuter sans payer d’accès |
| Personnalisation | limitée | transparence totale, affinage possible, mais plus d’ingénierie |
| Infrastructure | gérée pour toi, mais des coûts qui peuvent grimper vite | à ta charge : jusqu’à environ 14 milliards de paramètres sur une carte RTX 3090 (24 Go), un GPU de serveur au-delà |
Plus gros ne veut pas dire mieux adapté. Un petit modèle de langage suffit souvent pour une tâche précise : il perd en polyvalence, mais consomme bien moins de ressources et tourne sur un GPU grand public, voire un CPU. Il y a toutefois un plancher de capacité : quelques couches suffisent pour la grammaire, il en faut davantage pour la cohérence et la créativité, et un modèle d’une seule couche ne sait pas suivre une instruction.
Pour en obtenir un, trois voies existent : entraîner un petit modèle de zéro (Mistral 7B et LLaMA 7B l’ont été ainsi), distiller les connaissances d’un grand modèle vers un petit, ou réduire un modèle existant par quantification ou élagage.
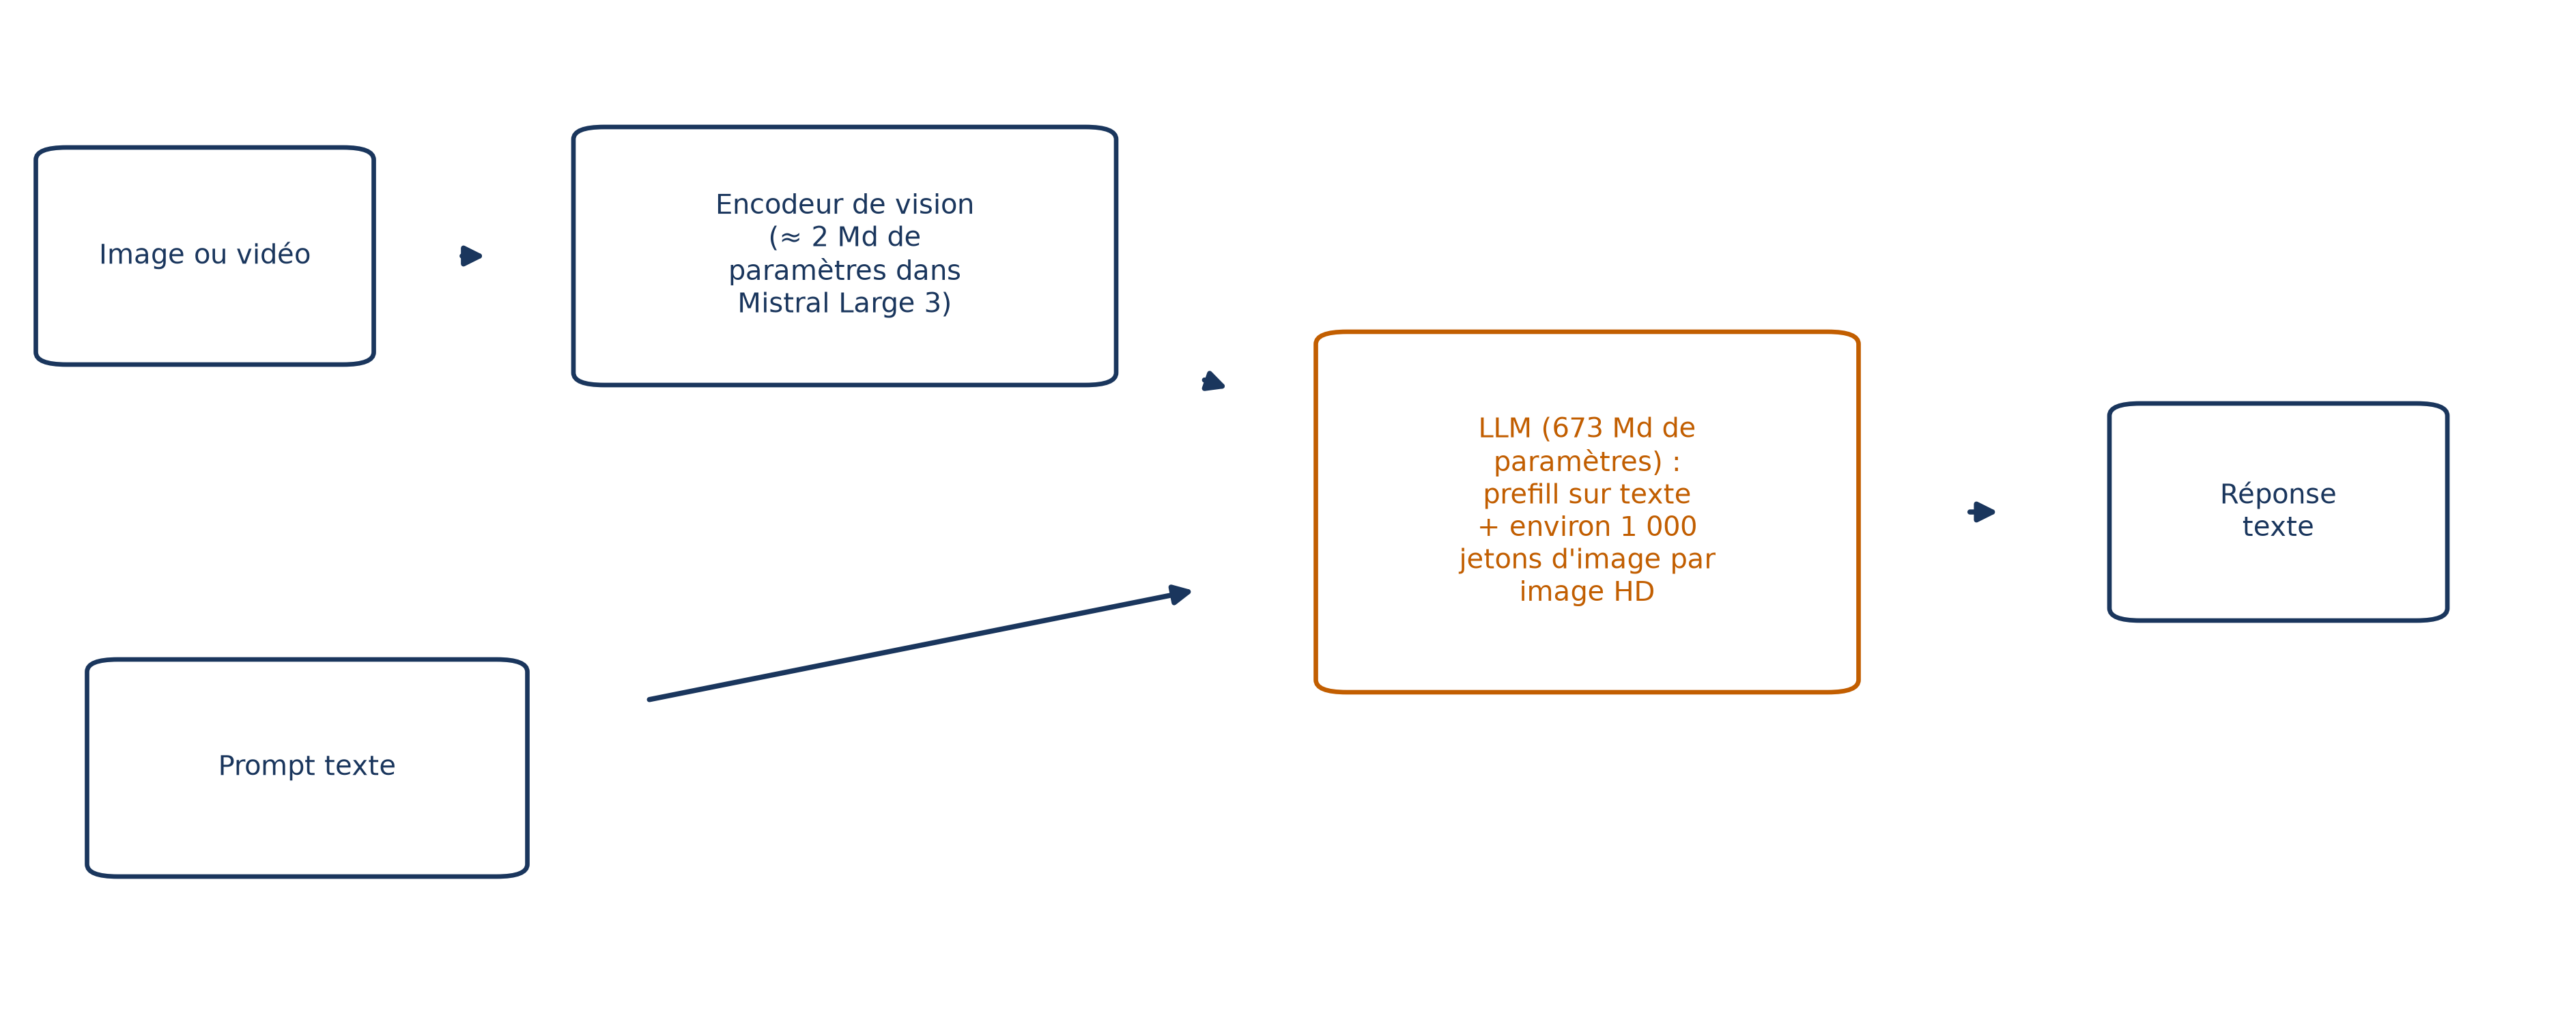
Reste la question des images. Un LLM, au sens strict, ne lit que du texte : même si ChatGPT-4o accepte aujourd’hui des images, cette fonction ne fait pas techniquement partie du LLM. Les modèles vision-langage lui adjoignent un petit encodeur de vision qui convertit images et vidéos en tokens d’image.
Cinq idées reçues à lâcher
« Il comprend ce qu’il dit »
Denis Diderot disait qu’un perroquet capable de répondre à tout mériterait, sans hésiter, d’être tenu pour un être pensant. Un LLM pourrait se définir comme un perroquet sophistiqué : répondre n’est pas comprendre, et l’on ne tient donc pas aujourd’hui les LLM pour des êtres intelligents. Ils répondent pourtant à presque toutes les questions avec un talent étonnant.
« Il ne se trompe que sur les sujets obscurs »
On parle d’hallucination quand le modèle produit un contenu absurde ou infidèle. L’hallucination factuelle contredit des faits réels et vérifiables ; l’hallucination de fidélité s’écarte des instructions ou du contexte que tu as donnés. Le modèle est entraîné à produire un texte cohérent, mais n’a aucun moyen de réviser sa sortie ni de vérifier qu’elle est correcte.
Les dates et les chiffres sont les premiers touchés. À l’entraînement, un concept se renforce par la répétition d’informations semblables : cela marche bien pour les concepts, moins pour les dates, les valeurs numériques ou les informations rares. Les jeux de données mêlent en outre des informations correctes et incorrectes, souvent contradictoires, et le modèle doit choisir parmi ce qu’il a appris quand il échantillonne sa réponse.
Deux facteurs aggravent les choses. Dans un domaine pointu, la perte est calculée sur l’ensemble des textes, donc davantage sur la connaissance générale que sur l’information particulière, quel que soit le nombre de paramètres. Et augmenter la température accroît l’aléa de l’échantillonnage, donc le tirage de tokens moins probables.
« Ce que je lui fournis l’emporte sur ce qu’il sait »
Pas toujours. Même quand les bons faits figurent dans la requête, le modèle peut produire une mauvaise sortie : il a ses propres connaissances a priori, et, ajusté sur instructions ou aligné, il décide implicitement d’utiliser le contexte ou de l’ignorer. Plus il est sûr de sa réponse, moins il est enclin à la changer.
Prends la question « quelle est la dose maximale du médicament X ? ». Si le modèle a vu 20 µg à l’entraînement et que le contexte indique 30, il répond 30 ; si le contexte indique 100, il maintient 20. Les grands modèles sont en général plus sûrs d’eux et préfèrent leur réponse, alors que les petits utilisent plus volontiers le contexte.
⚠️ Piège Le comportement dépend aussi du prompt : des consignes strictes forcent le modèle à utiliser le contexte, des consignes faibles le poussent vers ses connaissances a priori.
« Il apprend de chacune de nos conversations »
Non : ce que tu écris reste dans la fenêtre de contexte le temps de la requête. Contrairement aux humains, un LLM ne peut plus apprendre après la fin du pré-entraînement : l’ajustement est coûteux et ne peut servir à répétition, si bien que l’apprentissage continu reste un problème ouvert.
« Il est neutre »
Le modèle peut générer du contenu toxique et reproduire des stéréotypes envers des groupes démographiques. Ces biais viennent du jeu de pré-entraînement, qui reflète les textes humains dont il est tiré, avec un déséquilibre entre les textes produits aux États-Unis et ailleurs : le modèle hérite du point de vue des démographies dominantes.
Les conséquences deviennent concrètes si un LLM décide de la priorité d’accès à un traitement médical, à un emploi ou à un crédit : il peut le faire injustement, à cause des biais hérités de l’entraînement. Autre risque, ces textes crédibles et convaincants permettent d’automatiser la désinformation et l’hameçonnage.
Au bout du compte, un LLM est un compléteur de texte entraîné à très grande échelle, puis dressé à suivre des instructions et à répondre comme les humains le préfèrent. Garde cette image en tête : elle explique à la fois ses talents et ses faux pas.