Quelqu’un te tend un tableau de trente colonnes pour prédire une seule valeur, en jurant que tout compte. Tu soupçonnes qu’une bonne moitié n’est que du bruit, sans savoir laquelle. Le Lasso règle ce genre de doute en intégrant le tri dans le calcul même de la régression : à la fin de cette lecture, tu sauras ce qu’il fait, pourquoi certaines variables disparaissent et ce qu’il ne sait pas faire.
Sommaire
- L’essentiel en 30 secondes
- Une régression linéaire à qui l’on fait payer chaque coefficient
- Deux écritures du même modèle : un tarif ou un budget
- Pourquoi un losange fabrique des zéros
- Le Lasso face au tri exhaustif des variables
- Régler λ : un curseur posé par validation croisée
- Au-delà de la régression linéaire : un Lasso sur des essais cliniques
- Un modèle sobre, pas un modèle souple
L’essentiel en 30 secondes
- Le Lasso est une régression linéaire pénalisée : on ajoute à l’erreur un coût proportionnel à la somme des valeurs absolues des coefficients.
- Dès que le réglage λ est assez grand, certains coefficients tombent à exactement zéro : le modèle trie lui-même ses variables.
- Le même problème s’écrit sous un budget à ne pas dépasser ; la forme en losange de ce budget explique les zéros.
- λ se choisit par validation croisée, en comparant l’erreur de test de chaque valeur essayée.
- Le Lasso reste un modèle linéaire : il trie, il ne courbe pas.
Une régression linéaire à qui l’on fait payer chaque coefficient
Une régression linéaire choisit les coefficients  qui rendent la somme des carrés des écarts entre réponses observées et prédites, le RSS, la plus petite possible. Le Lasso garde ce critère et lui ajoute un prix : λ fois la somme des valeurs absolues des coefficients.
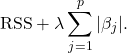
Le RSS mesure à quel point le modèle colle aux données. La somme des  mesure ce que le modèle « dépense » en coefficients, et
 est le tarif, un paramètre de réglage que tu fixes toi-même. Ce type de pénalité, sur les valeurs absolues, se nomme pénalité ℓ1 ; le cousin ridge pénalise au contraire la somme des carrés (pénalité ℓ2).
Deux forces s’opposent donc. Le RSS pousse à garder toutes les variables pour mieux coller aux données, la pénalité pousse chaque coefficient vers zéro. Quand λ devient assez grand, la pénalité l’emporte sur certains coefficients et les force à être exactement nuls : les variables correspondantes disparaissent du modèle, qui devient parcimonieux (sparse en anglais) et bien plus facile à lire.
💡 Intuition Vois λ comme un tarif au coefficient. Une variable qui n’apporte pas assez d’ajustement pour couvrir son prix n’a plus sa place dans le modèle : elle passe à zéro.
Deux écritures du même modèle : un tarif ou un budget
On peut poser le problème autrement, sans prix mais avec un plafond. Minimiser le seul RSS sous la contrainte que la somme des valeurs absolues des coefficients ne dépasse pas une valeur  revient au même problème que la version pénalisée.
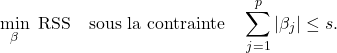
Ici, est un budget total à répartir entre tous les coefficients : en accorder davantage à une variable, c’est en retirer aux autres. Régler ou régler λ, c’est choisir jusqu’où le modèle a le droit de dépenser.
Le ridge admet la même double écriture, avec un plafond sur la somme des carrés au lieu de la somme des valeurs absolues. La forme de ce plafond va tout changer, comme tu vas le voir.
Pourquoi un losange fabrique des zéros
Prends un modèle à deux coefficients,  et
 , et dessine dans leur plan la zone que le budget autorise. Pour le Lasso, la contrainte
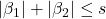 trace un losange dont les coins tombent sur les axes ; pour le ridge, la somme des carrés trace un disque.
Superpose maintenant les courbes de niveau du RSS : ce sont des ellipses centrées sur la solution des moindres carrés, celle qu’on obtiendrait sans aucune contrainte. La solution du problème sous budget est l’endroit où ces ellipses touchent la zone autorisée.
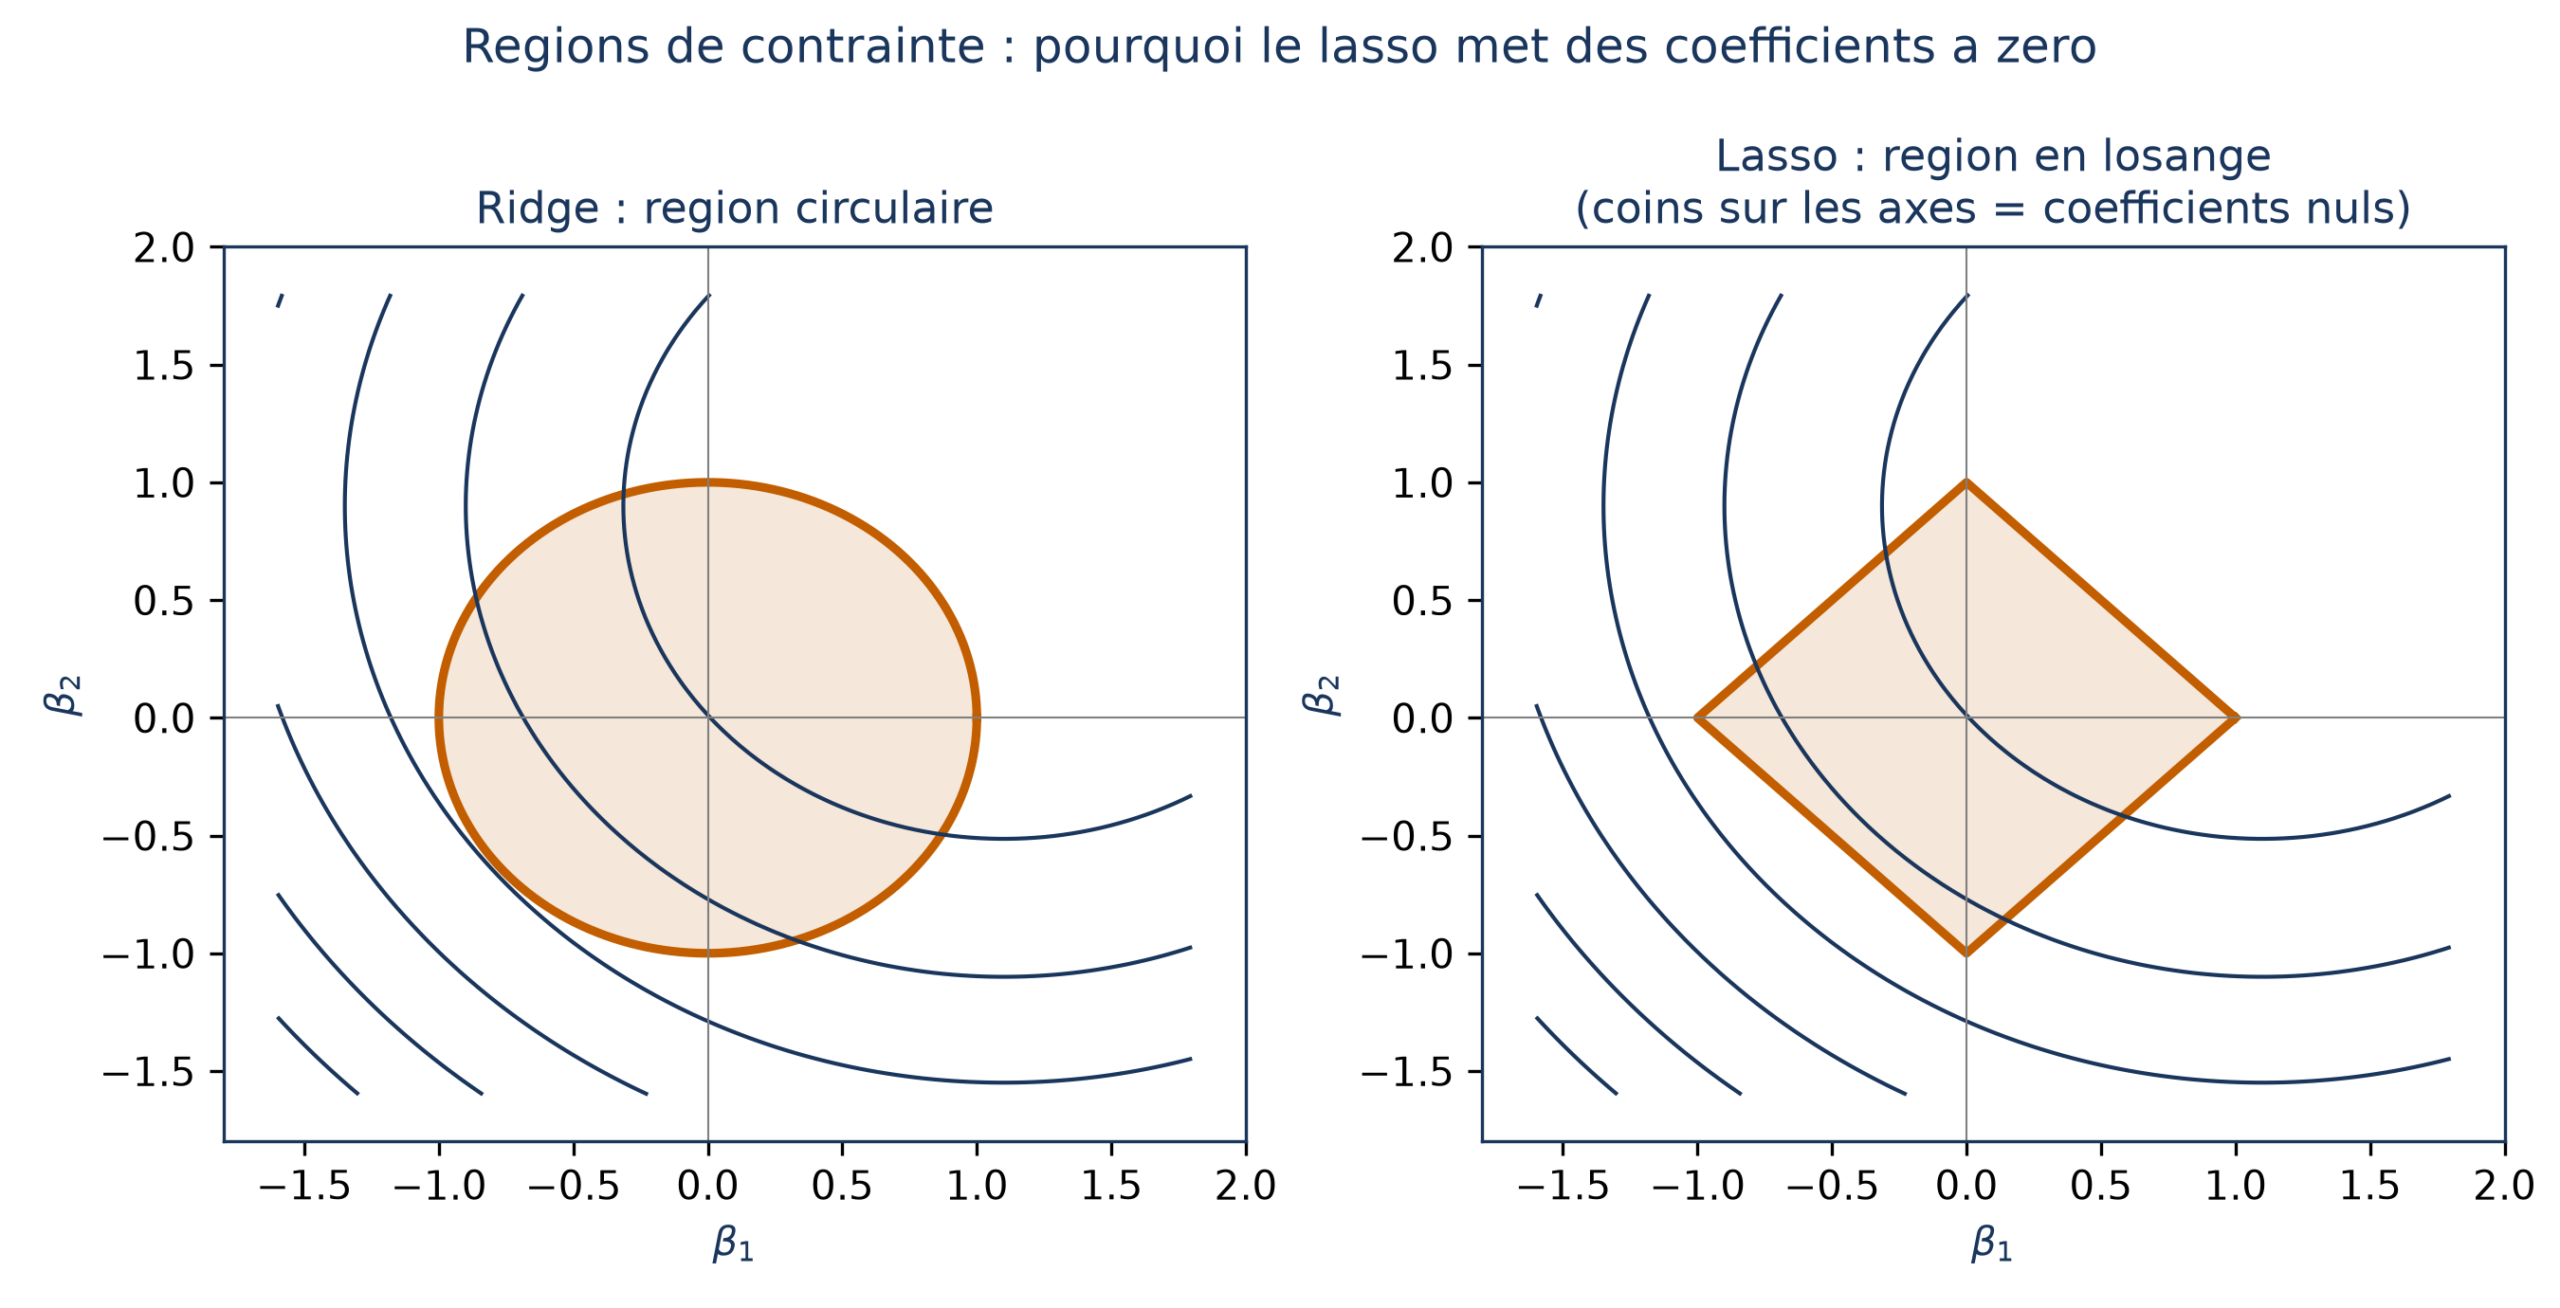
Avec beaucoup de variables, le même mécanisme joue sur des coins où un ou plusieurs coefficients valent zéro à la fois.
📌 À retenir Le zéro du Lasso n’est pas un arrondi ni un seuil posé à la main : il vient de la géométrie d’une contrainte aux coins pointus.
Le Lasso face au tri exhaustif des variables
Écarter les variables inutiles, d’autres méthodes le font déjà, par une route très différente. La sélection du meilleur sous-ensemble ajuste tous les modèles possibles pour chaque taille, retient le meilleur de chaque taille, puis compare les finalistes par leur erreur de test estimée. C’est la plus simple à comprendre, mais elle exige plus d’un milliard de modèles dès 30 variables.
Le Lasso ne trie pas avant d’ajuster. Il ajuste un modèle avec les  variables, mais contraint leurs coefficients, et c’est cette contrainte qui en met certains à zéro. Il réalise ainsi, comme la sélection de sous-ensembles, une vraie sélection de variables.
| Méthode | Ce qu’elle fait aux variables | Ce qu’il reste dans le modèle |
|---|---|---|
| Meilleur sous-ensemble | Choisit directement un groupe de variables | Le groupe retenu |
| Lasso | Contraint les coefficients par la somme des valeurs absolues | Les variables à coefficient non nul |
| Ridge | Rétrécit tous les coefficients | Toutes les variables, aucune annulée |
Régler λ : un curseur posé par validation croisée
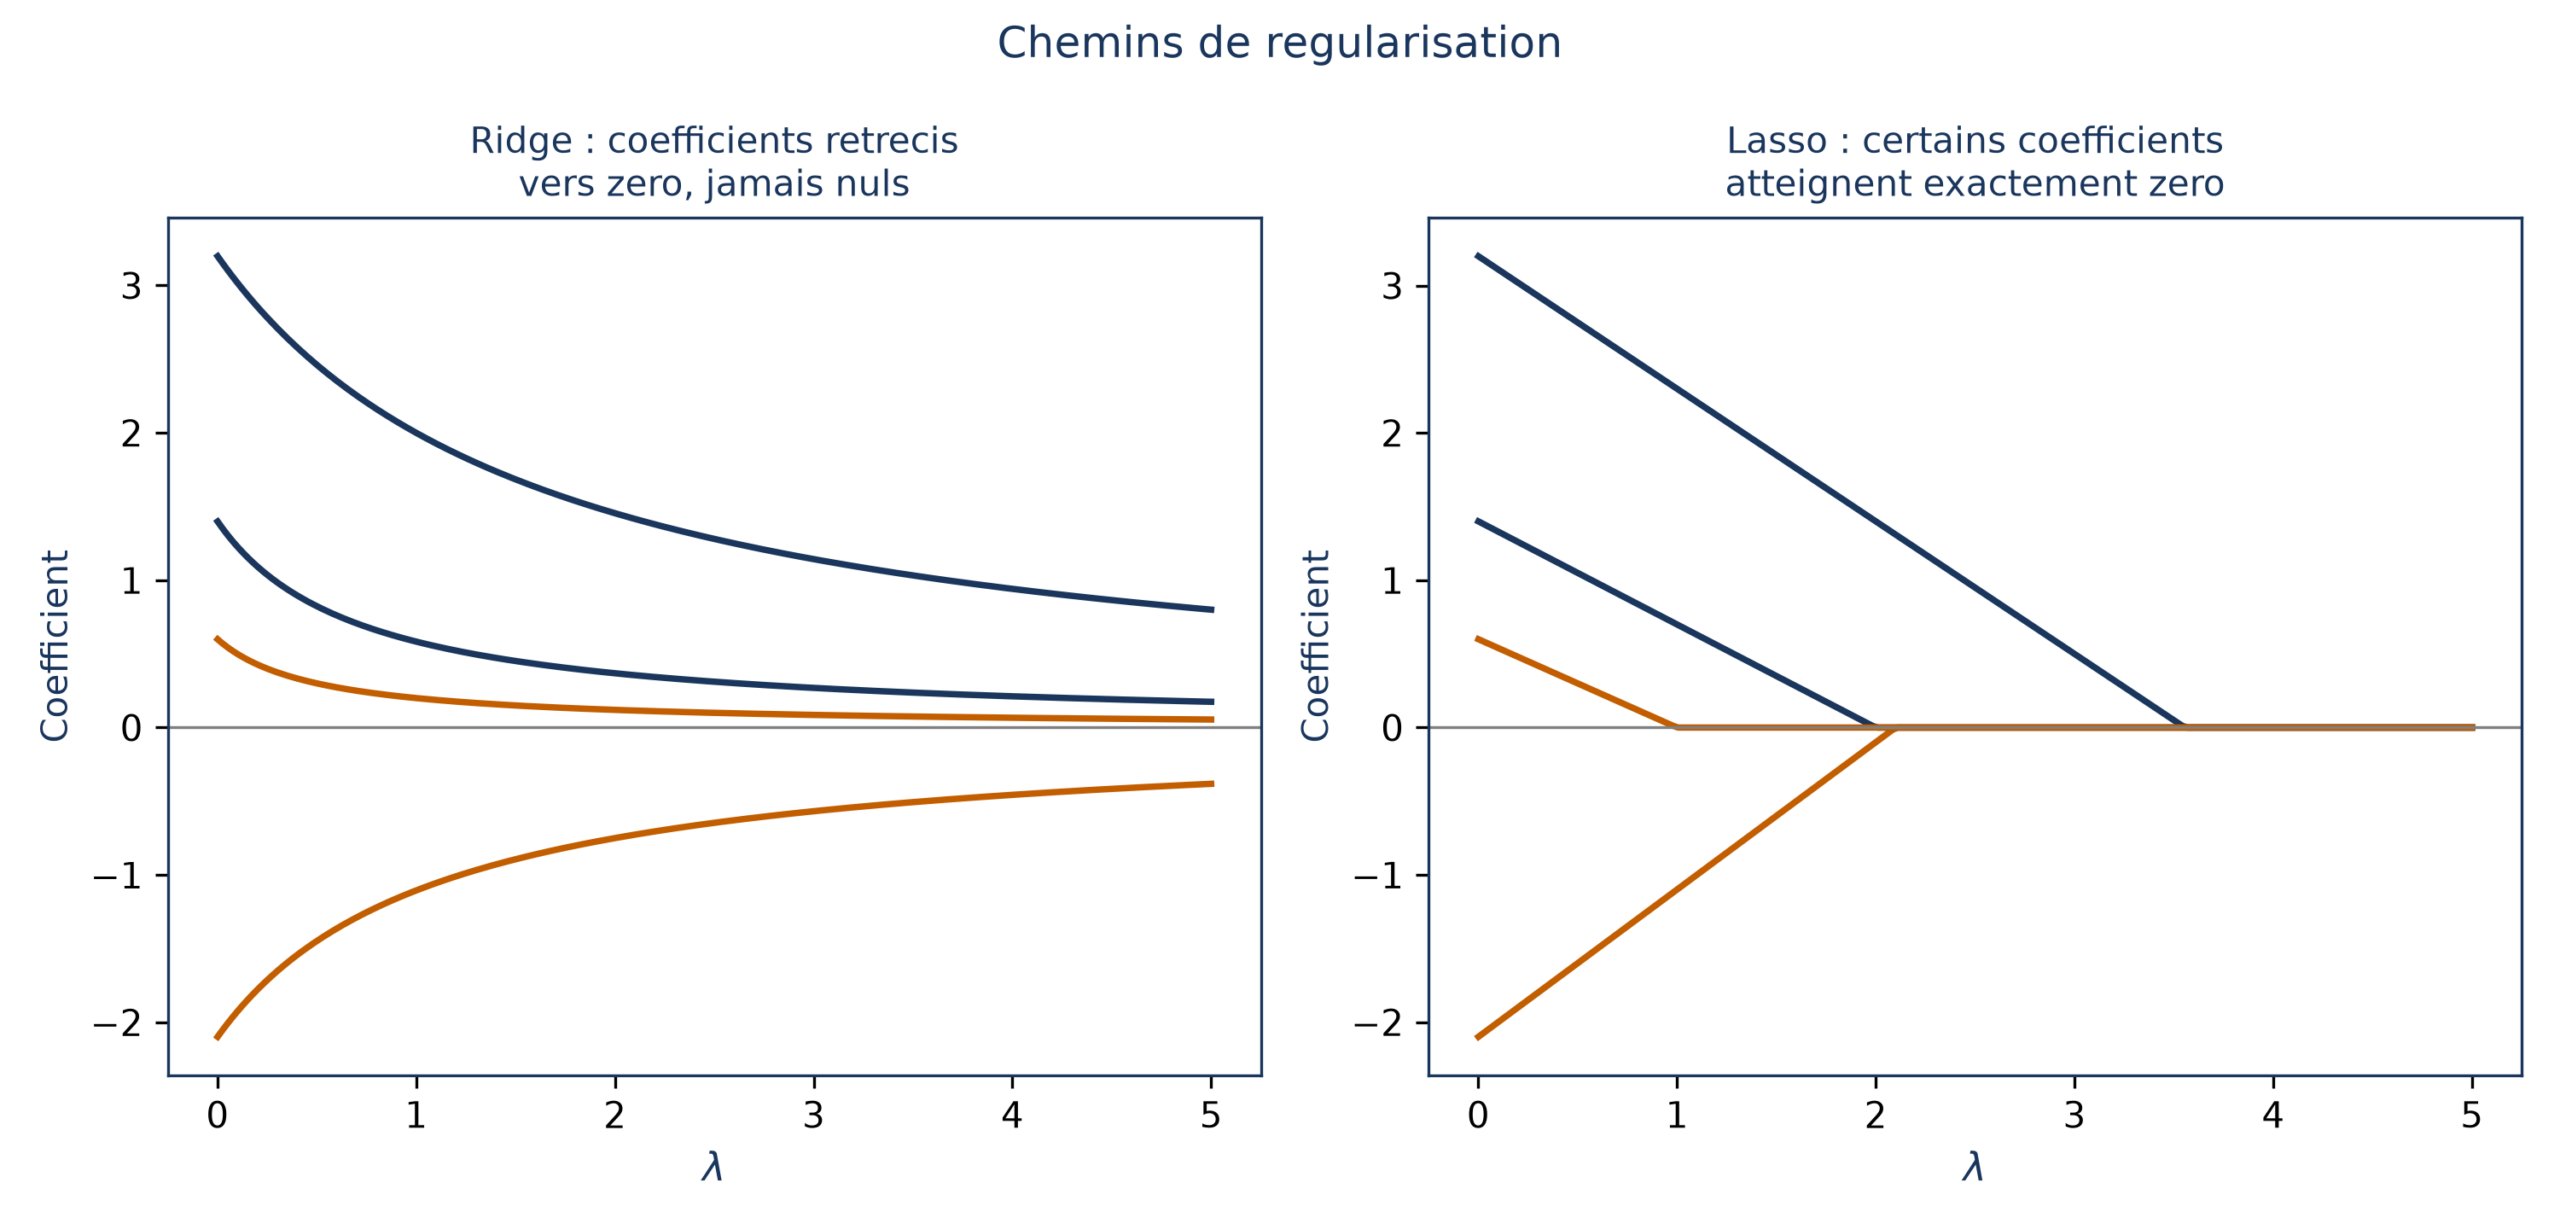
Tout Lasso se règle avec un seul curseur, λ. On balaie une grille de valeurs, on mesure pour chacune l’erreur de test par validation croisée, et la gagnante est celle dont l’erreur est la plus basse.
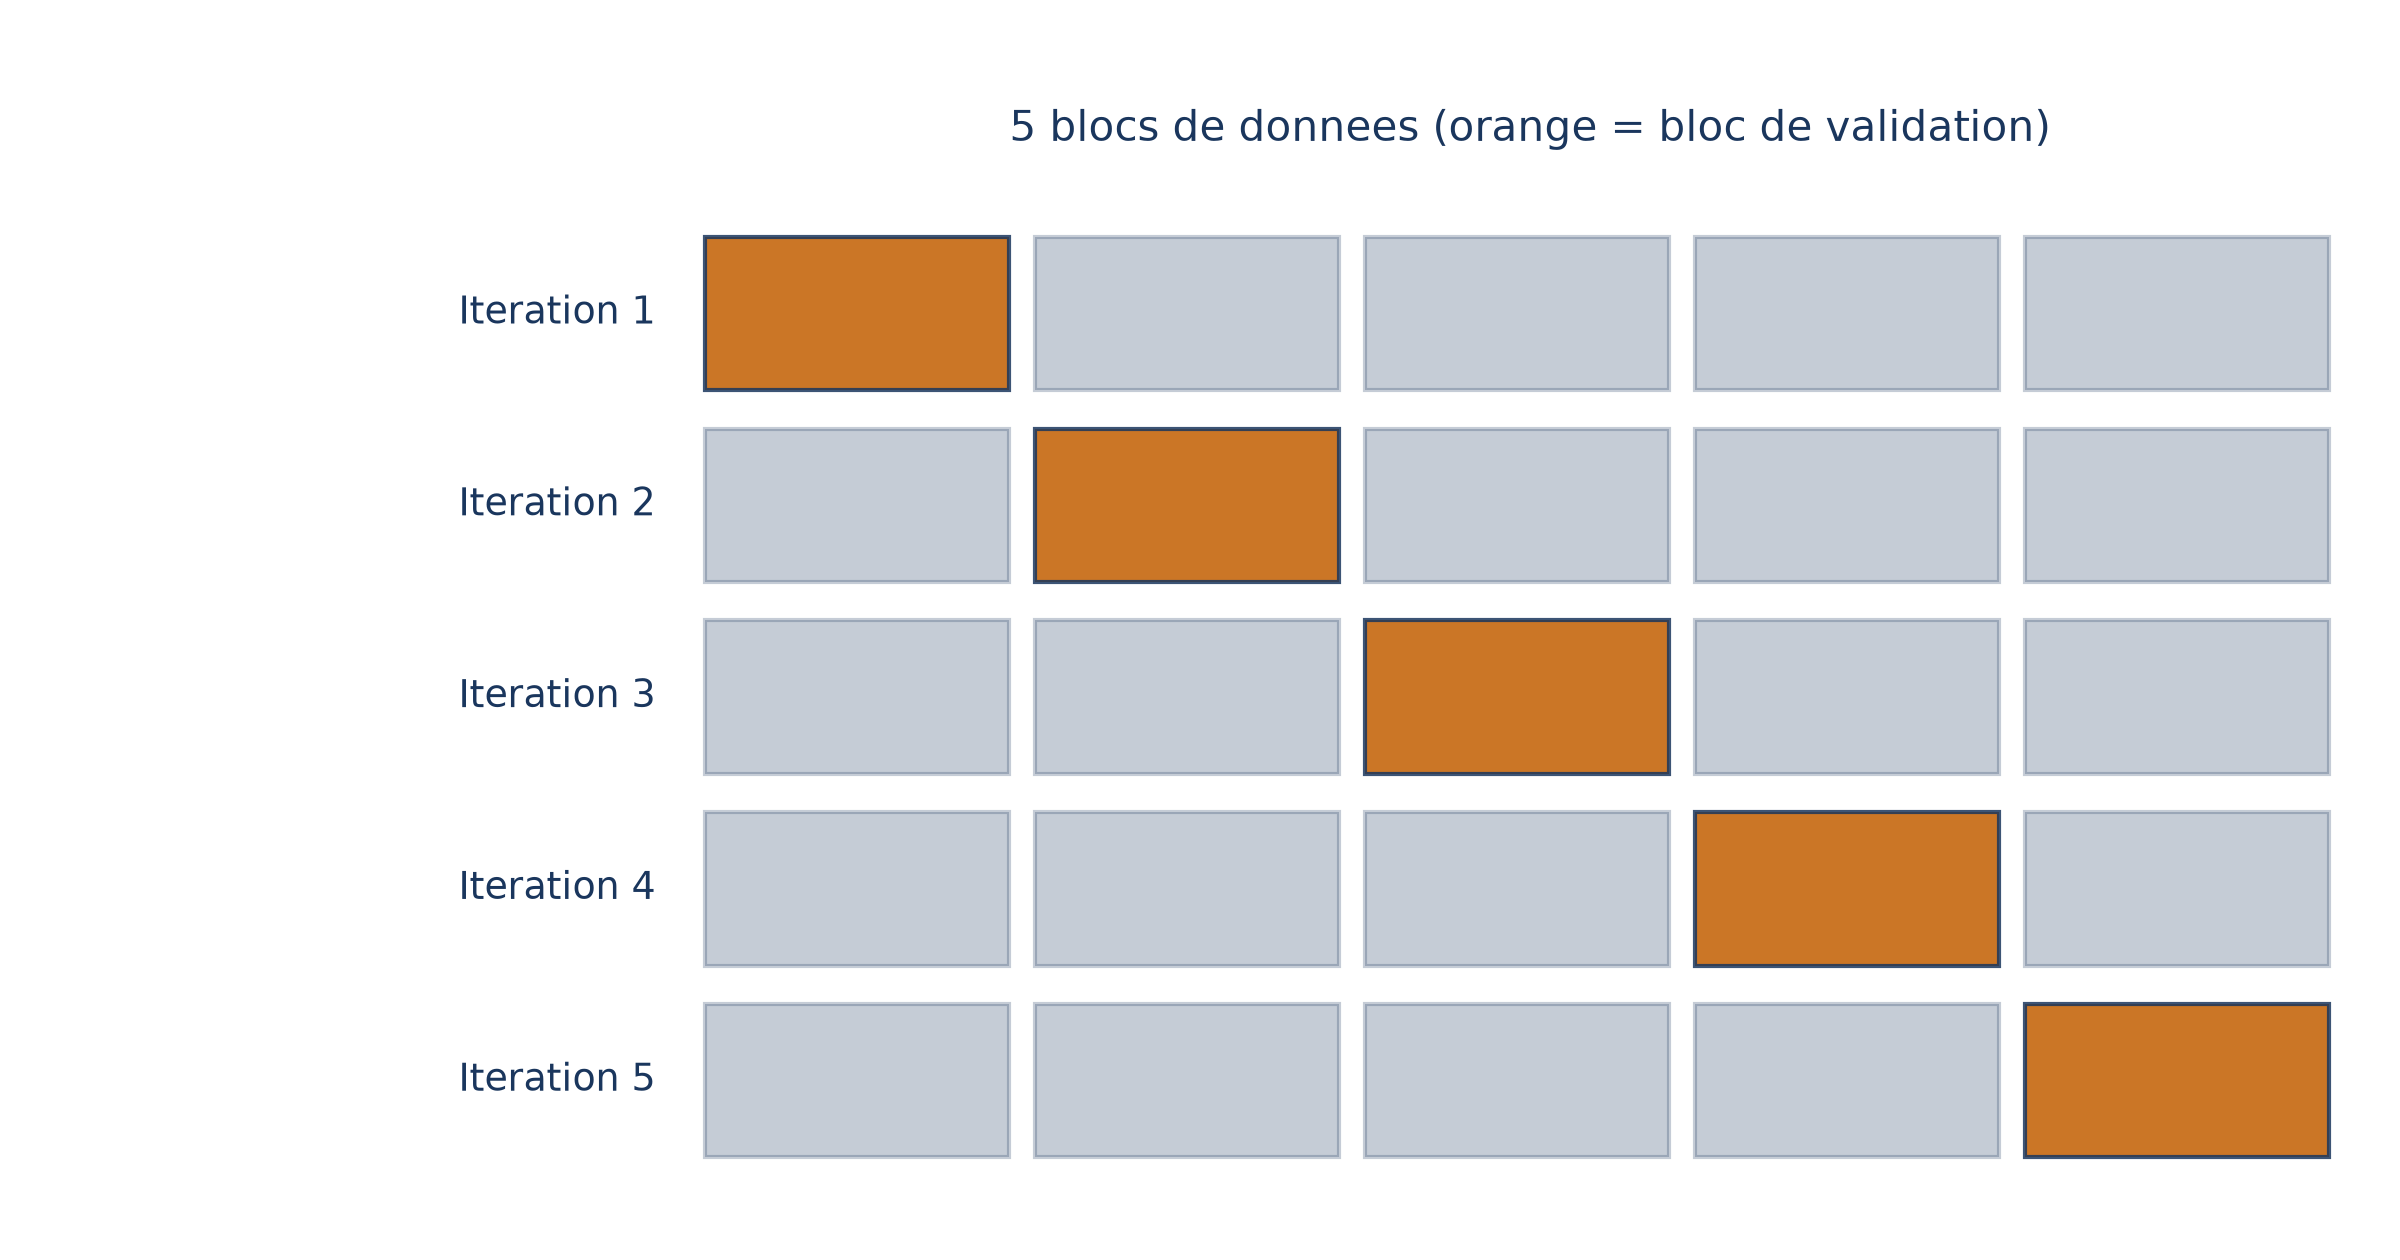
Reste à estimer l’erreur de test sans réserver de données dédiées, car l’erreur d’entraînement la sous-estime typiquement, parfois très largement. La validation croisée à  blocs découpe les observations en groupes de taille comparable : chaque groupe sert à tour de rôle de validation, le modèle étant ajusté sur les
 autres, et l’estimation finale est la moyenne des erreurs obtenues.
En pratique, avec scikit-learn, la classe ElasticNet généralise le ridge et le Lasso ; λ s’y appelle alpha, et son argument l1_ratio vaut 1 pour obtenir un Lasso pur.
Au-delà de la régression linéaire : un Lasso sur des essais cliniques
La pénalité ℓ1 n’est pas liée à la seule régression linéaire : les méthodes de régularisation, ridge et Lasso, s’appliquent telles quelles au modèle de Cox, un modèle de survie qui relie le temps écoulé avant un événement à des caractéristiques.
Un cas réel : le délai de publication de plusieurs centaines d’essais cliniques, selon le nombre de centres, un résultat positif ou non et le budget. Un modèle de Cox pénalisé par le Lasso sélectionne alors, comme en régression linéaire, un sous-ensemble restreint et interprétable de prédicteurs, ceux qui sont les plus associés au délai.
Le réglage suit la même logique : le paramètre de pénalité se contrôle par validation croisée.
Un modèle sobre, pas un modèle souple
Le Lasso ne donne pas de souplesse au modèle, il lui en retire. Il restreint encore la flexibilité du modèle linéaire en forçant certains coefficients à zéro, ce qui le rend plus lisible : la réponse ne dépend plus que d’un sous-ensemble réduit de variables.
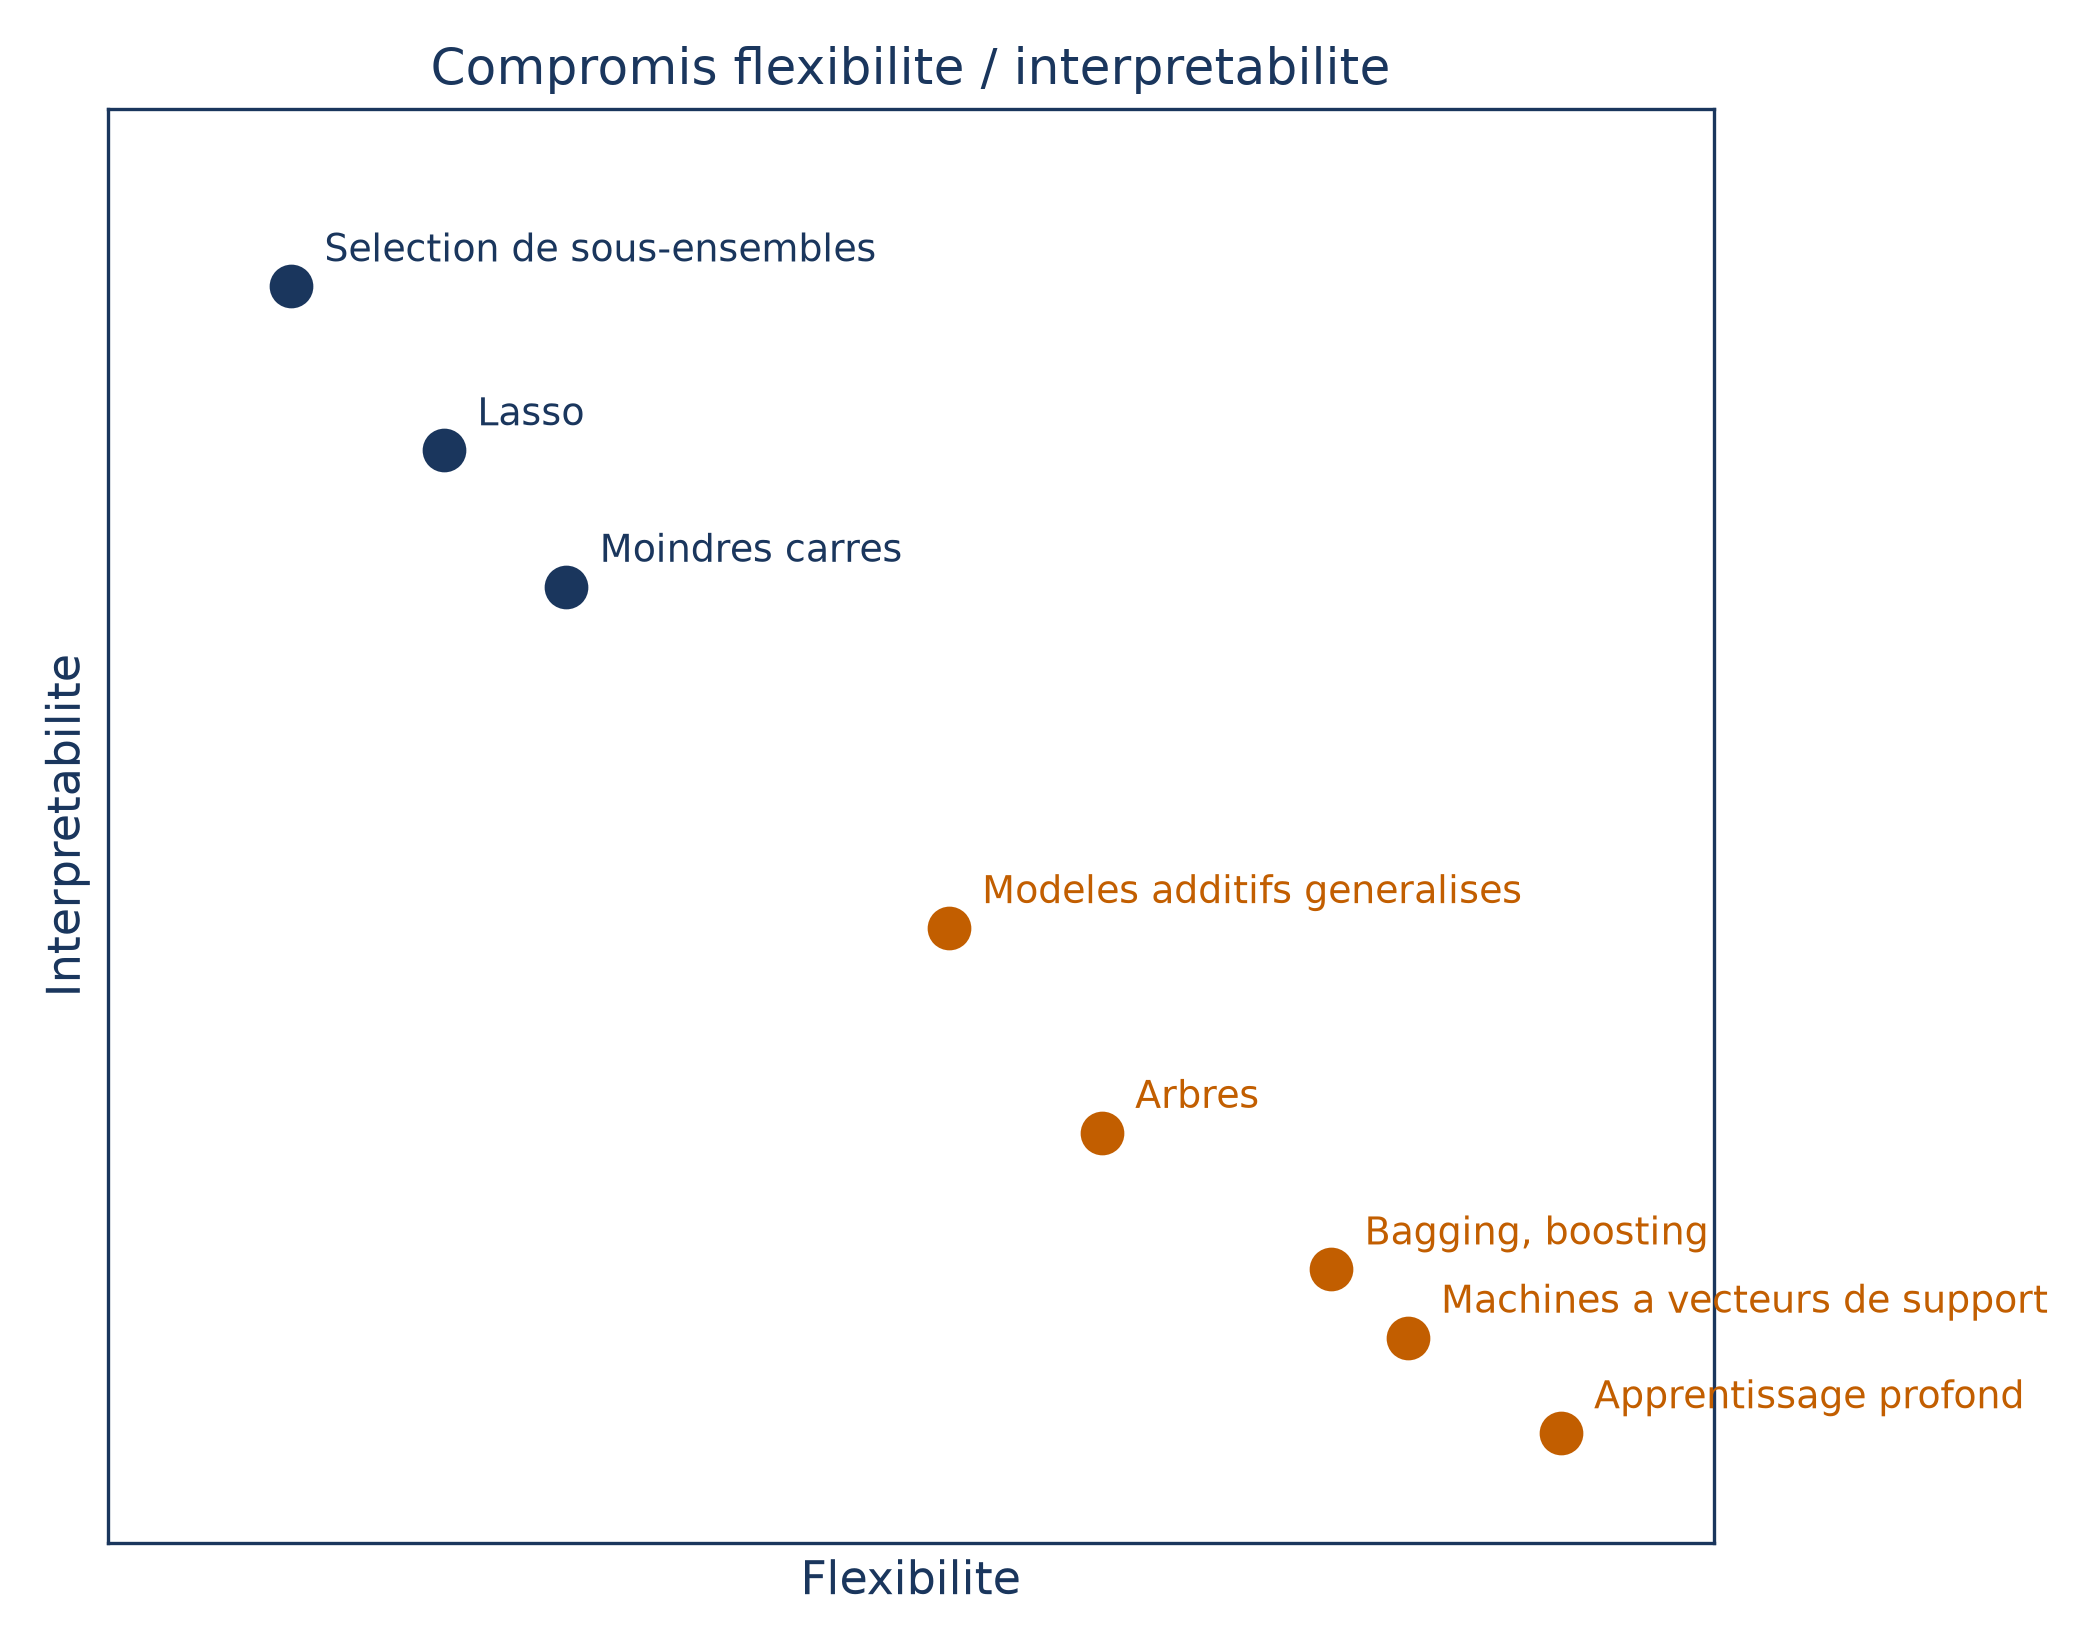
📌 À retenir Le Lasso ne rend pas ton modèle plus malin, il le rend plus sobre : il garde les variables qui valent leur coût et laisse les autres à zéro.