Coupe ton jeu de données en deux moitiés et ajuste le même modèle sur chacune. Avec une simple droite, tu obtiens deux droites presque jumelles ; avec un polynôme de degré 5, deux courbes sensiblement différentes. Un modèle qui change d’humeur à chaque échantillon est un modèle qu’on ne peut pas croire, et la régression ridge est la bride qui le calme. Tu vas voir ce qu’elle ajoute à une régression ordinaire, ce que règle son unique bouton λ, et pourquoi elle ne supprime jamais une variable.
Sommaire
- L’essentiel en 30 secondes
- Pourquoi un modèle change d’avis d’un échantillon à l’autre
- Ridge en une formule : la laisse sur les coefficients
- Tourner le bouton λ, de zéro à l’infini
- Pourquoi ridge ne supprime aucune variable
- Régulariser un réseau de neurones : le même geste, un autre contexte
L’essentiel en 30 secondes
- La régression ridge est une régression avec une pénalité : on ajoute au RSS un terme proportionnel à la somme des carrés des coefficients.
- Un seul réglage, λ : λ = 0 redonne les moindres carrés, et plus λ monte, plus les coefficients sont rétrécis vers zéro.
- Elle échange un peu de biais contre une variance bien plus faible.
- Elle garde toutes les variables : ses coefficients s’approchent de zéro sans jamais l’atteindre.
- λ se choisit sur un ensemble de validation, jamais sur l’ensemble de test.
Pourquoi un modèle change d’avis d’un échantillon à l’autre
Deux quantités expliquent l’expérience des deux moitiés. Le biais d’un estimateur mesure l’écart systématique entre sa valeur moyenne, sur de nombreux échantillons, et la vraie valeur qu’il cherche à estimer. La variance, elle, mesure sa sensibilité aux fluctuations de l’échantillon d’entraînement : la droite des deux moitiés a une variance faible, le polynôme de degré 5 une variance forte.
L’erreur attendue en un point  se décompose exactement en trois morceaux :
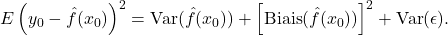
Ici  est la prédiction du modèle au point ,
 la vraie réponse, et
 le bruit que personne ne peut éliminer. Il reste deux termes sur lesquels tu as prise : le carré du biais et la variance.
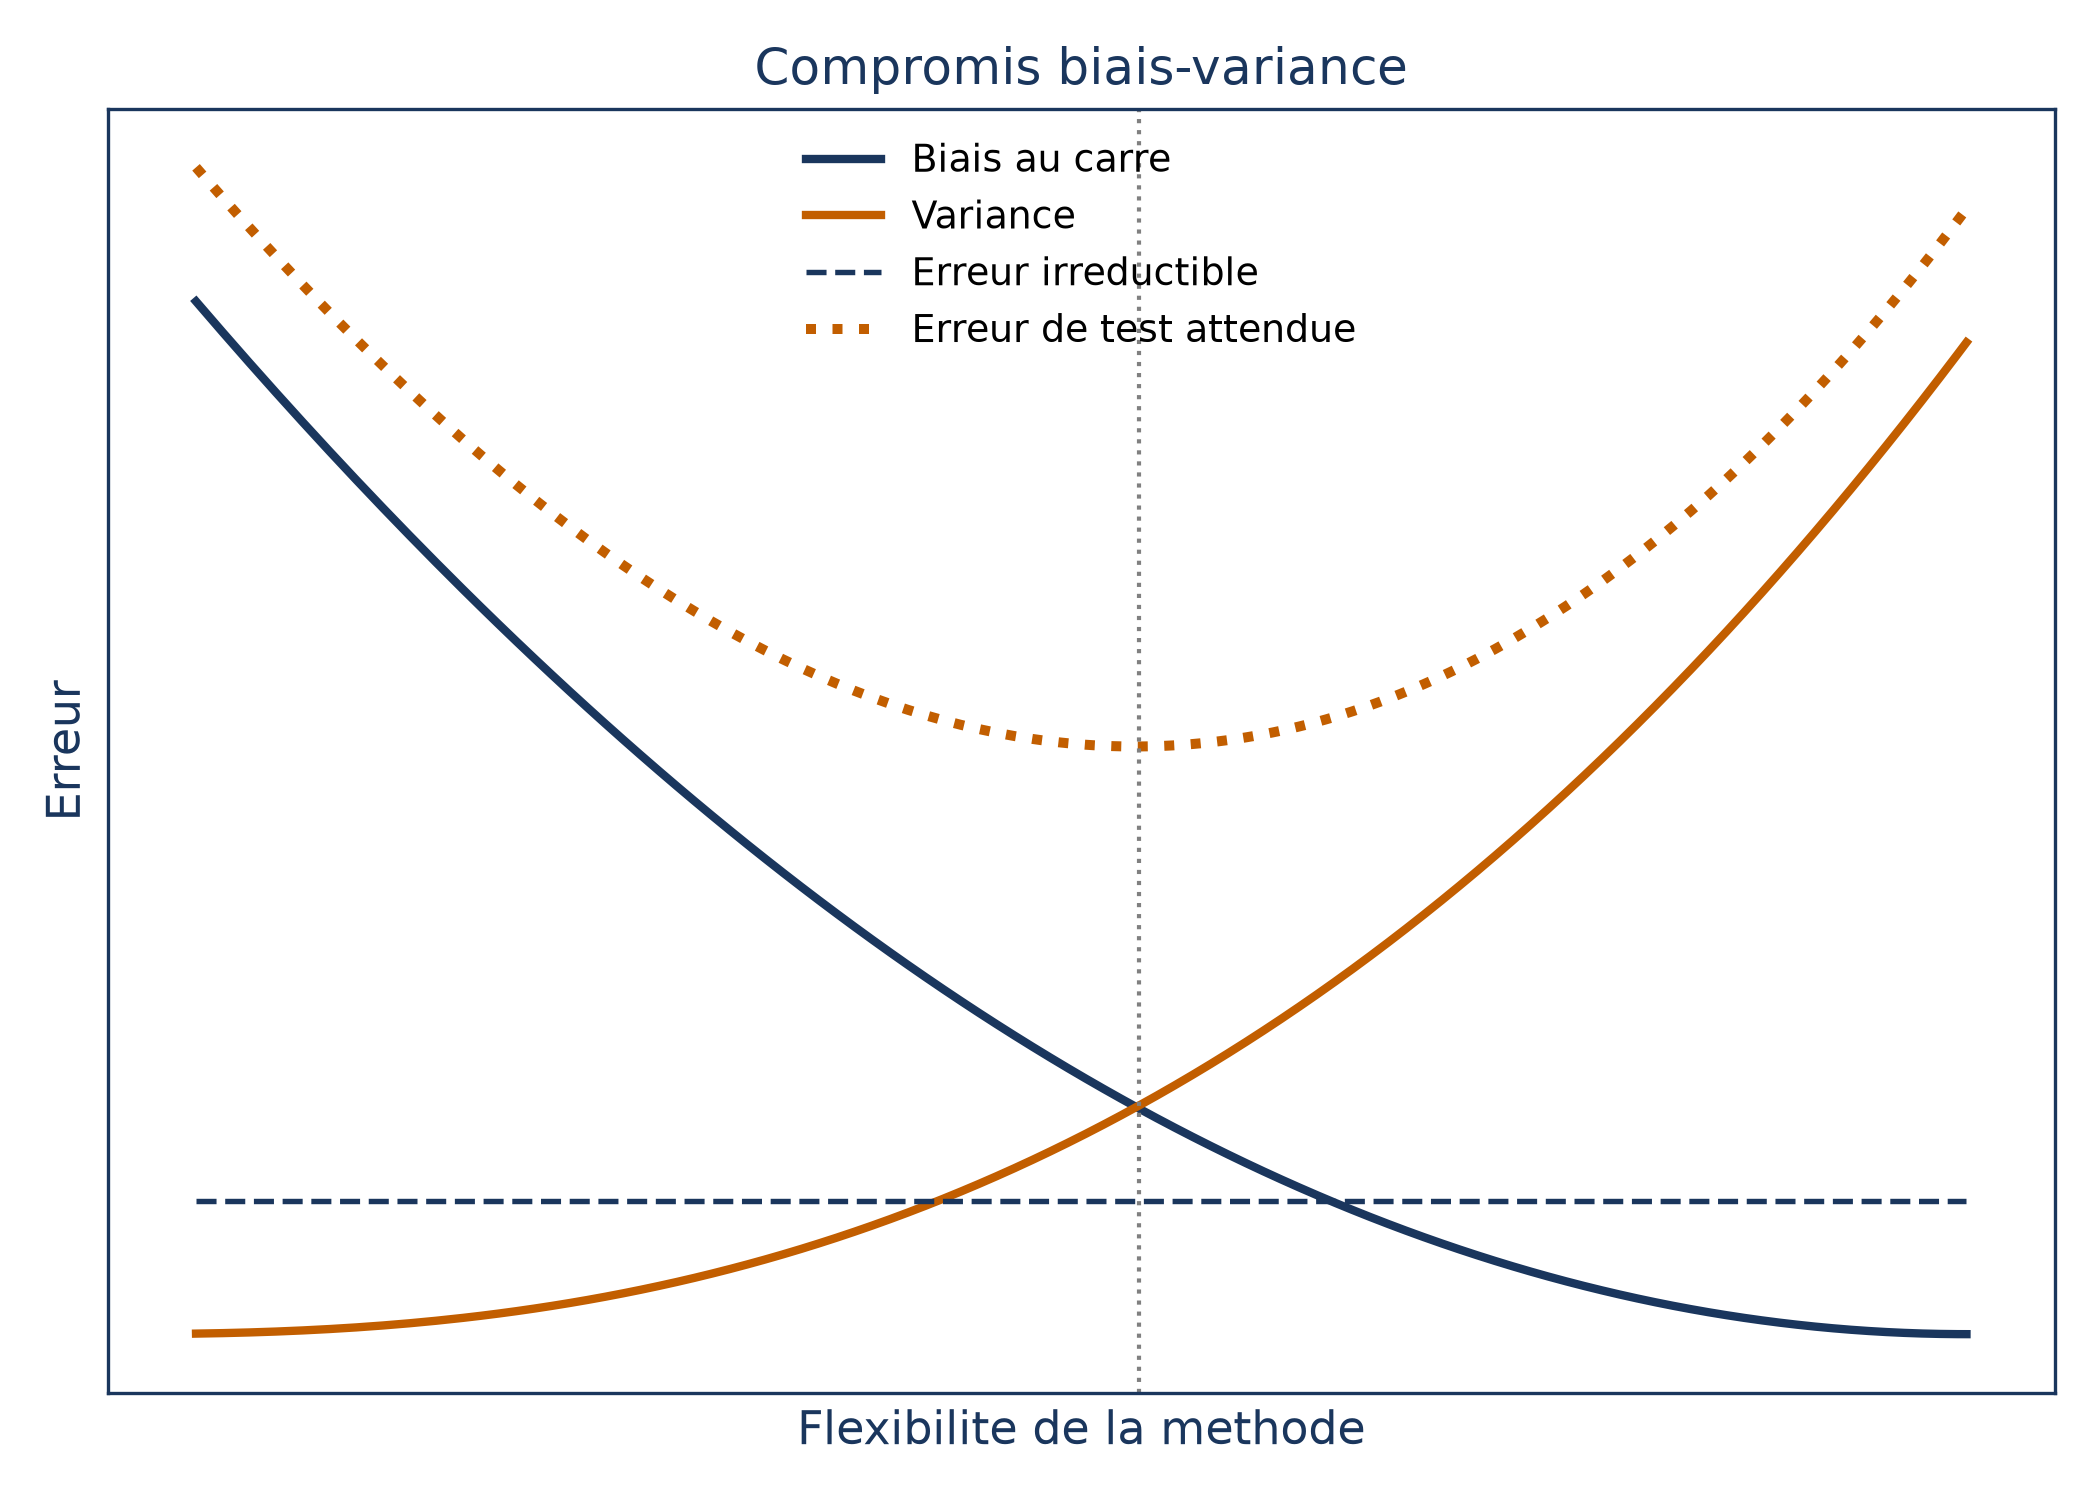
Voilà l’ouverture dont profite ridge. Les coefficients des moindres carrés ordinaires sont non biaisés, mais rien ne dit que leur variance est faible. Accepter un léger biais pour faire baisser la variance est souvent un arbitrage très favorable : c’est exactement ce que fait ridge.
Ridge en une formule : la laisse sur les coefficients
Les moindres carrés cherchent les coefficients qui minimisent le RSS. Ridge garde ce critère et lui ajoute un second terme :
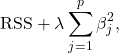
où  est un paramètre de réglage. Le premier terme tire les coefficients vers l’ajustement aux données ; le second, une pénalité L2 (somme des carrés des coefficients
 ), les tire vers zéro. λ décide qui gagne le bras de fer.
On range cette méthode parmi les techniques de régularisation : celles qui pénalisent artificiellement la complexité excessive d’un modèle pour lutter contre le sur-apprentissage.
💡 Intuition Les moindres carrés laissent chaque coefficient aller où il veut pour coller aux points. Ridge les attache à une laisse élastique dont λ règle la longueur : plus elle est courte, moins un coefficient peut s’écarter de zéro.
Cette formule se résout de façon explicite, comme les moindres carrés. En annulant la dérivée par rapport au vecteur des coefficients, avec le même calcul qu’en régression linéaire à plusieurs variables, on obtient :
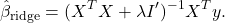
Ici  rassemble les observations des prédicteurs (avec une colonne de 1 pour l’ordonnée à l’origine),
 les réponses, et
 est une matrice identité modifiée pour que l’ordonnée à l’origine échappe à la pénalité. On trouve aussi les coefficients notés
 . À un terme supplémentaire près,
 , c’est la solution des moindres carrés
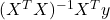 .
Tourner le bouton λ, de zéro à l’infini
Pose λ = 0 : la pénalité s’annule et l’on retrouve exactement les moindres carrés. Fais grimper λ : les coefficients sont de plus en plus rétrécis vers zéro, jusqu’à converger vers le modèle nul quand λ tend vers l’infini.
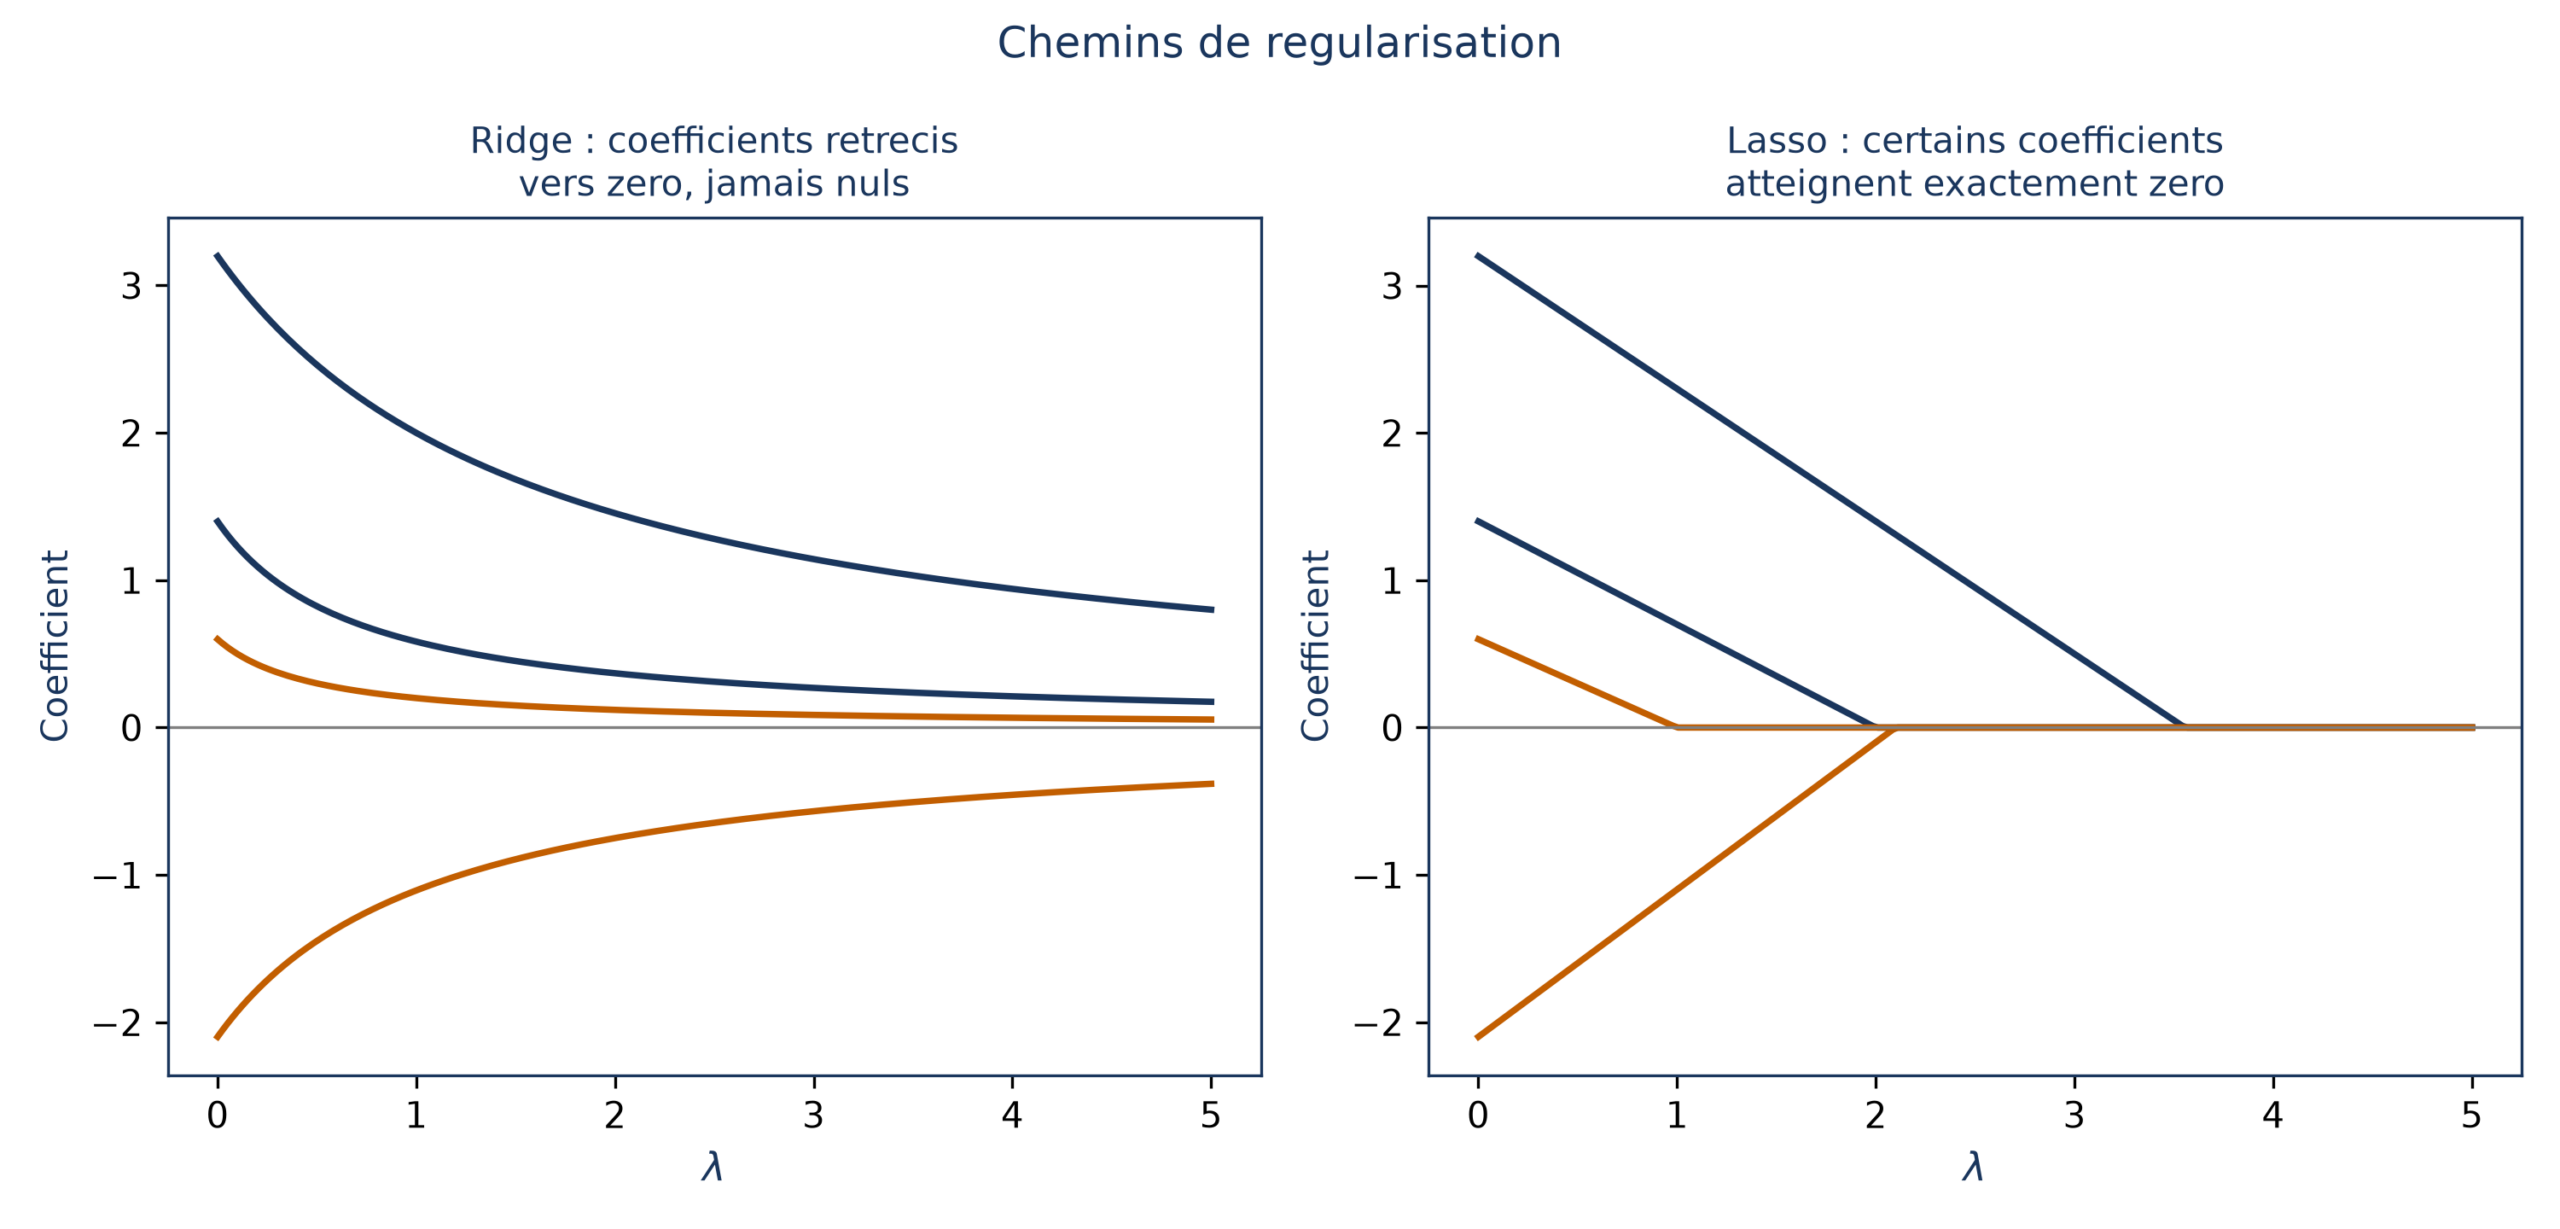
Que se passe-t-il pour de bon en chemin ? Sur un exemple à cinq points, faire croître λ de zéro à dix montre l’arbitrage à l’état pur : le biais des coefficients augmente en valeur absolue, tandis que leur variance décroît nettement. L’estimateur devient légèrement biaisé, un prix à payer, mais sa variance diminue, parfois considérablement.
Reste à choisir la valeur de λ. On teste plusieurs candidates et l’on retient celle qui minimise l’erreur sur l’ensemble de validation, jamais sur l’ensemble de test.
⚠️ Piège Régler λ sur l’ensemble de test, c’est lui faire passer l’examen avant de l’avoir passé : l’ensemble de test doit rester vierge pour juger le modèle final.
Pourquoi ridge ne supprime aucune variable
Il existe une façon équivalente de voir ridge : minimiser le seul RSS sous une contrainte  , c’est-à-dire en forçant les coefficients à rester dans un disque (une sphère en dimension supérieure). Son cousin le lasso ne change qu’un détail, le carré devient une valeur absolue :
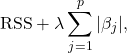
ce qui revient à une contrainte  , dont la région est un losange.
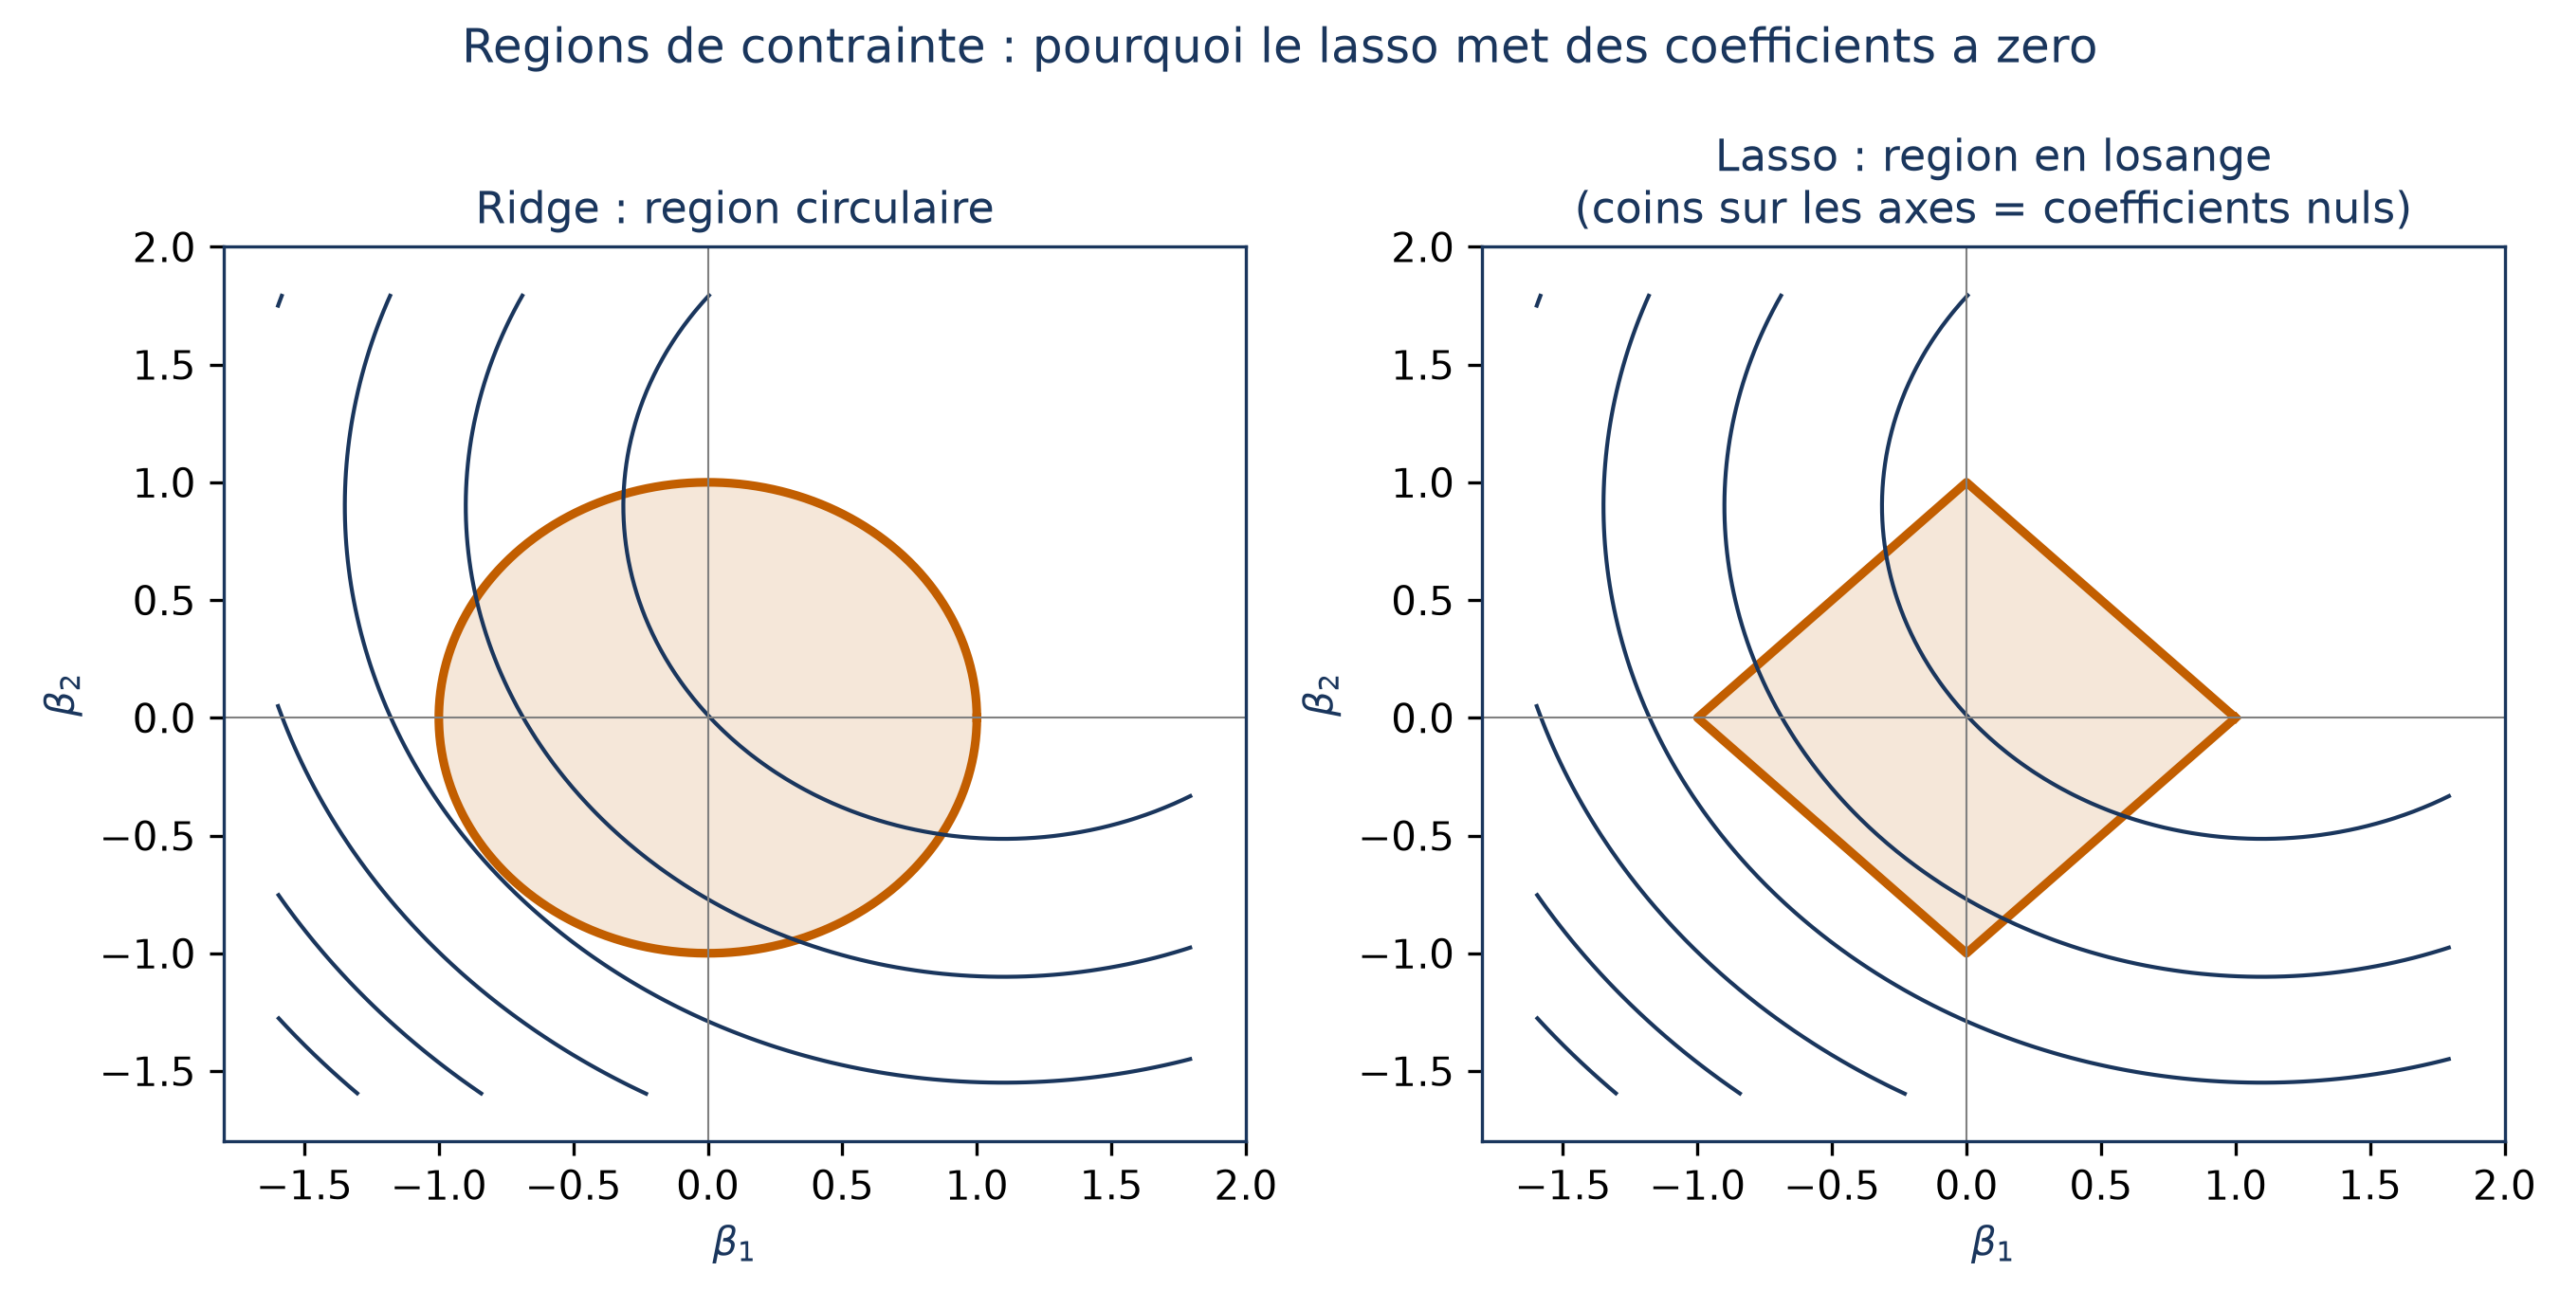
La conséquence est pratique. Ridge inclut toujours les  prédicteurs dans le modèle final, puisque la pénalité au carré ne met presque jamais un coefficient exactement à zéro. Ridge stabilise un modèle sans le simplifier ; pour obtenir un modèle parcimonieux, plus facile à lire, c’est la pénalité du lasso qu’il faut.
⚠️ Piège Rétrécir n’est pas éliminer. Un coefficient ridge très petit reste un coefficient : le modèle utilise encore la variable.
Régulariser un réseau de neurones : le même geste, un autre contexte
L’idée ne s’arrête pas aux régressions. Les réseaux profonds, avec leurs milliers voire millions de paramètres, semblent condamnés au surajustement ; la pénalité ridge s’applique telle quelle aux poids du réseau, et le dropout, qui désactive au hasard une fraction des unités cachées à chaque étape, fournit un second mécanisme.
Ridge a un concurrent d’une grande simplicité : l’arrêt précoce. On suit l’erreur de validation à chaque itération de l’entraînement et l’on s’arrête dès qu’elle cesse de s’améliorer. La différence de fond : ridge modifie la fonction objectif, l’arrêt précoce n’y touche pas.
📌 À retenir Ridge ajoute au RSS une pénalité λ sur la somme des carrés des coefficients. Il achète de la stabilité avec un peu de biais, règle λ sur des données de validation, et garde toutes les variables : pour trier les variables, il faut un autre outil.