Tu veux servir DeepSeek-V3.1 à tes utilisateurs. Ses 671 milliards de paramètres, chargés en FP8, réclament environ un gigaoctet de VRAM par milliard : un seul B200 s’arrête net sur une erreur de mémoire insuffisante. Et même si les poids tenaient, il resterait à répondre vite, à beaucoup de monde, sans ruiner le budget GPU.
Optimiser un moteur d’inférence, c’est exactement cela : un jeu d’arbitrages entre latence, débit et qualité, où chaque technique s’attaque à un goulot précis. À la fin de cet article, tu sauras lequel est en cause à chaque moment, et quel levier actionner.
L’essentiel en 30 secondes
- Un LLM répond en deux temps : le prefill (lire la question) est limité par le calcul, le decode (écrire la réponse) par la mémoire. Presque toutes les optimisations desserrent l’un de ces goulots.
- Six familles de techniques composent la couche d’exécution : regrouper les requêtes, mettre en cache, quantifier, spéculer, paralléliser, désagréger.
- Quantifier fait gagner environ 30 à 50 % par niveau de précision, au risque de la qualité ; spéculation et cache accélèrent sans changer la sortie du modèle.
- FlashAttention et PagedAttention allègent les lectures et écritures mémoire de l’attention, sans perte de qualité.
- Plus tu as de trafic, plus tu peux empiler d’optimisations.
Pourquoi un GPU rapide peut rester à attendre
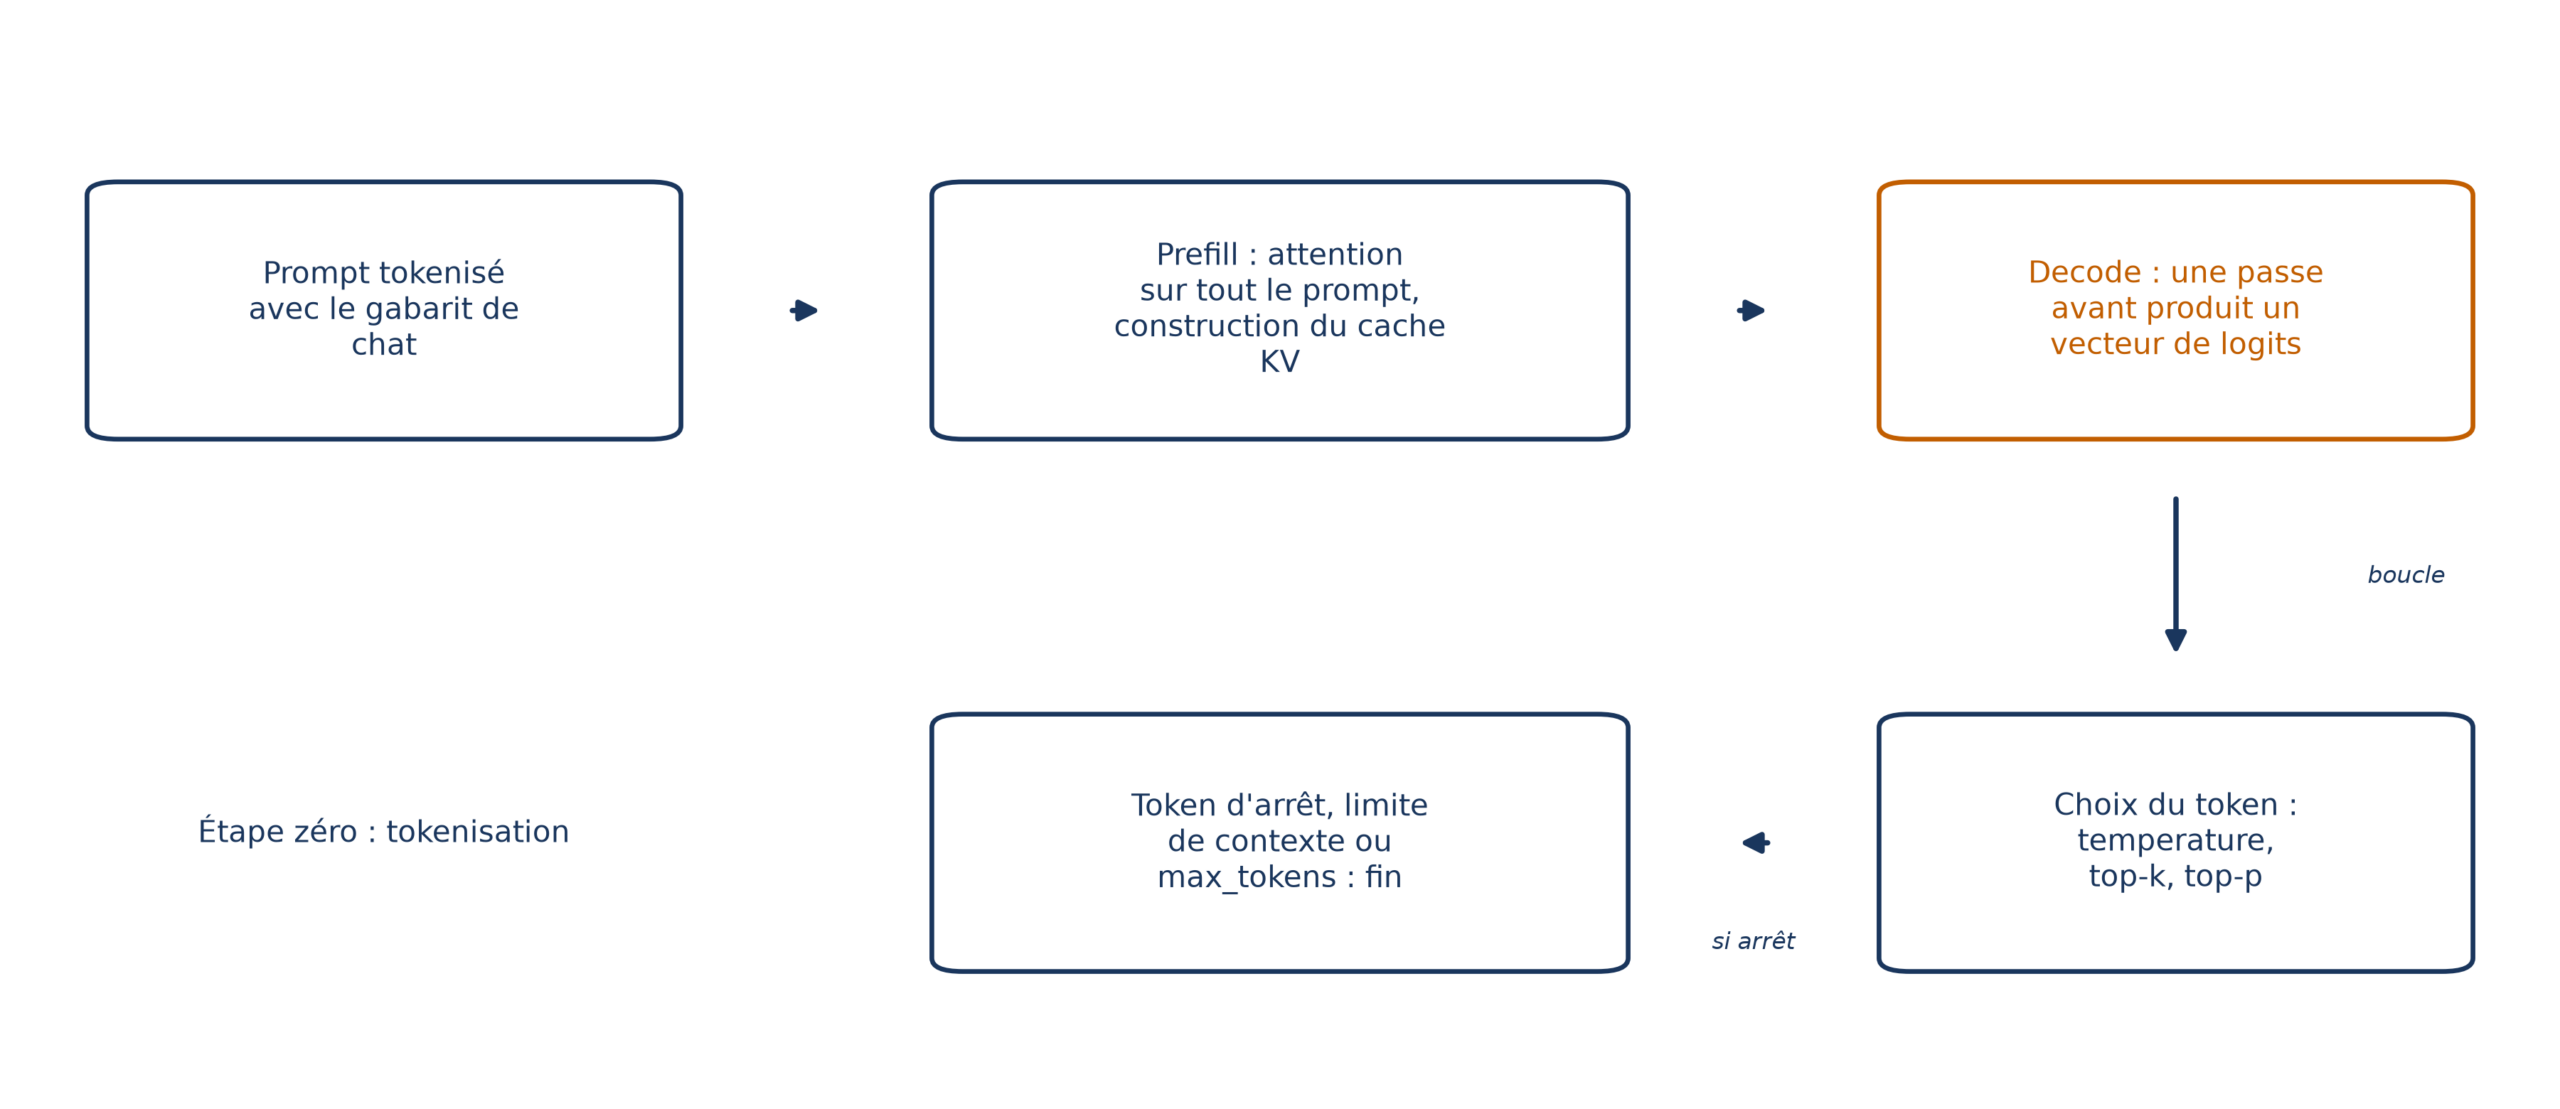
Une requête adressée à un LLM suit toujours le même parcours. Le texte est découpé en tokens, puis le prefill calcule l’attention de chaque token d’entrée et range le résultat dans un cache KV. Le decode prend ensuite le relais : chaque passe avant produit un token, et la boucle continue jusqu’à un token d’arrêt, la limite de contexte ou max_tokens.
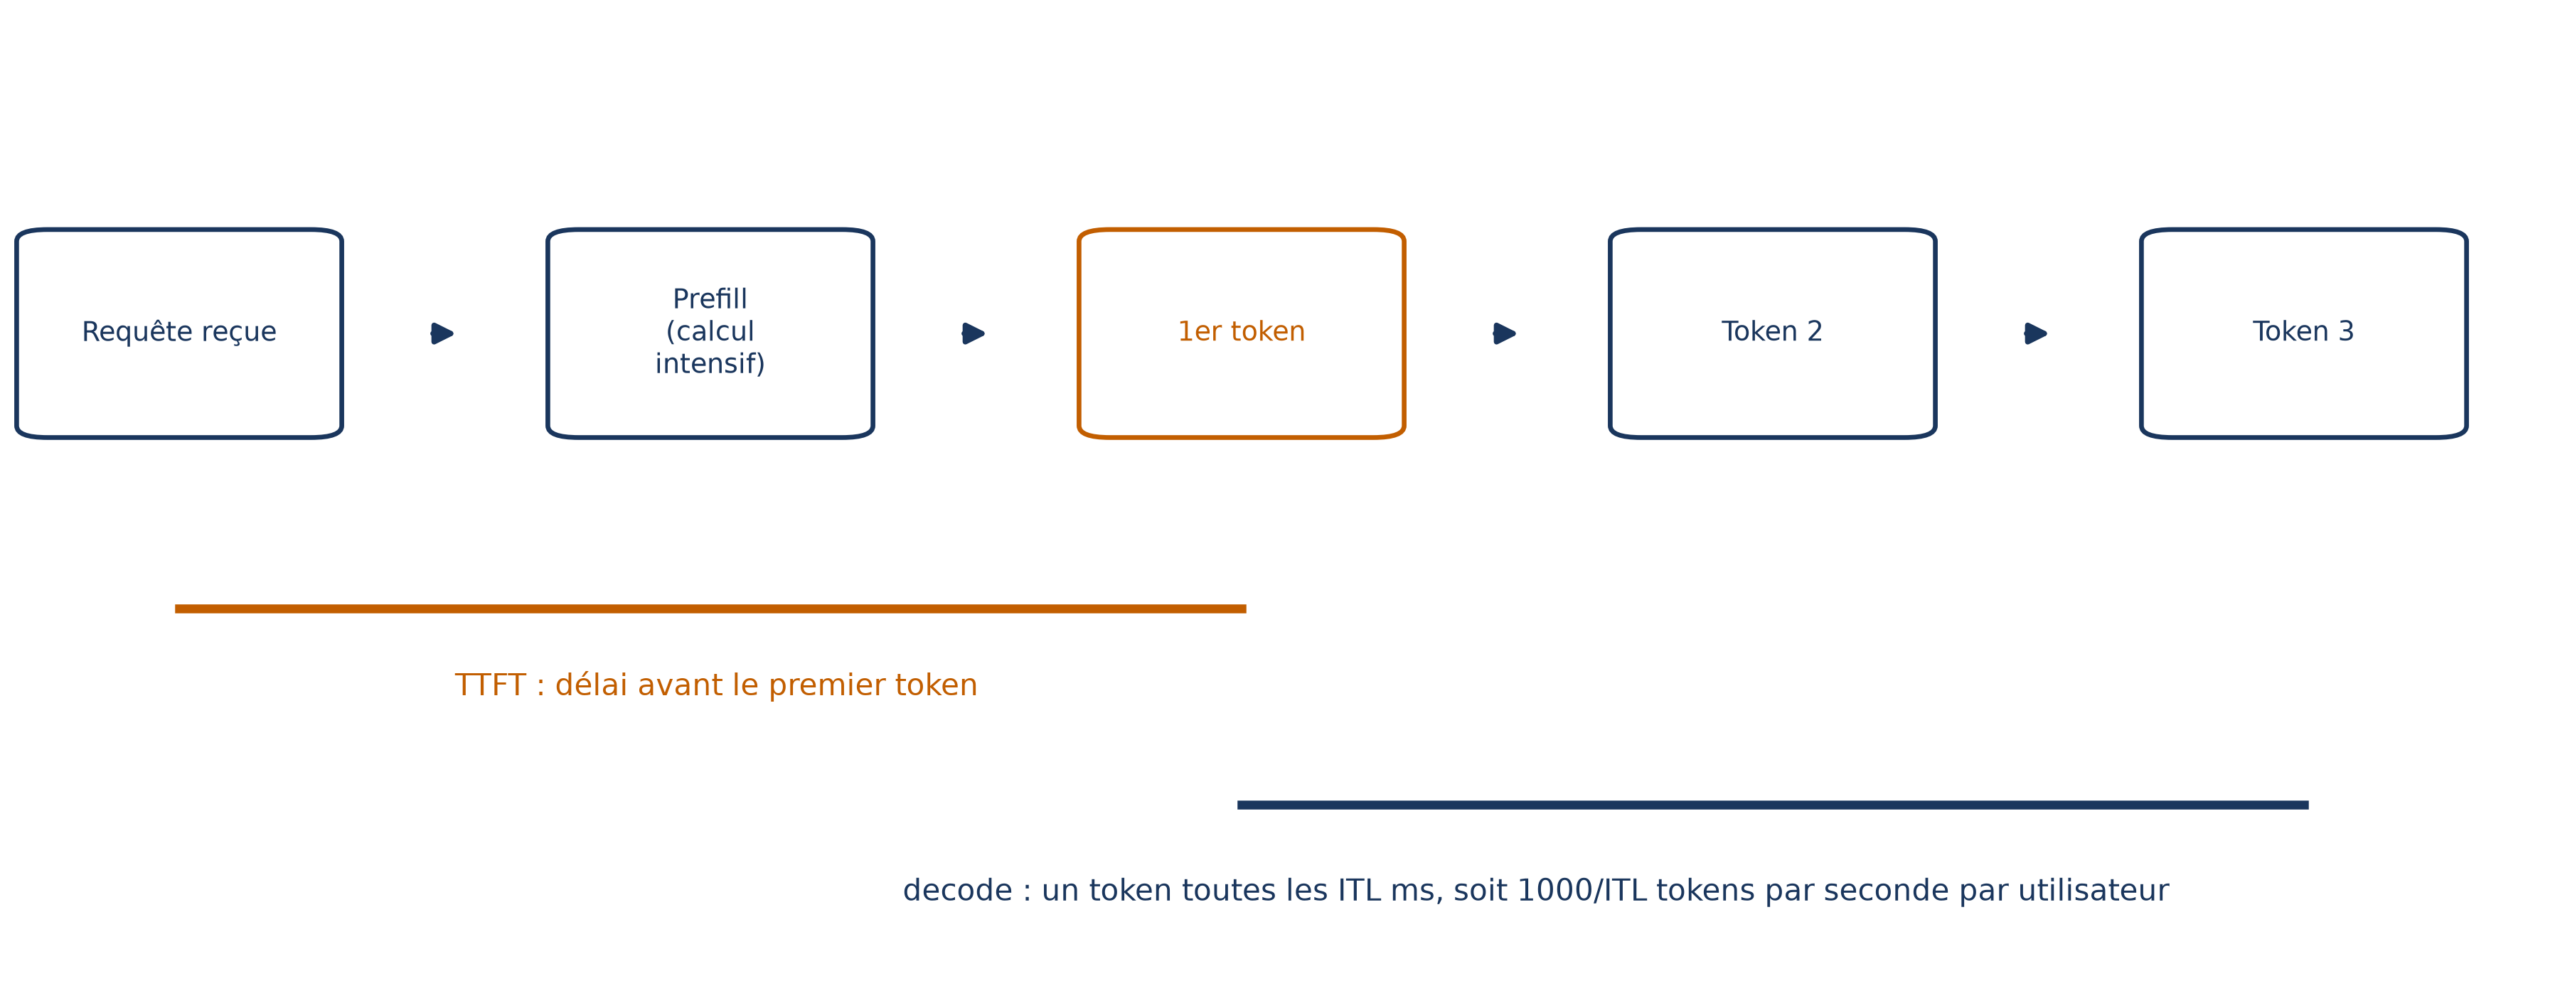
Deux mesures disent si tu as réussi. Le TTFT (time to first token) est le délai avant le premier token ; il dépend du prefill. Le TPS (tokens per second) compte les tokens reçus par seconde ensuite ; il dépend du decode. Une latence inter-token (ITL) de 10 millisecondes équivaut à 100 tokens par seconde et par utilisateur.
💡 Intuition Un GPU a deux ressources : le calcul (opérations par seconde) et la bande passante mémoire (octets déplacés par seconde). Dans un système idéal, aucune n’attend l’autre. Dans la réalité, l’une est saturée pendant que l’autre dort, et c’est ce déséquilibre qu’on appelle un goulot. Si une opération est limitée par la mémoire, aucune optimisation du calcul ne la rendra plus rapide.
Au prefill, les poids sont lus une seule fois puis servent à de grosses multiplications matricielles : beaucoup de calcul pour une lecture mémoire. Au decode, les poids sont relus pour chaque token généré, avec de petites multiplications vecteur-matrice : peu de calcul, énormément de lecture.
Un exemple minuscule montre le coût de ces lectures. Deux noyaux enchaînés, multiply_by_2 puis multiply_by_3, lisent le vecteur [1, 2, 3], écrivent [2, 4, 6], le relisent aussitôt, puis écrivent [6, 12, 18]. Fusionnés en un seul noyau multiply_by_6, ils lisent [1, 2, 3] et écrivent [6, 12, 18] directement. L’écriture suivie de la relecture intermédiaires était un aller-retour inutile, que le decode ne peut pas se permettre.
Sous le capot : mesurer le goulot de l’attention
Pour savoir si une opération attend la mémoire ou le calcul, on compare son intensité arithmétique (opérations effectuées par octet déplacé) au rapport ops:octet du matériel. Prenons l’attention standard, sans optimisation, pour une tête de dimension  sur une séquence de
 tokens.
Elle tient en trois lignes : calculer  en lisant
 et
 puis en écrivant
 ; lire , calculer
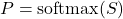 et écrire
 ; lire et
 , calculer
 et écrire
 . , , et mesurent
 , tandis que et mesurent
 . En FP16, une valeur occupe deux octets, donc une matrice
 pèse environ 32 Mio.
Chaque ligne lit, calcule, écrit. En additionnant tous les mouvements mémoire, on obtient :
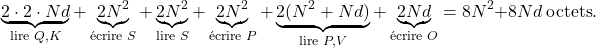
Lecture pas à pas : chaque terme est un nombre d’octets, avec 2 octets par valeur. Les trois termes en  viennent des matrices et , écrites puis relues. Ce sont elles qui dominent, car
 grandit bien plus vite que
 .
Côté calcul, la somme des trois étapes donne 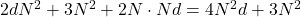 opérations. Le rapport des deux totaux est l’intensité arithmétique :
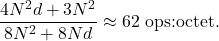
Avec et , on trouve environ 62 opérations par octet, très en dessous du rapport ops:octet de 295 d’un H100 : l’attention du decode est limitée par la mémoire. Les chiffres exacts varient selon le modèle, la longueur de séquence et le matériel, mais le principe tient.
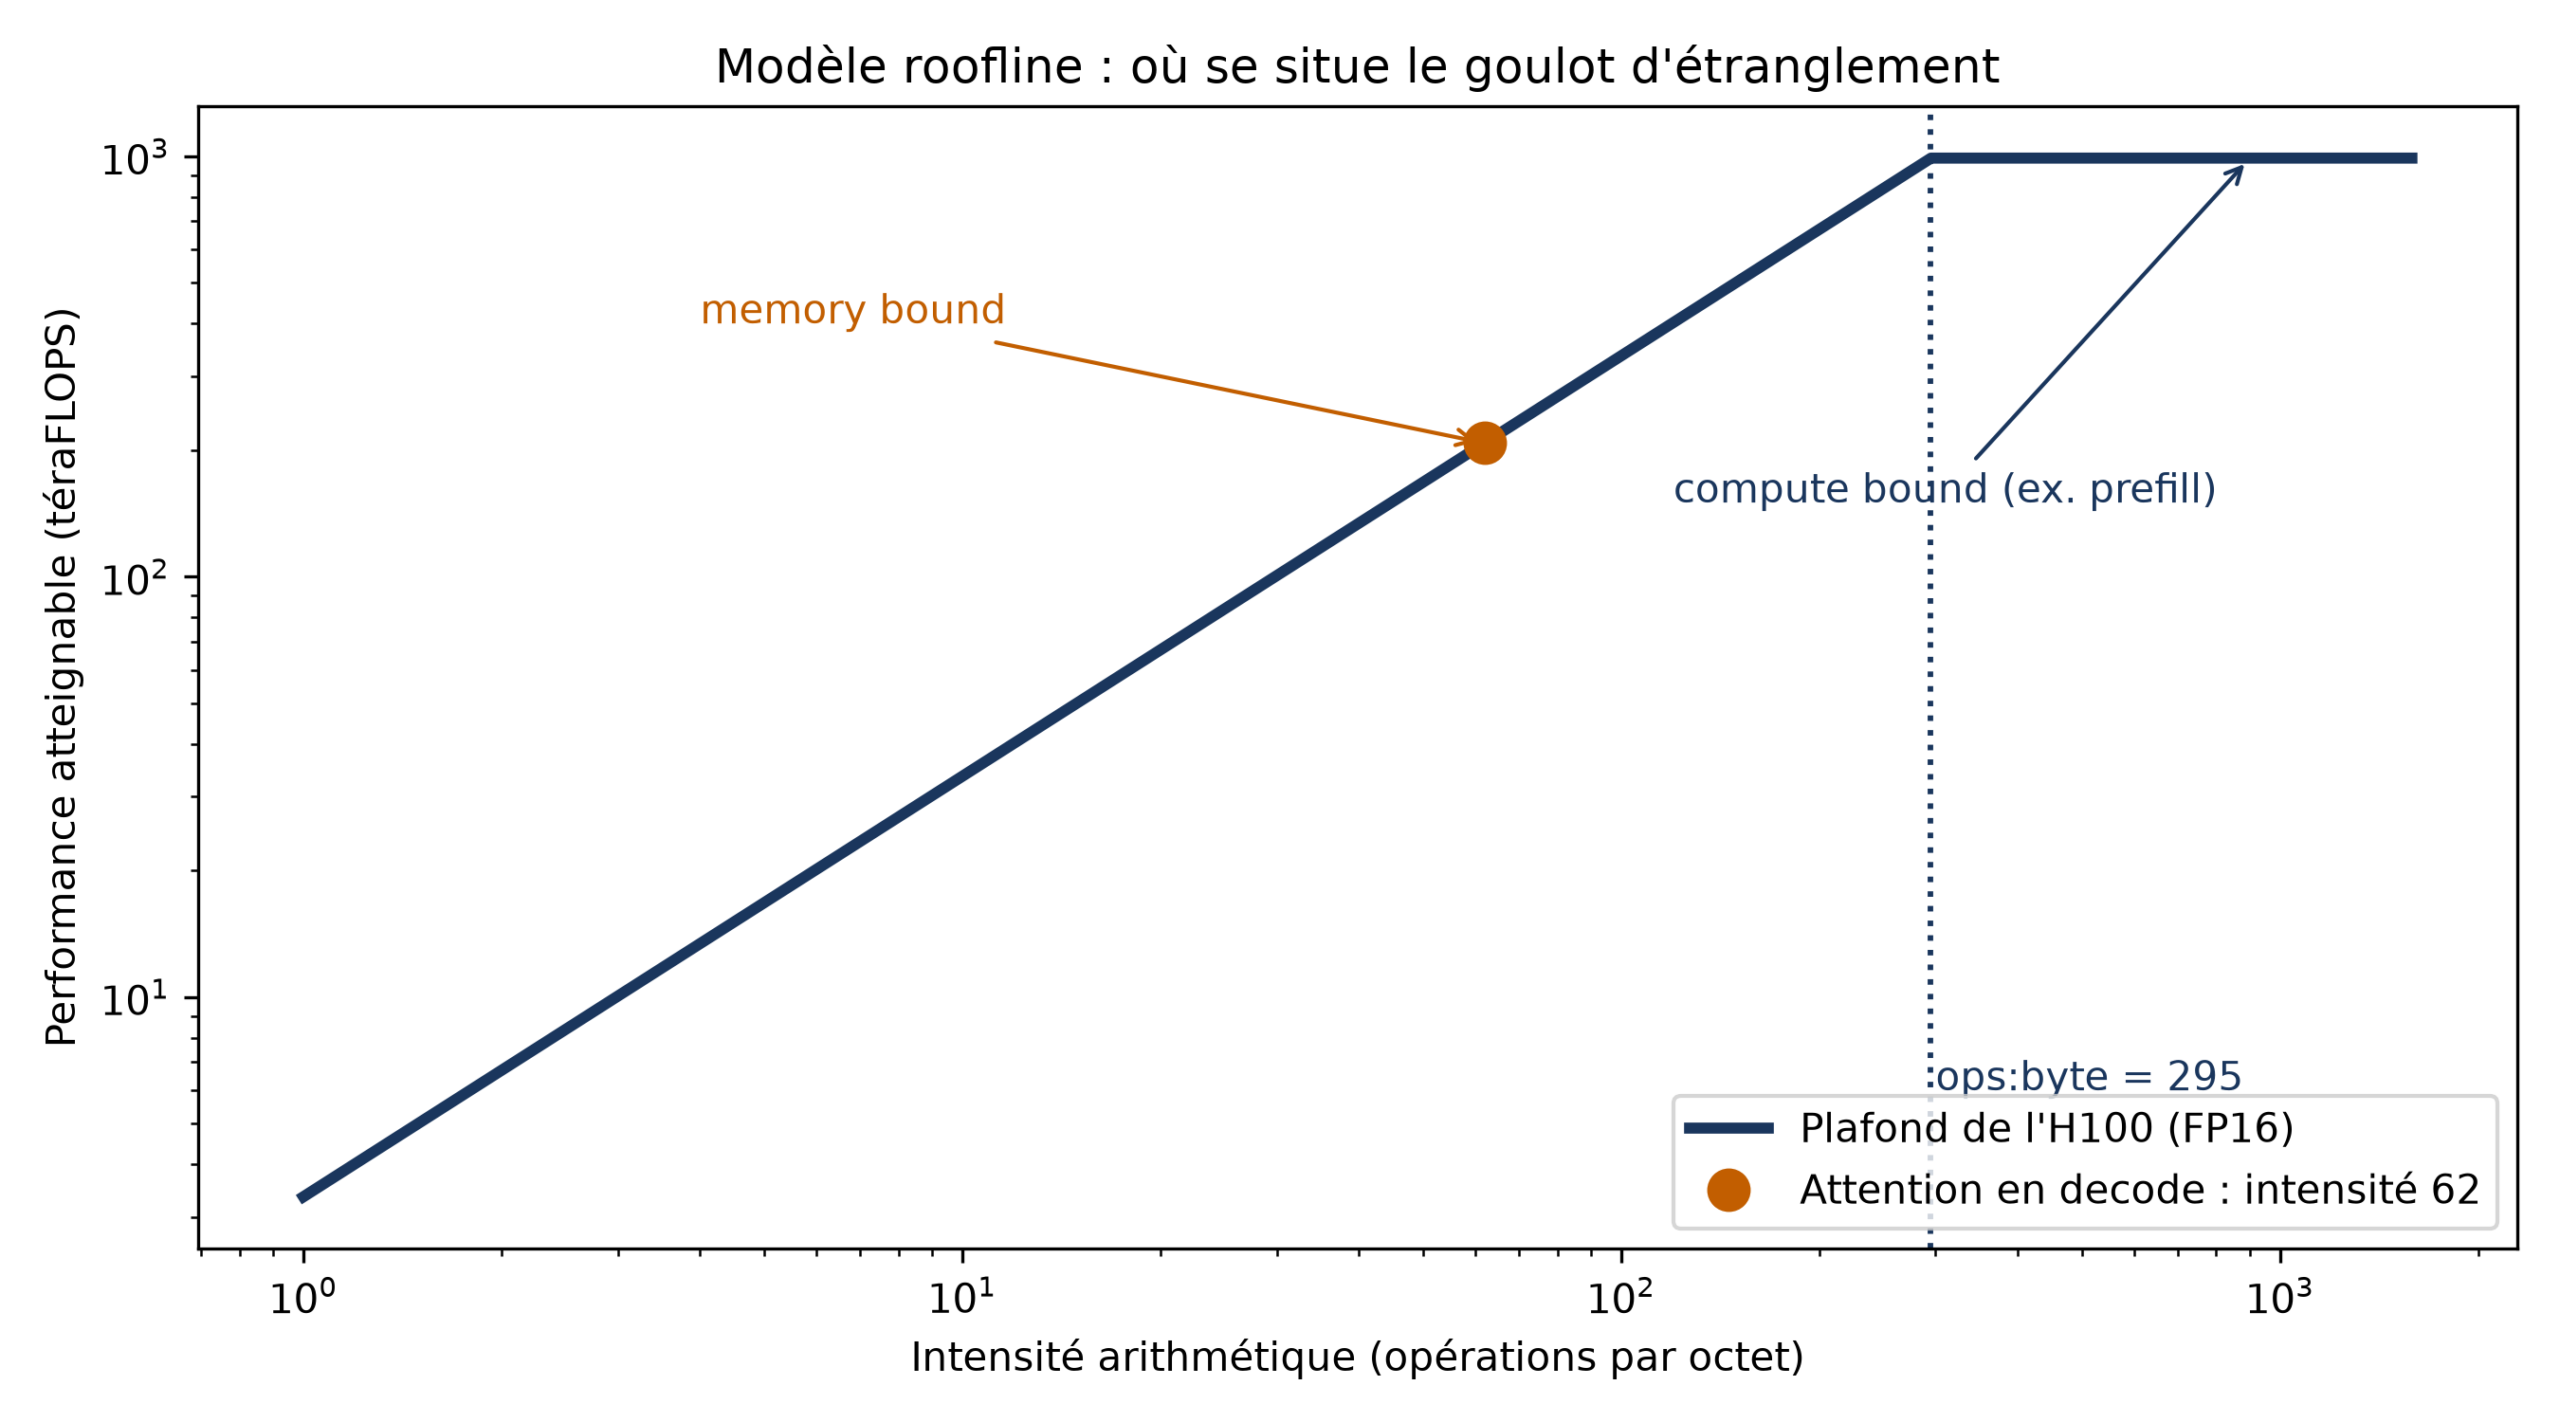
📌 À retenir Prefill, génération d’images et de vidéos sont limités par le calcul. Le decode est limité par la mémoire. Regrouper plusieurs requêtes rend le decode moins limité par la mémoire : traiter un lot consomme plus de calcul pour le même trafic mémoire.
Les noyaux d’attention : lire et écrire moins
L’implémentation de base de l’attention écrit les matrices intermédiaires et à la fin d’une étape, puis les relit aussitôt à la suivante. Deux stratégies s’offrent à toi : de meilleures implémentations (mêmes calculs, mieux placés en mémoire) ou de nouveaux algorithmes de complexité moindre. Les premières restent quadratiques mais sont sans perte de qualité ; les seconds échangent de la qualité contre du temps et de l’espace.
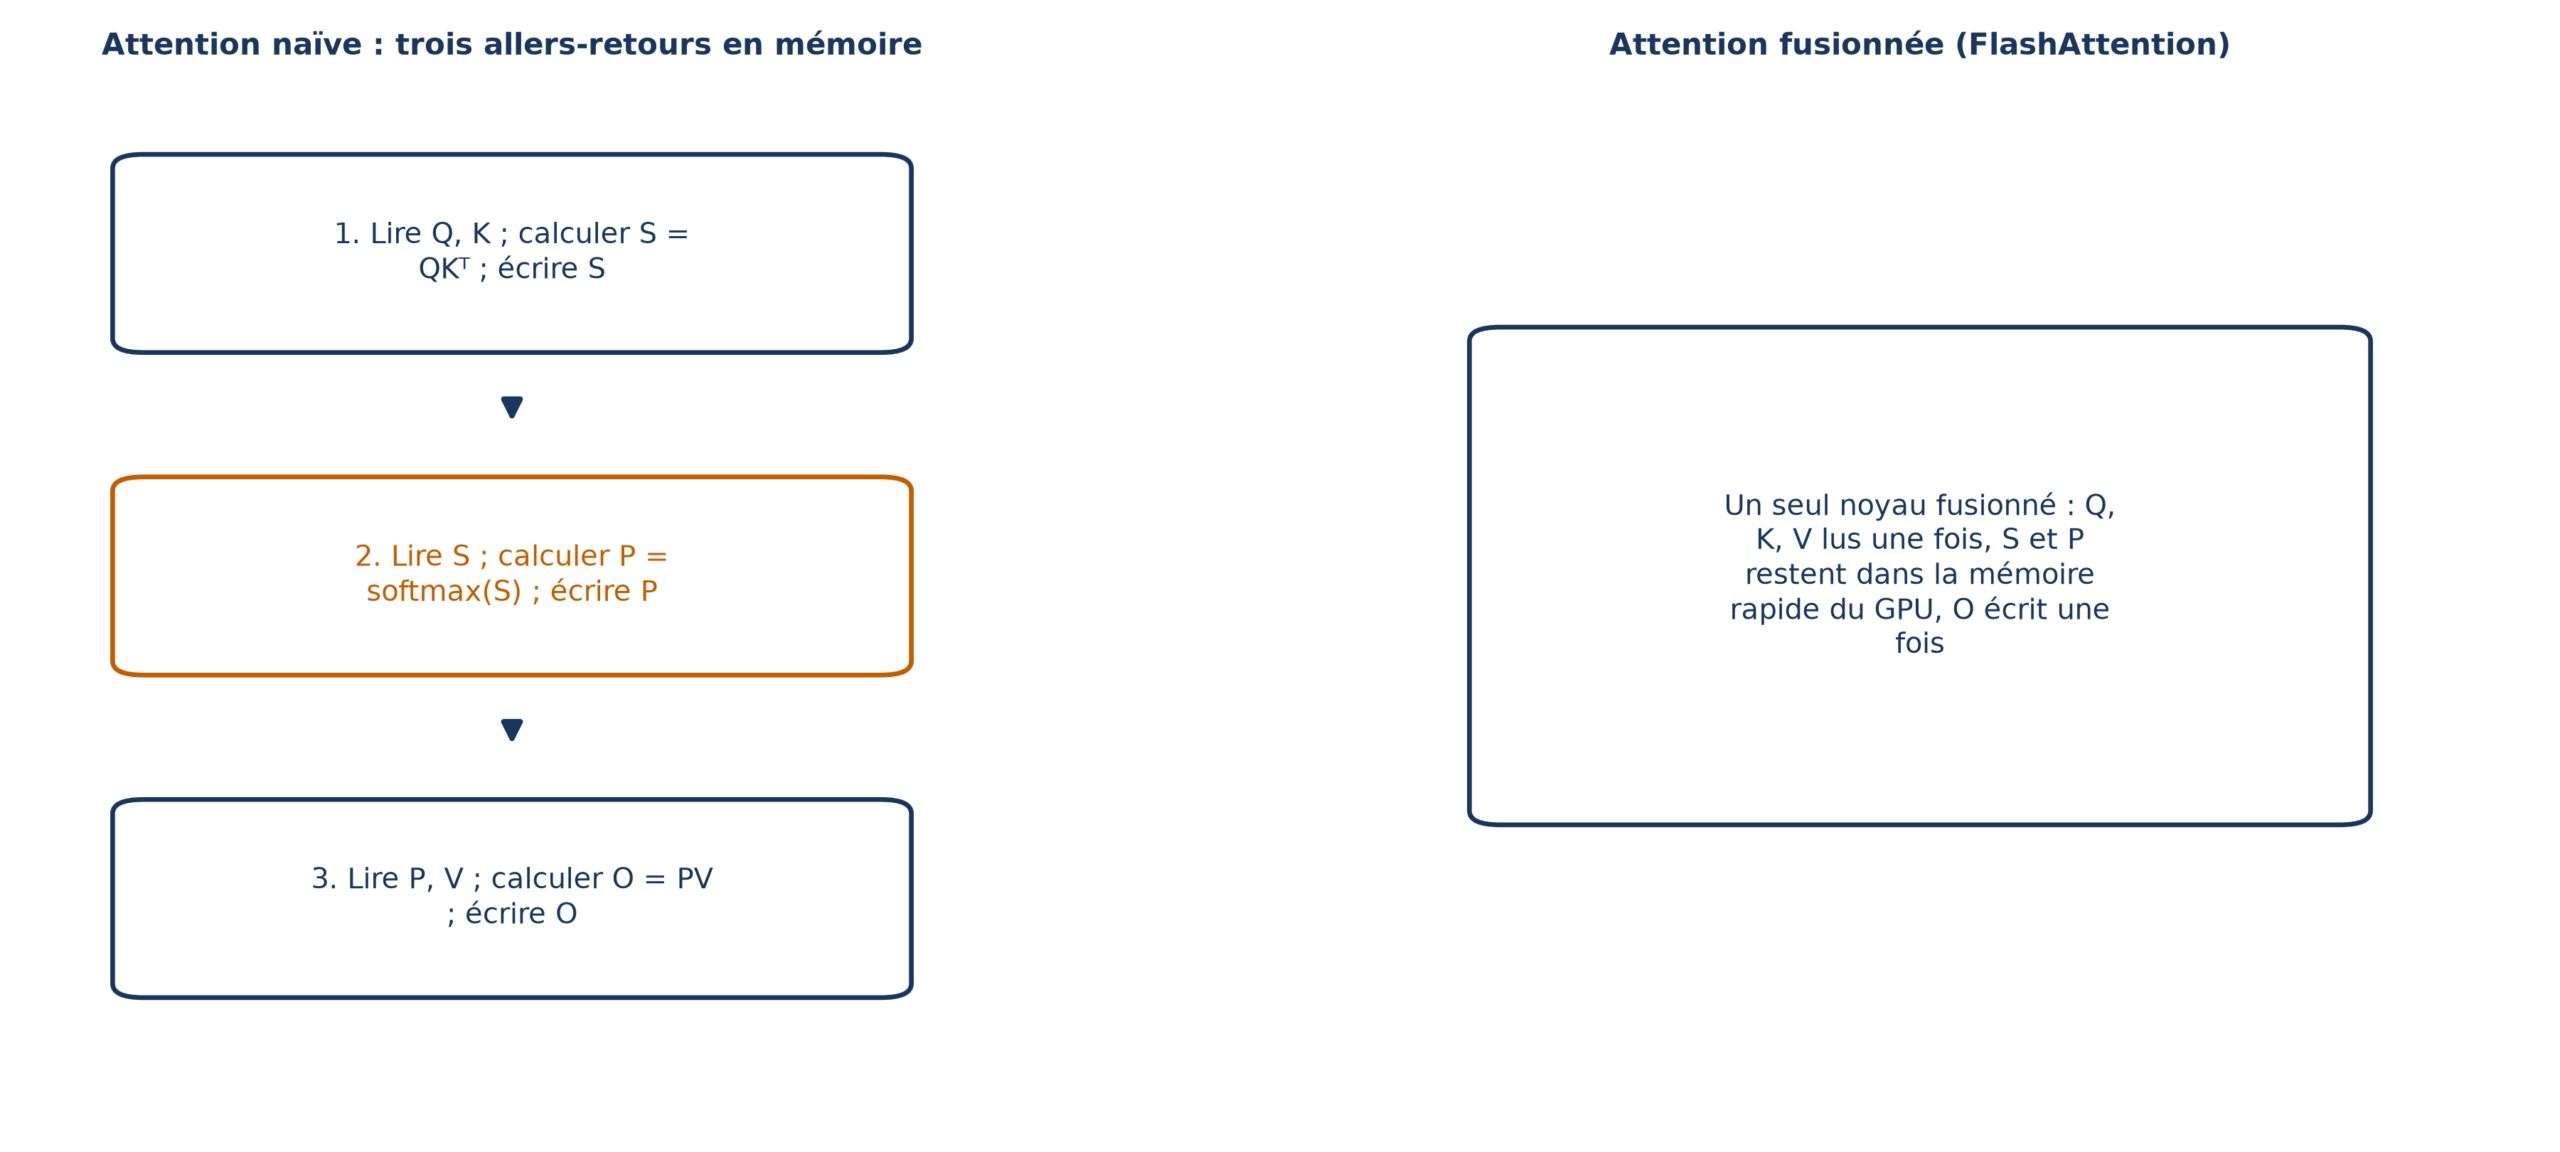
FlashAttention est une série de noyaux fusionnés à la main pour des GPU précis : le code pour H100 diffère de celui pour B200. Elle sert surtout aux opérations limitées par le calcul, comme le prefill ou la génération de vidéo. PagedAttention découpe le cache KV en blocs, les pages, accessibles par une table de correspondance : le cache peut vivre dans une mémoire fragmentée plutôt que dans un bloc contigu.
Ni l’une ni l’autre ne change la complexité quadratique de l’attention. Les variantes algorithmiques, elles, la changent. L’attention à fenêtre glissante ne regarde que les  derniers tokens, avec souvent compris entre 8 000 et 32 000, et passe de
 à
 . L’attention linéaire remplace le softmax quadratique par un algorithme linéaire qui l’approxime. Mamba, un modèle d’espace d’états sélectif, remplace carrément l’attention par une mise à jour d’état récurrente.
Pour les longues séquences, le prefill par morceaux (chunked prefill) découpe la grande entrée en morceaux exécutés en même temps que le decode, selon les ressources disponibles, pour qu’une longue séquence ne submerge pas le moteur.
Les six leviers de la couche d’exécution
Toutes les techniques ci-dessous partagent un principe : plus tu ajoutes de contraintes au système, meilleure est la performance. Elles se combinent, mais pas toujours harmonieusement, nous y reviendrons.
Regrouper les requêtes : le batching
Un même GPU peut traiter plus d’une requête à la fois. Le regroupement statique attend que le lot soit plein avant de démarrer. Le regroupement dynamique démarre quand le lot est plein ou quand un délai configuré est écoulé. Le regroupement continu insère les requêtes à mesure que des places se libèrent.
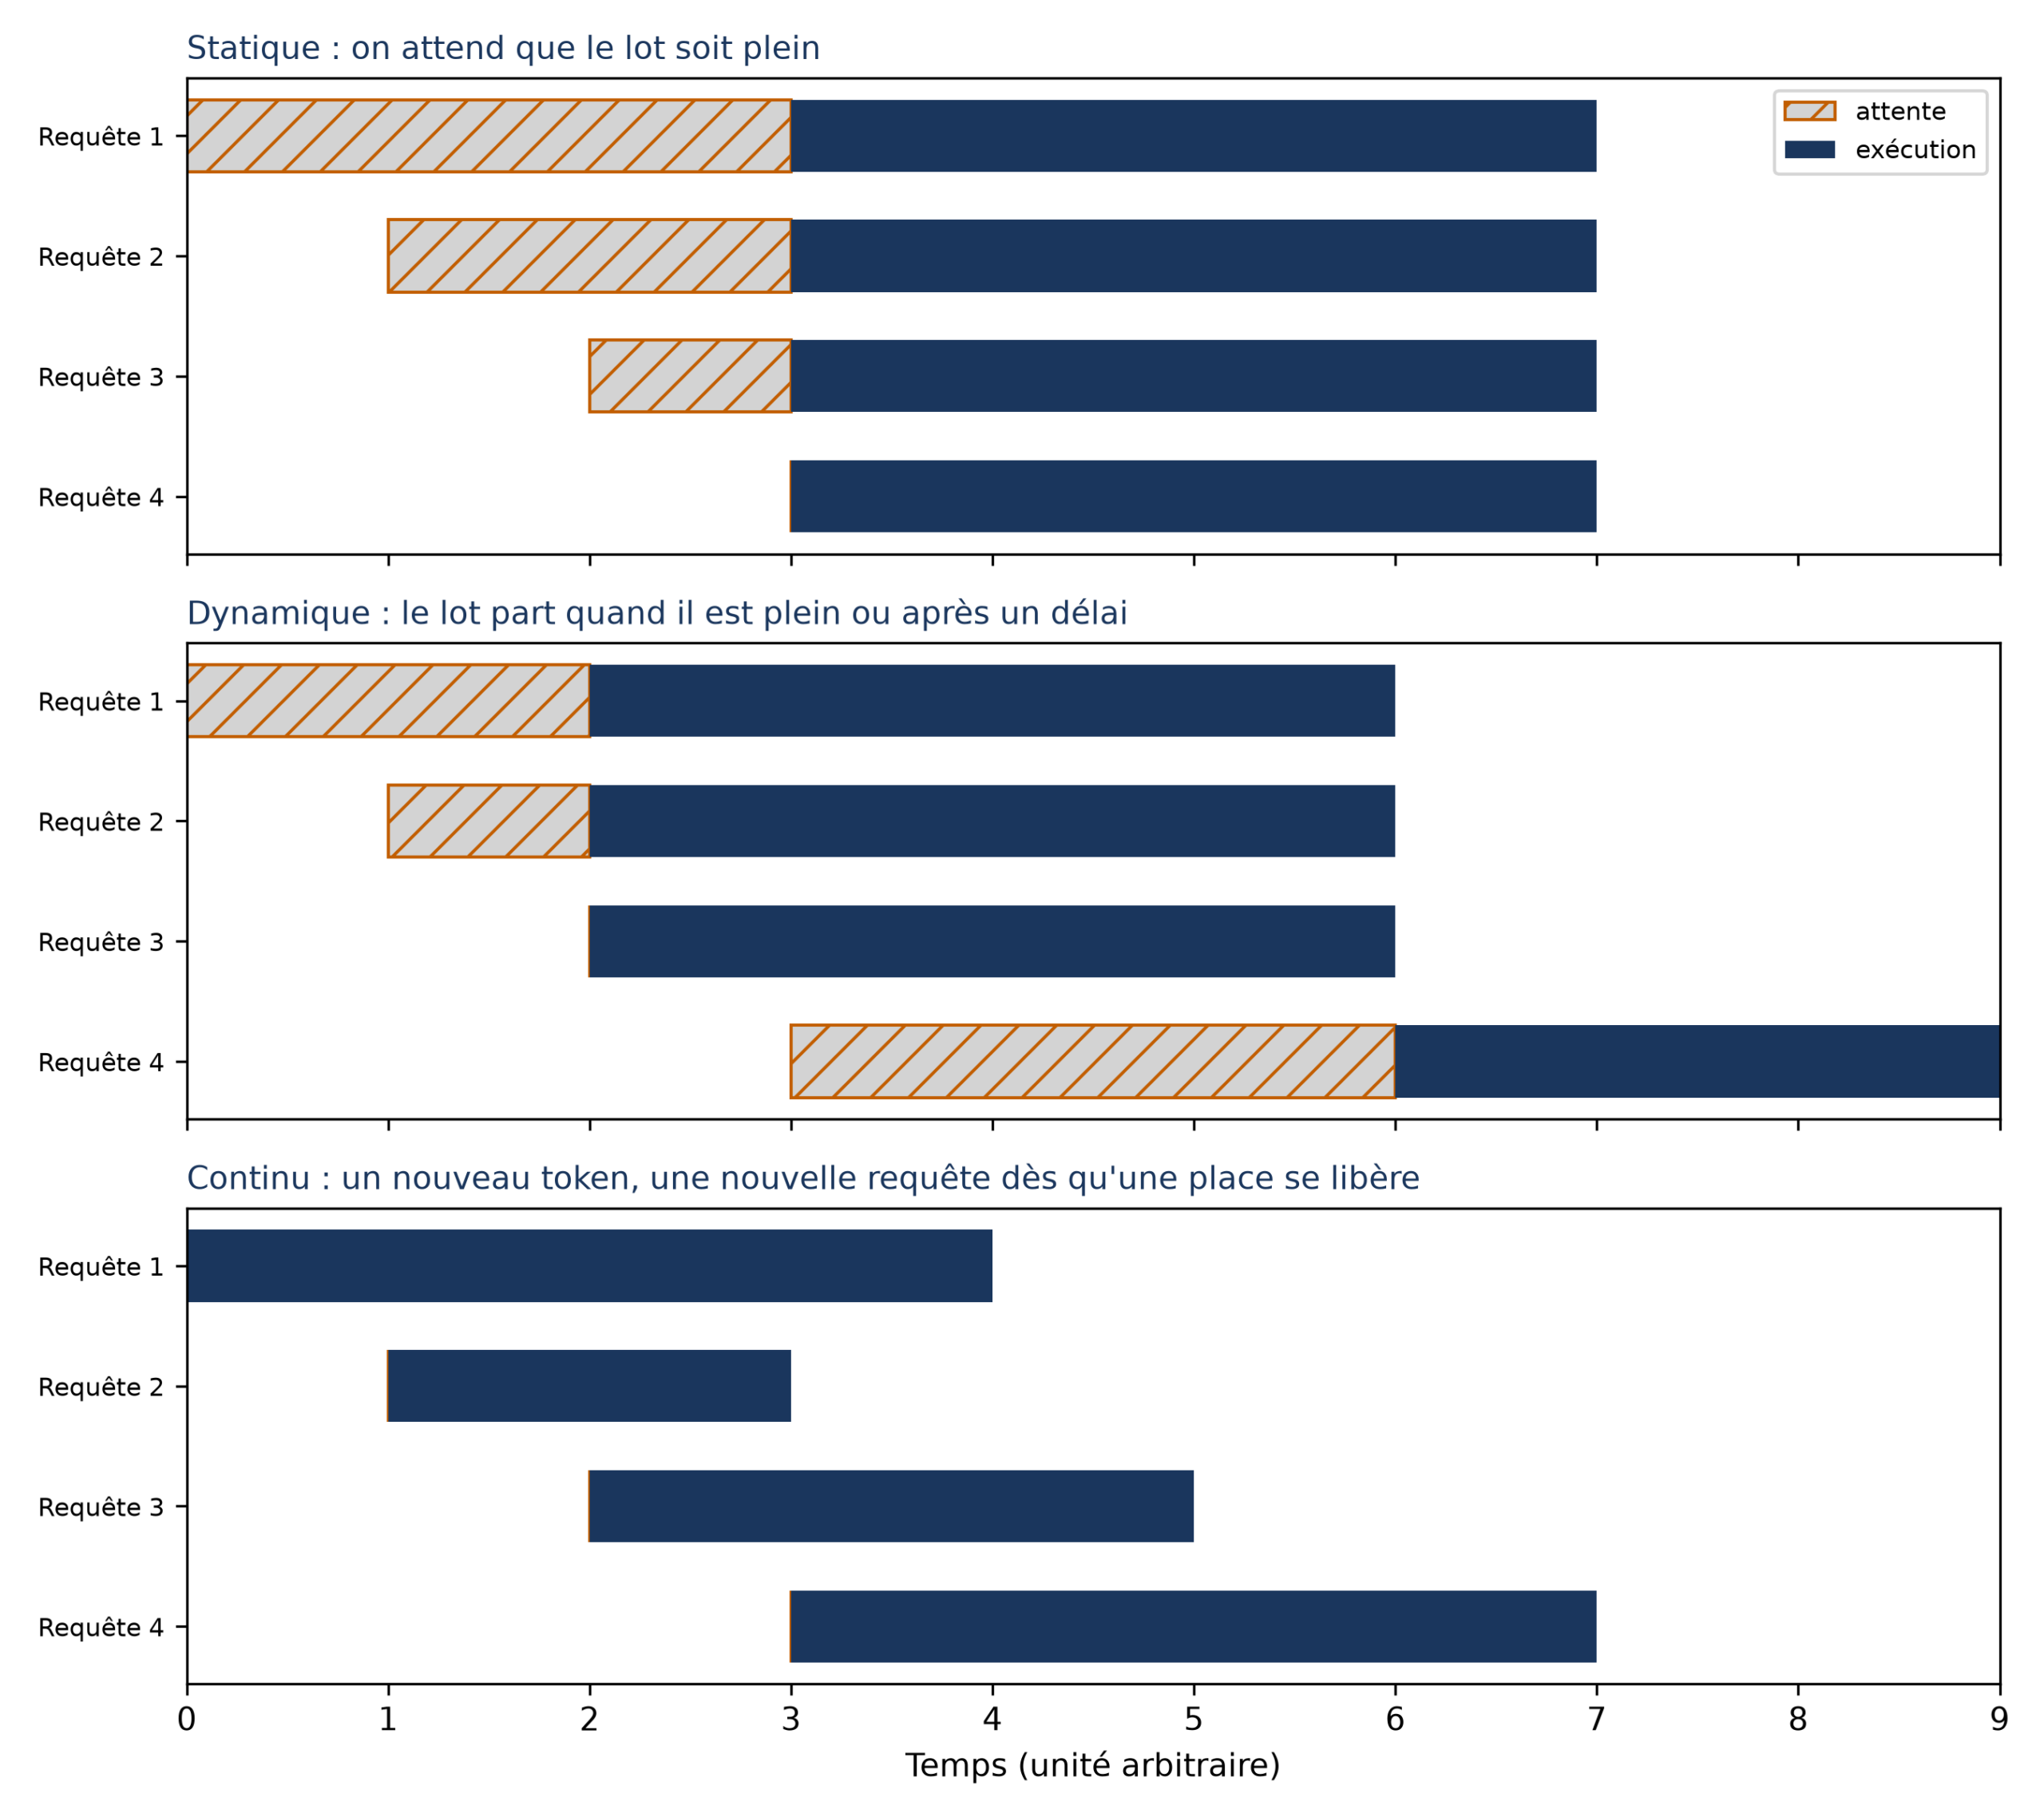
La taille de lot est un curseur : l’augmenter produit plus de débit global, mais la latence de chaque utilisateur se dégrade. Il faut donc tester plusieurs tailles de lot pour trouver le bon compromis pour ton modèle, ton instance, ta cible de latence et ton budget.
Quantifier : des nombres plus petits
Les modèles sont entraînés dans un format numérique natif, le plus souvent BF16 ou FP16. La quantification après entraînement convertit les poids et d’autres valeurs vers une précision inférieure. Diviser la précision par deux aide les deux phases : le prefill s’exécute sur des Tensor Cores de précision inférieure qui offrent deux fois plus de FLOPS, et le decode charge deux fois moins de données par valeur.
Le gain réel est moins beau que la théorie, car travailler sur des données quantifiées ajoute un surcoût : descendre d’un niveau de précision apporte en pratique 30 à 50 % de performance en plus pour les LLM.
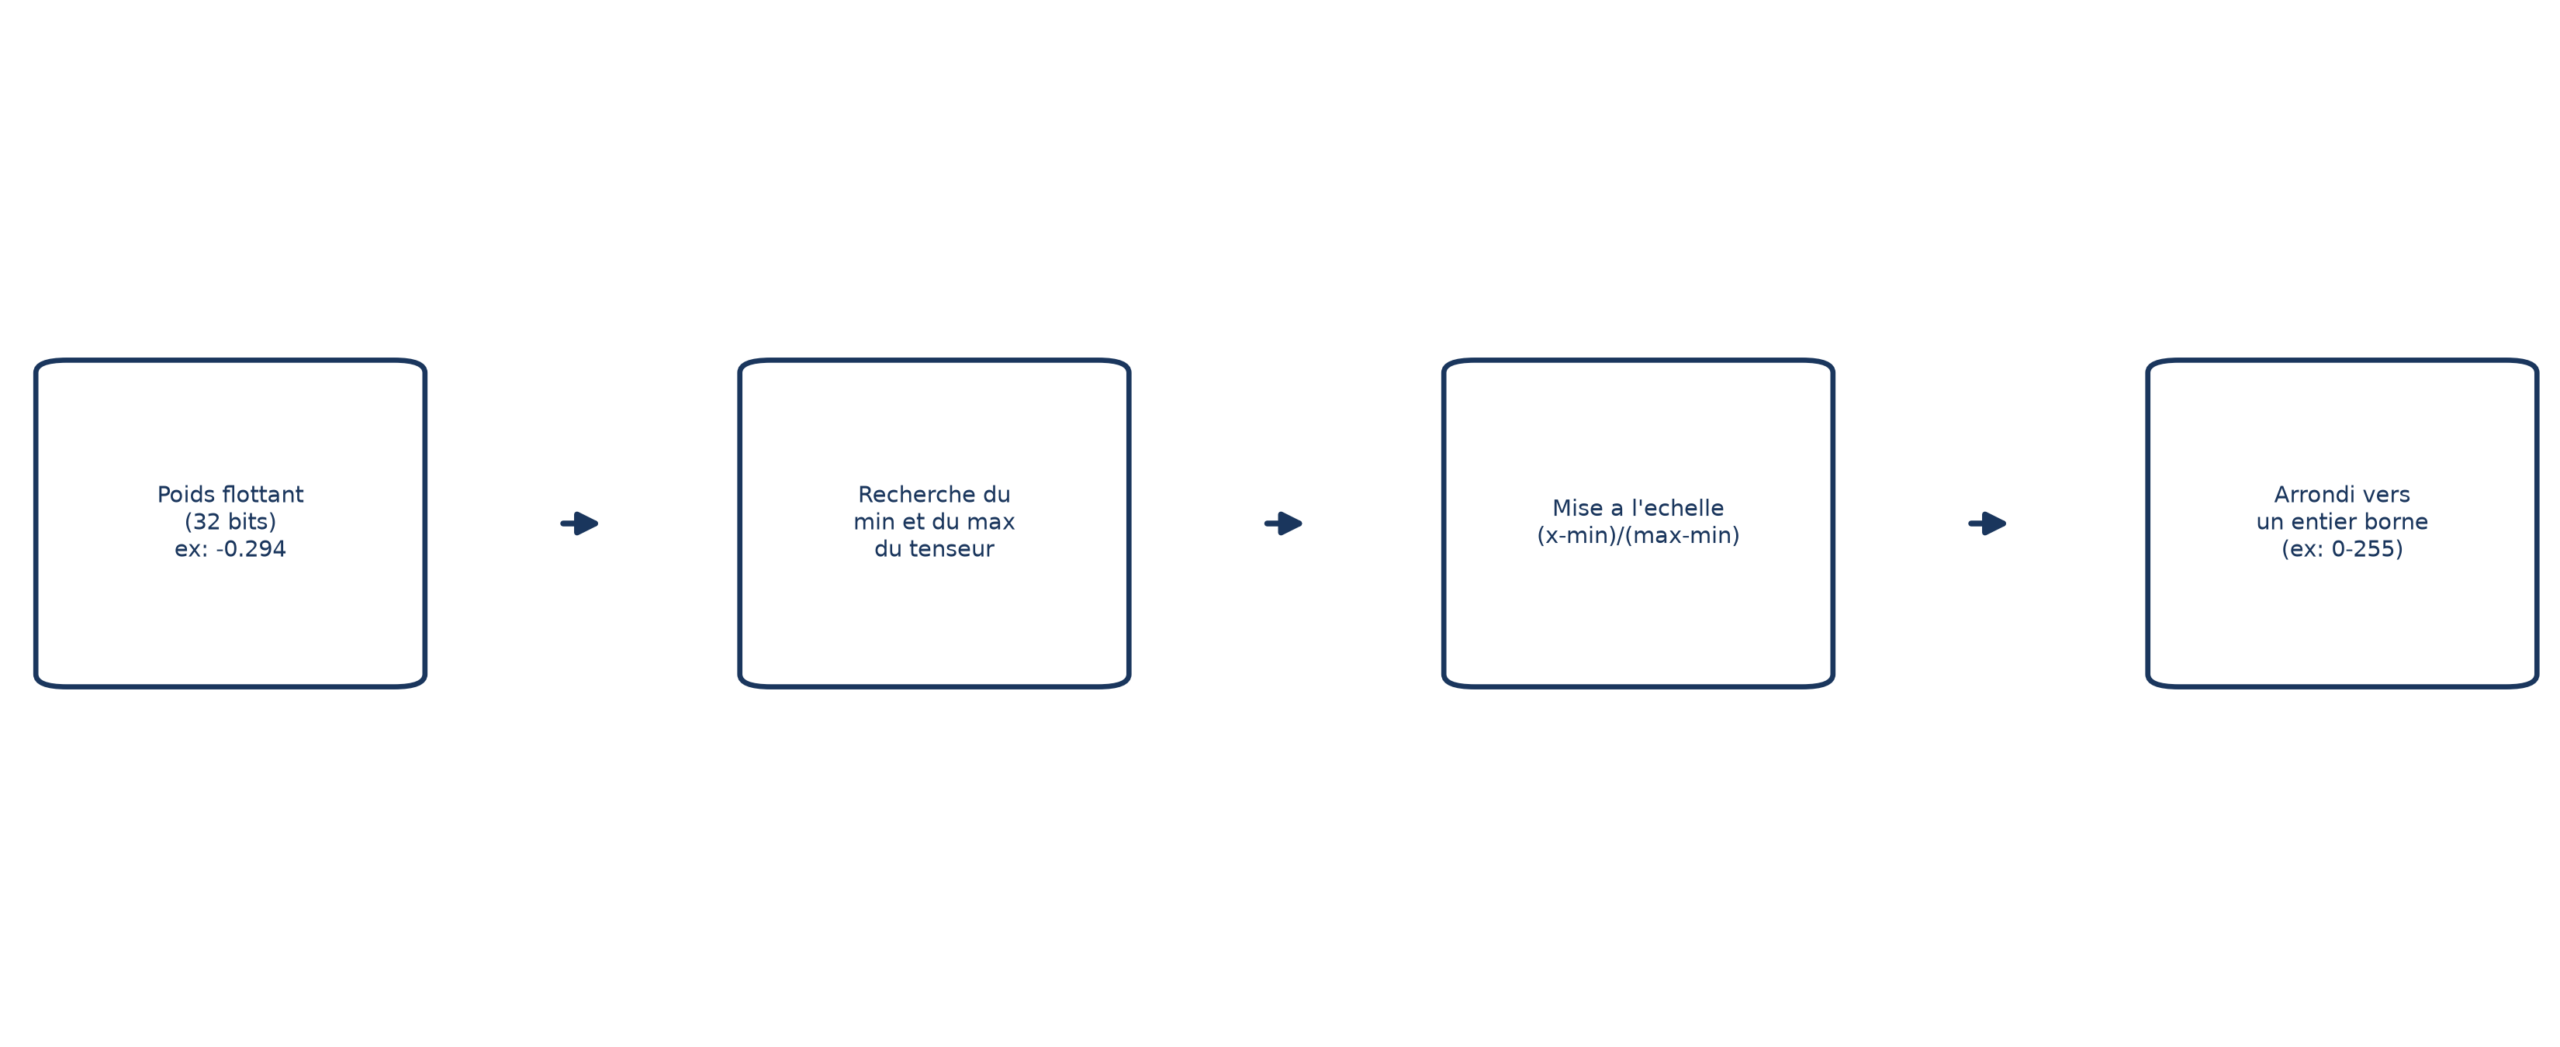 , puis on arrondit vers un entier borné, par exemple entre 0 et 255. Un poids flottant 32 bits comme −0,294 devient ainsi un simple entier.
Le revers, ce sont les erreurs de précision, qui s’accumulent. Élève au carré et au cube différentes précisions de π : avec 3,14159 tu obtiens 9,869588 et 31,006198 ; avec 3,14, 9,8596 et 30,959144 ; avec 3, tu obtiens 9 et 27. Tout le travail de quantification consiste à prévenir ces erreurs et à limiter leur effet sur la sortie finale.
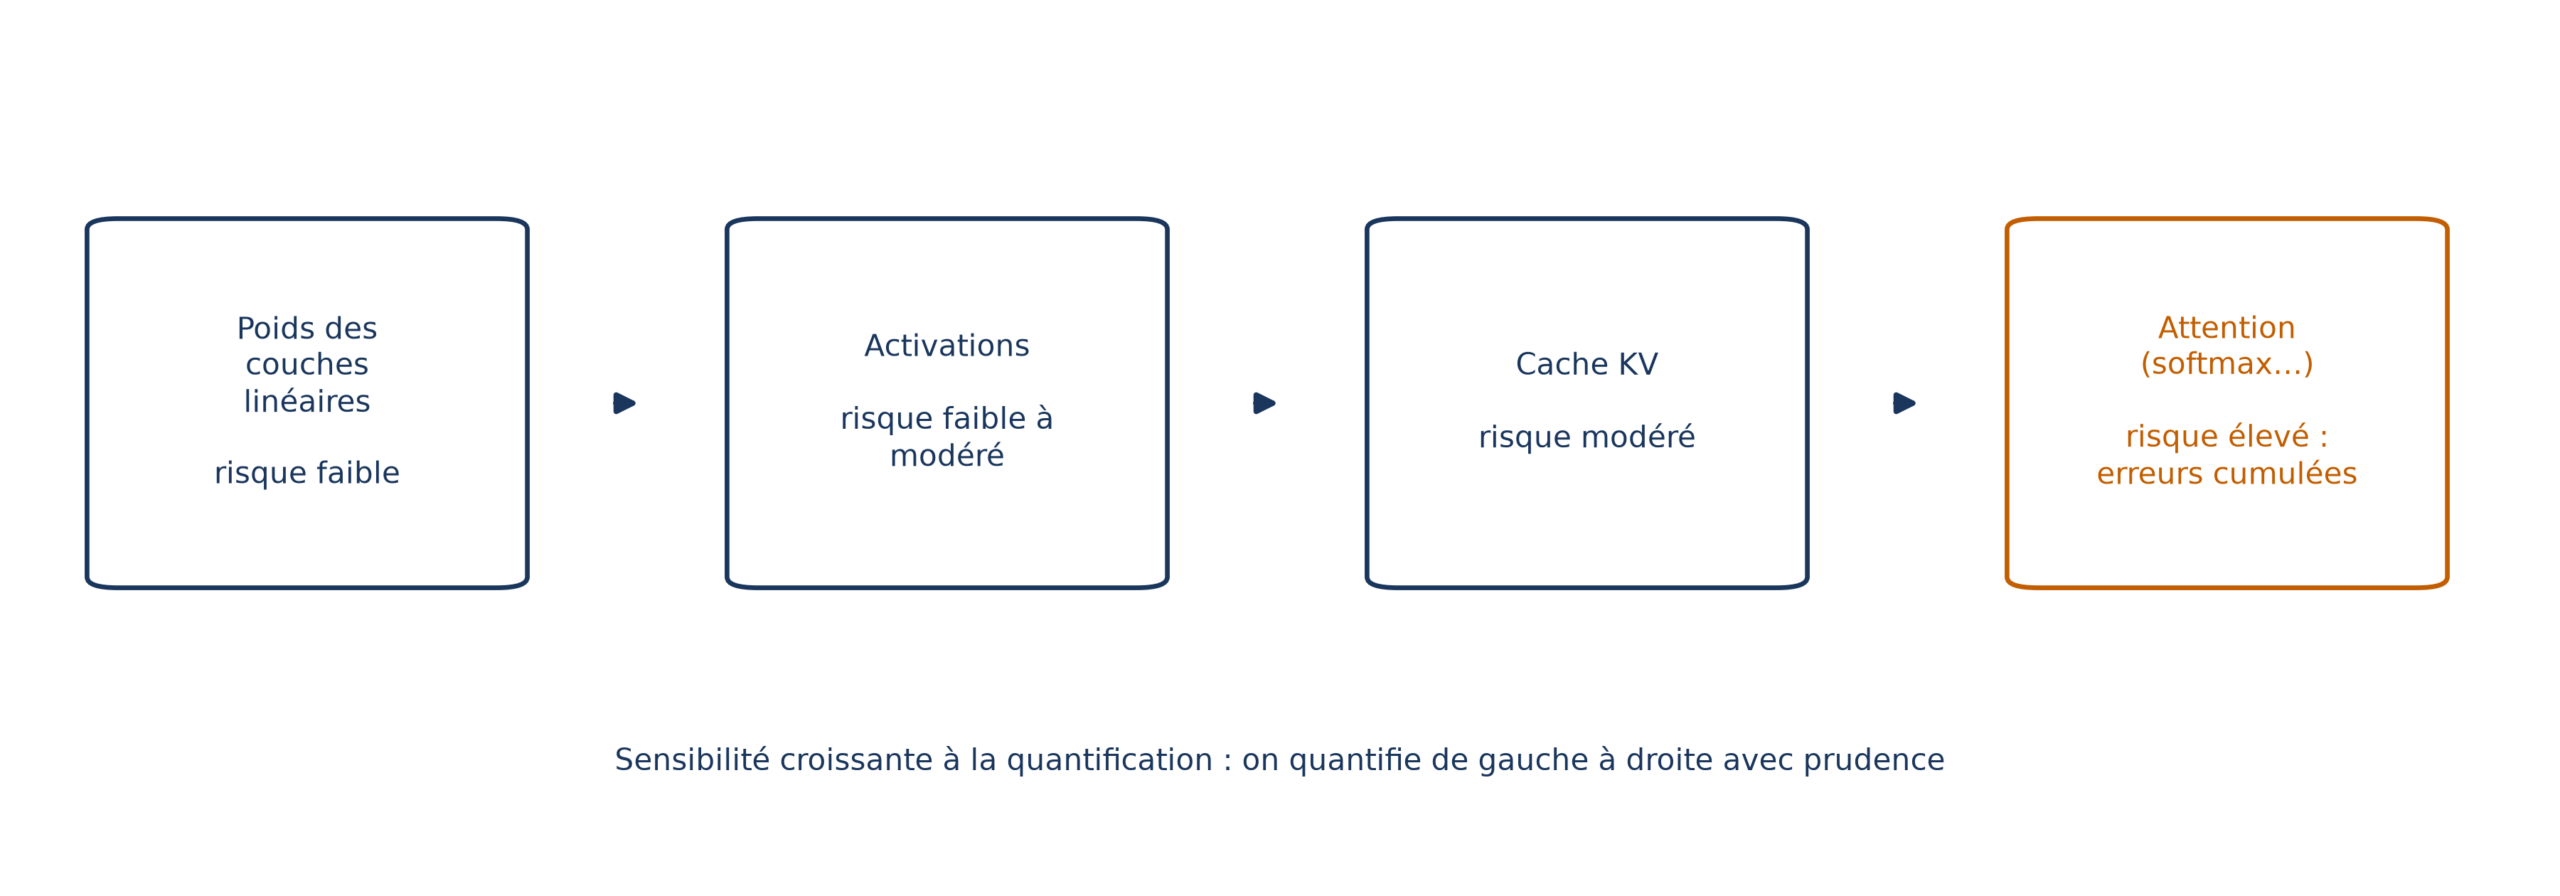
Tout ne se quantifie pas avec le même risque. De la moins à la plus sensible : les poids des couches linéaires, les activations, le cache KV, puis l’attention, très sensible, surtout des équations comme le softmax.
Côté formats, mieux vaut s’en tenir aux flottants : les entiers manquent de plage dynamique pour les charges sensibles à la qualité. Les flottants 8 bits (FP8, MXFP8) offrent généralement le meilleur compromis ; le FP4, surtout NVFP4, est prometteur.
Deux voies existent : l’entraînement conscient de la quantification (des laboratoires publient ainsi GPT-OSS en MXFP4 ou Kimi K2 Thinking en INT4) et la quantification après entraînement, la seule accessible quand on reçoit des poids terminés. NVIDIA TensorRT Model Optimizer est un outil de référence, et ses sorties sont compatibles avec vLLM, SGLang et TensorRT-LLM.
⚠️ Piège La quantification est une échelle, pas un choix binaire. Quantifie en FP8 plutôt qu’en FP4, ou seulement les poids, si la qualité ne peut pas être risquée. Pour vérifier, compare la perplexité avant et après (on cherche une hausse minimale), puis un banc d’essai public ou, mieux, une évaluation propre à ton domaine.
Spéculer : plusieurs tokens par passe
Le decode est limité par la mémoire : à lot faible ou modéré, le calcul reste au repos pendant que les poids sont lus. Le décodage spéculatif exploite ce calcul libre pour tenter de produire plusieurs tokens par passe avant dans le modèle cible.
Le mécanisme est commun à tous les algorithmes : un spéculateur propose un ou plusieurs tokens de brouillon, le modèle cible les valide en une seule passe, accepte ceux qui coïncident avec ce qu’il aurait généré, puis produit lui-même un token de plus. On obtient  tokens par passe, où
 est le nombre de brouillons acceptés.
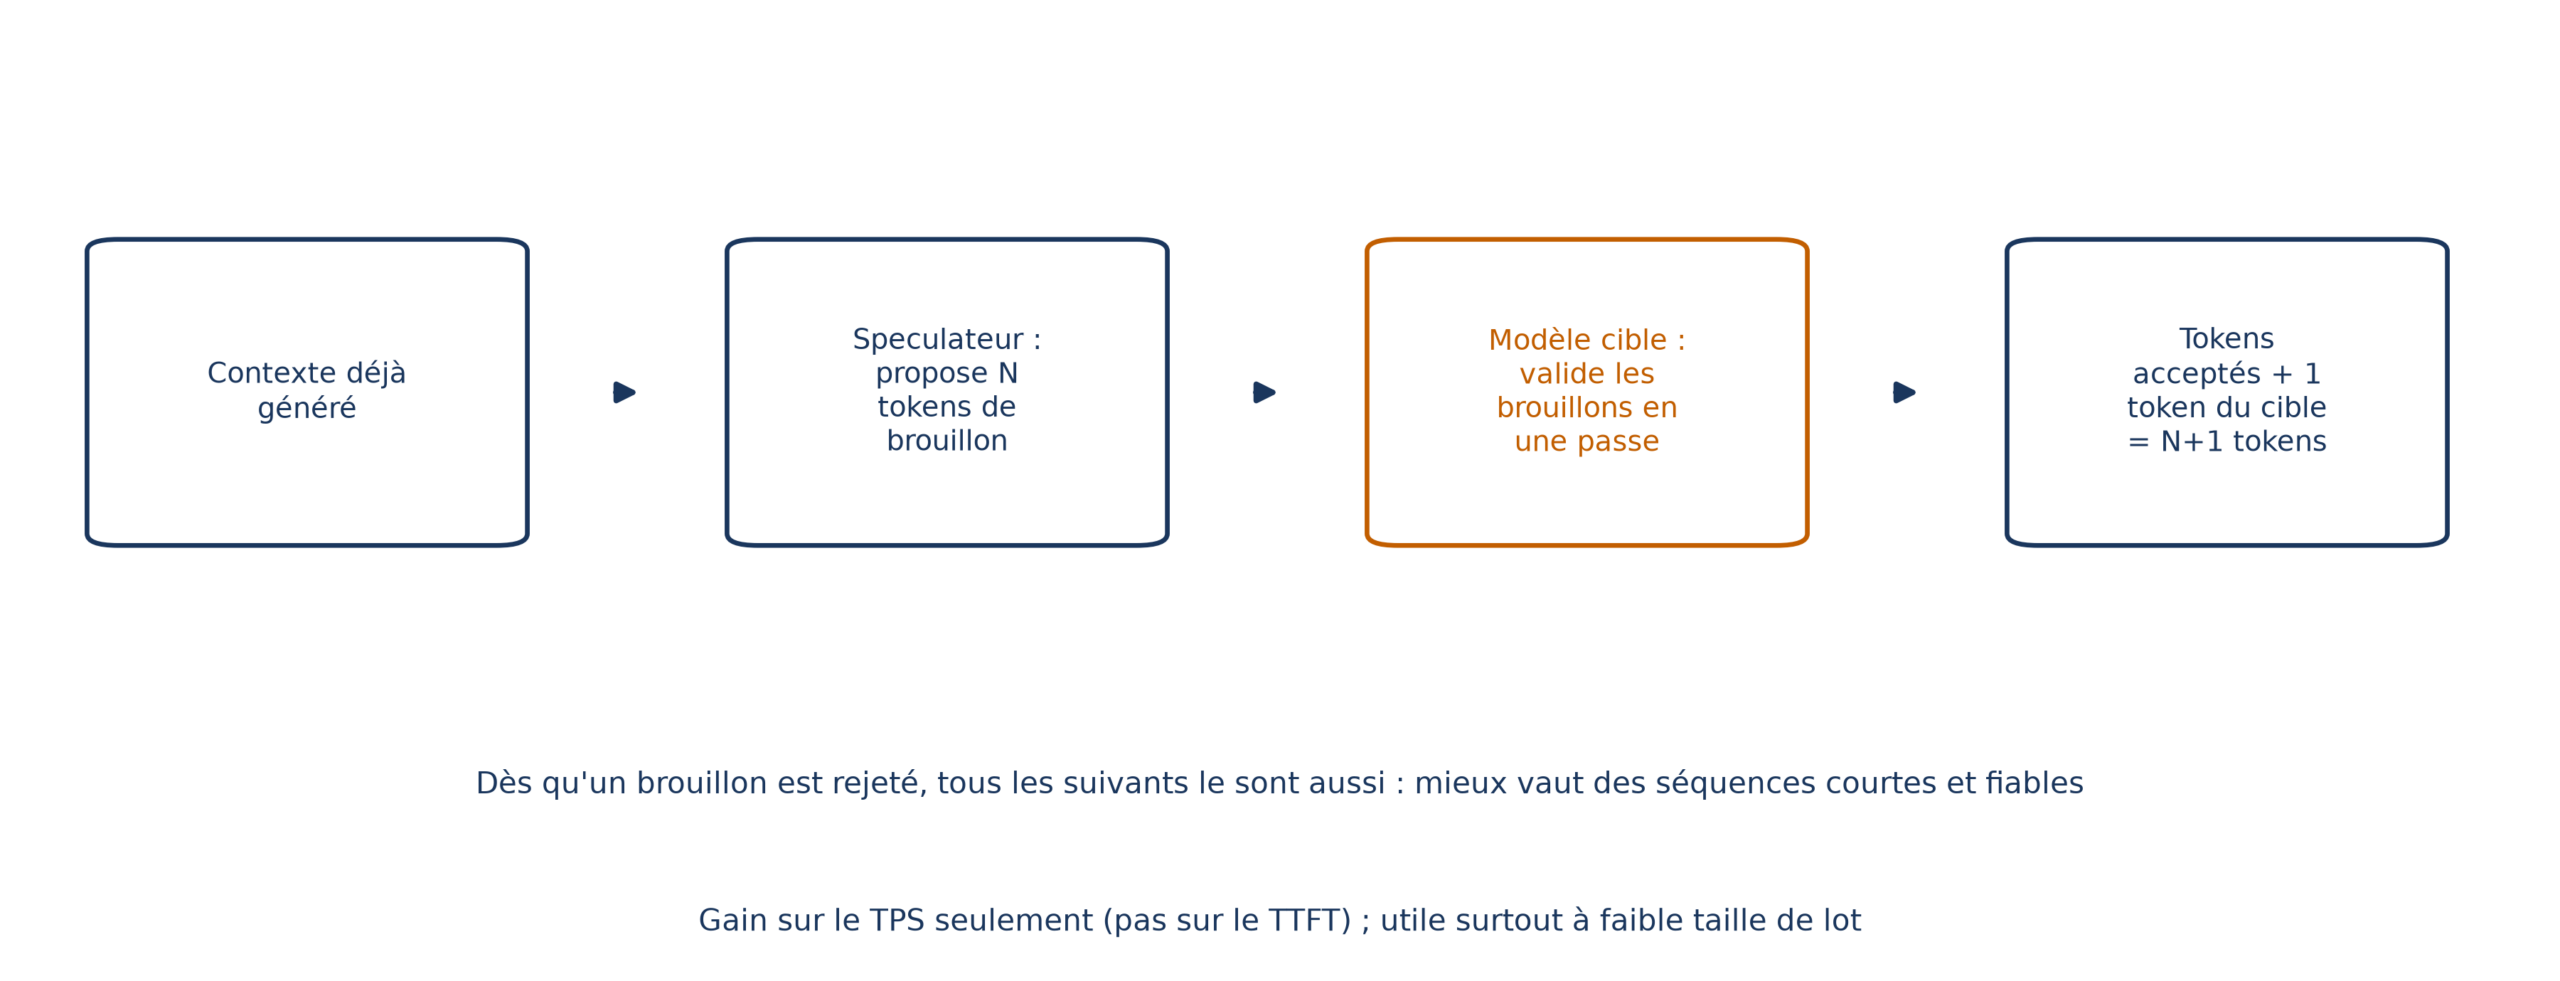
Pourquoi ça marche ? Vérifier est bien plus rapide que générer, comme une grille de sudoku : la résoudre est difficile, contrôler une grille terminée est facile. Le gain dépend de trois facteurs : le coût d’un token de brouillon, la longueur de la séquence de brouillon et le taux d’acceptation.
Le taux d’acceptation chute avec la température (des distributions plus difficiles à prédire) et varie avec le sujet traité. Autre limite : la spéculation n’aide qu’à faible taille de lot, là où il reste des cycles de calcul ; à lot élevé, le calcul est saturé et il faut la désactiver dynamiquement.
Trois variantes s’appuient sur un modèle de brouillon :
- Brouillon-cible : un petit modèle de la même famille génère les brouillons, avec en règle générale au moins dix fois moins de paramètres. Simple à mettre en place, mais au surcoût le plus élevé.
- Medusa : elle affine le modèle cible pour lui greffer de deux à quatre têtes de décodage supplémentaires. Peu utilisée en production, elle a inspiré EAGLE.
- EAGLE : un modèle de brouillon entraîné sur les états cachés du modèle, jusqu’à huit tokens de brouillon avec un très haut taux d’acceptation. C’est l’algorithme de référence pour un usage général chez les ingénieurs qui savent entraîner ces têtes.
La spéculation par n-grammes fait sans modèle de brouillon : elle construit pendant le prefill un dictionnaire de séquences du texte d’entrée. Elle dépasse dix tokens de brouillon, mais n’est efficace que quand la sortie ressemble à l’entrée, comme en complétion de code. Le décodage anticipé (Lookahead Decoding) généralise l’idée en produisant les n-grammes pendant l’inférence, au prix de calcul supplémentaire.
Mettre en cache : ne pas refaire ce qui est fait
Tous les moteurs utilisent le cache KV requête par requête : sans lui, il faudrait recalculer chaque valeur précédente de toute la séquence pour chaque nouveau token. On peut en tirer plus en le réutilisant d’une requête à l’autre.
Prenons deux prompts de quatre tokens qui commencent par « Weather in ». Par défaut, le moteur exécute le prefill sur les quatre tokens de chacun. Avec le cache de préfixe, il réutilise le cache KV de la première requête et saute le prefill des deux premiers tokens de la seconde. Les API facturent moins cher les tokens d’entrée « avec succès de cache » pour cette raison.
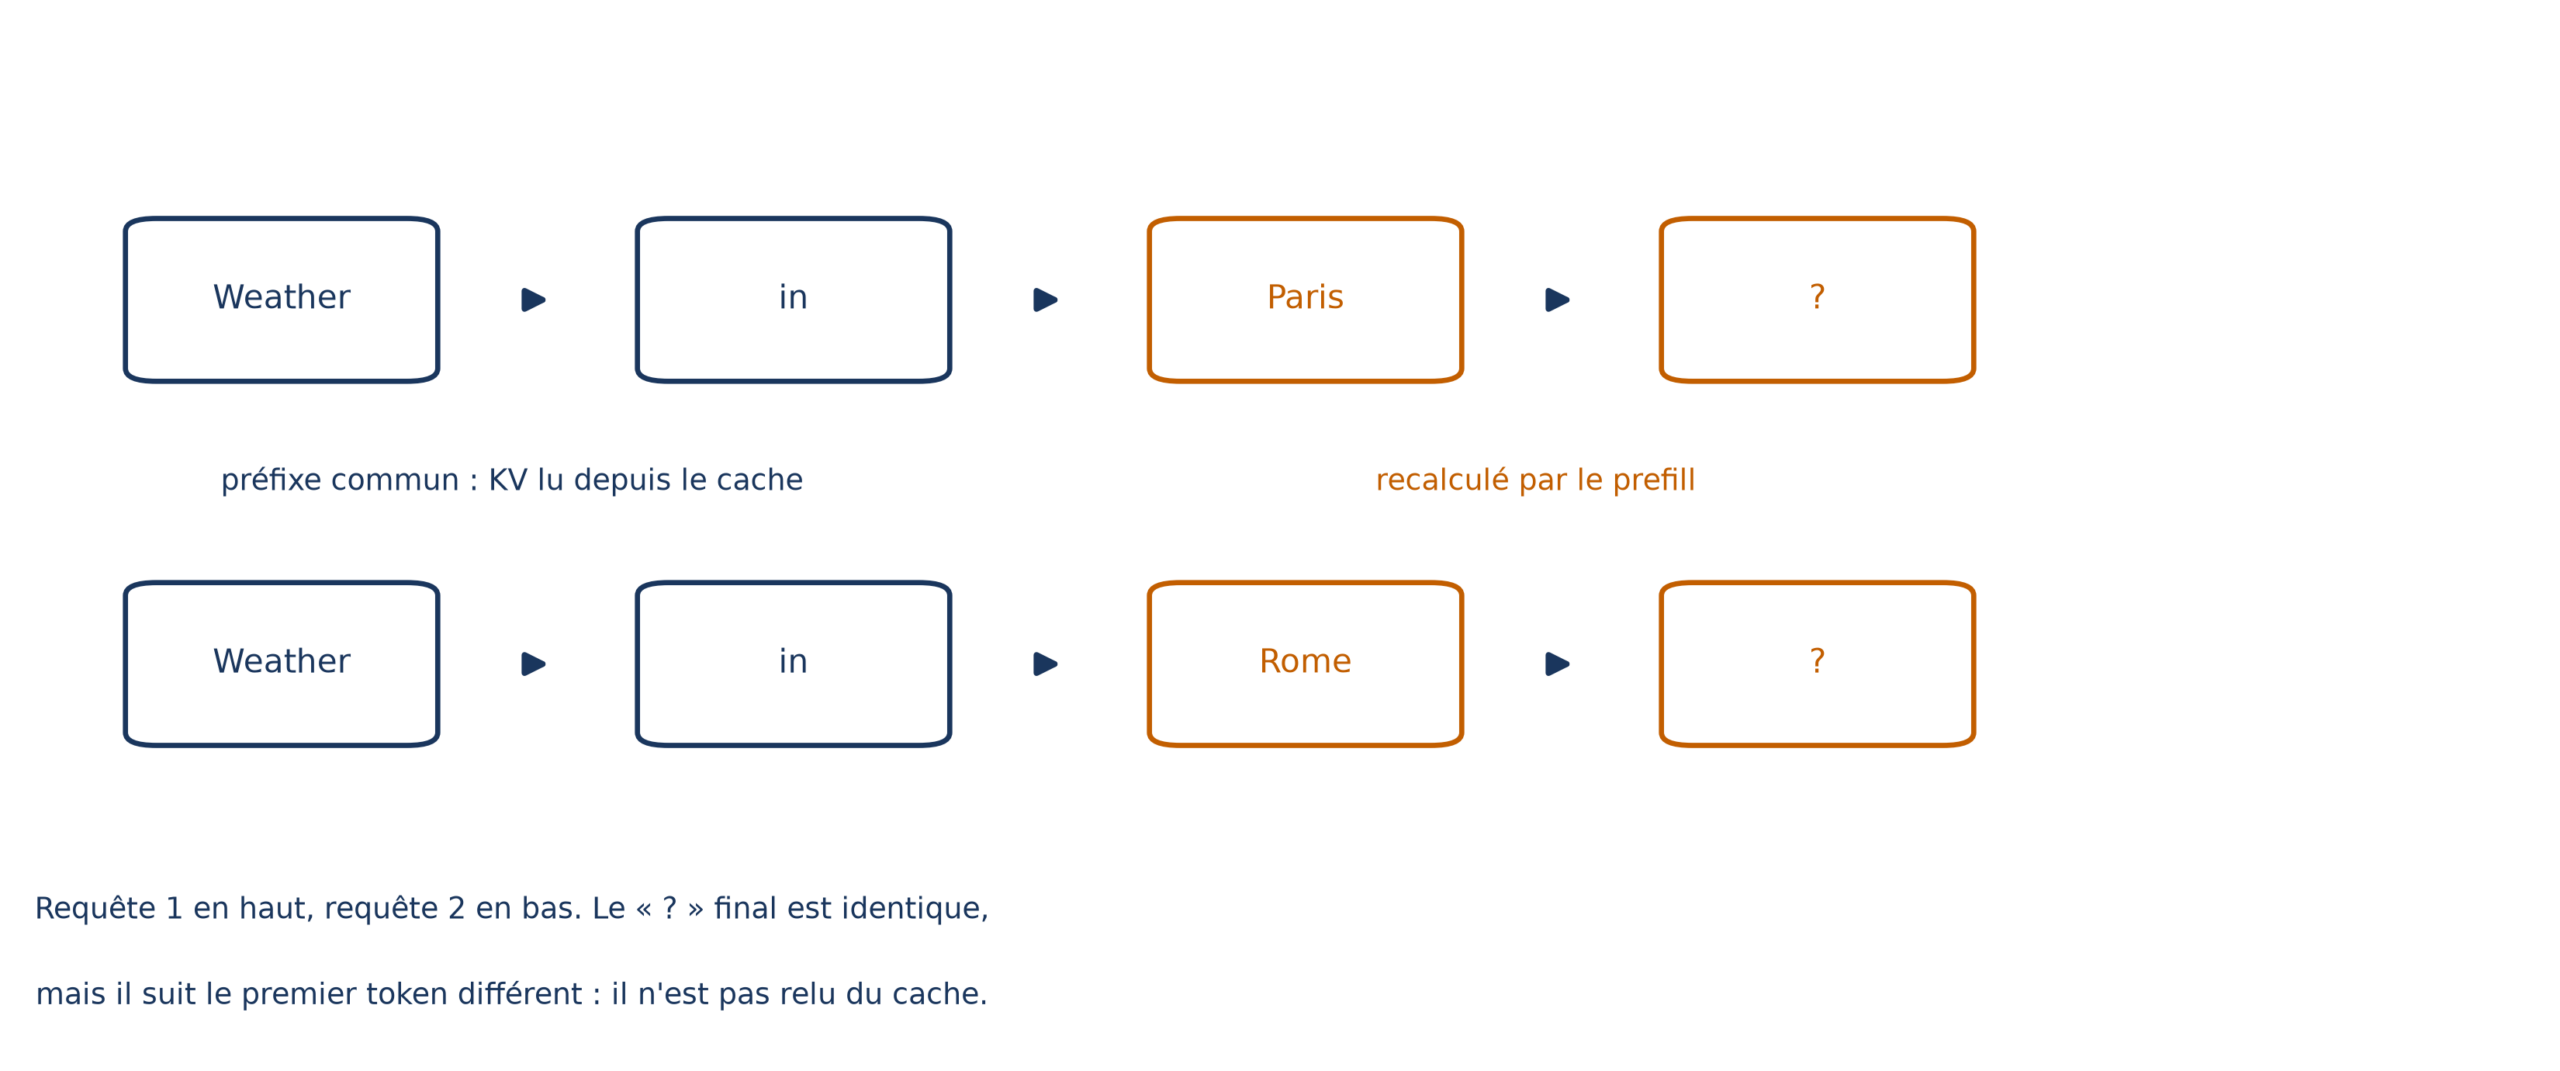
Le cache de préfixe fonctionne du début de la séquence jusqu’au premier token non répété. Si le tout premier token diffère, il n’y a aucune économie, même si tous les suivants sont identiques. Place donc les tokens nouveaux le plus tard possible dans le contexte : c’est ton ingénierie de contexte qui détermine les économies de TTFT.
Les gains deviennent massifs là où de longues parties se répètent : invites système d’agents ou de chatbots, complétion de code, résumé et questions-réponses sur documents, conversations à plusieurs tours. Pour dépasser la limite du préfixe, des outils comme CacheBlend et LMCache prennent en charge des séquences hors préfixe.
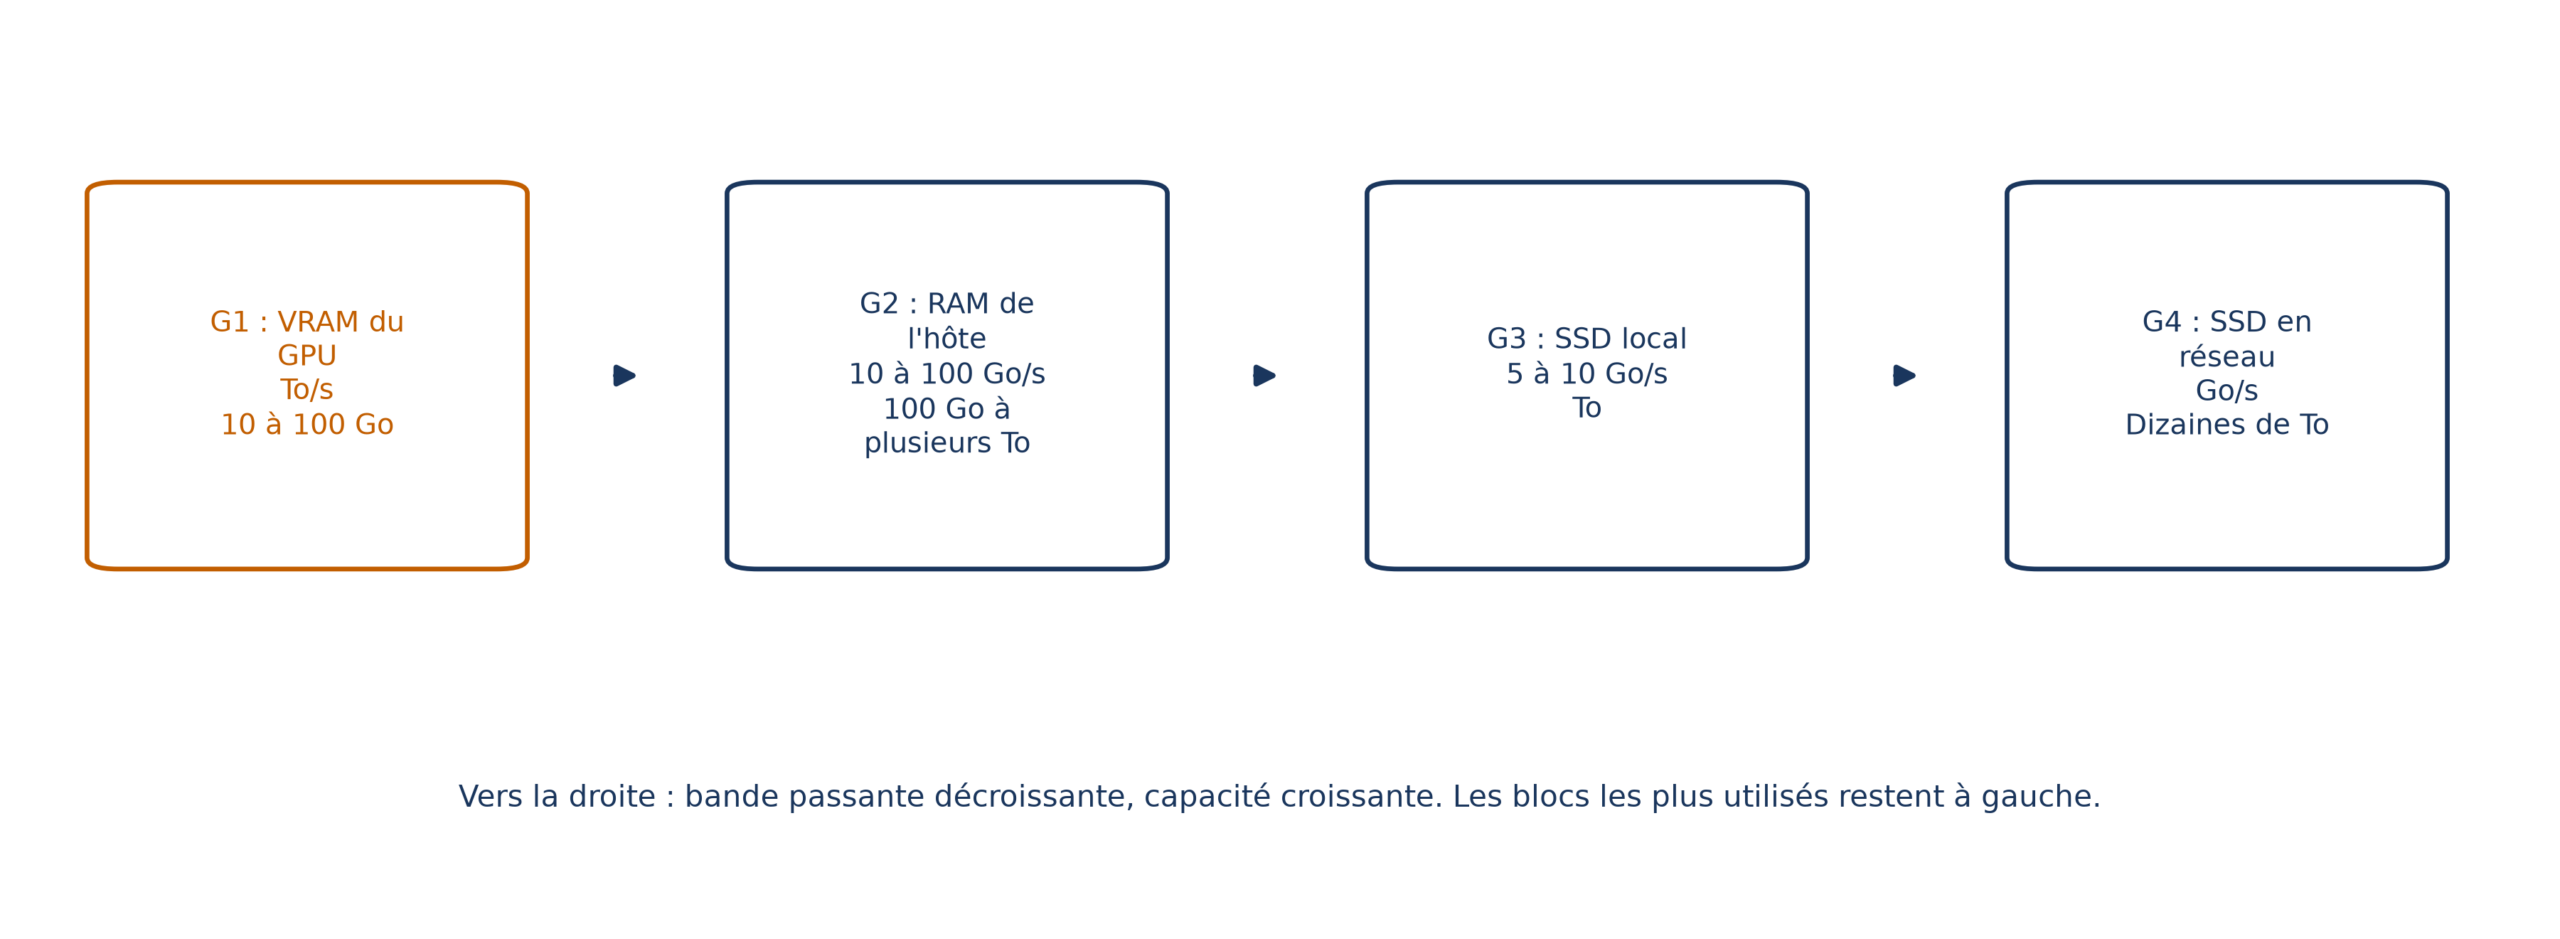
Reste un problème : le cache KV occupe beaucoup de mémoire. On peut le décharger de la VRAM vers d’autres stockages, par bande passante décroissante : G1 (VRAM du GPU, de l’ordre du To/s pour 10 à 100 Go), G2 (RAM de l’hôte, 10 à 100 Go/s), G3 (SSD local, 5 à 10 Go/s) et G4 (SSD en réseau, de l’ordre du Go/s pour des dizaines de To).
Avec plusieurs réplicas, le routage doit lui aussi tenir compte du cache : un utilisateur en longue conversation doit atterrir autant que possible sur le même réplica pour obtenir un succès de cache. On parle de routage conscient du cache. Un cache global sur stockage réseau G4 garantit en plus que les séquences en cache ne sont pas perdues quand des nœuds s’arrêtent pendant la mise à l’échelle.
Paralléliser : quand un GPU ne suffit plus
Tous les LLM de pointe sont trop gros pour tenir sur un seul GPU en inférence par lots. Il ne suffit d’ailleurs pas de faire tout juste tenir les poids : le cache KV occupe souvent 80 % ou plus de la VRAM restante après les poids. Avec quatre B200, soit 720 Go, on pourrait théoriquement charger les poids de DeepSeek, mais il ne resterait aucune place pour le cache KV. Un nœud complet de huit B200 est nécessaire pour un vrai trafic de production.
Il existe trois formes de parallélisme de modèle :
- Pipeline (PP) : les couches sont réparties entre les GPU. Latence et usage médiocres ; il n’est pas recommandé, sauf pour l’inférence multi-nœuds.
- Tensoriel (TP) : les tenseurs de chaque couche sont répartis. Les opérations lourdes sont partagées, mais il faut synchroniser les GPU. C’est généralement le meilleur choix pour une faible latence dans un seul nœud.
- Experts (EP) : dans un modèle MoE, chaque expert vit sur un GPU. Il faut du routage entre GPU, mais le débit est meilleur.
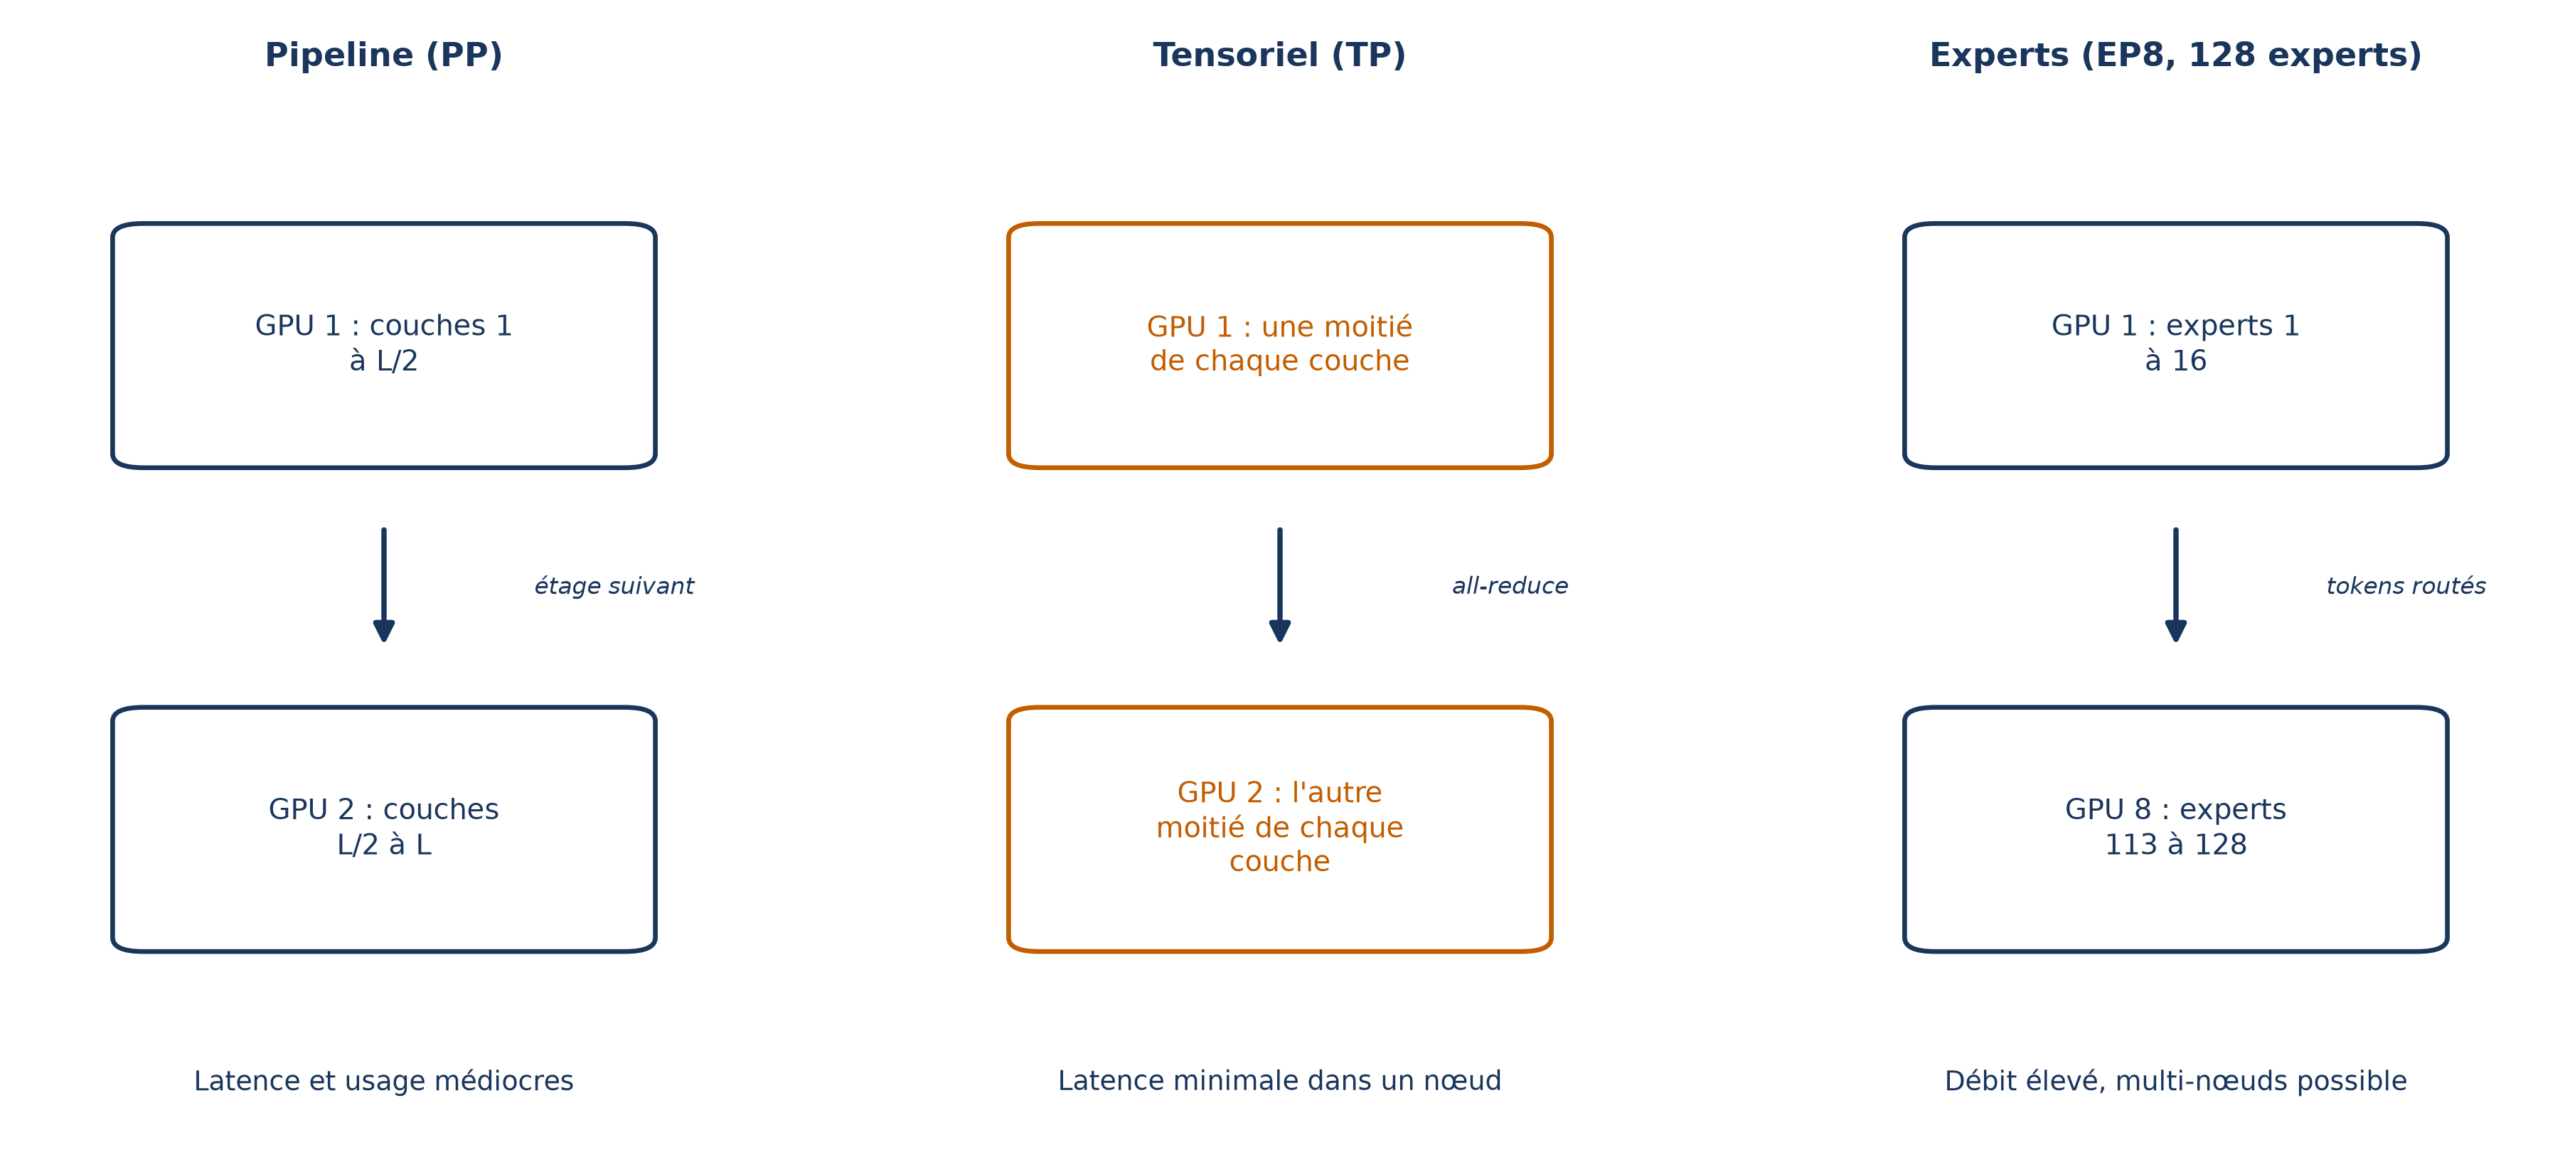
Le parallélisme tensoriel doit être ta stratégie par défaut. Mais les résultats de chaque couche doivent être combinés par une réduction collective (all-reduce) avant la couche suivante : sur des nœuds équipés de NVLink et NVSwitch, ce surcoût de communication est minimisé. De nombreux déploiements mêlent TP pour l’attention et EP pour la couche MoE parcimonieuse.
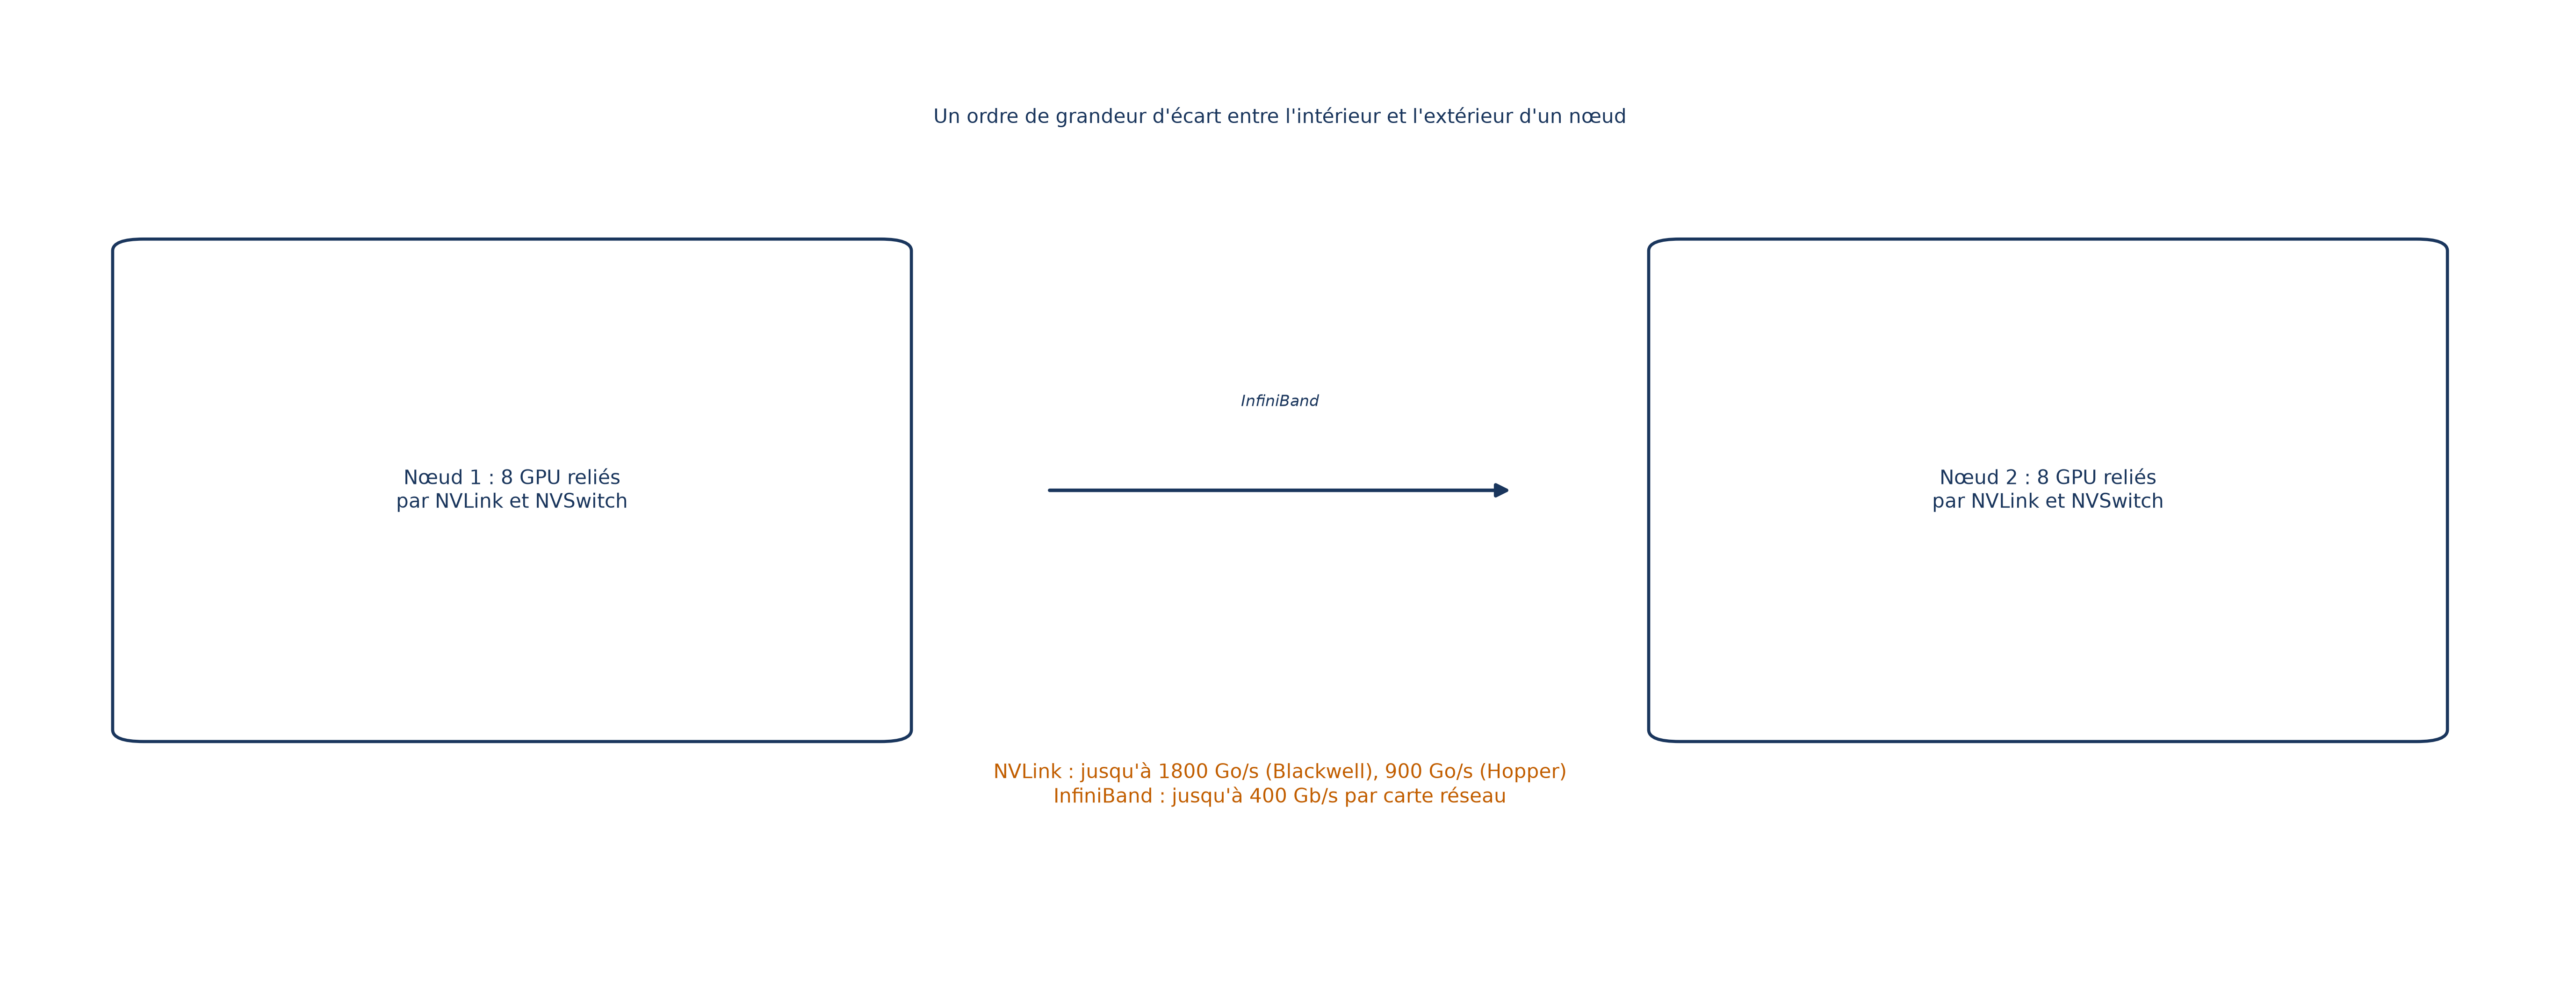
Sur InfiniBand, le TP exige trop de communication entre GPU. Deux options fonctionnent : pour les modèles denses, du TP dans chaque nœud et du PP entre les nœuds (TP8PP2) ; pour les MoE, le parallélisme d’experts (EP16). Pour les MoE, TP8PP2 offrira généralement une latence plus basse par utilisateur, et EP16 un débit global plus élevé.
Désagréger : séparer prefill et decode
Quand prefill et decode tournent sur le même nœud sous fort trafic, ils se gênent : le prefill consomme du calcul, le decode de la mémoire, et avec de plus grands lots ils se disputent les ressources.
La désagrégation les sépare en moteurs distincts, sur des GPU ou des nœuds distincts. Le moteur de prefill prend la séquence d’entrée et génère un cache KV en calculant le premier token ; il envoie le cache KV au moteur de decode par l’interconnexion matérielle ; le moteur de decode calcule tous les tokens suivants.
Les vrais systèmes ne comptent pas un moteur de chaque sorte. On note xPyD le nombre de moteurs de prefill et de decode : 5P3D signifie cinq moteurs de prefill et trois de decode au service d’un même déploiement. Le nouveau goulot devient la taille de la file de prefill, et l’autre est le manque de cache KV sur les moteurs de decode sous forte charge, soulagé par la quantification et le déport du cache KV.
📌 À retenir Ces six leviers servent à contourner un goulot. Le batching rend le decode moins limité par la mémoire, la quantification diminue les octets à lire, la spéculation produit plusieurs tokens par lecture des poids, le cache évite de recalculer, le parallélisme étale poids et cache sur plusieurs GPU, la désagrégation spécialise chaque phase.
Quel moteur pour appliquer tout ça ?
Tu n’as pas à réimplémenter ces techniques : trois moteurs concurrents les intègrent. Ils offrent de bonnes performances prêtes à l’emploi et fonctionnent d’emblée avec le regroupement continu ; ils prennent en charge quantification, décodage spéculatif, cache de préfixe, parallélisme et désagrégation. Les moteurs sont puissants parce qu’ils sont configurables : tu testes des combinaisons plutôt que de répéter des implémentations routinières.
| vLLM | SGLang | TensorRT-LLM | |
|---|---|---|---|
| Performance | Bonne | Bonne | La meilleure |
| Facilité d’usage | Facile | Facile | Difficile |
| Modèles pris en charge | La plupart | La plupart | Certains |
| Matériel | GPU, TPU | NVIDIA, AMD | NVIDIA seulement |
| Licence | Apache 2.0 | Apache 2.0 | Apache 2.0 |
vLLM et SGLang sont plus généralistes et prennent en charge davantage de modèles dès le premier jour ; TensorRT-LLM a une courbe d’apprentissage plus raide mais atteint généralement la meilleure performance, en grande partie grâce aux noyaux écrits et fusionnés à la main par les ingénieurs de NVIDIA. Pour orchestrer ces moteurs à grande échelle, NVIDIA Dynamo ajoute routage KV distribué, désagrégation et parallélisme multi-nœuds ; sans volume suffisant, il serait une surcharge inutile.
Le voir tourner : DeepSeek sur huit GPU
Reprenons notre fil rouge. Première question : combien de GPU faut-il ? On estime le minimum en multipliant la précision, le nombre de paramètres et l’allocation prévue pour le cache KV, puis on arrondit à la taille d’instance supérieure. Le bloc suivant fait ce calcul pour DeepSeek en FP8 ; round_up y désigne cet arrondi vers la taille disponible suivante.
# Deciding GPU allocation for DeepSeek
bits_precision = 8 # FP8 quantization
params = 671 # parameters in billions
kv_cache_allocation = 1.8
vram_required = (bits_precision / 8) * params * kv_cache_allocation
# DeepSeek requires about 1200 GB of VRAM with this config
b200_vram_available = [180, 360, 720, 1440]
round_up(vram_required, b200_vram_available)
# Serving DeepSeek in FP8 requires 1440 GB of VRAM (8xB200 GPUs)
Avec 8 bits, 671 milliards de paramètres et un coefficient de 1,8 pour le cache KV, le calcul donne environ 1 200 Go ; on arrondit à la taille d’instance suivante, 1 440 Go, soit huit B200. Même pour des modèles de taille moyenne, on veut souvent plus que le minimum de GPU, pour permettre de plus grands caches KV et une meilleure latence par utilisateur.
Deuxième question : quelle part de la mémoire réserver au cache KV ? Le moteur se règle. Voici l’extrait de configuration TensorRT-LLM qui fixe cette part.
kv_cache_config.free_gpu_memory_fraction = 0.8
# or any value 0.0 < n < 1.0
Ce réglage réserve au cache KV 80 % de la VRAM restante : sur un B200 de 180 Go dont 100 Go servent aux poids du modèle et aux tampons, cela alloue 80 % des 80 Go restants, soit 64 Go. Une fois cette allocation remplie, et elle se remplit vite, il faut supprimer des caches KV enregistrés, ce qui augmente la probabilité d’échec de cache pour les requêtes futures.
Troisième question : comment lancer le serveur ? Avec vLLM, la commande vllm serve active ici le parallélisme d’experts et un parallélisme tensoriel sur 8 GPU, et nomme le modèle ds31 pour les clients.
vllm serve deepseek-ai/DeepSeek-V3.1
  --enable-expert-parallel
  --tensor-parallel-size 8
  --served-model-name ds31
Avec SGLang, la même idée se complète d’un décodage spéculatif EAGLE : on règle le nombre d’étapes spéculatives, le top-k d’EAGLE et le nombre de tokens de brouillon, avec un parallélisme tensoriel sur 8 GPU.
python3 -m sglang.launch_server
  --model-path deepseek-ai/DeepSeek-V3-0324
  --speculative-algorithm EAGLE
  --speculative-num-steps 1
  --speculative-eagle-topk 1
  --speculative-num-draft-tokens 2
  --trust-remote-code
  --tp 8
Avec TensorRT-LLM, la commande trtllm-serve règle en plus la taille maximale de lot, les limites de tokens et de séquence, la part de mémoire GPU réservée au cache KV, et combine parallélisme tensoriel et parallélisme d’experts sur huit GPU.
trtllm-serve deepseek-ai/DeepSeek-R1-0528
  --host 0.0.0.0
  --port 8000
  --backend pytorch
  --max_batch_size 1024
  --max_num_tokens 3200
  --max_seq_len 2048
  --kv_cache_free_gpu_memory_fraction 0.8
  --tp_size 8
  --ep_size 8
  --trust_remote_code
  --extra_llm_api_options ${EXTRA_LLM_API_FILE}
Retiens ce que ces trois commandes ont en commun : chaque option est un levier vu plus haut. Parallélisme tensoriel et d’experts, spéculation, taille de lot, part de VRAM du cache KV : optimiser un moteur, c’est avant tout régler ces paramètres.
Savoir si ça a marché
Optimiser sans mesurer ne mène nulle part. Distingue d’abord le temps d’inférence (le temps passé sur le GPU à générer les tokens) de la mesure de bout en bout, qui inclut latence réseau et file d’attente. Quand l’inférence est rapide mais que le bout en bout est lent, tourne-toi vers l’infrastructure plutôt que vers le modèle.
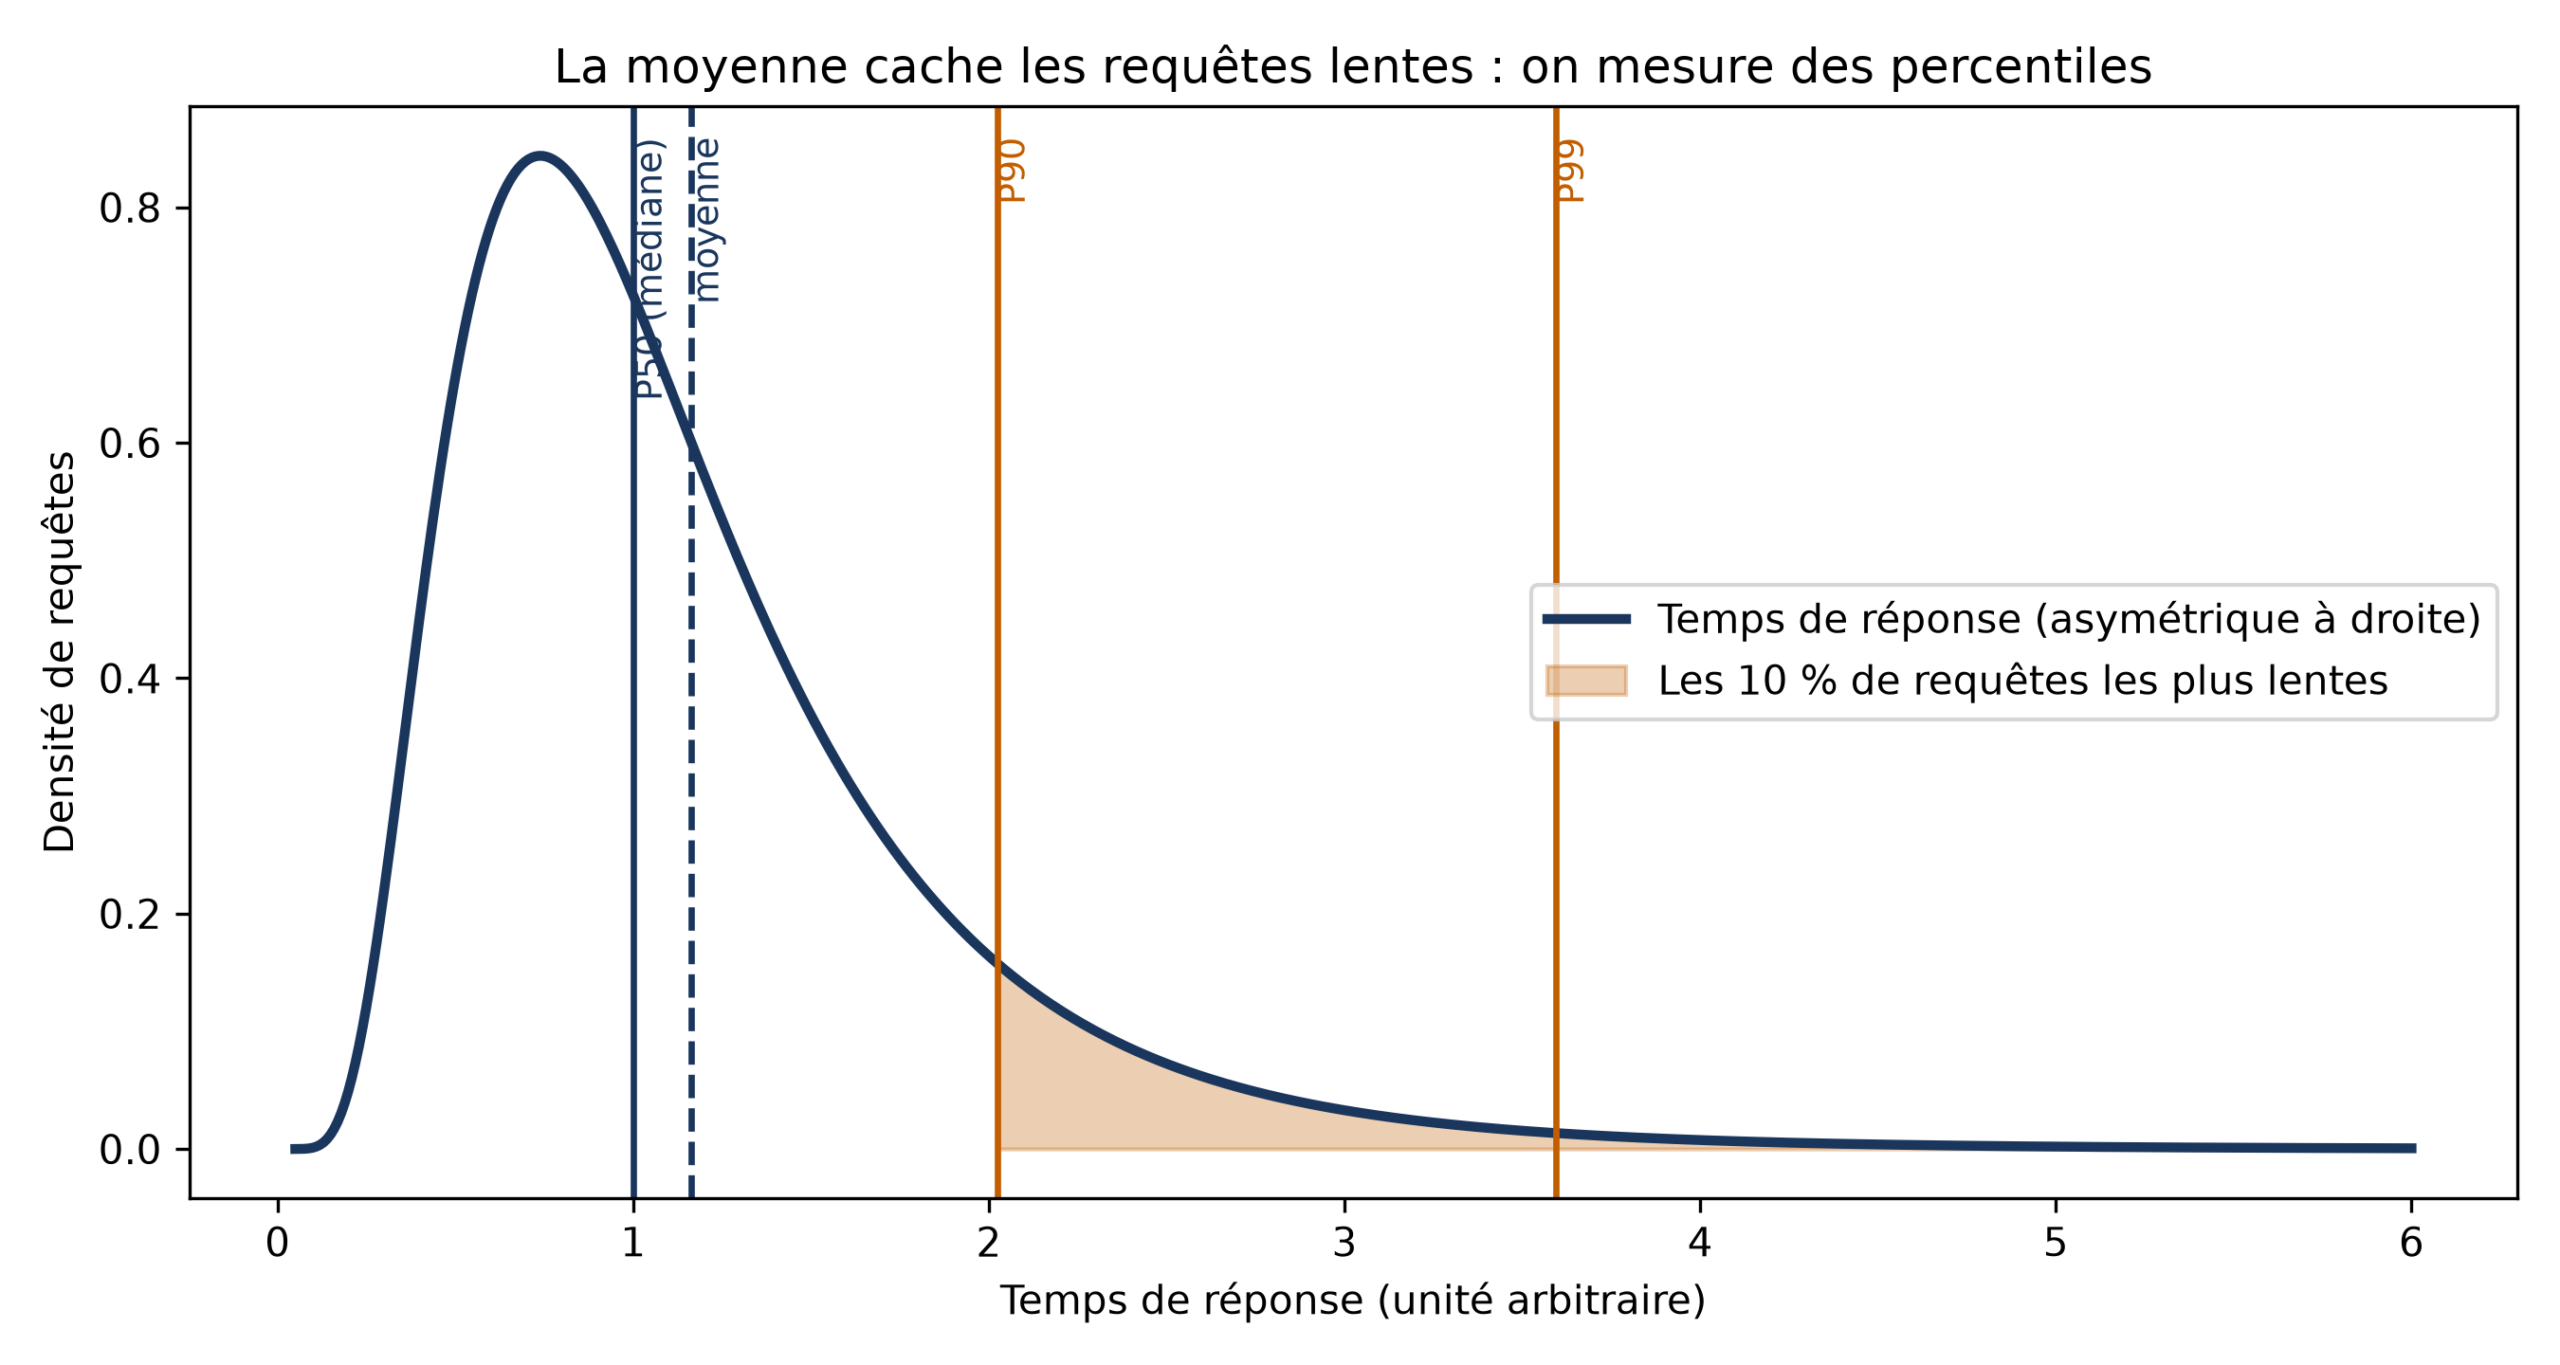
Un bon banc d’essai imite le trafic réel et ne change qu’une variable à la fois ; le profilage explique le pourquoi des chiffres. Pour les modèles d’embedding quantifiés, un contrôle simple compare la similarité cosinus des vecteurs de sortie du modèle d’origine et du modèle quantifié : 100 % signifie des vecteurs identiques, et il faut au moins 99 % pour être en confiance.
Pièges et limites
Les techniques sont parfois symbiotiques, parfois incompatibles. Quantifier le cache KV allège un goulot de la désagrégation, mais augmenter la taille de lot réduit le calcul disponible pour la spéculation. L’objectif est un ensemble équilibré d’optimisations qui vaut plus que la somme de ses parties, et cela demande de l’expérimentation patiente : chez Baseten, un ingénieur a essayé 77 configurations avant de trouver une solution peu évidente qui doublait le TPS pour le modèle d’un client.
⚠️ Piège Plus de contraintes donne une meilleure performance, mais plus de trafic permet plus d’optimisations. Un parallélisme poussé, un routage conscient du KV et une désagrégation dynamique n’ont de sens qu’avec un grand nombre de GPU. À faible trafic, ces outils ajoutent de la complexité sans rapporter.
Quelques autres limites à garder en tête :
- Réduire la latence par la spéculation impose de réduire les tailles de lot, ce qui abaisse le débit et augmente le coût.
- Le cache de préfixe et la désagrégation ne servent à rien pour un modèle d’embedding, qui traite ses tokens en parallèle.
- Les moteurs compilés ciblent un GPU précis : pour exécuter un modèle sur un B200, il faut compiler sur un B200. Un noyau choisi à la main peut aussi perdre sa compatibilité en changeant de GPU.
Surtout, aucun réglage ne remplace le choix du modèle : à matériel, exécution et architecture égaux, un modèle plus petit est plus rapide et moins cher. C’est la décision la plus importante, avant le moteur ou l’algorithme de spéculation.
Aller plus loin
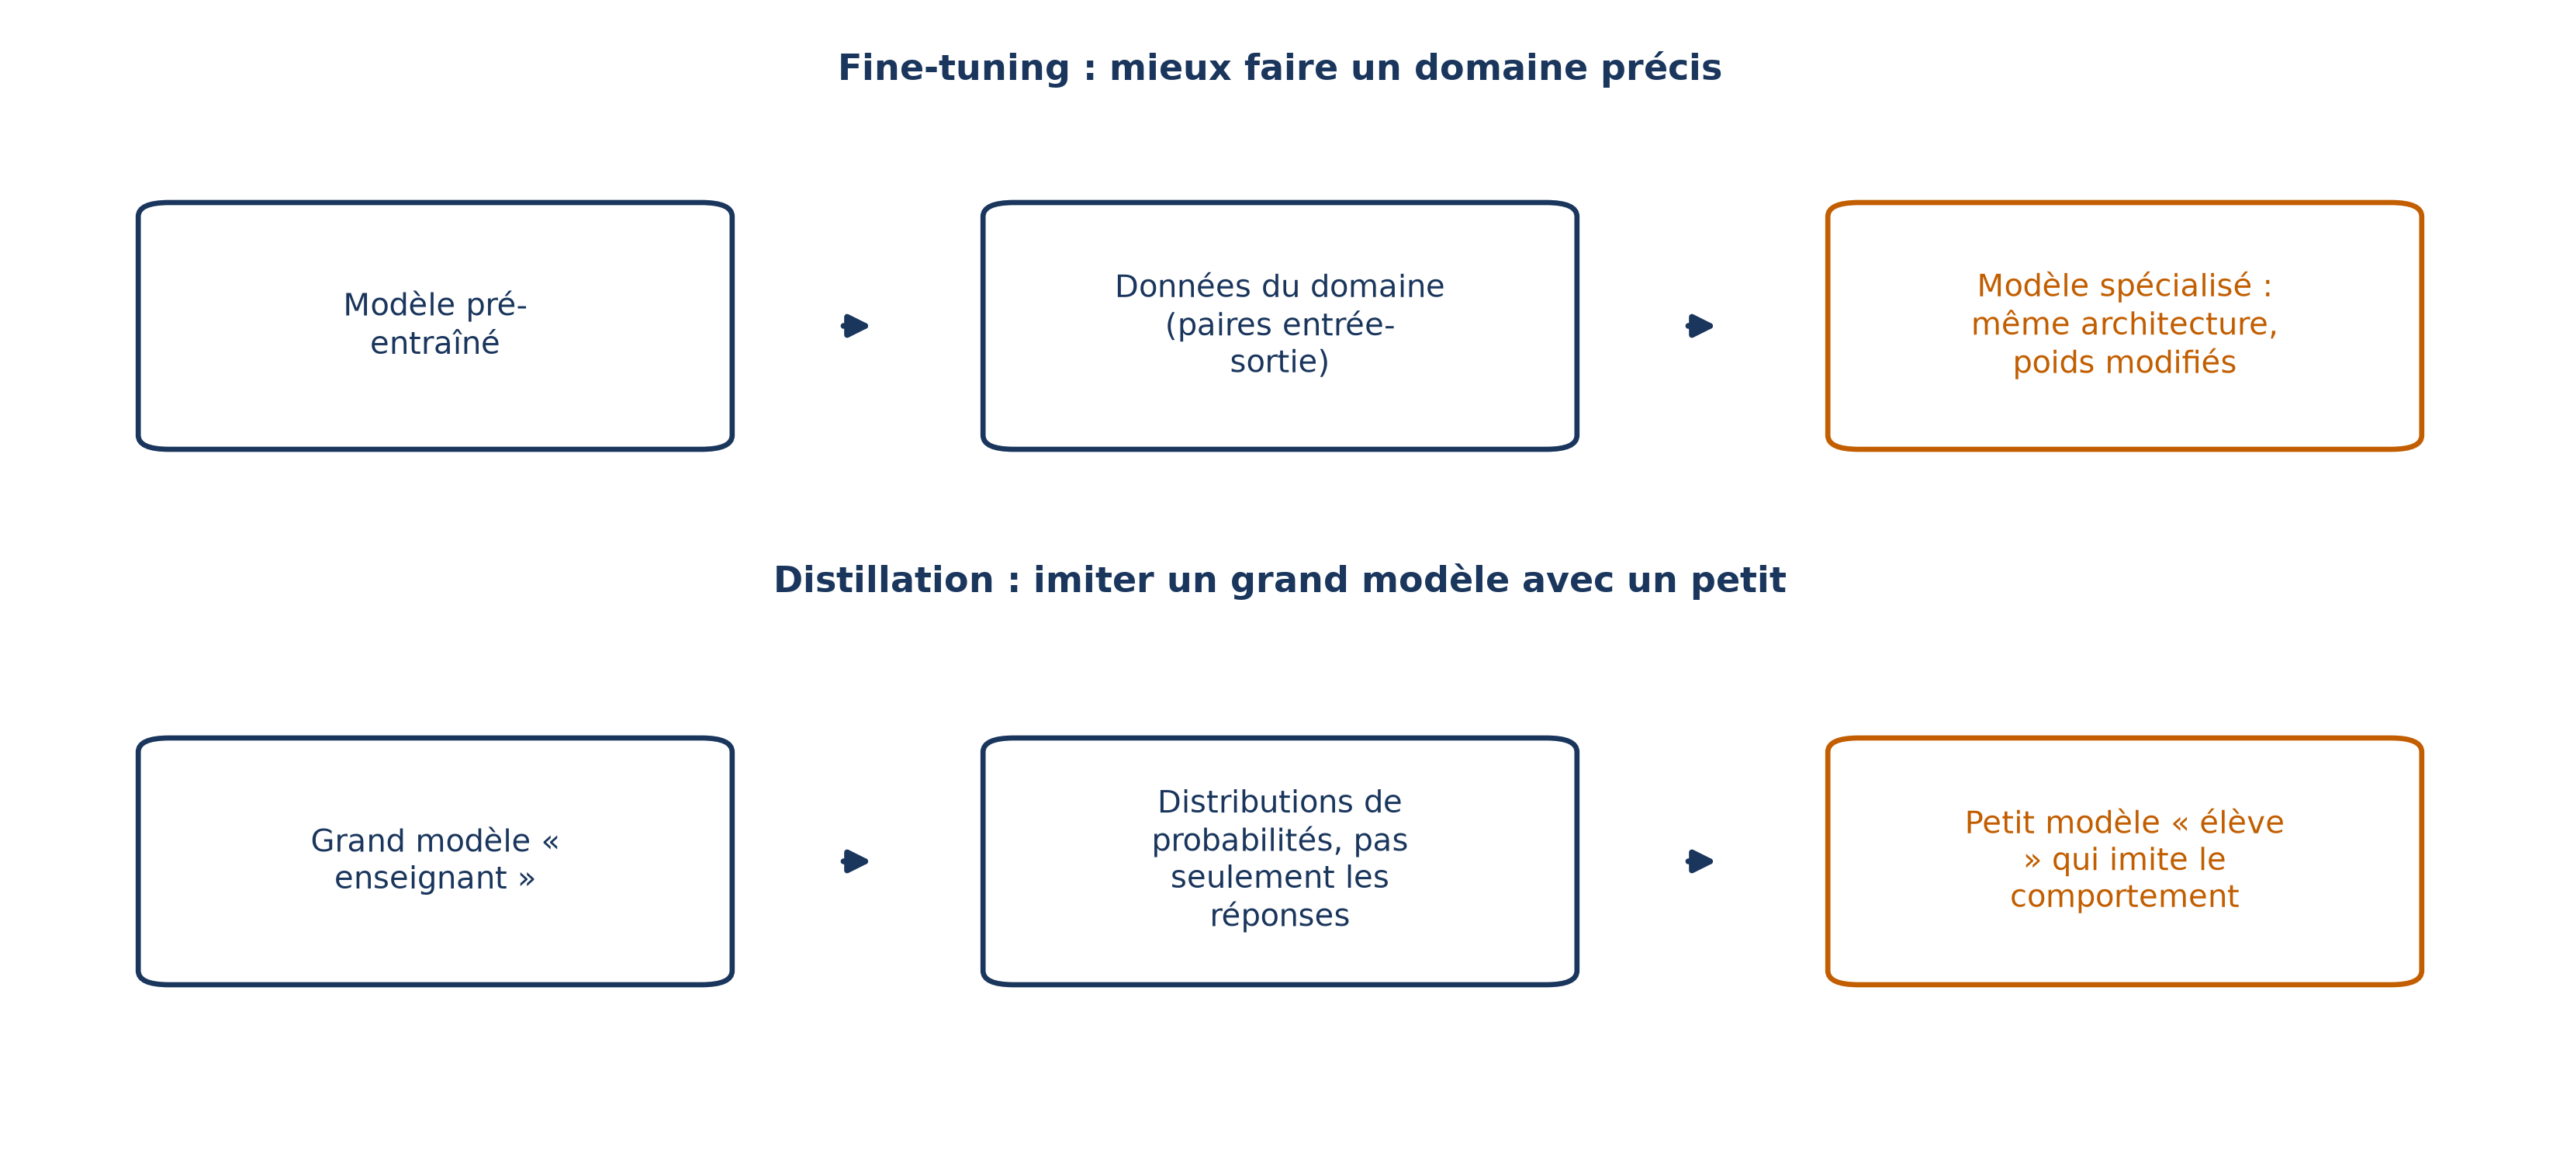
- Distillation : un grand modèle « enseignant » entraîne un petit « élève » à imiter son comportement. À la différence d’un affinage sur des données synthétiques, l’élève voit les distributions de probabilités de l’enseignant, pas seulement ses réponses.
- Mise à l’échelle automatique : quand une instance, même optimisée, reçoit plus de trafic qu’elle ne peut traiter, c’est un problème d’infrastructure. On ajuste le nombre de réplicas selon l’utilisation ou selon le trafic, et l’on utilise les deux ensemble.
- Démarrage à froid : le temps pour lancer un réplica dépend de l’obtention du GPU, du chargement de l’image et des poids, et du démarrage du moteur. Des poids quantifiés se chargent plus vite.
Deux pistes plus larges :
- NVIDIA Dynamo : l’orchestrateur distribué qui fédère routage KV, désagrégation et multi-nœuds au-dessus des moteurs.
- Autres modalités : les mêmes techniques s’appliquent aux modèles vision-langage, d’embedding ou de parole ; pour la génération d’images et de vidéos, l’attention, qui représente 70 à 80 % du temps de calcul en vidéo, devient le premier poste à optimiser.
Questions fréquentes
Quelle technique essayer en premier ?
Regarde d’abord où se trouve ton goulot. Pour un modèle qui ne tient pas sur un GPU, le parallélisme tensoriel est la stratégie par défaut ; pour des requêtes qui répètent de longs préfixes, le cache de préfixe ; pour réduire la latence à faible trafic, la spéculation.
La quantification dégrade-t-elle toujours la qualité ?
Non, mais elle peut l’abîmer si elle est mal faite. Plus un modèle a de paramètres, moins il y est sensible, et les poids sont le composant le moins risqué à quantifier. Valide toujours par la perplexité, un banc d’essai et une évaluation propre à ton usage.
Le décodage spéculatif change-t-il les réponses du modèle ?
Non : le modèle cible valide les tokens de brouillon et ne garde que ceux qui coïncident avec ce qu’il aurait généré. La spéculation et le cache accélèrent le modèle sans changer ce qu’il produit.
Vaut-il mieux vLLM, SGLang ou TensorRT-LLM ?
Cela dépend du déploiement : vLLM et SGLang sont plus faciles à adopter, TensorRT-LLM atteint généralement la meilleure performance sur NVIDIA au prix d’un travail d’ingénierie accru. Un ingénieur doit connaître les trois et choisir déploiement par déploiement.
À retenir
- Prefill et decode ont des goulots opposés : identifie la phase avant d’optimiser.
- Lire moins d’octets (quantification, fusion de noyaux, FlashAttention) et produire plus de tokens par lecture (batching, spéculation) sont les deux grandes manières de desserrer le decode.
- Le cache KV est précieux : réutilise-le entre requêtes, déporte-le sur des mémoires plus lentes, route le trafic selon lui.
- Au-delà d’un GPU, la communication décide de tout : TP dans un nœud, EP pour le débit, désagrégation quand prefill et decode se gênent.
- Mesure en percentiles, change une variable à la fois : un bon réglage est le fruit d’expériences plus que d’une recette.