Un agent reçoit une mission banale : trouver un paquet de chips sans produits laitiers, variété pomme, à moins de 30 dollars. Il cherche, clique, relit, cherche encore, échoue — puis écrit une réflexion sur son échec et repart de zéro. À chaque tour de cette boucle, quelqu’un paie. Voici comment garder un agent capable sans laisser la facture de tokens lui échapper.
L’essentiel en 30 secondes
- Un modèle est facturé au nombre de jetons (tokens) qu’il lit et qu’il écrit : une boucle qui tourne « autant que nécessaire » n’a donc aucun plafond de dépense naturel.
- Le premier réflexe d’économie consiste à ne pas ouvrir de boucle quand un réflexe ou un flux fixe suffit, puis à donner à chaque boucle restante une condition de sortie.
- La réflexion et le contexte se gardent courts : peu de souvenirs réinjectés, un historique résumé ou glissant, un budget de jetons par appel.
- La recherche se déclenche à la demande et ramène peu de documents, au lieu de tourner à chaque tour.
- Le modèle se choisit à la tâche : les gros pour planifier, les petits pour exécuter.
L’intuition : une boucle, c’est un compteur qui tourne
Un modèle de langage ne se facture pas à la durée mais à la quantité de texte : les éditeurs comptent séparément les jetons d’entrée et les jetons de sortie. Une réponse unique coûte donc une fois ce prix. Un agent, lui, enchaîne les appels.
La boucle ReAct est l’exemple type : le modèle produit une pensée, choisit et invoque un outil, observe le résultat, puis recommence « autant que nécessaire ». Son avantage est la souplesse et la transparence d’une chaîne de pensée lisible ; son prix est une hausse des coûts d’API et du temps de réponse.
Le piège tient à ce que chaque tour relit ce qui précède. Les résultats d’outils sont intégrés dans l’invite pour nourrir le cycle de raisonnement suivant, et dans les exemples de code d’agents à outils, le second appel au modèle reçoit de nouveau toute la conversation augmentée du résultat de l’outil. Plus l’agent travaille, plus chaque appel embarque de texte.
💡 Intuition Le coût d’une boucle dépend de trois choses : le nombre de tours, la taille de ce qu’on relit à chaque tour, et le prix du jeton. Les six leviers qui suivent s’attaquent chacun à l’un des trois.
Levier 1 : ne pas ouvrir de boucle quand un réflexe suffit
Avant d’optimiser un agent, demande-toi s’il en faut un. Si les entrées sont prévisibles et chaque sortie descriptible à l’avance, quelques lignes de code procédural sont plus rapides, moins chères et bien plus faciles à tester qu’un modèle. Pour quelques branches connues, un moteur de workflow offre un meilleur contrôle des erreurs qu’un modèle de langage.
Entre les deux, les agents réflexes associent directement entrée et action, sans trace de raisonnement : latence minimale, performances prévisibles, idéal pour un routage par mots-clés ou une recherche en une étape. Les agents à boucle, eux, sont puissants mais exigeants en calcul et en efforts d’ingénierie pour les surveiller et les régler.
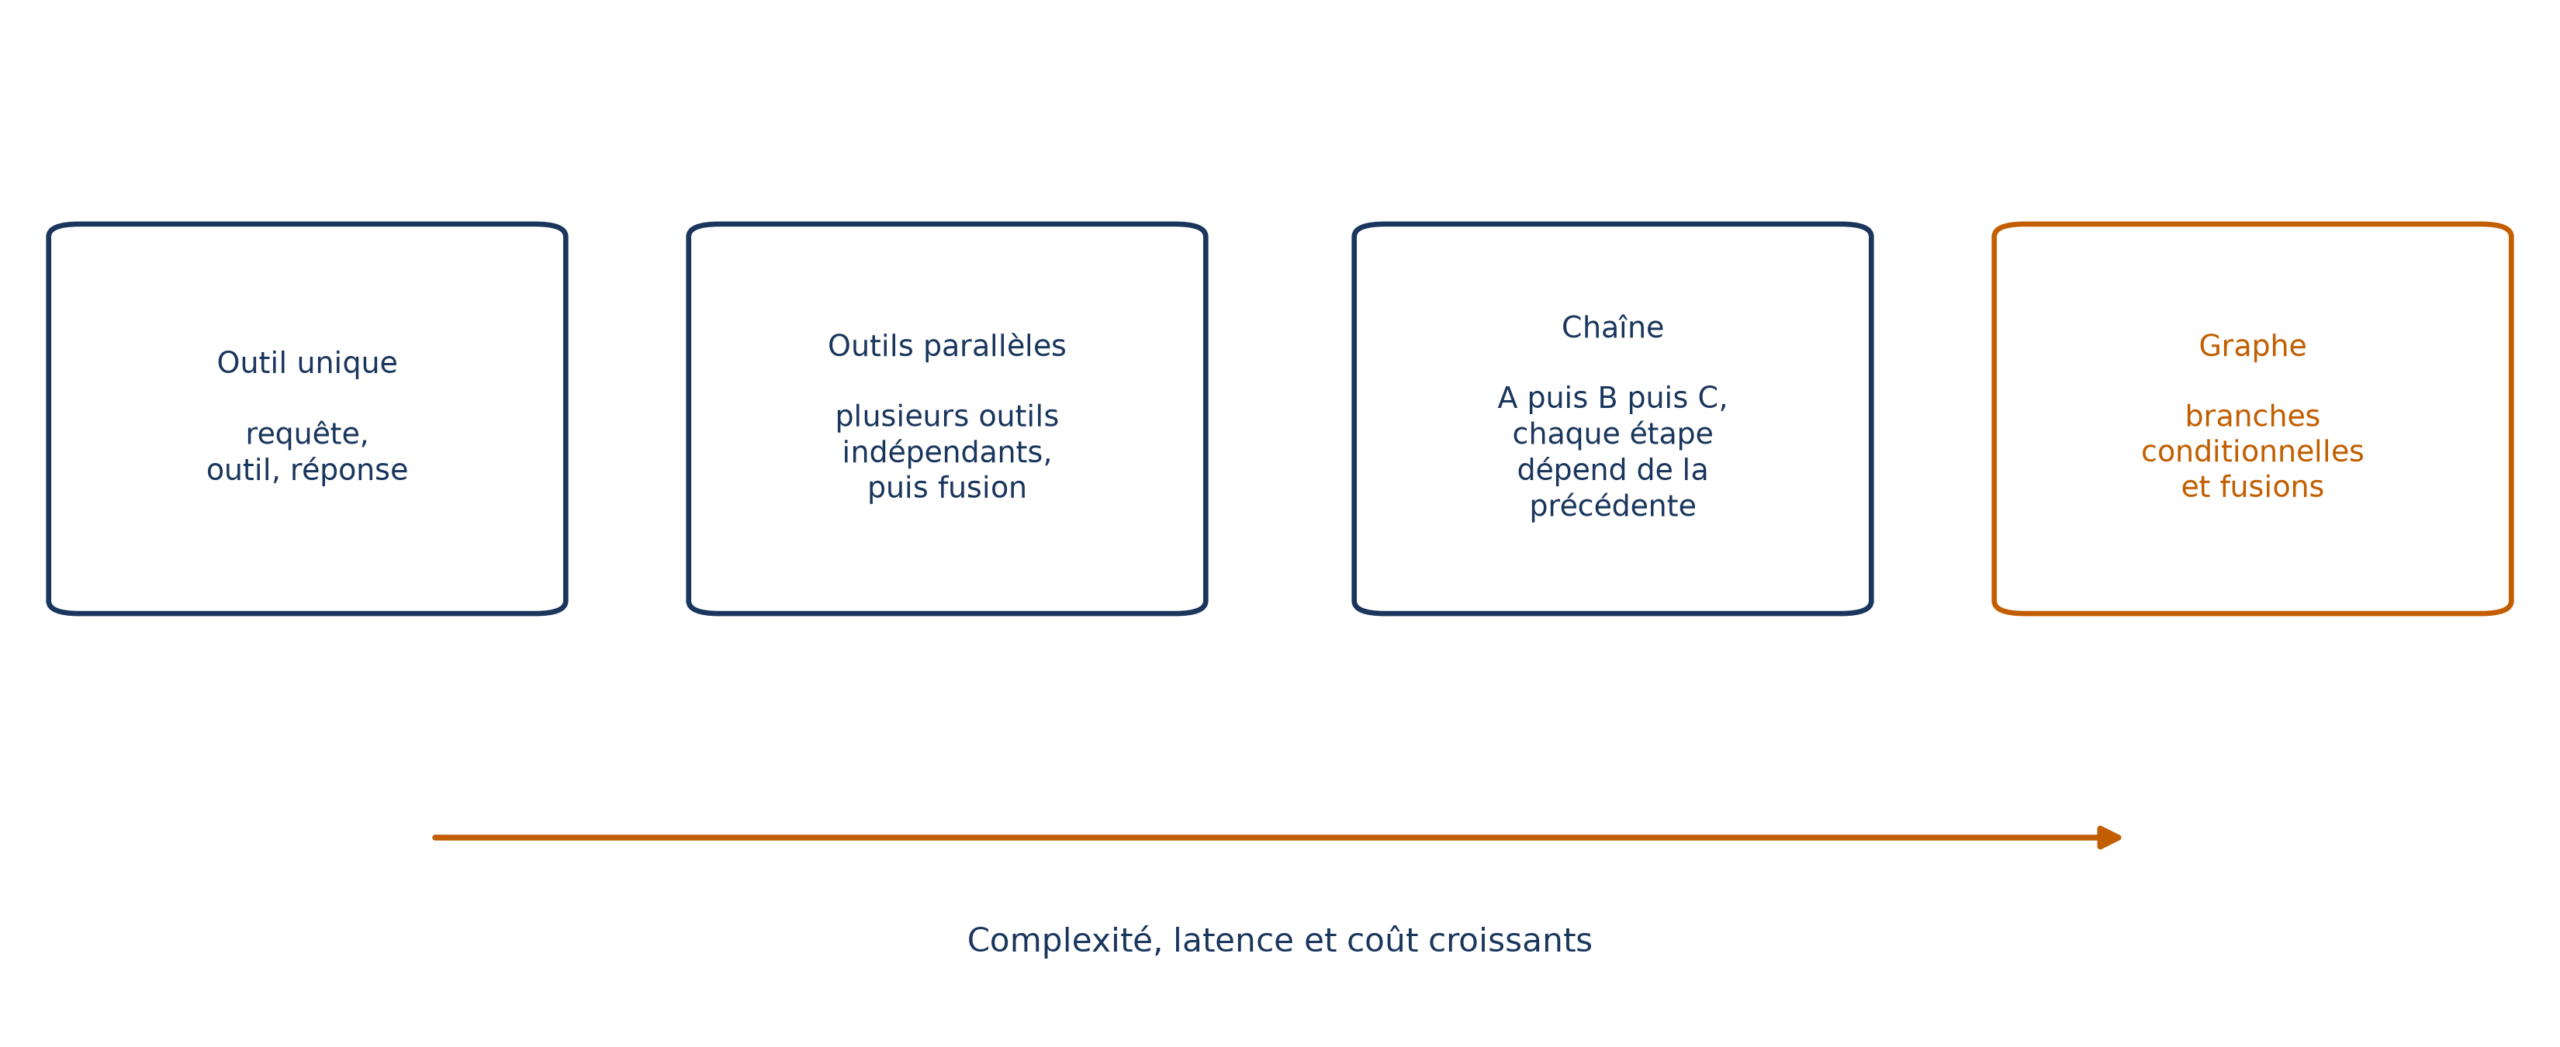
Le nombre d’agents compte aussi : chaque agent supplémentaire ajoute de la communication, de la coordination et des besoins en ressources. Commence par un seul agent, qui invoque des outils jusqu’à une limite avant de répondre.
Même le choix d’un outil peut coûter : la sélection « standard » demande un appel supplémentaire à un modèle de fondation. Avant de multiplier les agents face à un grand catalogue, on regroupe les outils (sélection hiérarchique) ou on choisit l’outil par recherche sémantique dans une base vectorielle.
Levier 2 : donner une sortie à chaque boucle
Une boucle sans condition de sortie est un robinet ouvert. Les consignes de conception vont toutes dans le même sens : appeler des outils jusqu’à une limite avant de répondre, plafonner la profondeur et la ramification des plans, et prévoir un critère de sortie.
Ce dernier point mérite un exemple. Une critique de réponse est une fonction bloquante : si la réponse est incorrecte ou incomplète, elle génère une nouvelle question et relance un tour de récupération. Mais la bonne réponse peut simplement ne pas exister dans les données ; la critique doit alors pouvoir le signaler à l’utilisateur plutôt que de boucler indéfiniment.
La boucle acteur-critique illustre bien le risque. L’acteur produit des plans candidats, le critique les note, et on recommence tant que le seuil n’est pas atteint. L’approche est une forme de calcul au moment du test : elle coûte plus cher, en échange de résultats souvent nettement meilleurs, et elle vaut surtout quand on dispose d’une grille d’évaluation claire et que le surcoût reste acceptable.
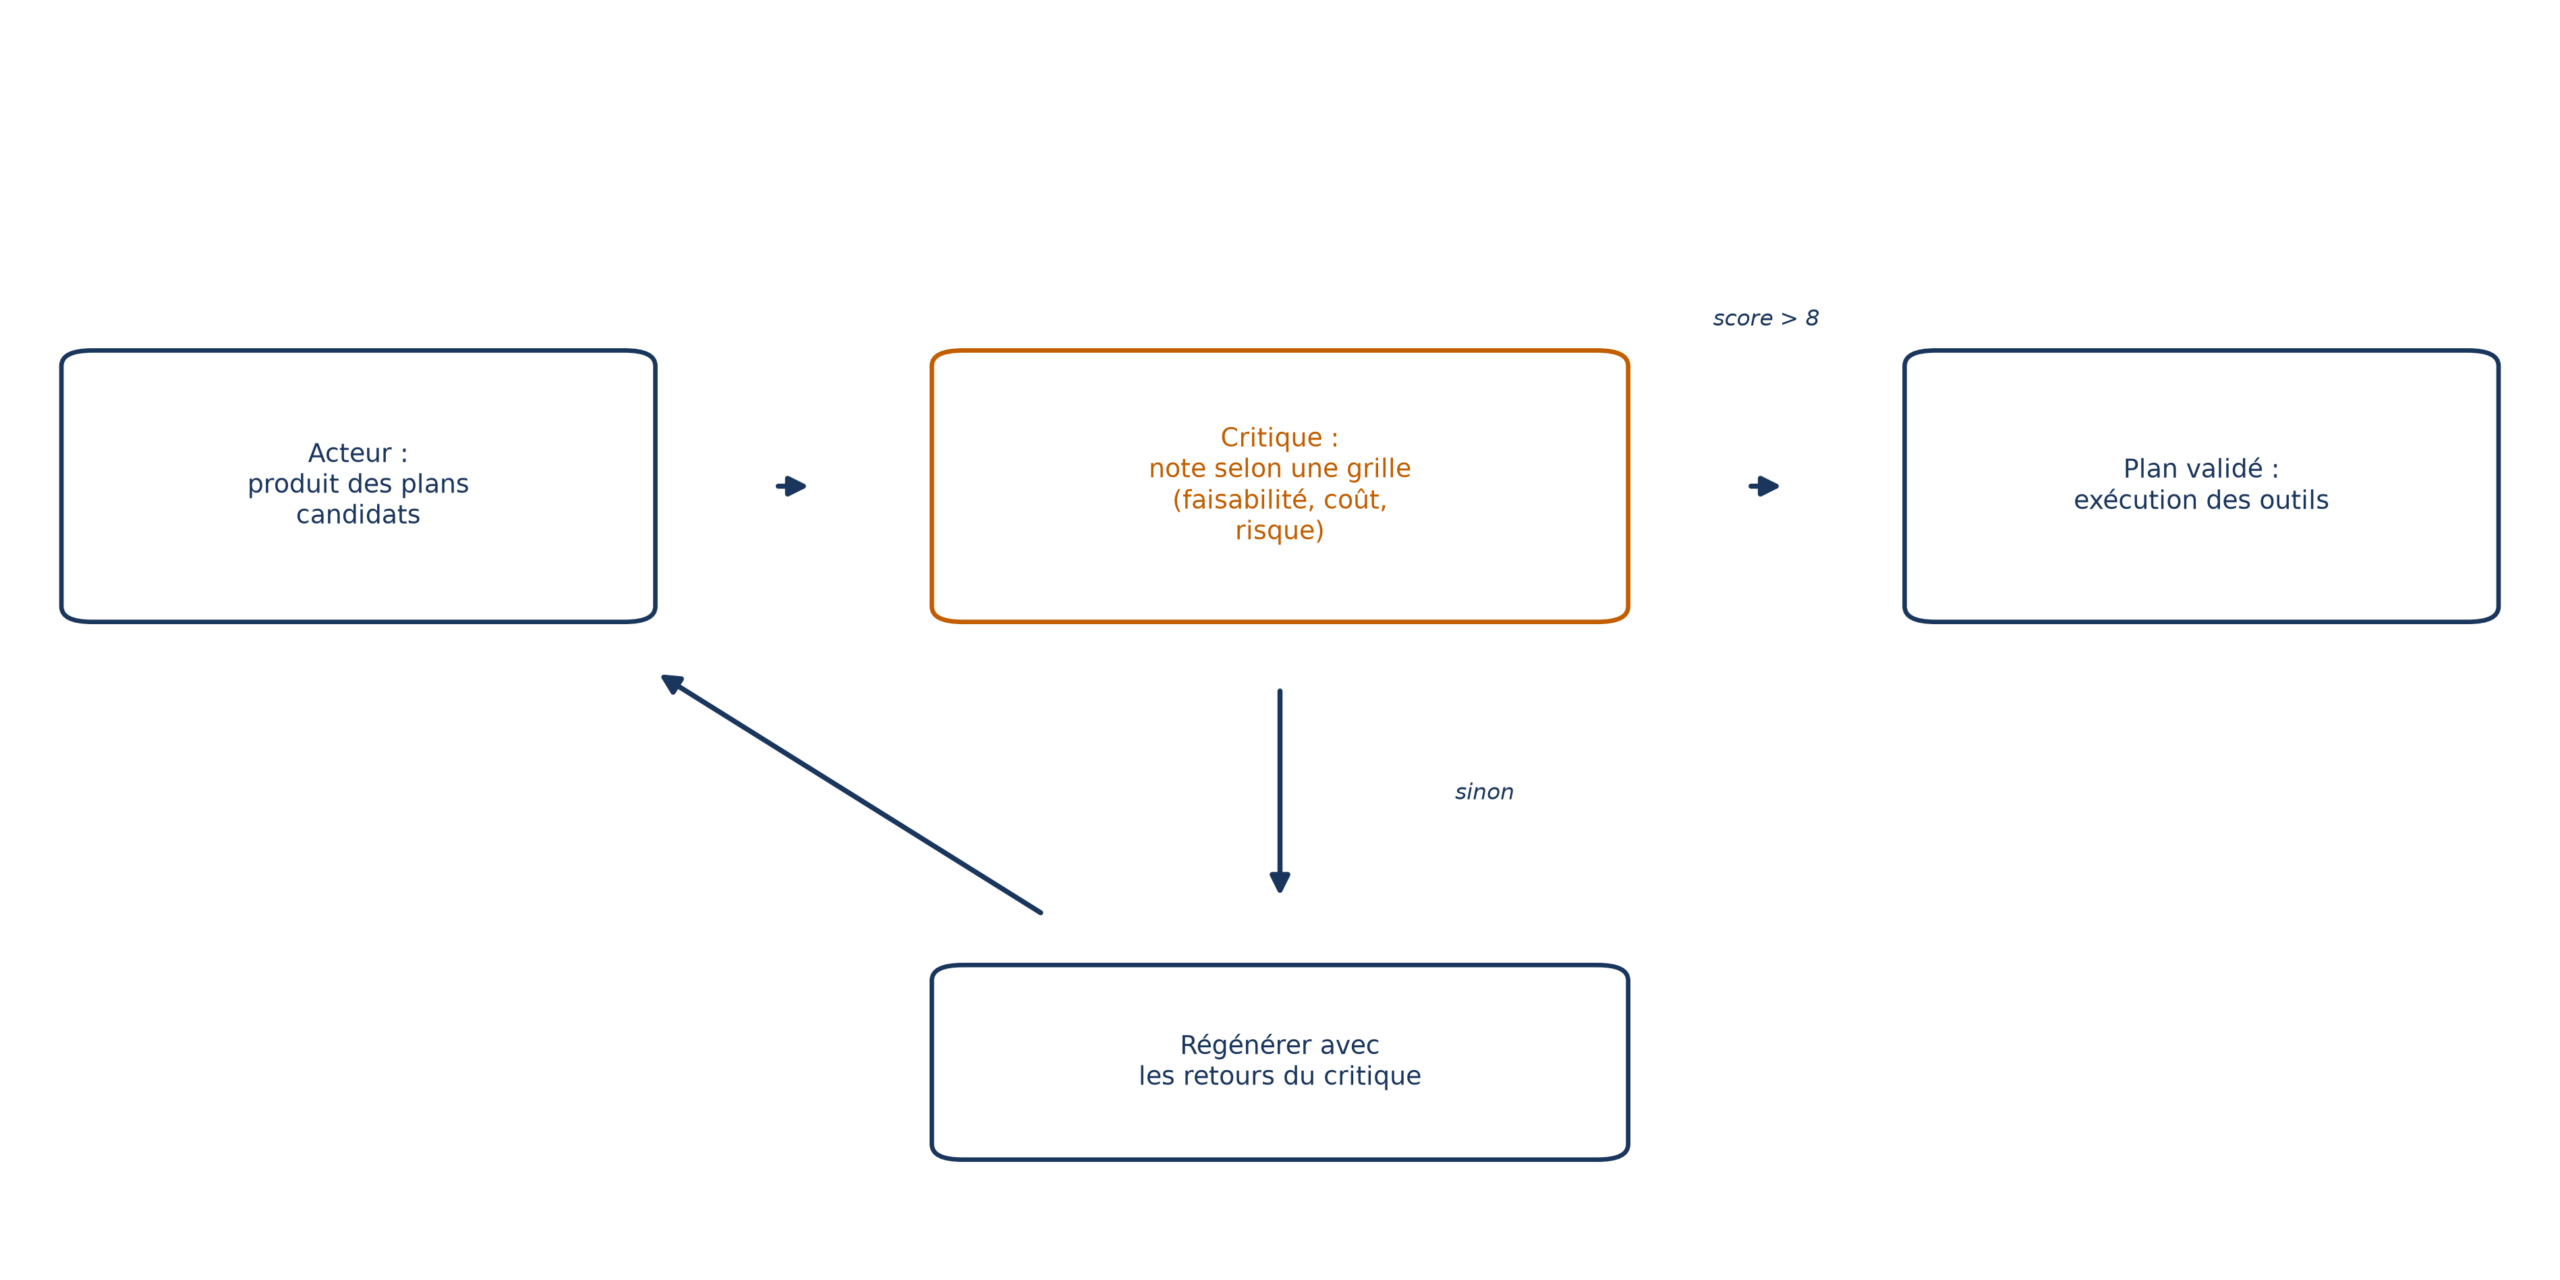
actor_node et critic_node sont les deux fonctions qui appellent le modèle (l’une génère trois plans candidats à chaque passage, l’autre les note), et AgentState est l’état partagé que le graphe se transmet. Un seul arc renvoie vers l’acteur, décidé par le critique.def construct_actor_critic_graph():
g = StateGraph(AgentState)
g.add_node("actor", actor_node)
g.add_node("critic", critic_node)
g.set_entry_point("actor")
g.add_edge("actor", "critic")
# Loop back if not approved (conditional)
g.add_conditional_edges("critic", lambda s: "actor"
if "regenerate" in s["messages"][-1].content.lower() else
END)
return g.compile()
Lis la ligne add_conditional_edges : tant que le message du critique contient « regenerate », le graphe retourne à l’acteur, et rien d’autre dans cette fonction ne compte les tours. Un plafond de tours, ajouté ici, transforme une boucle potentiellement infinie en dépense bornée.
📌 À retenir Une boucle bien conçue a deux sorties : le succès (seuil atteint) et l’aveu (« je n’ai rien trouvé »). Sans la seconde, l’agent peut dépenser sans fin pour une réponse qui n’existe pas.
Levier 3 : garder la réflexion courte
Revenons à notre agent des chips. Après un échec, la technique Reflexion lui fait écrire une brève réflexion sur ce qui n’a pas marché ; ces réflexions s’accumulent dans une mémoire et sont relues avant la tentative suivante, sans jamais réentraîner le modèle.
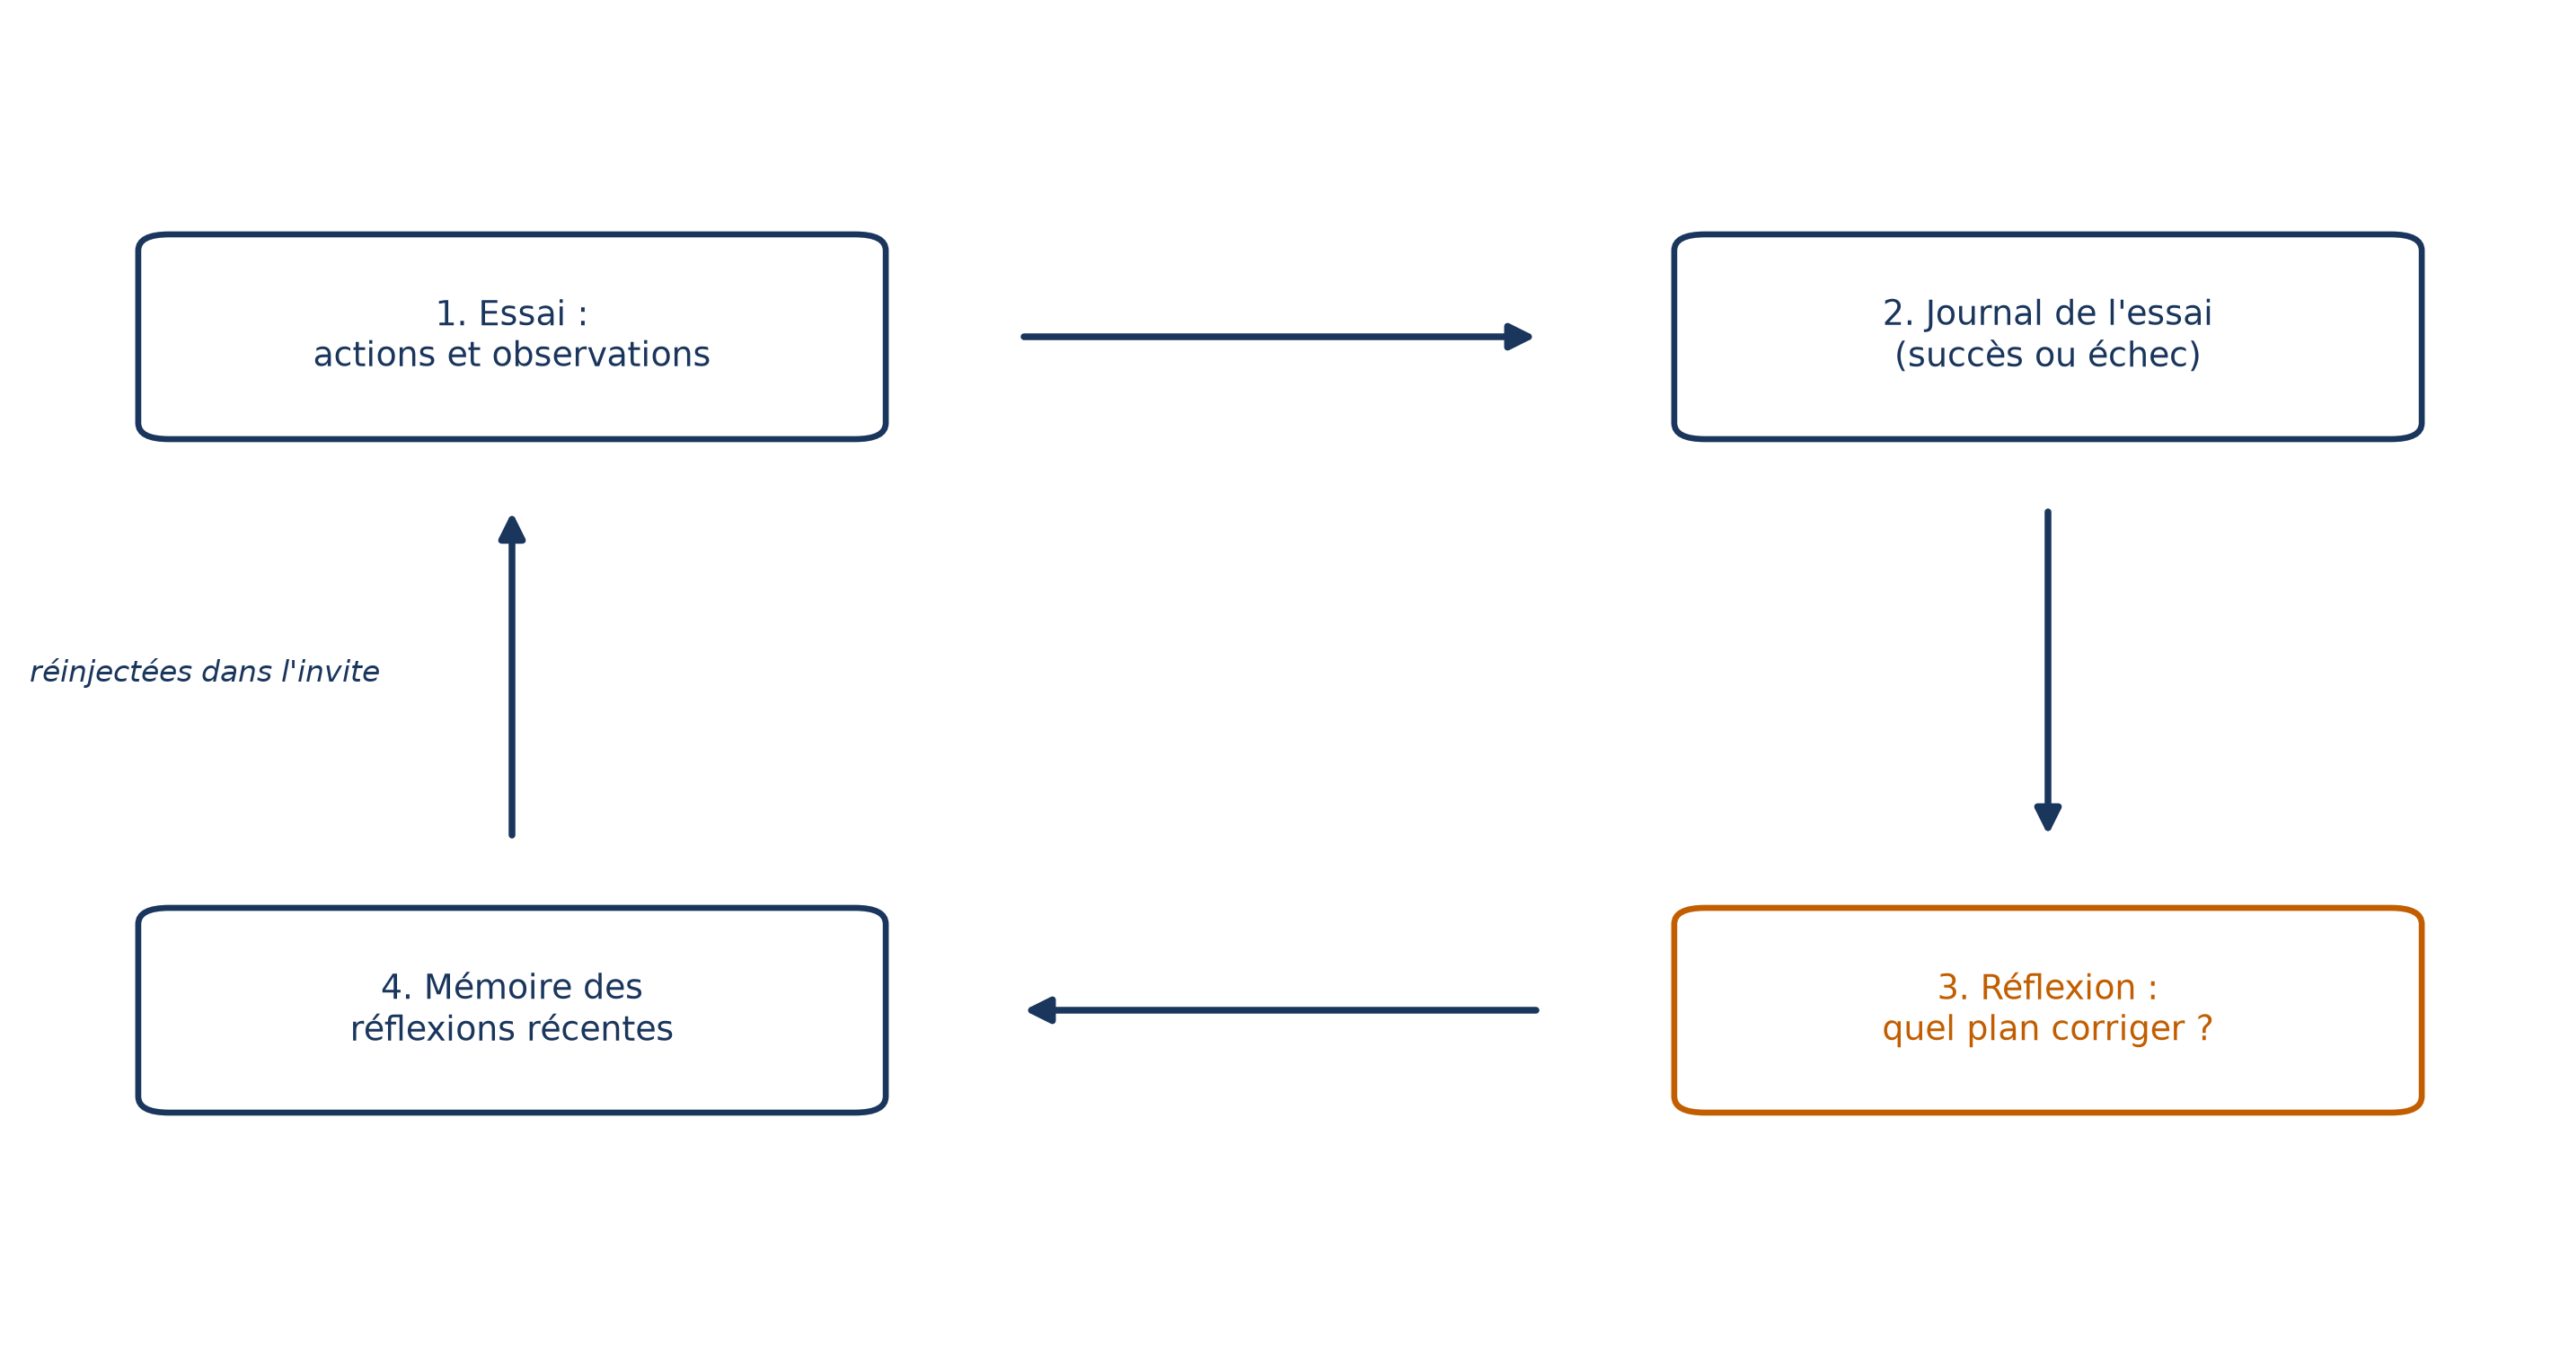
Le code de l’exemple montre deux garde-fous de coût. Commence par lire, avant les fonctions, ce qu’elles font : get_completion envoie un prompt au modèle (llm, configuré en amont), _generate_reflection_query assemble l’historique des réflexions et le journal de l’essai, et update_memory lit le fichier de journaux d’essais (full_log, découpé en un journal par environnement dans env_logs) puis ajoute une réflexion à chaque environnement en échec.
def get_completion(prompt: str) -> str:
    # Wraps our `call_model` helper for one-off text completions

    result = llm.invoke([{"role":"user","content":prompt}])
    return result[0].content

def _generate_reflection_query(trial_log: str, recent_reflections: List[str]):
    history = "\n\n".join(recent_reflections)
    return f'''{history}
        {trial_log}
        Based on the above, what plan would you follow next? Plan:'''

def update_memory(trial_log_path: str, env_configs: List[Dict[str, Any]]):
    """Updates the given env_config with the appropriate reflections."""
    with open(trial_log_path, 'r') as f:
        full_log: str = f.read()

    env_logs: List[str] = full_log.split('#####\n\n#####')
    assert len(env_logs) == len(env_configs), print(f'bad: {env_logs}')
    for i, env in enumerate(env_configs):
        # if unsolved, get reflection and update env config
        if not env['is_success'] and not env['skip']:
            if len(env['memory']) > 3:
                memory: List[str] = env['memory'][-3:]
            else:
                memory: List[str] = env['memory']
            reflection_query = _generate_reflection_query(env_logs[i], memory)
            reflection = get_completion(reflection_query)
            env_configs[i]['memory'] += [reflection]
Deux lignes travaillent pour ta facture. La condition if not env['is_success'] and not env['skip'] ne déclenche une réflexion que pour un échec non ignoré. Et env['memory'][-3:] ne réinjecte que les trois dernières réflexions, donc la part « historique » du prompt de réflexion ne grandit pas avec le nombre d’essais.
La réflexion systématique, elle, a un prix assumé : le métaraisonnement ajoute latence et calcul. On le réserve aux flux à fort enjeu, où une erreur précoce peut se propager en échec coûteux (transactions financières, diagnostic médical, incident critique).
Levier 4 : tenir le contexte dans un budget
Tout ce que l’agent relit à chaque tour forme son contexte. L’ingénierie de contexte consiste à assembler dynamiquement messages de l’utilisateur, connaissances récupérées, état du flux et invite système en une fenêtre structurée et économe en jetons. Il s’agit de décider quoi inclure, comment le structurer et comment le faire tenir dans les limites de jetons.
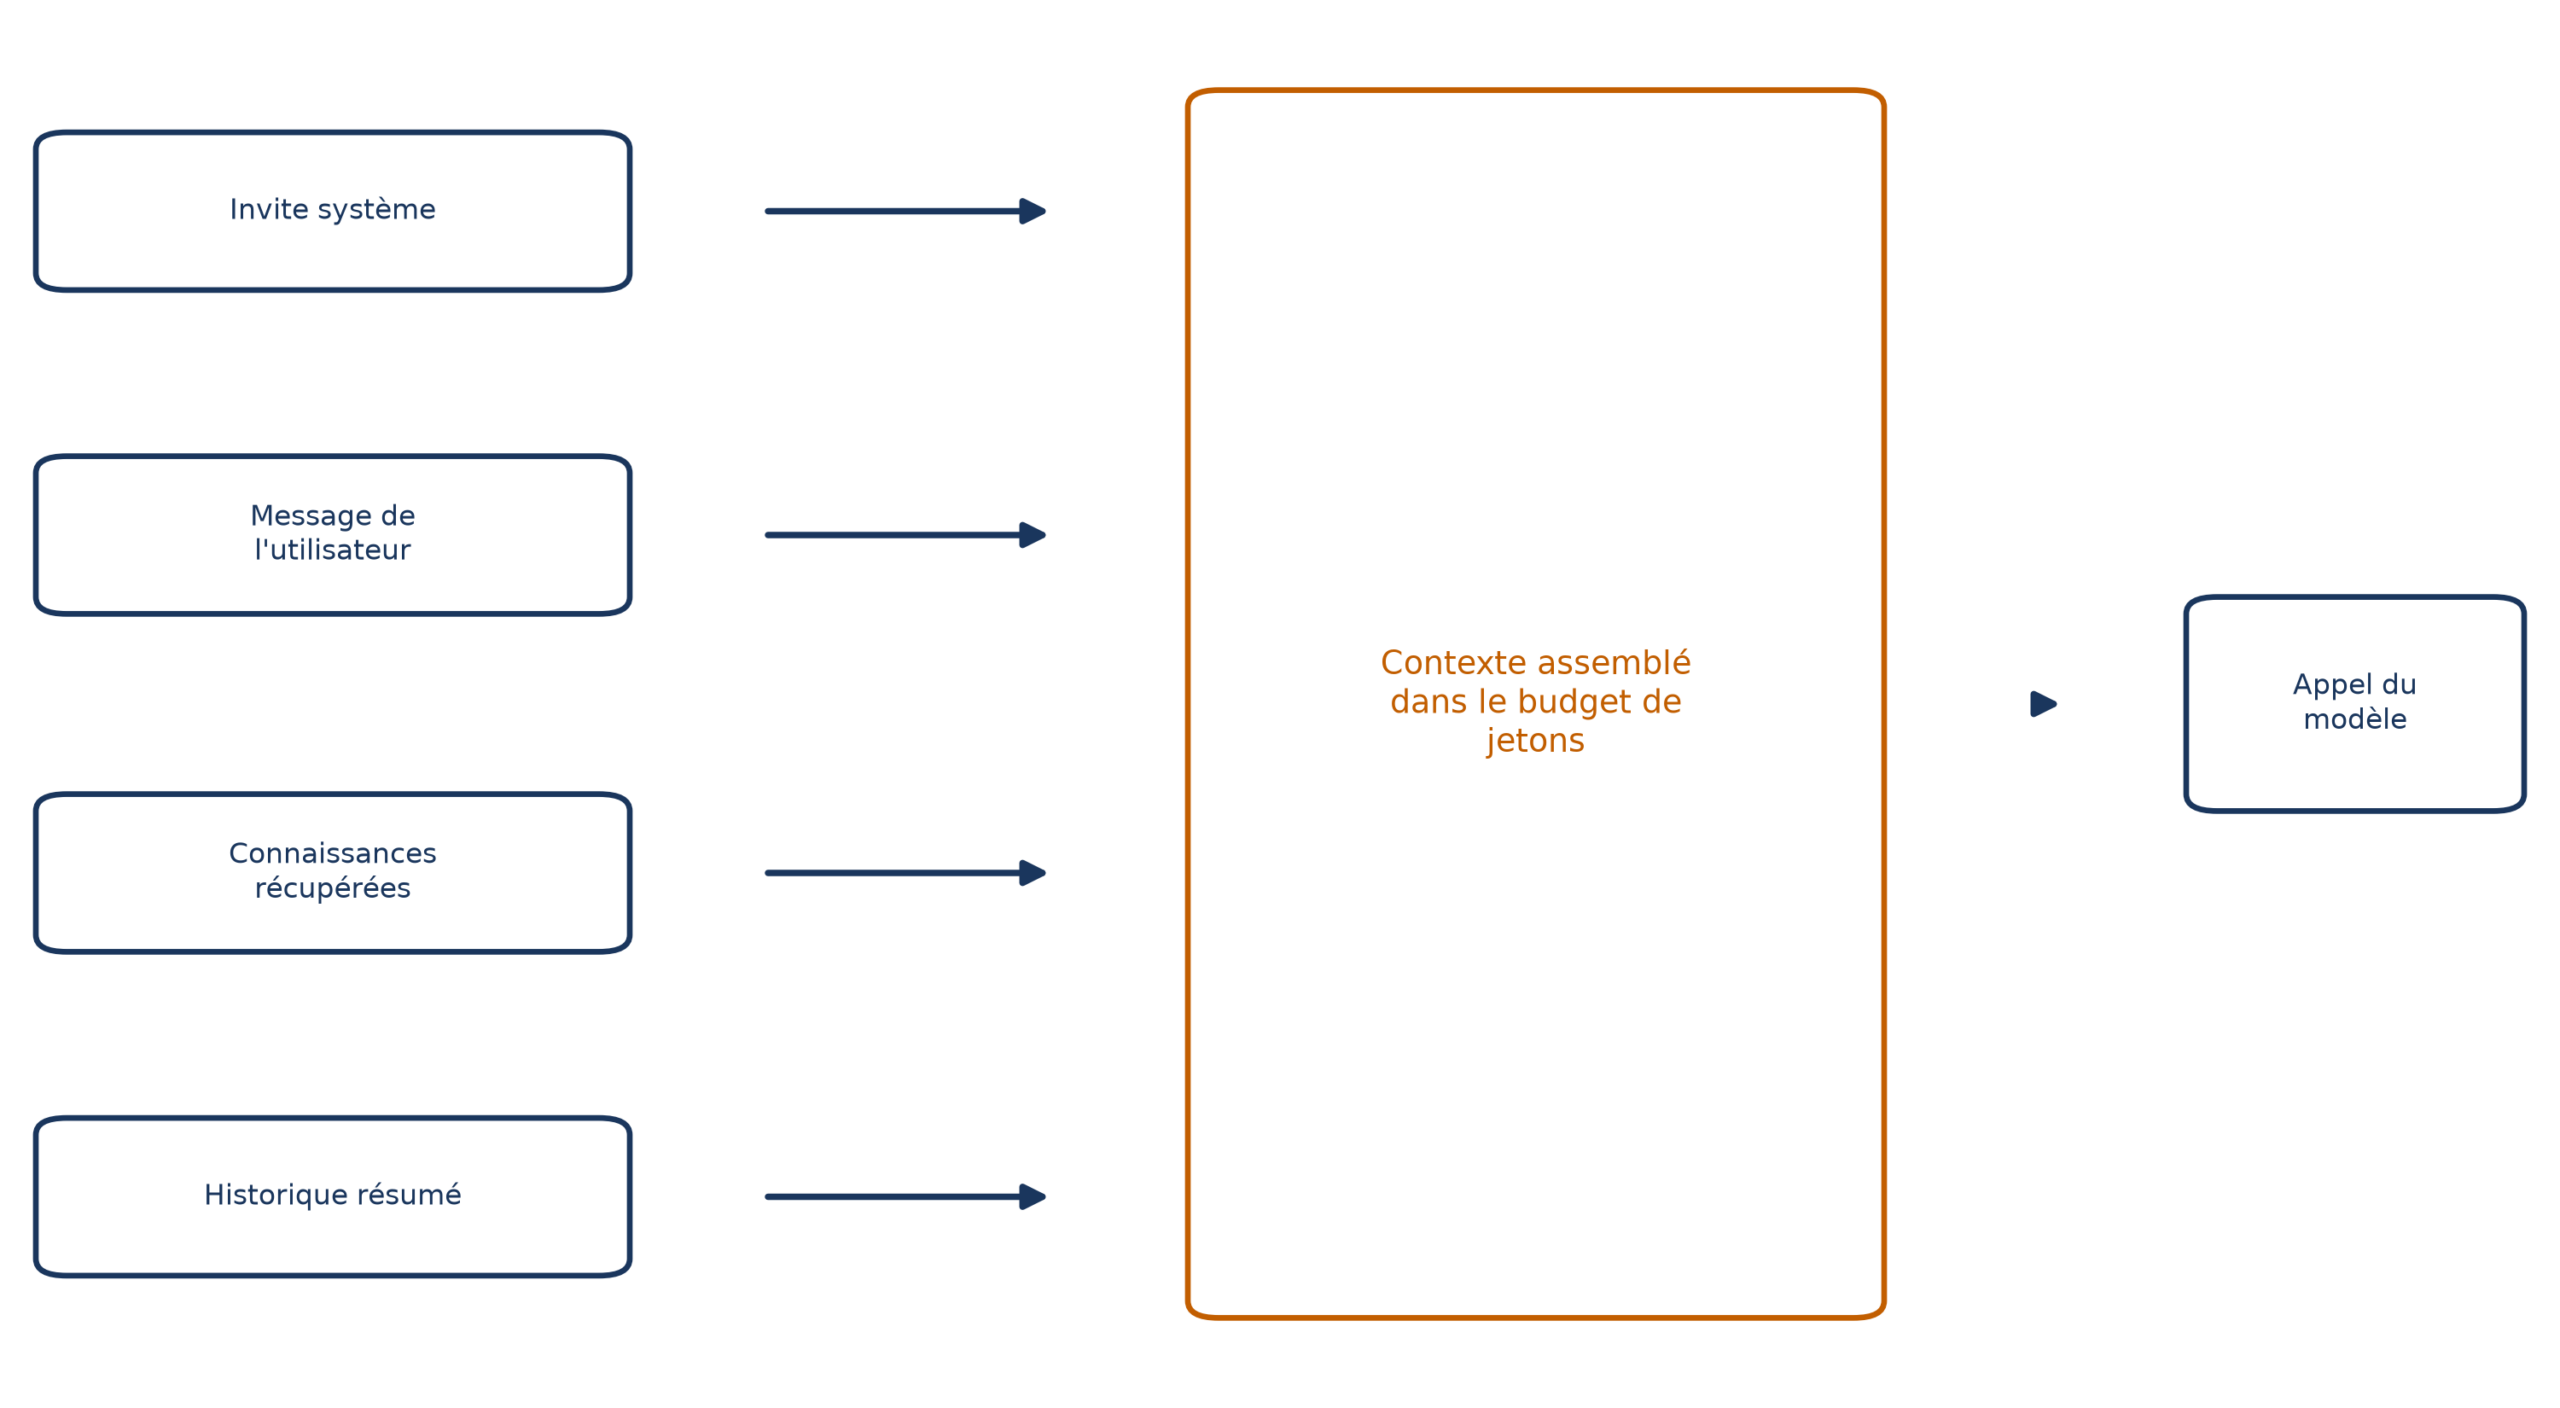
Trois techniques donnent du contrôle. La fenêtre glissante garde les informations récentes et écarte les plus anciennes. La compression supprime les tokens peu importants, via un modèle, ce qui réduit le coût et le risque de dépasser la fenêtre. Et on peut retirer ou compresser les détails périmés, ou récupérer en mémoire vectorielle seulement ce qui est pertinent.
Un grand contexte n’est pas une excuse pour tout y mettre. Même les modèles à grande fenêtre (jusqu’à 200 000 tokens pour Claude 3) perdent en précision quand l’information utile se trouve au milieu d’un long prompt : c’est le problème du « perdu au milieu ». Ne transmettre que l’information pertinente limite ce risque.
Levier 5 : chercher à la demande, et peu
Une recherche documentaire à chaque tour est une dépense silencieuse. Un système standard interroge une base unique pour toute requête et la parcourt entièrement, même quand seule une fraction est pertinente.
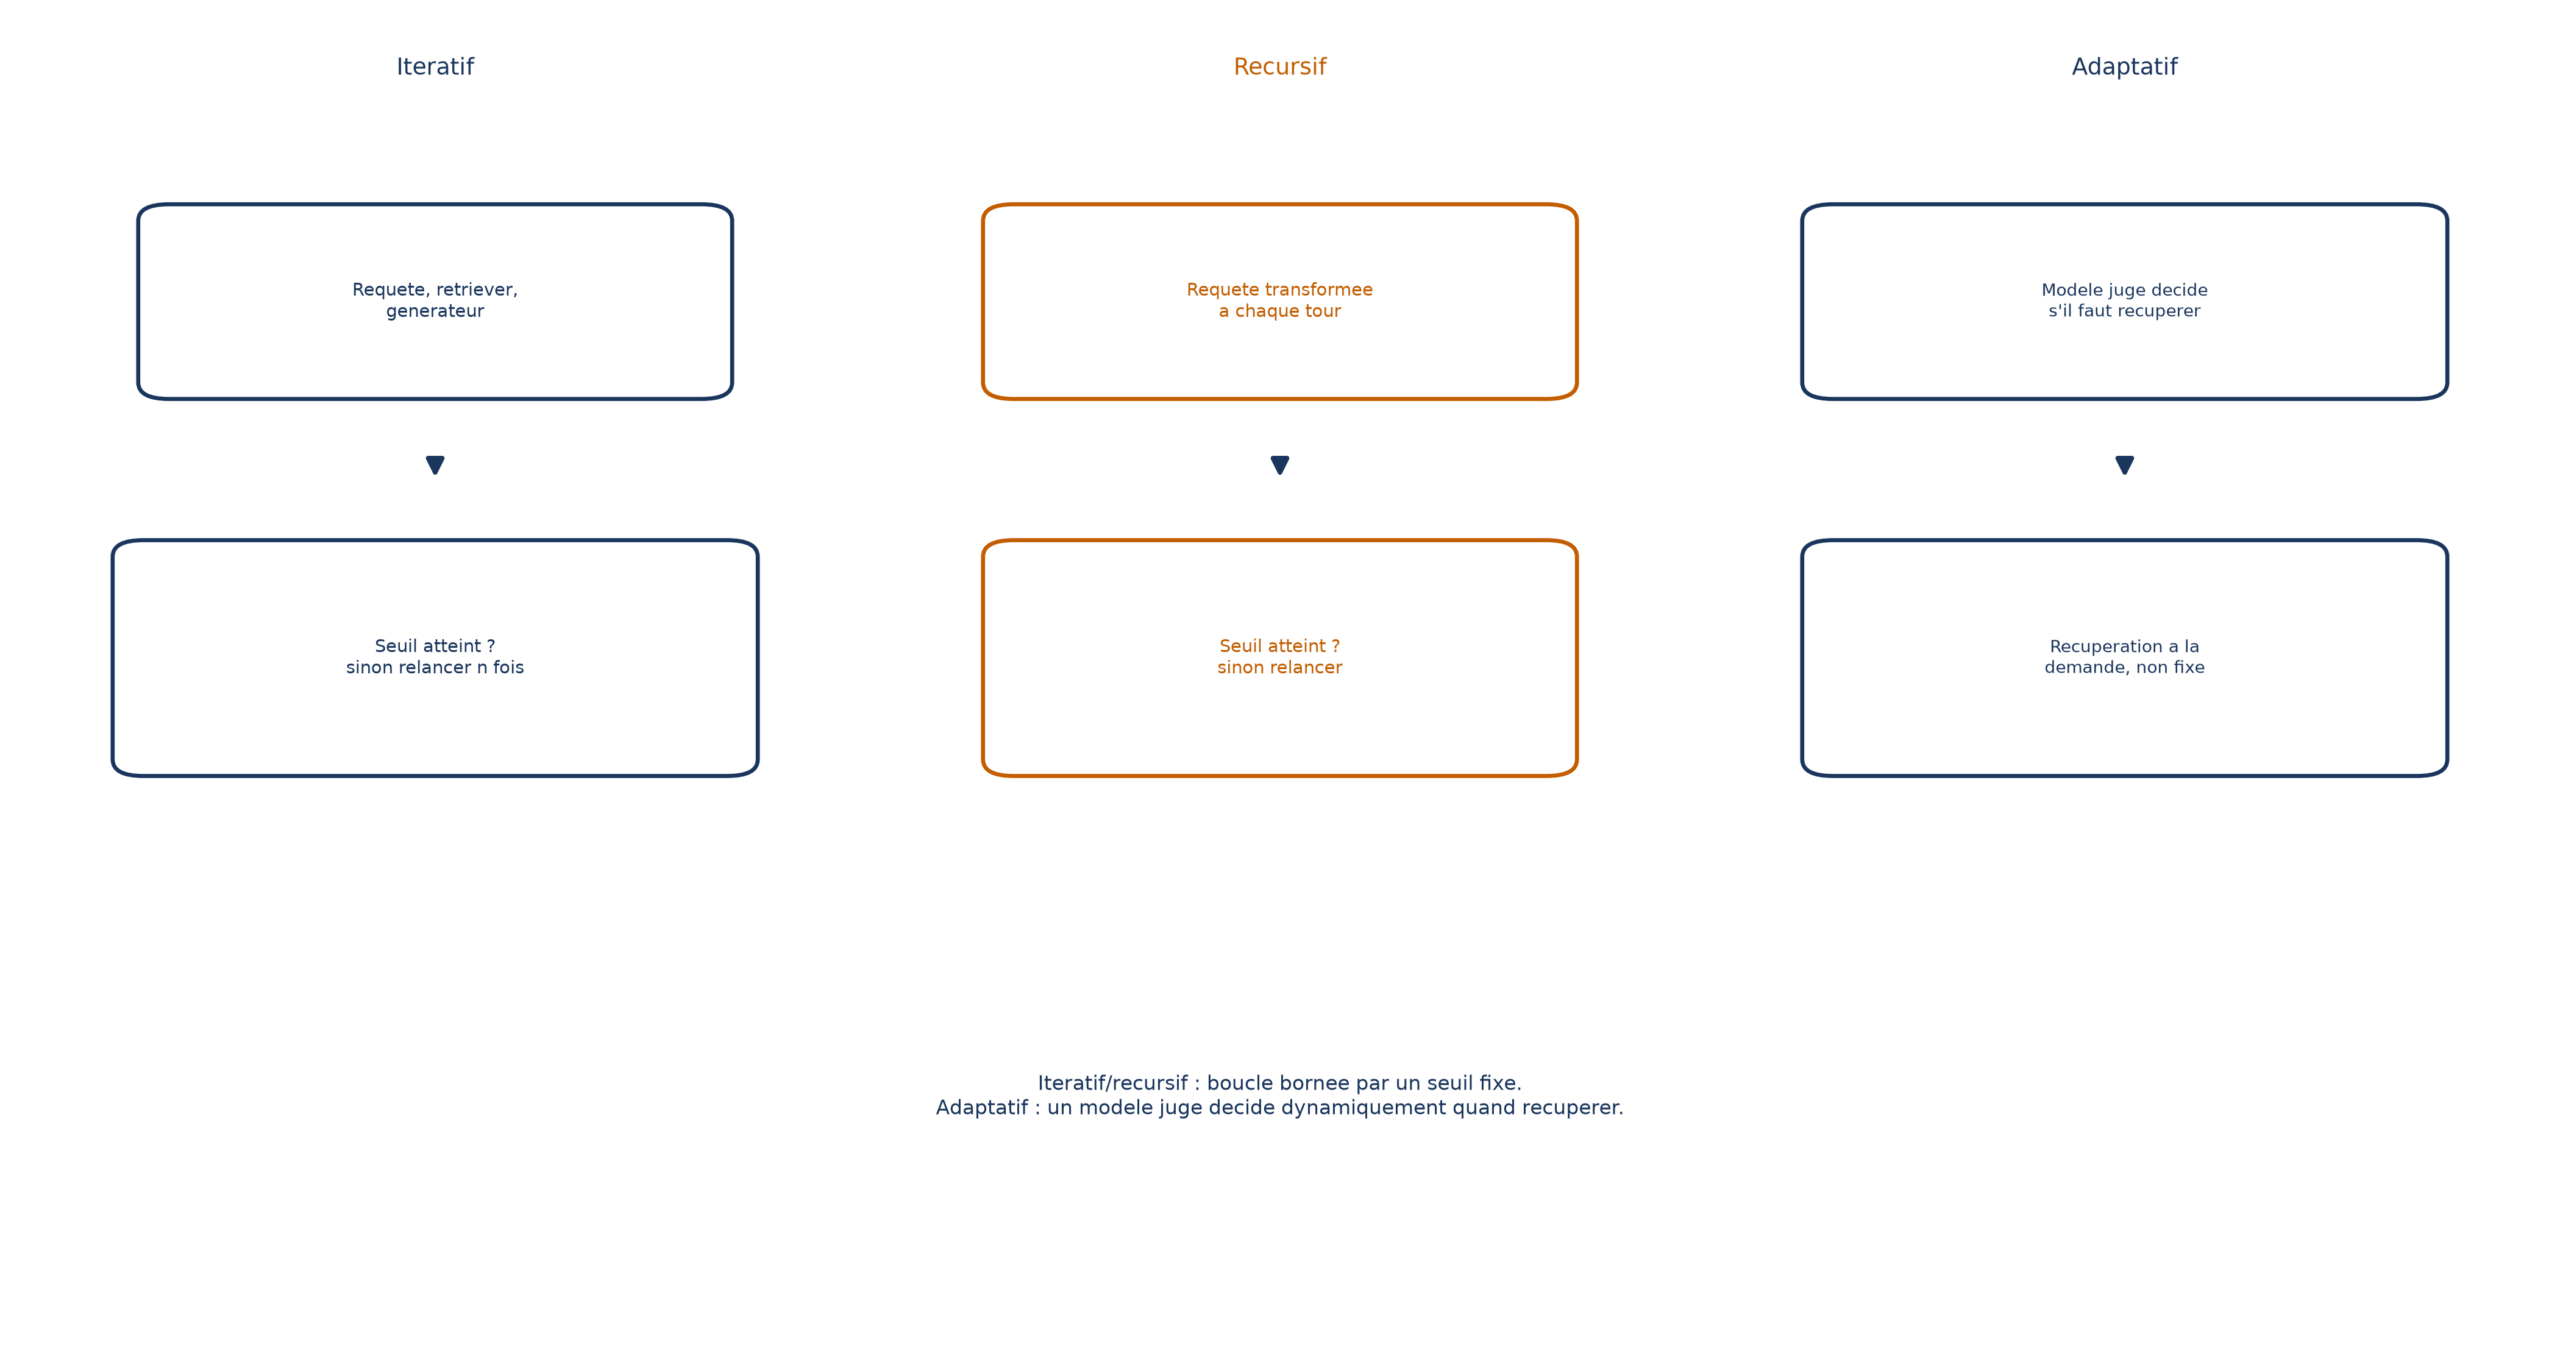
La récupération agentique confie la décision à l’agent : il choisit quelle source interroger, peut même contourner la récupération pour une simple salutation, et juge si l’information obtenue suffit ou si une nouvelle itération avec une requête reformulée s’impose. C’est la récupération adaptative.
D’autres mécanismes visent le même but. Un module de mémoire s’appuie sur la connaissance interne du modèle pour décider quand une récupération supplémentaire est réellement nécessaire, ce qui réduit les récupérations superflues. Self-RAG entraîne le modèle à utiliser des « jetons de réflexion » dont l’un indique si une récupération est nécessaire, au prix d’une demande de calcul plus élevée et d’un réglage fin des seuils.
Reste le nombre de documents ramenés. Voici une recherche par similarité dans un index chargé depuis le disque, où le paramètre k=2 demande les deux documents les plus proches de la question.
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings
import os
os.environ["OPENAI_API_KEY"] = "<YOUR_API_KEY>"

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vector_store = FAISS.load_local(
    folder_path="../../Assets/Data",
    index_name="CWC_index",
    embeddings=embeddings,
    allow_dangerous_deserialization=True
)
query = "Who won the 2023 Cricket World Cup?"
retrieved_docs = vector_store.similarity_search(query, k=2)
Ce k est un réglage à toi : moins de documents, moins de texte réinjecté dans l’invite. Tu peux aussi réduire le bruit avant même la recherche, par un filtrage sur les métadonnées (date, auteur, catégorie) qui restreint la recherche par similarité aux fragments pertinents.
Enfin, le meilleur appel reste celui qu’on ne fait pas. Un cache sémantique retrouve la réponse déjà générée quand une question similaire revient, au lieu de traverser tout le pipeline : on gagne du temps de réponse et du coût d’inférence, et on soulage le service du modèle.
Levier 6 : payer le bon modèle au bon moment
Le prix d’un jeton varie énormément d’un modèle à l’autre, et pas forcément avec la qualité. Le tableau prend Llama 3.1 comme référence (0,20 $ par million de jetons d’entrée, 0,60 $ en sortie) ; la qualité est mesurée par le score MMLU.
| Modèle | MMLU | Prix relatif entrée | Prix relatif sortie |
|---|---|---|---|
| DeepSeek-v3 | 87,2 | 2,75 | 3,65 |
| Claude 4 Opus, réflexion étendue | 86,5 | 75 | 125 |
| Gemini 2.5 Pro | 86,2 | 12,5 | 25 |
| Llama 3.1 Instruct Turbo 405B | 84,5 | 1 | 1 |
| o4-mini | 83,2 | 5,5 | 7,33 |
| Nova Pro | 82,0 | 4 | 5,33 |
| Mistral Large 2 | 80,0 | 10 | 10 |
| Grok 3 | 79,9 | 15 | 25 |
Lis les deux premières lignes : des scores MMLU voisins (87,2 et 86,5) pour des prix relatifs en entrée de 2,75 contre 75. La performance n’est pas directement corrélée au prix, et ces scores ne donnent qu’une indication : compare les modèles sur ta propre tâche.
L’architecture peut faire le tri à ta place. Dans un agent planificateur-exécuteur, le planificateur se concentre sur le raisonnement à long horizon tandis que les exécuteurs n’invoquent que les outils nécessaires, ce qui réduit les appels redondants ; des modèles plus petits peuvent gérer l’exécution, en réservant les gros à la planification.
Beaucoup d’équipes adoptent des stratégies hybrides : un modèle puissant pour les requêtes complexes, un modèle léger pour les tâches routinières, ou un routage dynamique qui envoie chaque requête vers le modèle adapté. Des plateformes automatisent ce tri (sélection automatique de modèle).
Pièges et limites
⚠️ Piège Chaque économie a son propre coût. Re-classement, compression et les autres techniques avancées introduisent un surcoût de calcul, de latence et de stockage, à mettre en balance avec le gain attendu ; la compression peut en plus faire perdre de l’information.
Ne sur-optimise pas trop tôt : on peut dépenser une énergie considérable à optimiser le choix du modèle pour des gains marginaux, et sauf contrainte d’échelle, démarrer simplement suffit.
Enfin, l’affinage d’un modèle peut réduire le coût par appel à fort trafic, mais il demande données, calcul et maintenance. La recommandation est de commencer par l’appel de fonctions intégré des modèles préentraînés, et en cas de doute de ne pas affiner : il existe souvent des actions moins coûteuses et à plus fort levier.
Aller plus loin
- ReAct : la boucle pensée-action-observation qui explique pourquoi un agent peut tourner longtemps.
- Re-classement : réordonner les documents récupérés pour prioriser les plus pertinents avant de les donner au modèle.
- Sélection automatique de modèle : l’envoi des requêtes simples vers de petits modèles rapides, des requêtes complexes vers les gros.
- Récupération agentique : l’agent choisit quand et où chercher, au lieu d’interroger une base unique à chaque fois.
À retenir
- La facture suit le nombre de tours, le texte relu à chaque tour et le prix du jeton : mesure-les séparément pour savoir où agir.
- Un agent n’est pas toujours nécessaire : du code ou un flux fixe coûte moins, et un agent unique coûte moins qu’une équipe.
- Toute boucle mérite une limite, un seuil et une sortie « introuvable ».
- Réflexion et contexte se plafonnent : peu de souvenirs réinjectés, historique résumé, budget de jetons.
- Recherche à la demande et choix du modèle par tâche sont les deux derniers gisements d’économie.
Questions fréquentes
Faut-il toujours limiter le nombre d’étapes d’un agent ?
Les consignes vont dans ce sens : appeler des outils jusqu’à une limite avant de répondre, plafonner profondeur et ramification, et prévoir un critère de sortie pour les boucles de critique.
La réflexion vaut-elle son coût ?
Elle ajoute latence et calcul ; elle se justifie dans les flux à fort enjeu, où une erreur précoce peut se propager en échec coûteux.
Un petit modèle peut-il suffire ?
Pour des tâches bien définies, sensibles à la latence ou au coût, un modèle beaucoup plus petit offre des résultats quasi équivalents pour une fraction du prix.