Pose cette question à un assistant branché sur ta base de films : « Qui a remporté le plus d’Oscars, et cette personne est-elle encore en vie ? » Un système de recherche classique lance une seule requête et s’arrête. Pourtant la question en cache deux, la seconde dépendant de la première. Et dans le jeu de données de films utilisé plus bas, l’information sur les Oscars est tout simplement absente.
Un bon système doit donc décider quoi chercher, où le chercher, vérifier ce qu’il a trouvé, et avoir l’honnêteté de dire « je ne sais pas ». À la fin de cet article, tu sauras assembler un agent et un RAG pour obtenir ce comportement, le mesurer, et repérer les pièges avant qu’ils ne coûtent cher.
L’essentiel en 30 secondes
- Un RAG va chercher de l’information dans une base externe au moment de la question, puis la donne au modèle pour qu’il réponde. Il met l’information au jour, mais ne décide d’aucune action.
- Un agent est un système qui exerce un vrai pouvoir de décision : il choisit ses outils, planifie, et s’adapte à ce qu’il observe.
- Le RAG agentique confie à l’agent le choix de la source à interroger et le jugement sur la qualité de ce qui revient.
- Trois briques suffisent pour démarrer : un routeur, des retrievers spécialisés, une critique de réponse.
- On commence simple (un seul agent, une critique), on mesure, puis on ajoute mémoire, réflexion ou agents multiples si le besoin est prouvé.
L’intuition : pourquoi coupler les deux
Avant de coupler quoi que ce soit, demande-toi si tu as besoin d’un agent. Cinq niveaux existent, du plus simple au plus autonome : du code procédural, un flux de travail déterministe, un chatbot classique, un RAG, puis un agent. À chaque marche, l’adaptabilité monte, mais le coût et la latence aussi.
Le RAG occupe une place précise dans cette échelle. Il suffit quand le besoin se résume à interroger une base de connaissances : un manuel produit, une archive juridique, un wiki d’entreprise. Ton service informatique peut répondre à « Comment réinitialiser mes identifiants VPN ? » en allant chercher le dernier guide de dépannage.
Mais un RAG ne planifie pas de façon autonome. Il ne va pas ouvrir un ticket ou planifier un rappel. Et quand les entrées deviennent très variables (des courriels libres allant de « la batterie de mon portable gonfle et risque d’exploser » à « on me facture des services que je n’ai jamais commandés »), il faut un agent qui comprend l’intention, consulte une base, rédige et escalade vers un humain si besoin.
📌 À retenir Le test d’un agent n’est pas son étiquette : l’agentivité est un spectre, pas un interrupteur. Demande-toi s’il exerce un authentique pouvoir de décision ou s’il suit un script figé.
Ce que fait le RAG, en deux pipelines
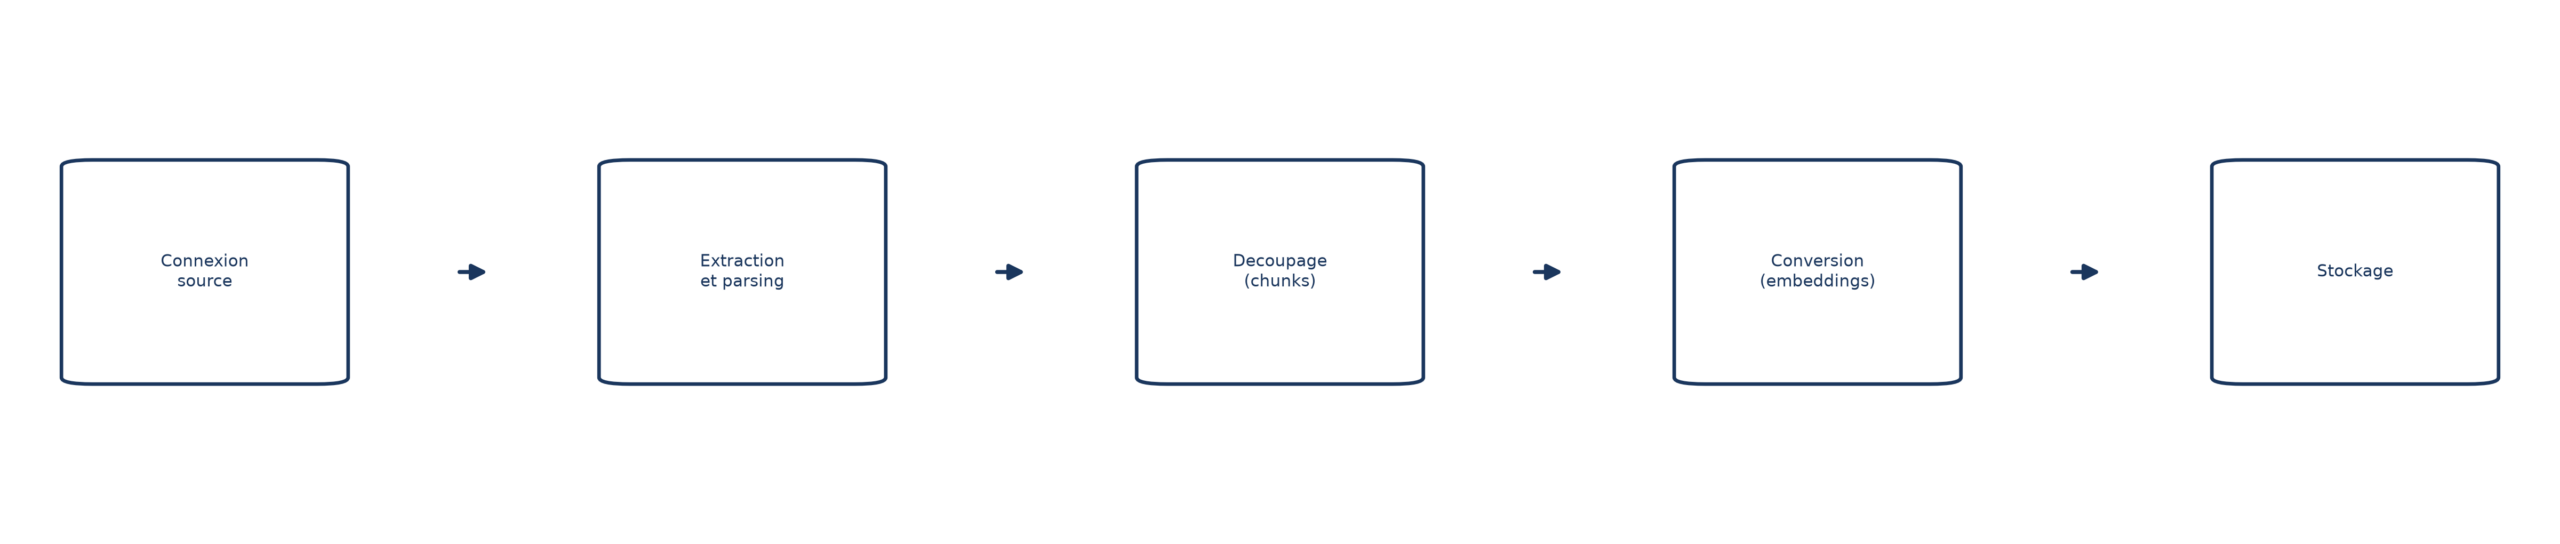
Un système RAG repose sur deux pipelines. Le premier, l’indexation, tourne hors ligne : il construit la base de connaissances à l’avance et la met à jour à intervalles réguliers. Le second, la génération, tourne en temps réel à chaque question.
L’indexation se déroule en cinq étapes : connexion à la source, extraction du texte, découpage en fragments, conversion en embeddings, stockage dans une base vectorielle. Cette étape est un prérequis : avant qu’elle ait tourné, le pipeline de génération n’a tout simplement rien à chercher.
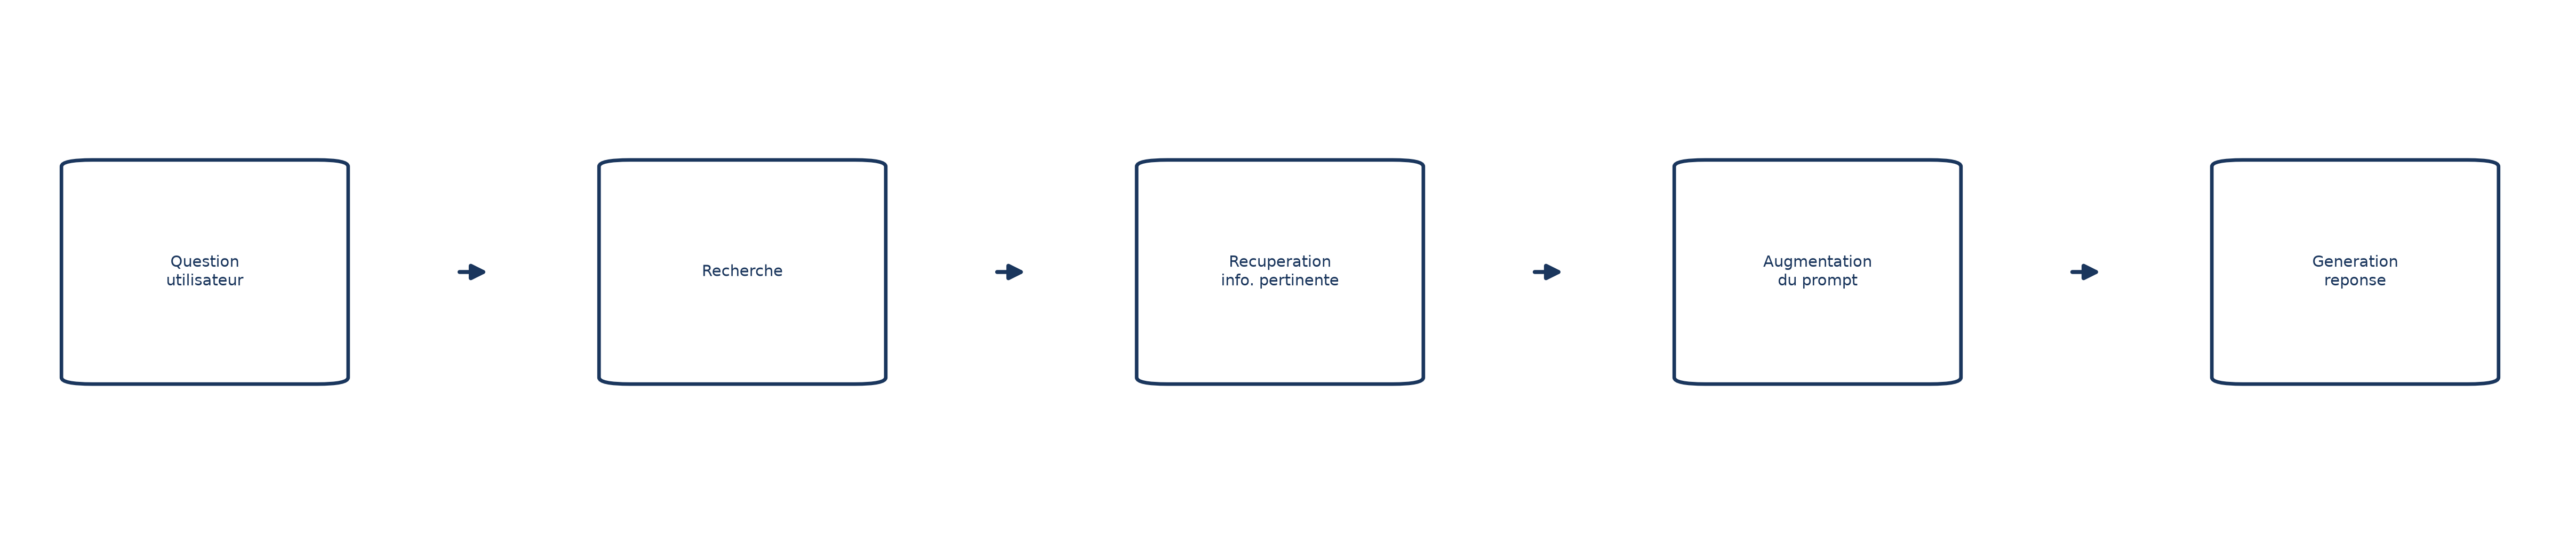
La génération, elle, se résume en cinq gestes : l’utilisateur pose sa question, le système cherche l’information pertinente, la récupère, l’ajoute à la question dans l’invite, puis le modèle répond en s’appuyant dessus.
Ce qu’ajoute l’agent
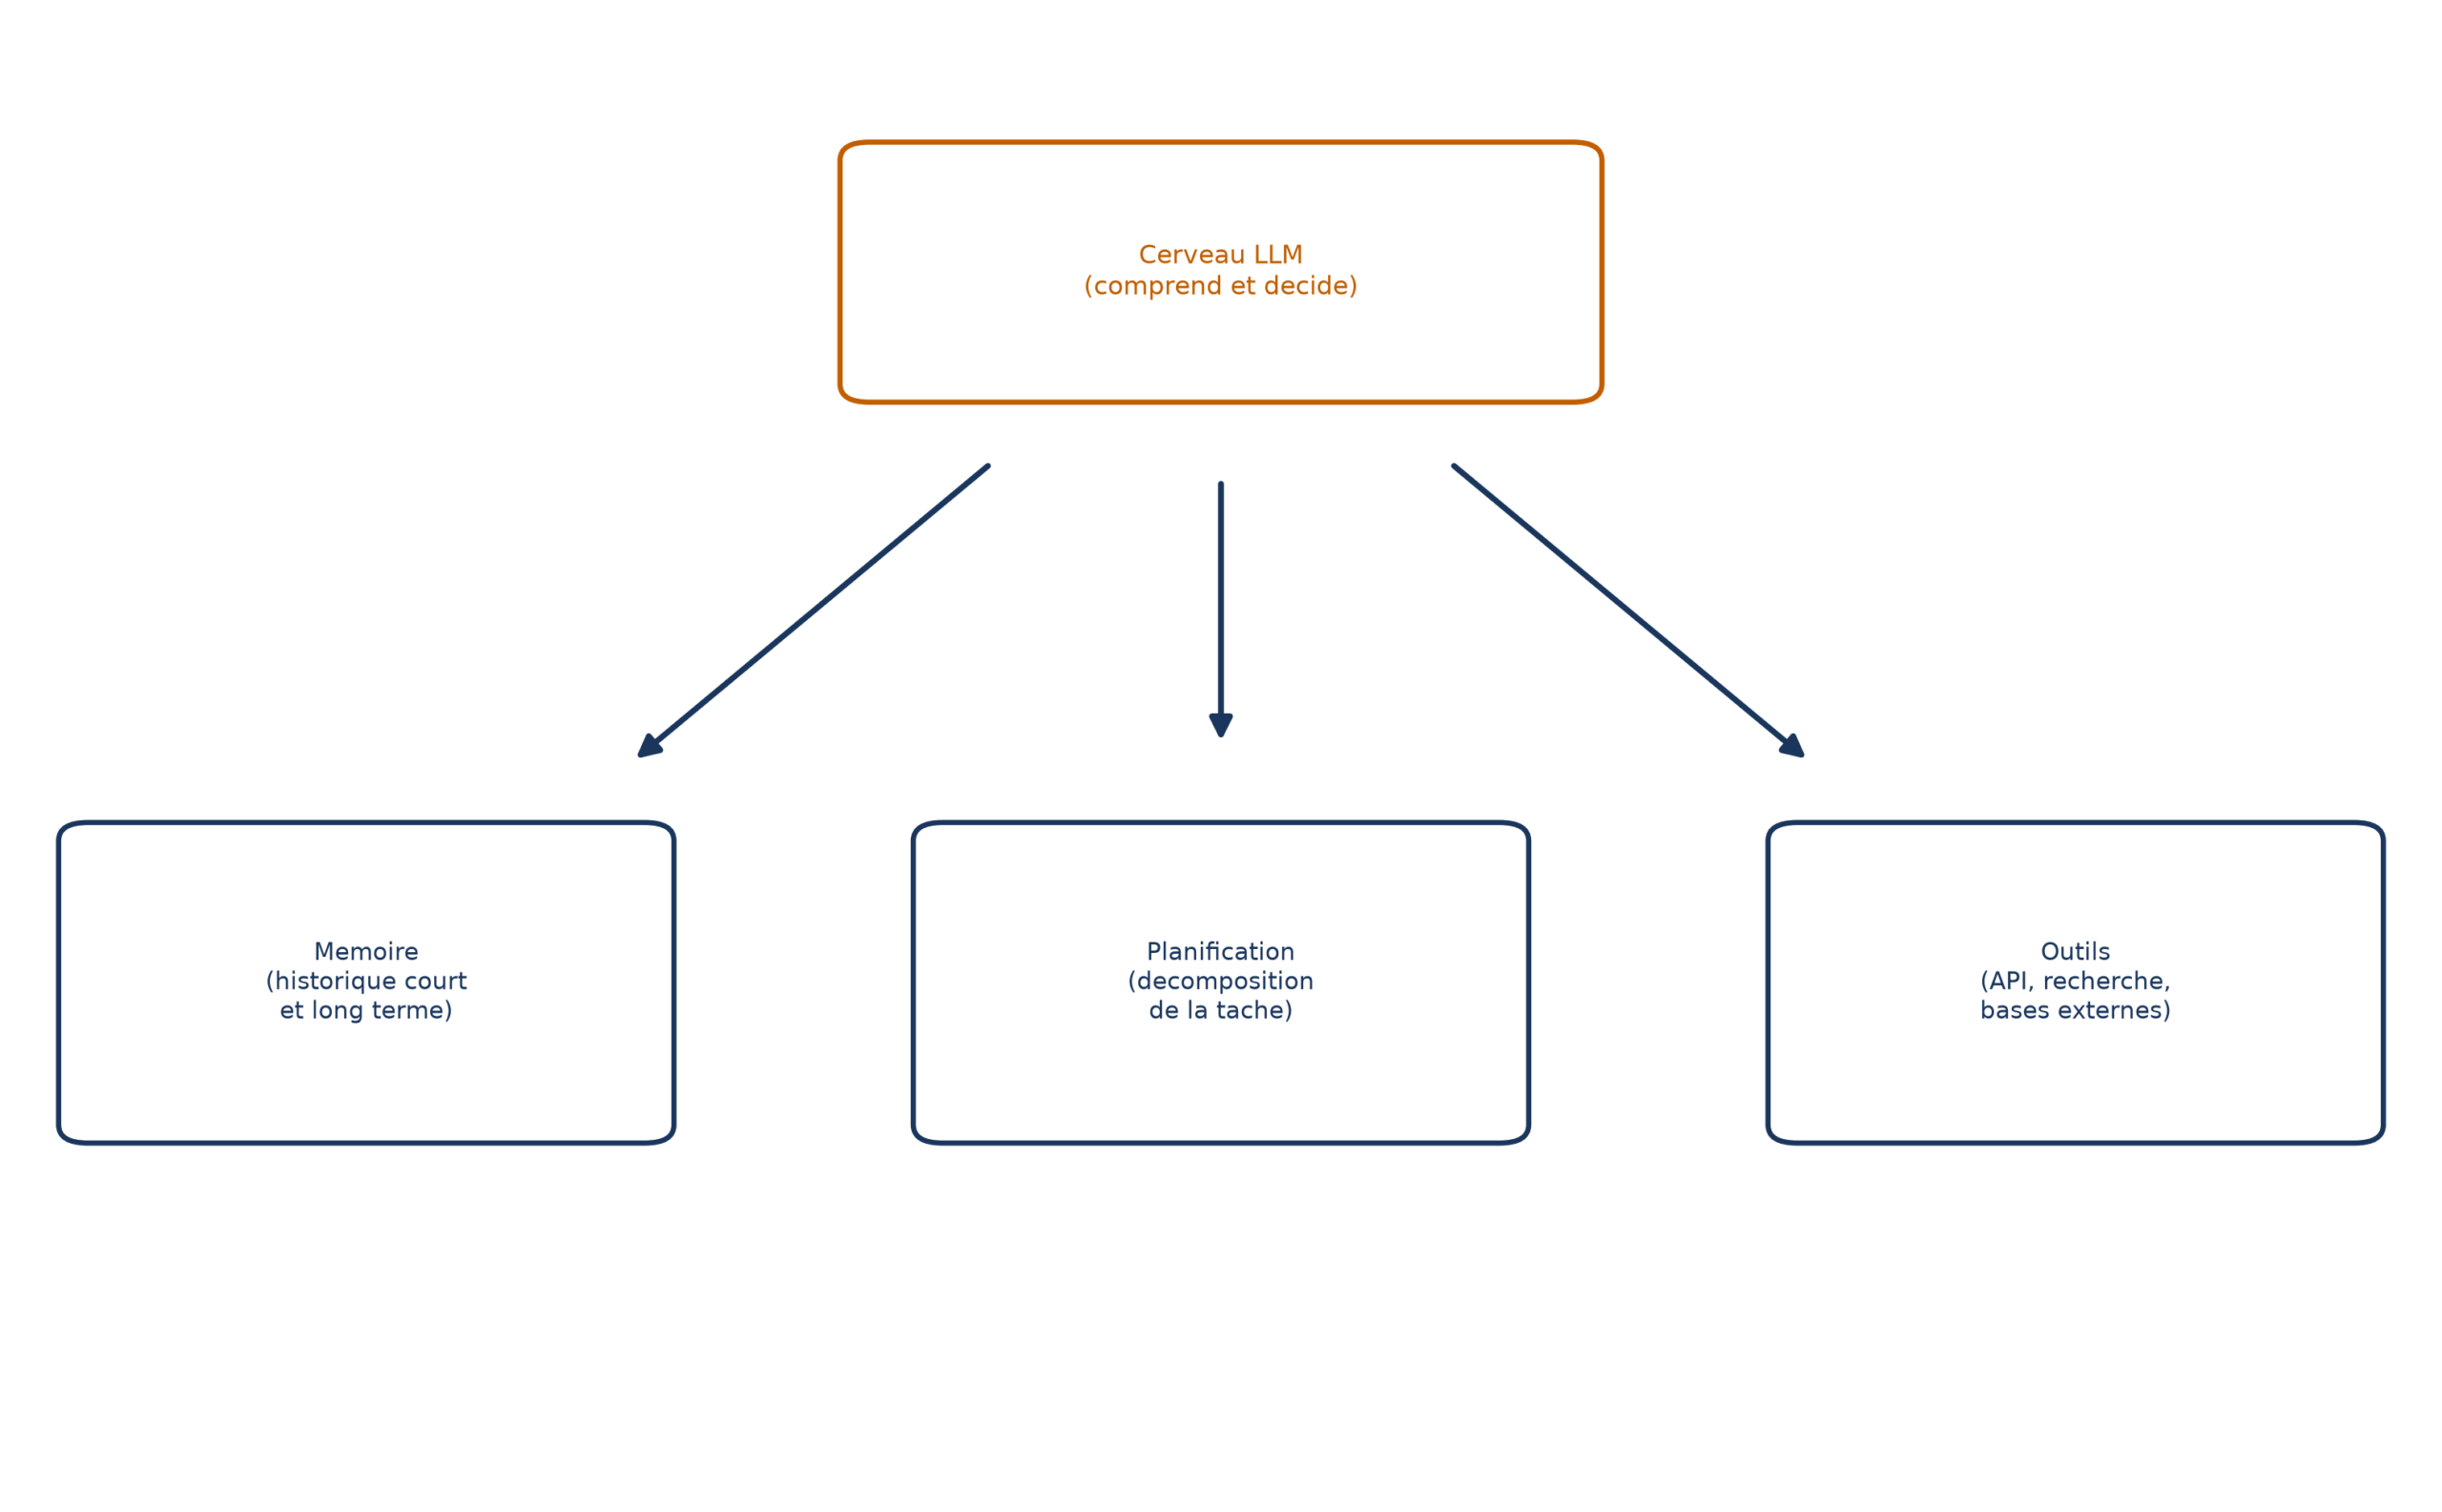
Un agent LLM repose généralement sur quatre composants. Le cerveau, un LLM, comprend la requête et coordonne le reste. La mémoire conserve l’historique à court terme (la conversation) et à long terme. La planification décompose une tâche en sous-tâches. Les outils permettent d’agir sur des ressources externes : recherche web, requête SQL, API tierce.
Le RAG agentique tire trois capacités de ce couplage. Le routage de requête, d’abord : l’agent décide quelle base interroger, ou même s’il doit s’en passer pour une simple salutation. L’usage d’outils, ensuite, qui donne accès à des sources hors base de connaissances, comme une recherche web. La récupération adaptative, enfin : l’agent juge si l’information suffit ou si une nouvelle recherche, avec une requête reformulée, s’impose.
Pourquoi ne pas tout mettre dans un seul magasin ? Un RAG standard interroge une base unique pour toute requête. Toute l’information doit y être indexée, et chaque question doit la parcourir en entier, même quand seule une fraction est utile.
Sous le capot : trois briques
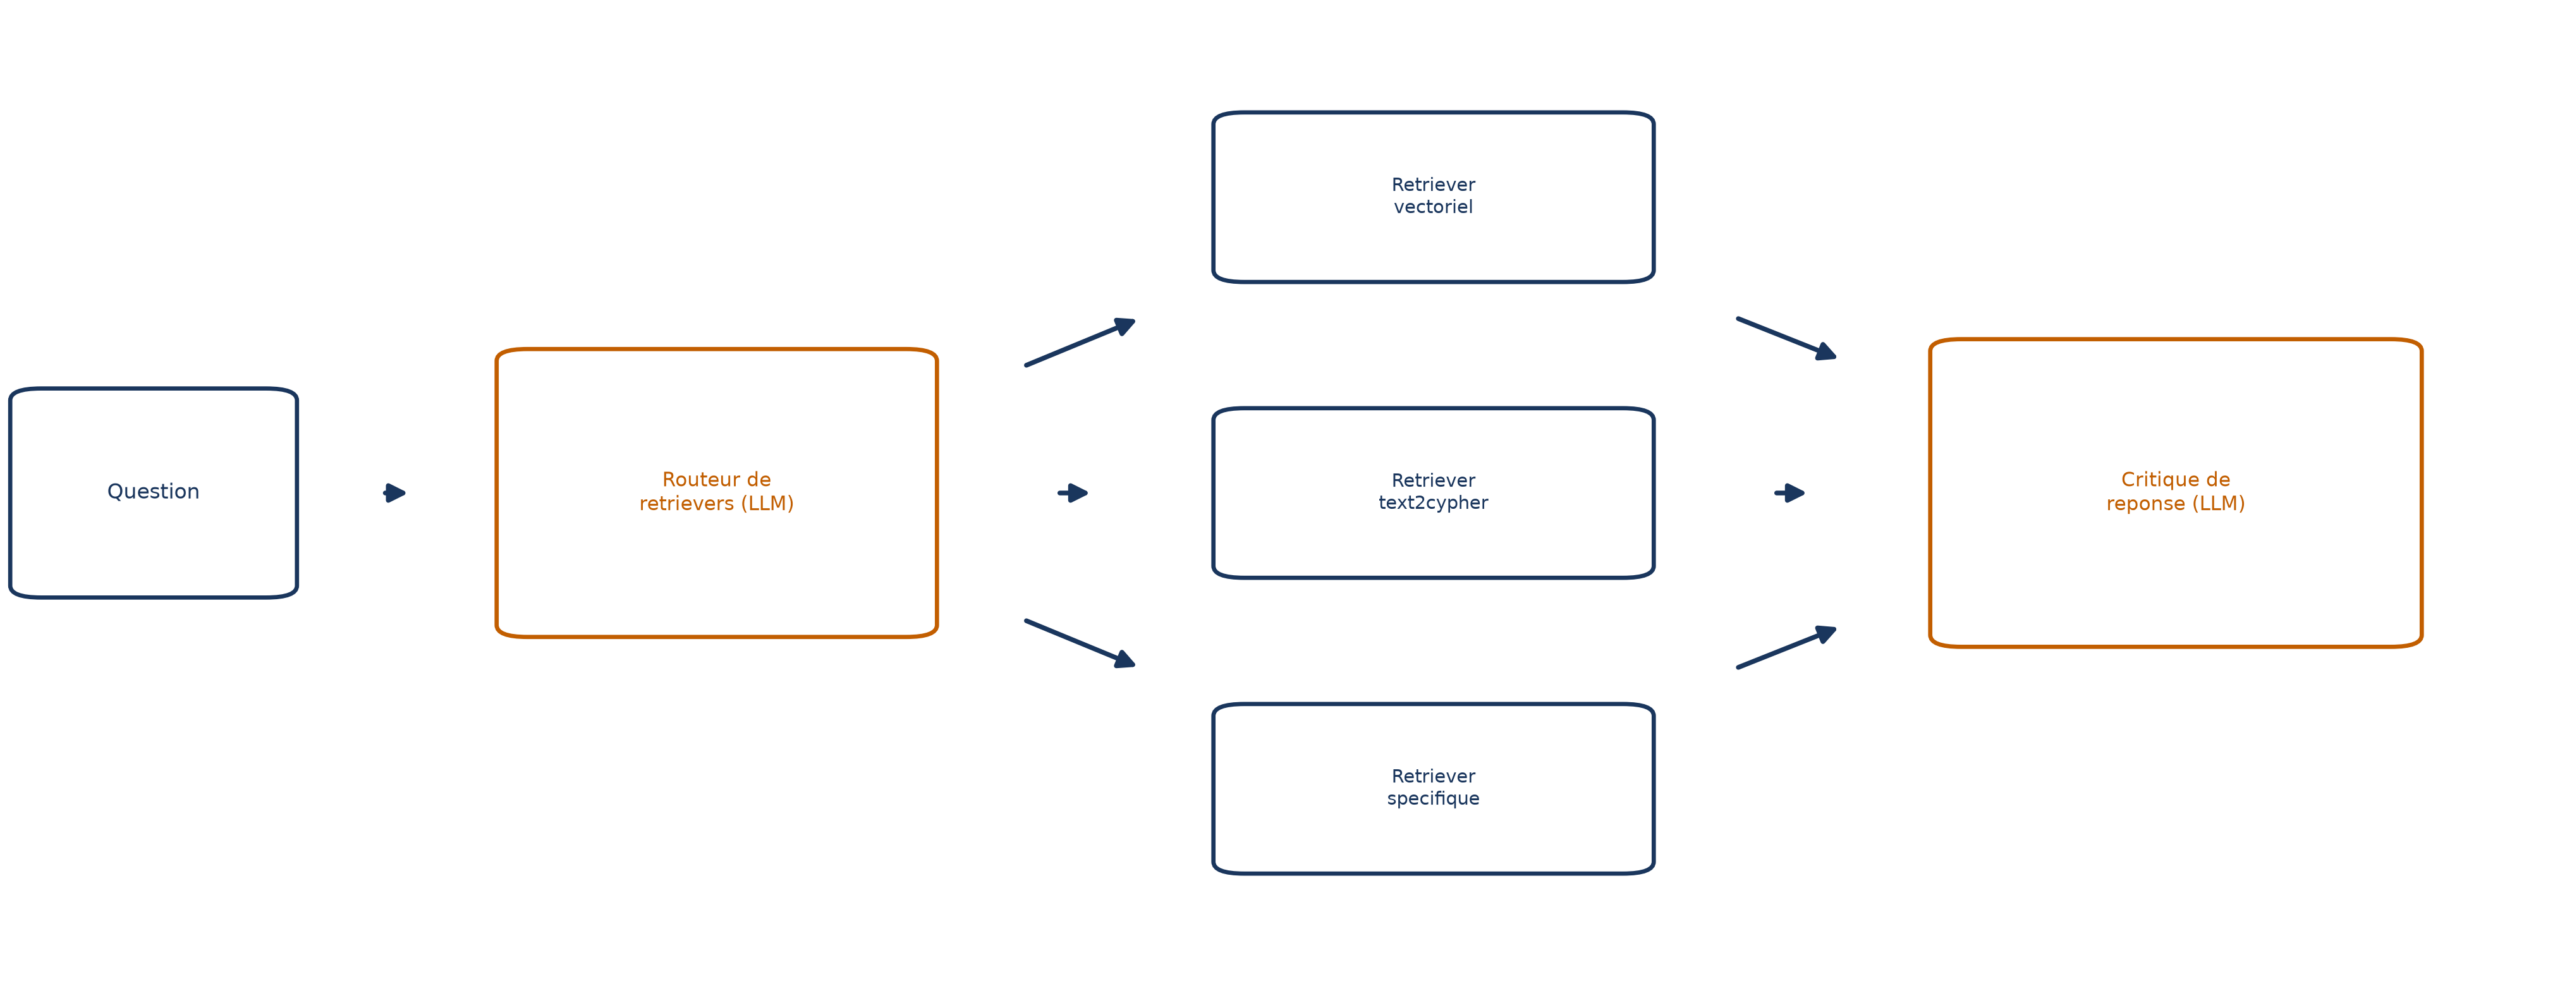
Un RAG agentique repose sur trois briques. Le routeur de retrievers prend la ou les questions de l’utilisateur et retourne le ou les meilleurs retrievers à utiliser. Les agents retrievers vont chercher effectivement les données. La critique de réponse vérifie que les réponses obtenues répondent bien à la question initiale.
Le routeur : choisir le bon outil
Des retrievers, il en existe de généraux et de très étroits. Un retriever vectoriel est adapté aux sources non structurées. Un text2cypher, qui traduit la question en requête sur un graphe, convient aux données structurées. Mais en production, aucun des deux ne suffit toujours sur des données complexes : on construit donc au fil du temps des retrievers spécialisés, comme un gabarit de requête codée en dur qui prend des paramètres.
Prends deux retrievers codés en dur, capital_by_country et country_by_capital. Pour « What is the capital of France ? », le routeur (un LLM) choisit le premier avec « France » comme argument : capital_by_country("France").
Une précision importante : le LLM n’appelle jamais directement les retrievers. Il décide lequel utiliser et avec quels arguments, et l’appel effectif reste à la charge du système qui l’entoure. C’est le principe du function calling, et il faut que le modèle le supporte nativement, ou qu’on s’y prenne avec l’approche ReAct.
La critique : ne pas laisser passer une mauvaise réponse
La critique est une fonction bloquante. Si la réponse est incorrecte ou incomplète, elle l’empêche de continuer, génère une nouvelle question qui permet de récupérer l’information manquante et relance un tour de recherche.
Il faut cependant prévoir une sortie de boucle. La bonne réponse peut simplement ne pas exister dans les données, et la critique doit alors pouvoir le signaler plutôt que de tourner indéfiniment.
💡 Intuition Le routeur répond à « où chercher ? », la critique à « ai-je vraiment de quoi répondre ? ». Sans la seconde, l’agent invente ; sans le premier, il cherche partout et mal.
Boucler : itératif, récursif, adaptatif
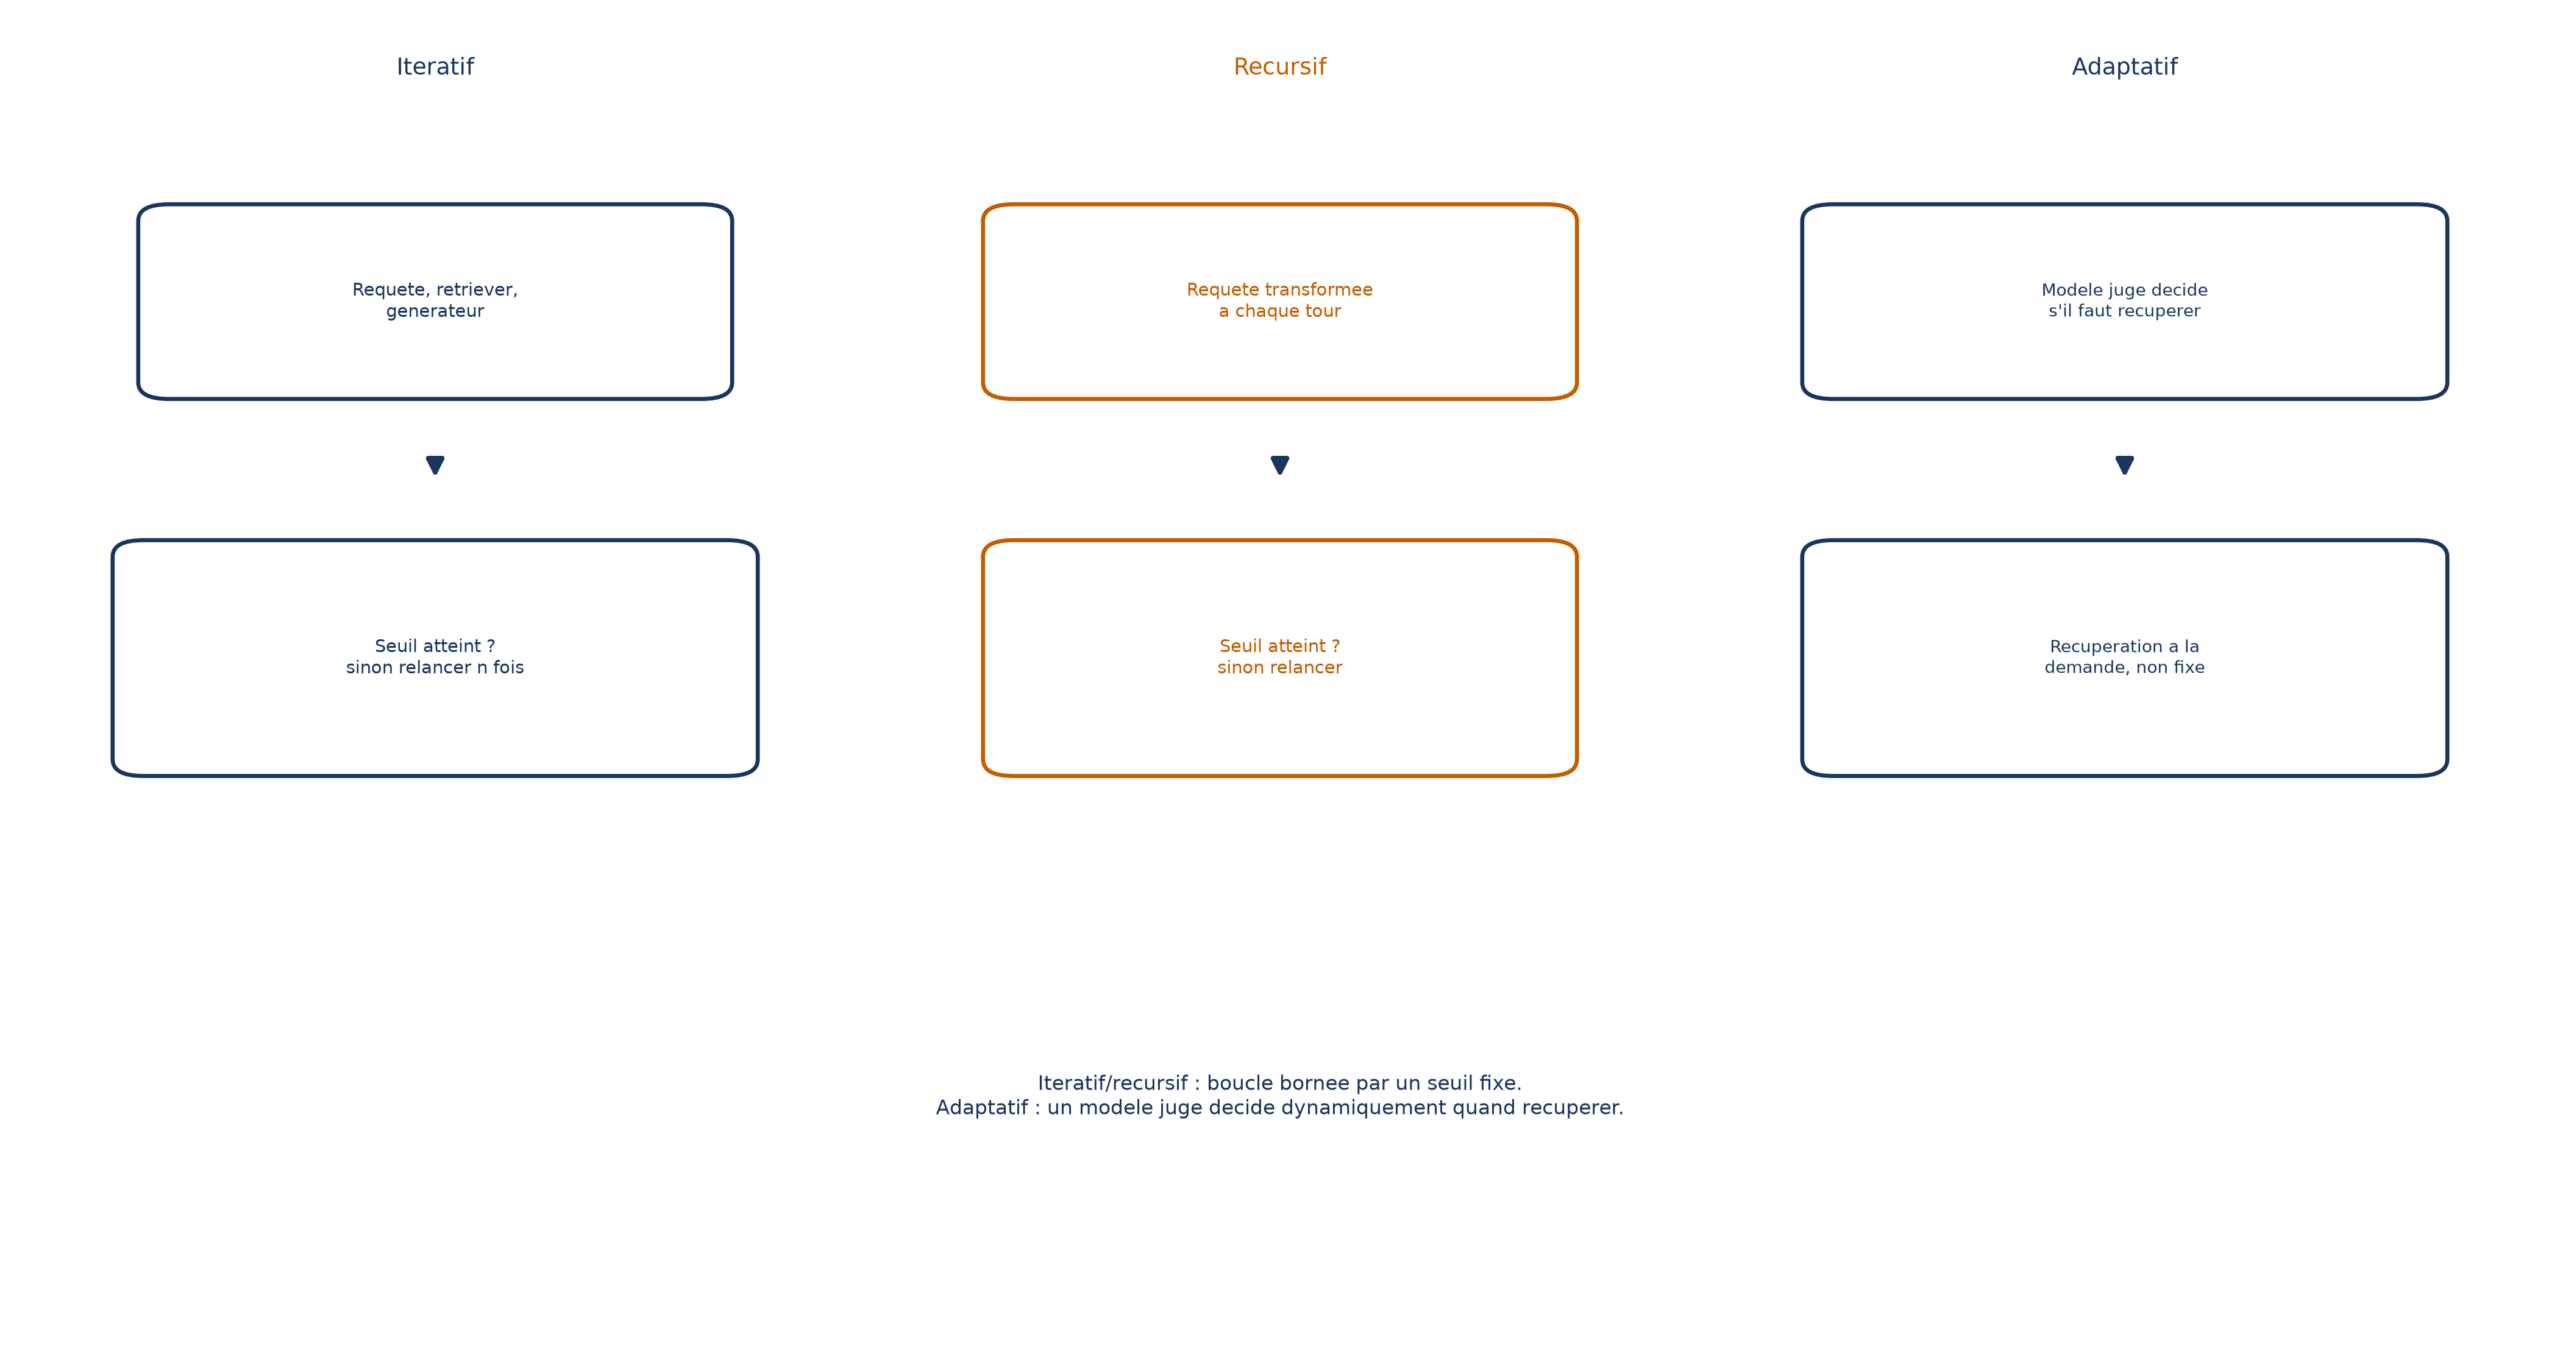
Quand une seule passe ne suffit pas, trois manières de répéter la récupération existent. En mode itératif, on interroge plusieurs fois en affinant à partir de ce qui est déjà obtenu. En mode récursif, on transforme la requête à chaque tour selon les fragments obtenus. En mode adaptatif, le LLM décide lui-même quand et quoi récupérer.
Le voir tourner
Passons à du code réel : un système agentique volontairement simple, qui choisit un retriever et décide si le contexte trouvé répond à la question. Il tourne sur un jeu de données de films stocké dans une base de graphe Neo4j, avec trois outils : un gabarit de requête par titre de film, un gabarit par acteur, et un text2cypher de repli pour tout le reste.
Un outil, sa description et son implémentation
Chaque outil se compose de deux morceaux. Une description au format JSON schema, que le LLM lit pour comprendre à quoi sert l’outil et quels paramètres passer. Et une fonction Python, qui exécute la requête Cypher sur la base. Observe la requête : elle retrouve un film par son titre, avec son casting et ses réalisateurs.
movie_info_by_title_description = {
    "type": "function",
    "function": {
        "name": "movie_info_by_title",
        "description": "Get information about a movie by providing the title",
        "parameters": {
            "type": "object",
            "properties": {
                "title": {
                    "type": "string",
                    "description": "The movie title",
                }
            },
            "required": ["title"],
        },
    },
}

def movie_info_by_title(title: str):
    """Return movie information by title."""
    query = """
    MATCH (m:Movie)
    WHERE toLower(m.title) CONTAINS $title
    OPTIONAL MATCH (m)<-[:ACTED_IN]-(a:Person)
    OPTIONAL MATCH (m)<-[:DIRECTED]-(d:Person)
    RETURN m AS movie, collect(a.name) AS cast, collect(d.name) AS directors
    """
    records, _, _ = neo4j_driver.execute_query(query, title=title.lower())
    return [record.data() for record in records]
neo4j_driver est la connexion à la base de films. La description compte autant que le code : c’est elle qui permet au modèle de bien choisir l’outil et ses paramètres. Le troisième outil, answer_given, sert quand la réponse est déjà dans la conversation, comme « What’s Dave Smith’s last name ? » : il évite de relancer une recherche inutile.
Exécuter l’appel décidé par le LLM
Le modèle a choisi un outil. Il faut maintenant faire l’appel à sa place. La fonction ci-dessous parcourt la liste des appels demandés, retrouve la fonction réelle dans le dictionnaire tools, décode les arguments JSON et exécute.
def handle_tool_calls(tools: dict[str, any], llm_tool_calls: list[dict[str, any]]):
    output = []
    if llm_tool_calls:
        for tool_call in llm_tool_calls:
            function_to_call = tools[tool_call.function.name]["function"]
            function_args = json.loads(tool_call.function.arguments)
            res = function_to_call(**function_args)
            output.append(res)
    return output
Le modèle peut tout à fait décider d’appeler plusieurs outils pour une seule question : d’où la boucle.
Le routeur, en une fonction
Pour les questions « à tiroirs » comme celle des Oscars, on ajoute une étape : query_update reformule chaque question en s’appuyant sur les réponses déjà obtenues. La question devient « Who won the most Oscars ? » puis « Is that person alive ? », la seconde dépendant de la première. Voici maintenant le routage : le dictionnaire des outils, l’invite qui explique au modèle son rôle, et route_question qui l’interroge.
tools = {
    "movie_info_by_title": {
        "description": movie_info_by_title_description,
        "function": movie_info_by_title
    },
    "movies_info_by_actor": {
        "description": movies_info_by_actor_description,
        "function": movies_info_by_actor
    },
    "text2cypher": {
        "description": text2cypher_description,
        "function": text2cypher
    },
    "answer_given": {
        "description": answer_given_description,
        "function": answer_given
    }
}

tool_picker_prompt = """
    Your job is to choose the right tool needed to respond to the user
question.
    The available tools are provided to you in the request.
    Make sure to pass the right and complete arguments to the chosen tool.
"""

def route_question(question: str, tools: dict[str, any], answers:
list[dict[str, str]]):
    llm_tool_calls = tool_choice(
        [
            {
                "role": "system",
                "content": tool_picker_prompt,
            },
            *answers,
            {
                "role": "user",
                "content": f"The user question to find a tool to answer: '{question}'",
            },
        ],
        model = "gpt-4o",
        tools=[tool["description"] for tool in tools.values()],
    )
    return handle_tool_calls(tools, llm_tool_calls)
Chaque entrée associe un outil à sa description et à sa fonction. Celle du titre est le bloc vu plus haut ; les trois autres (gabarit par acteur, text2cypher, answer_given) sont construites sur le même modèle : une description JSON puis une fonction. tool_choice est la fonction qui envoie ces messages au modèle en lui passant les descriptions d’outils. Ajouter un retriever revient à ajouter une entrée : le système reste facilement extensible.
La boucle principale et la critique
On assemble ensuite ces briques en une fonction qui met à jour la question, l’aiguille vers un outil et note le résultat dans l’historique.
def handle_user_input(input: str, answers: list[dict[str, str]] = []):
    updated_question = query_update(input, answers)
    response  = route_question(updated_question, tools, answers)
    answers.append({"role": "assistant", "content": f"For the question: '{updated_question}', we have the
         answer: '{json.dumps(response)}'"})
    return answers
Reste la dernière pièce. critique_answers est la critique de réponse : elle renvoie une liste de questions complémentaires si la réponse est incomplète ou incorrecte. Le code ci-dessous l’appelle une seule fois, puis demande au LLM final de répondre en n’utilisant que ce qui a été trouvé.
main_prompt = """
    Your job is to help the user with their questions.
    You will receive user questions and information needed to answer the
questions
    If the information is missing to answer part of or the whole question,
you will say that the information
    is missing. You will only use the information provided to you in the
prompt to answer the questions.
    You are not allowed to make anything up or use external information.
"""

def main(input: str):
    answers = handle_user_input(input)
    critique = critique_answers(input, answers)
    if critique:
        answers = handle_user_input(" ".join(critique), answers)
    llm_response = chat(
        [
            {"role": "system", "content": main_prompt},
            *answers,
            {"role": "user", "content": f"The user question to answer: {input}"},
        ],
        model="gpt-4o",
    )
    return llm_response
Trois choses à retenir de ce code. La critique n’est appliquée qu’une fois : si les réponses restent incomplètes après la seconde passe, elles sont quand même renvoyées, et le LLM final signale explicitement ce qui manque. C’est ton critère de sortie de boucle. Ensuite, l’invite finale interdit d’inventer : le modèle ne doit utiliser que les informations fournies. Enfin, chat est la fonction qui appelle le modèle de conversation.
⚠️ Piège Si tu supprimes la borne sur la critique, la question sur les Oscars fera tourner ton système en rond : la réponse n’existe pas dans le jeu de données, et rien ne le lui dira. La sortie « l’information manque » est une fonctionnalité, pas un échec.
Mesurer que ça marche
Un pipeline sophistiqué peut se tromper de plusieurs façons, alors on évalue chaque étape. Il y a le choix de l’outil, la pertinence du contexte récupéré, la qualité de la réponse, puis l’efficacité de l’ensemble.
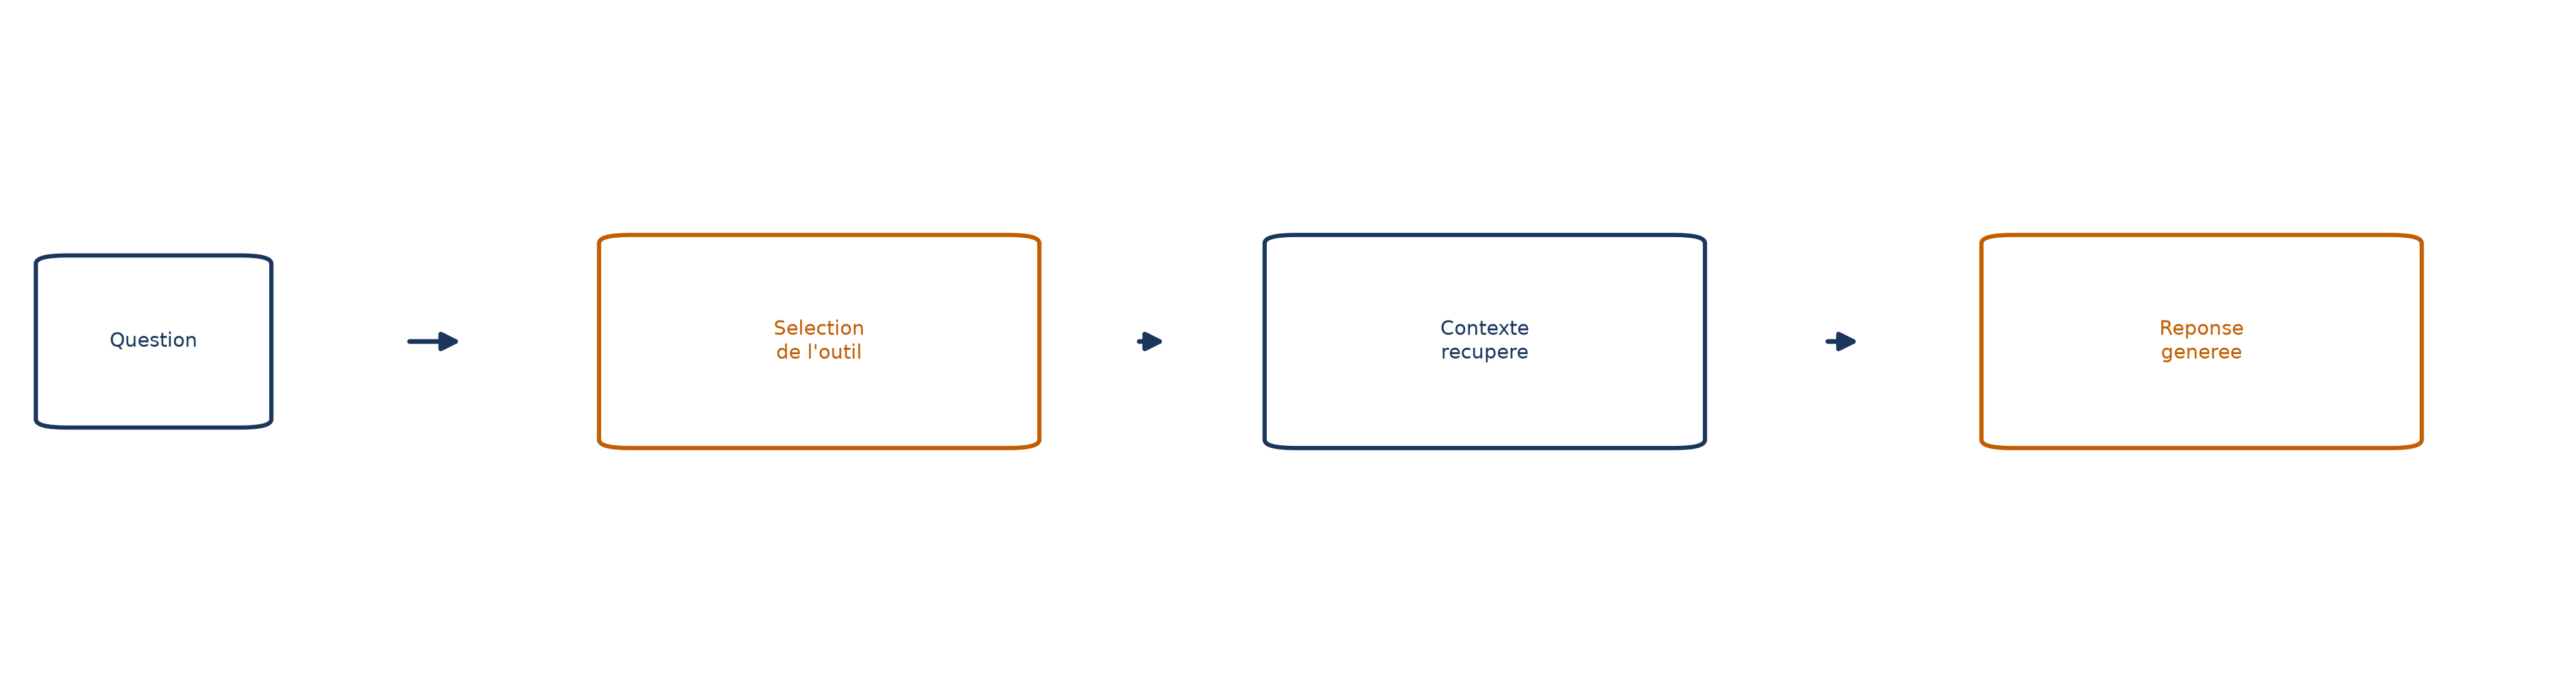
Isoler ces étapes a un avantage : tu peux vérifier si le LLM produit la bonne réponse quand on lui donne le bon contexte. Cela sépare ses capacités de raisonnement et de synthèse de celles de la récupération.
Évaluer les choix d’outils
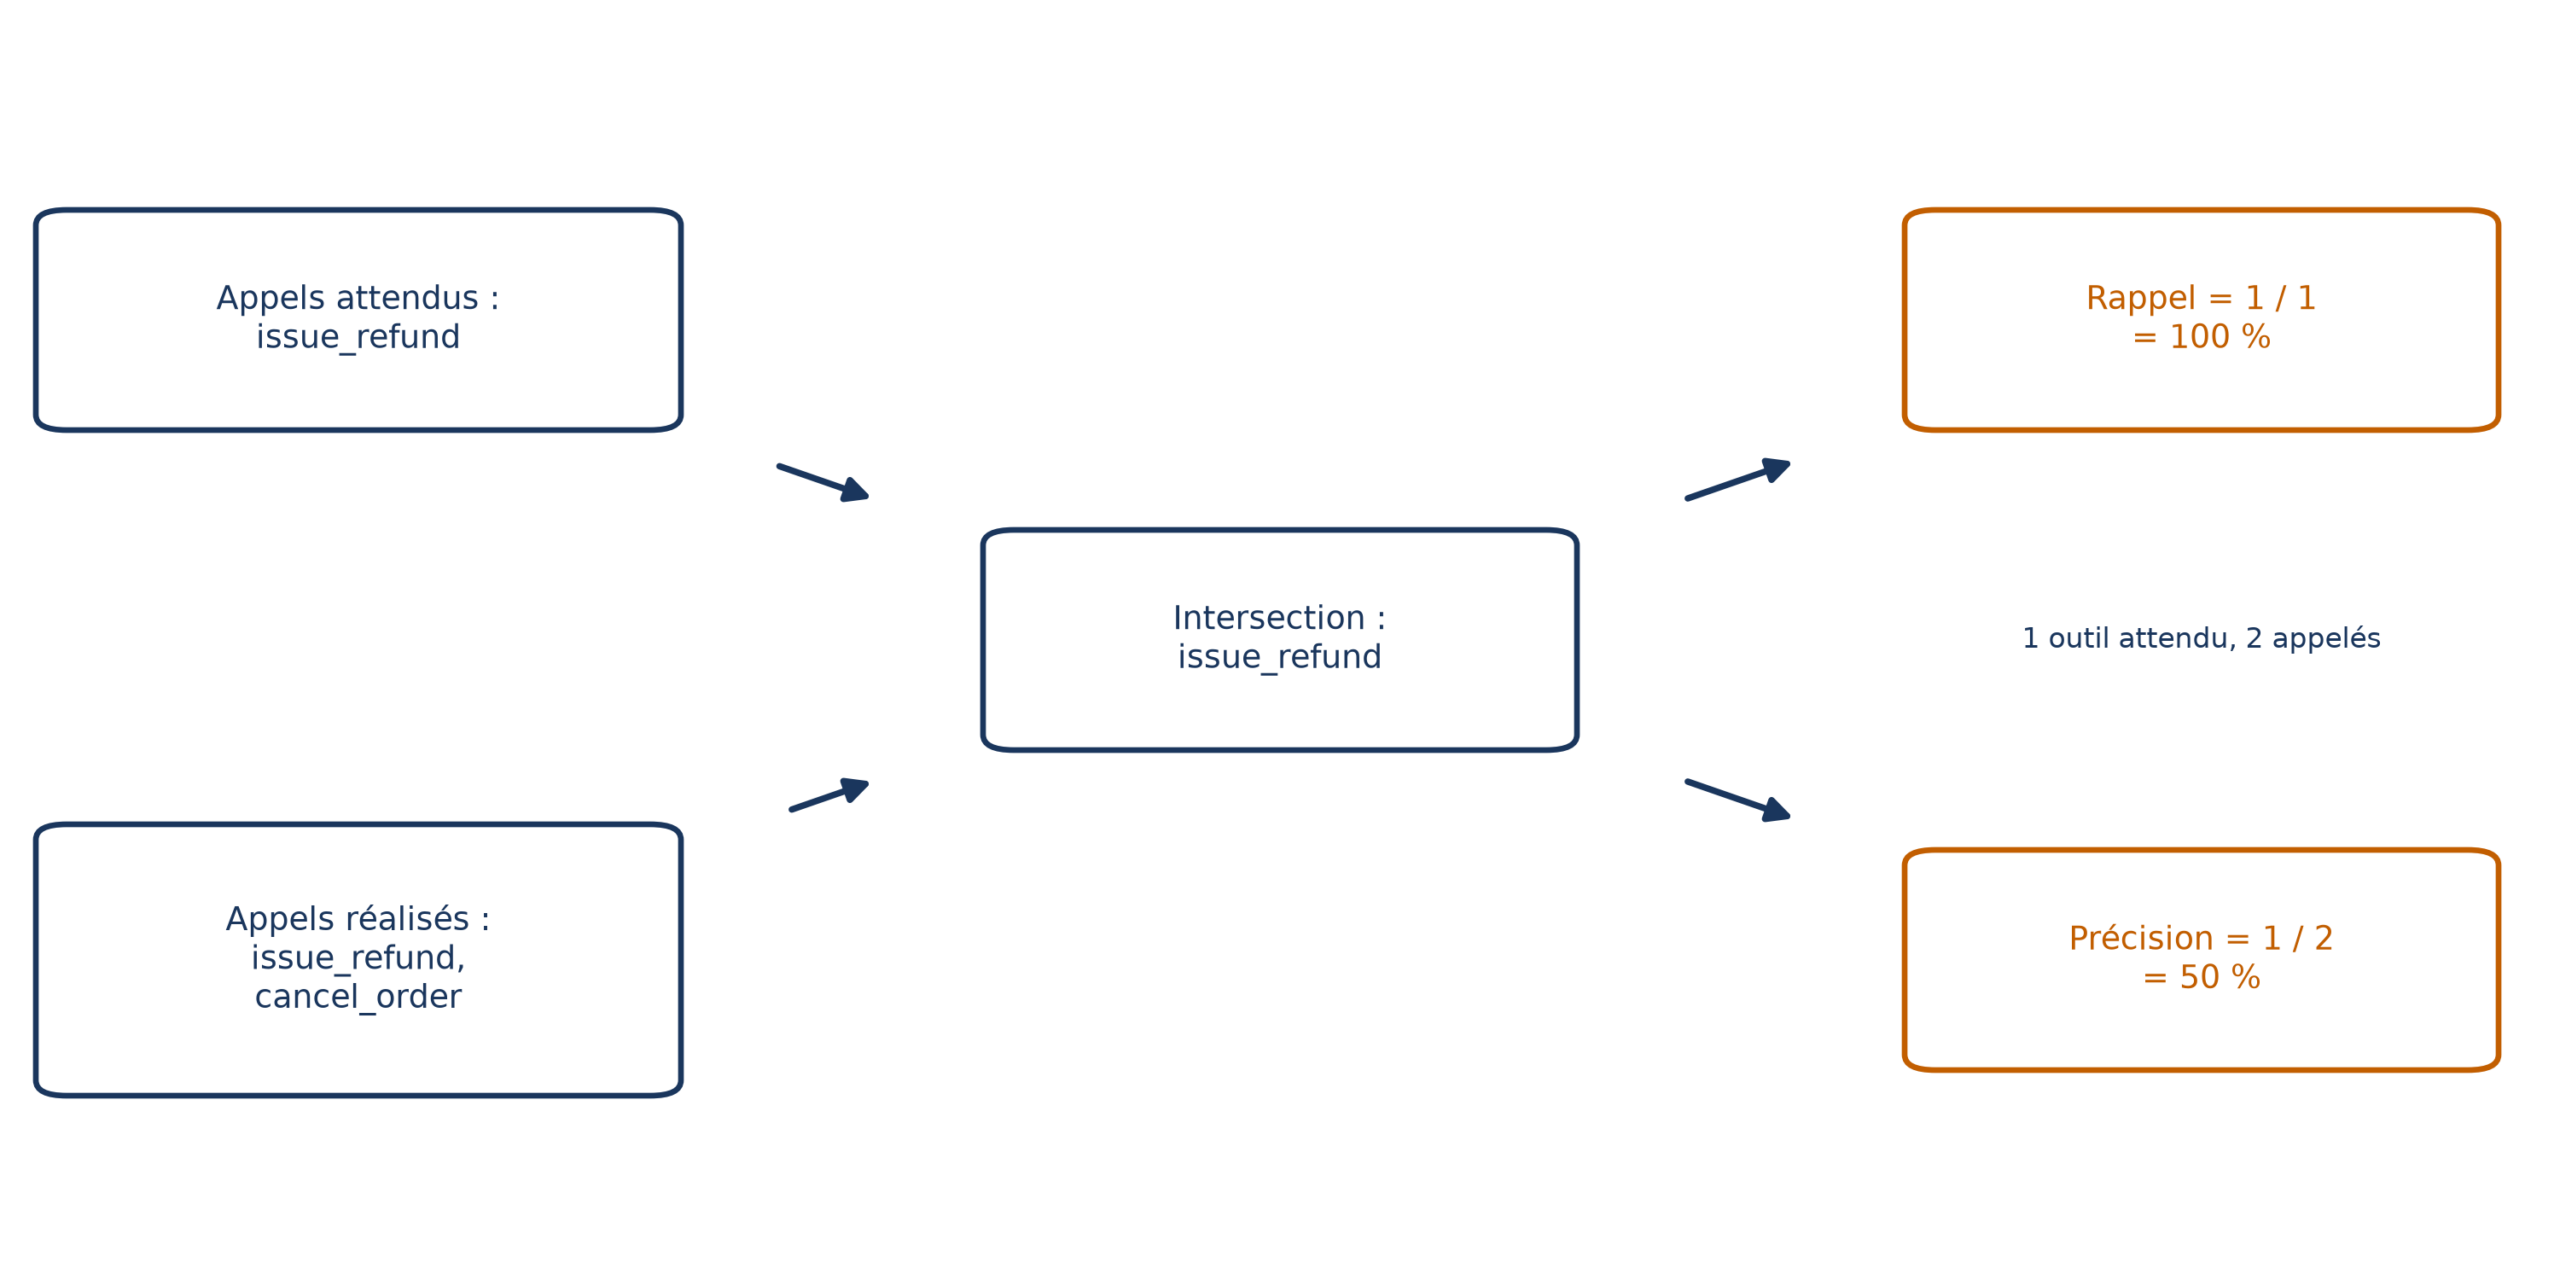
Pour vérifier le routage, on exécute l’agent de bout en bout et on compare ses appels d’outils aux attentes. Trois métriques : le rappel d’outils (a-t-il inclus tous les appels attendus ?), la précision d’outils (a-t-il évité les appels inutiles ?) et l’exactitude des paramètres (a-t-il passé le bon identifiant de commande ou le bon montant ?).
Évaluer le RAG lui-même
Côté RAG, trois qualités se dégagent : la pertinence du contexte (l’information récupérée est-elle utile à la requête ?), la fidélité de la réponse (s’appuie-t-elle vraiment sur ce qui a été récupéré ?) et la pertinence de la réponse (répond-elle à la question posée ?). La récupération et la génération sont à évaluer en priorité, car leurs effets sont directement mesurables.
Il faut aussi un jeu de test. Celui de l’exemple compte 17 cas, et sa composition dépend des fonctionnalités de ton agent. Diversifie-le : une salutation, une question hors sujet (la météo pour un agent dédié aux films), des questions d’agrégation qui exigent text2cypher, et des cas limites où la réponse manque dans les données.
📌 À retenir Un juge LLM peut biaiser l’évaluation, surtout s’il est le même modèle que celui qui génère. Utilise plusieurs juges différents du modèle de génération, échantillonne leurs jugements et complète par un retour humain.
Faire grandir le système, sans se précipiter
La mémoire : connaissance et histoire
Deux notions se confondent souvent. La connaissance, mise en œuvre par le RAG, apporte des contenus factuels ou propres à un domaine. La mémoire capture l’histoire de l’agent : échanges passés, sorties d’outils, mises à jour d’état. Elle lui donne de la continuité entre les tours et les sessions.
La mémoire de base est une fenêtre de contexte glissante qui perd l’information ancienne. La recherche par mots-clés (BM25) retrouve des termes exacts mais pas les paraphrases. La mémoire sémantique, elle, encode les interactions en vecteurs pour retrouver des contenus proches en sens.
Ce dernier mécanisme est celui de la mémoire d’expérience sémantique. À chaque entrée de l’utilisateur, on cherche dans les interactions précédentes stockées. Une partie de la fenêtre de contexte est réservée aux meilleures correspondances ; le reste va au message système, à la dernière entrée et aux interactions récentes.
La réflexion : apprendre de ses échecs
Reflexion donne à l’agent une habitude d’autocritique. Après chaque tentative ratée, il écrit une brève réflexion sur ce qui n’a pas marché, la range dans une mémoire, puis la relit avant de réessayer. Le modèle n’est jamais réentraîné.
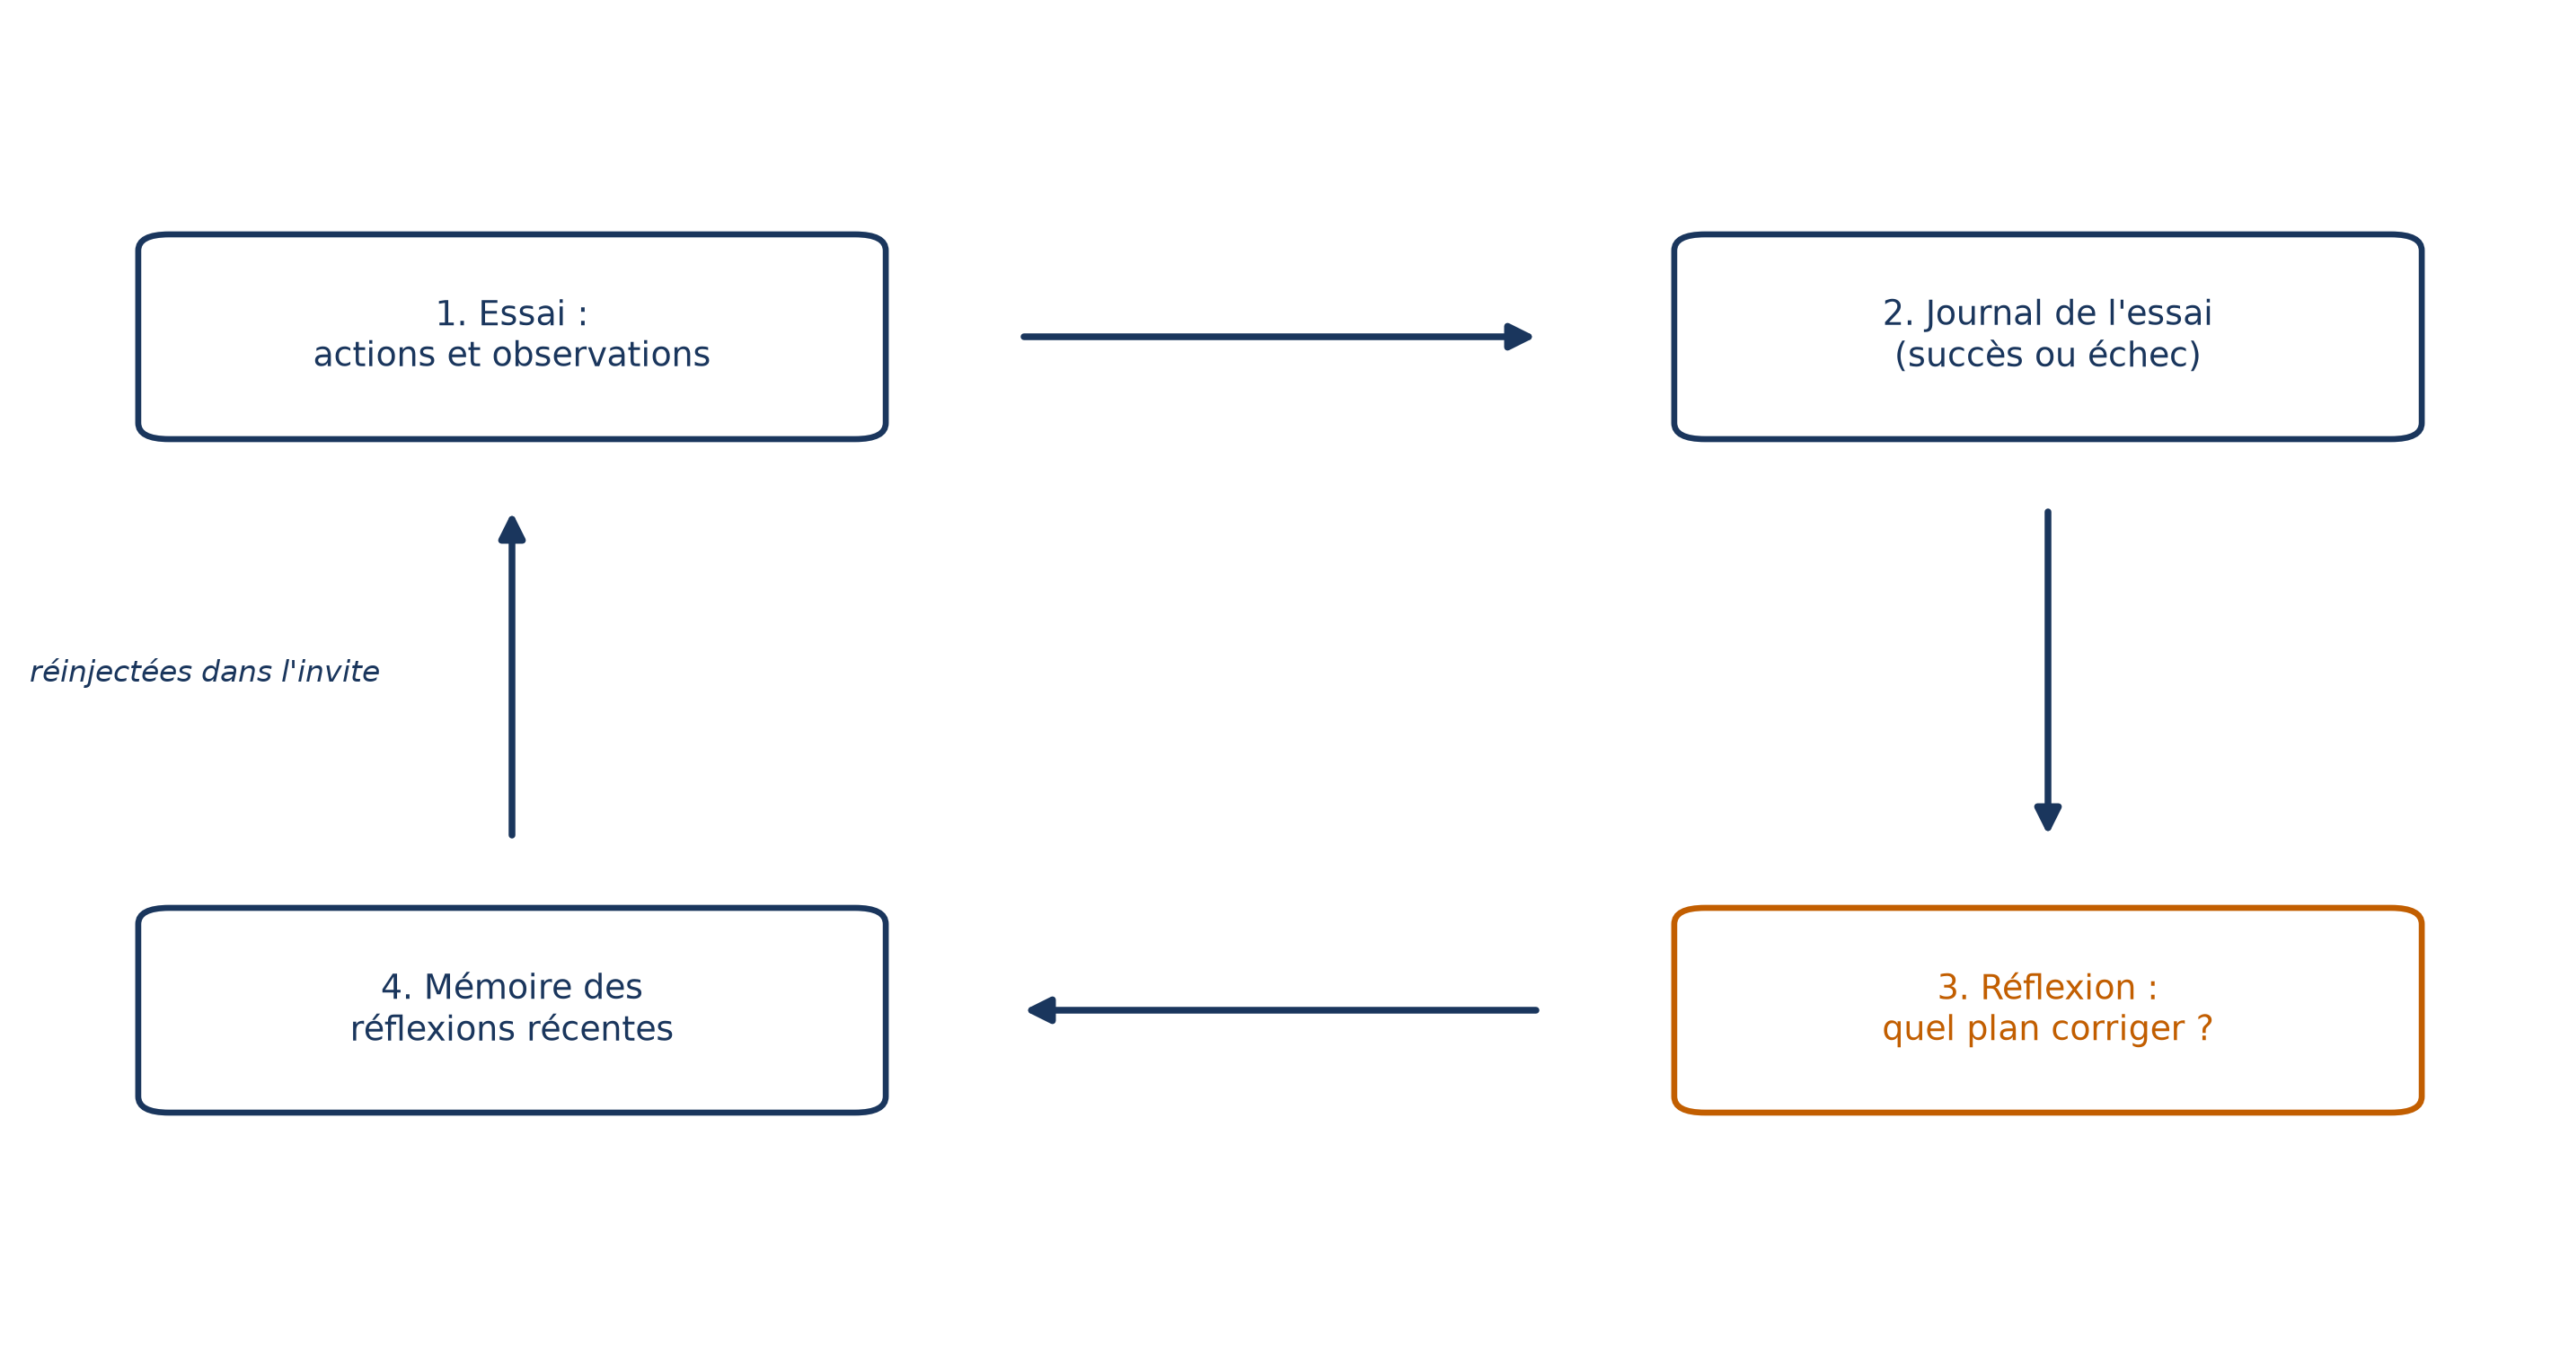
Cet apprentissage n’est pas obligatoire pour concevoir un agent : il exige davantage de conception, d’évaluation et de supervision, et l’investissement vaut ou non le coup selon l’application.
Un agent ou plusieurs ?
La plupart des cas d’usage démarrent avec un seul agent, souvent plus rapide et moins cher, et on n’envisage plusieurs agents que quand la complexité dépasse ce qu’un seul sait faire. Le problème apparaît avec le nombre d’outils : dans l’exemple de chaîne logistique, un agent unique en a seize et sa performance se dégrade à mesure qu’il doit choisir dans un grand ensemble.
Avant de multiplier les agents, on peut d’abord regrouper les outils (sélection hiérarchique) ou utiliser une sélection sémantique via une base vectorielle. Si cela ne suffit pas, on scinde en agents spécialisés, au prix d’une surcharge de coordination.
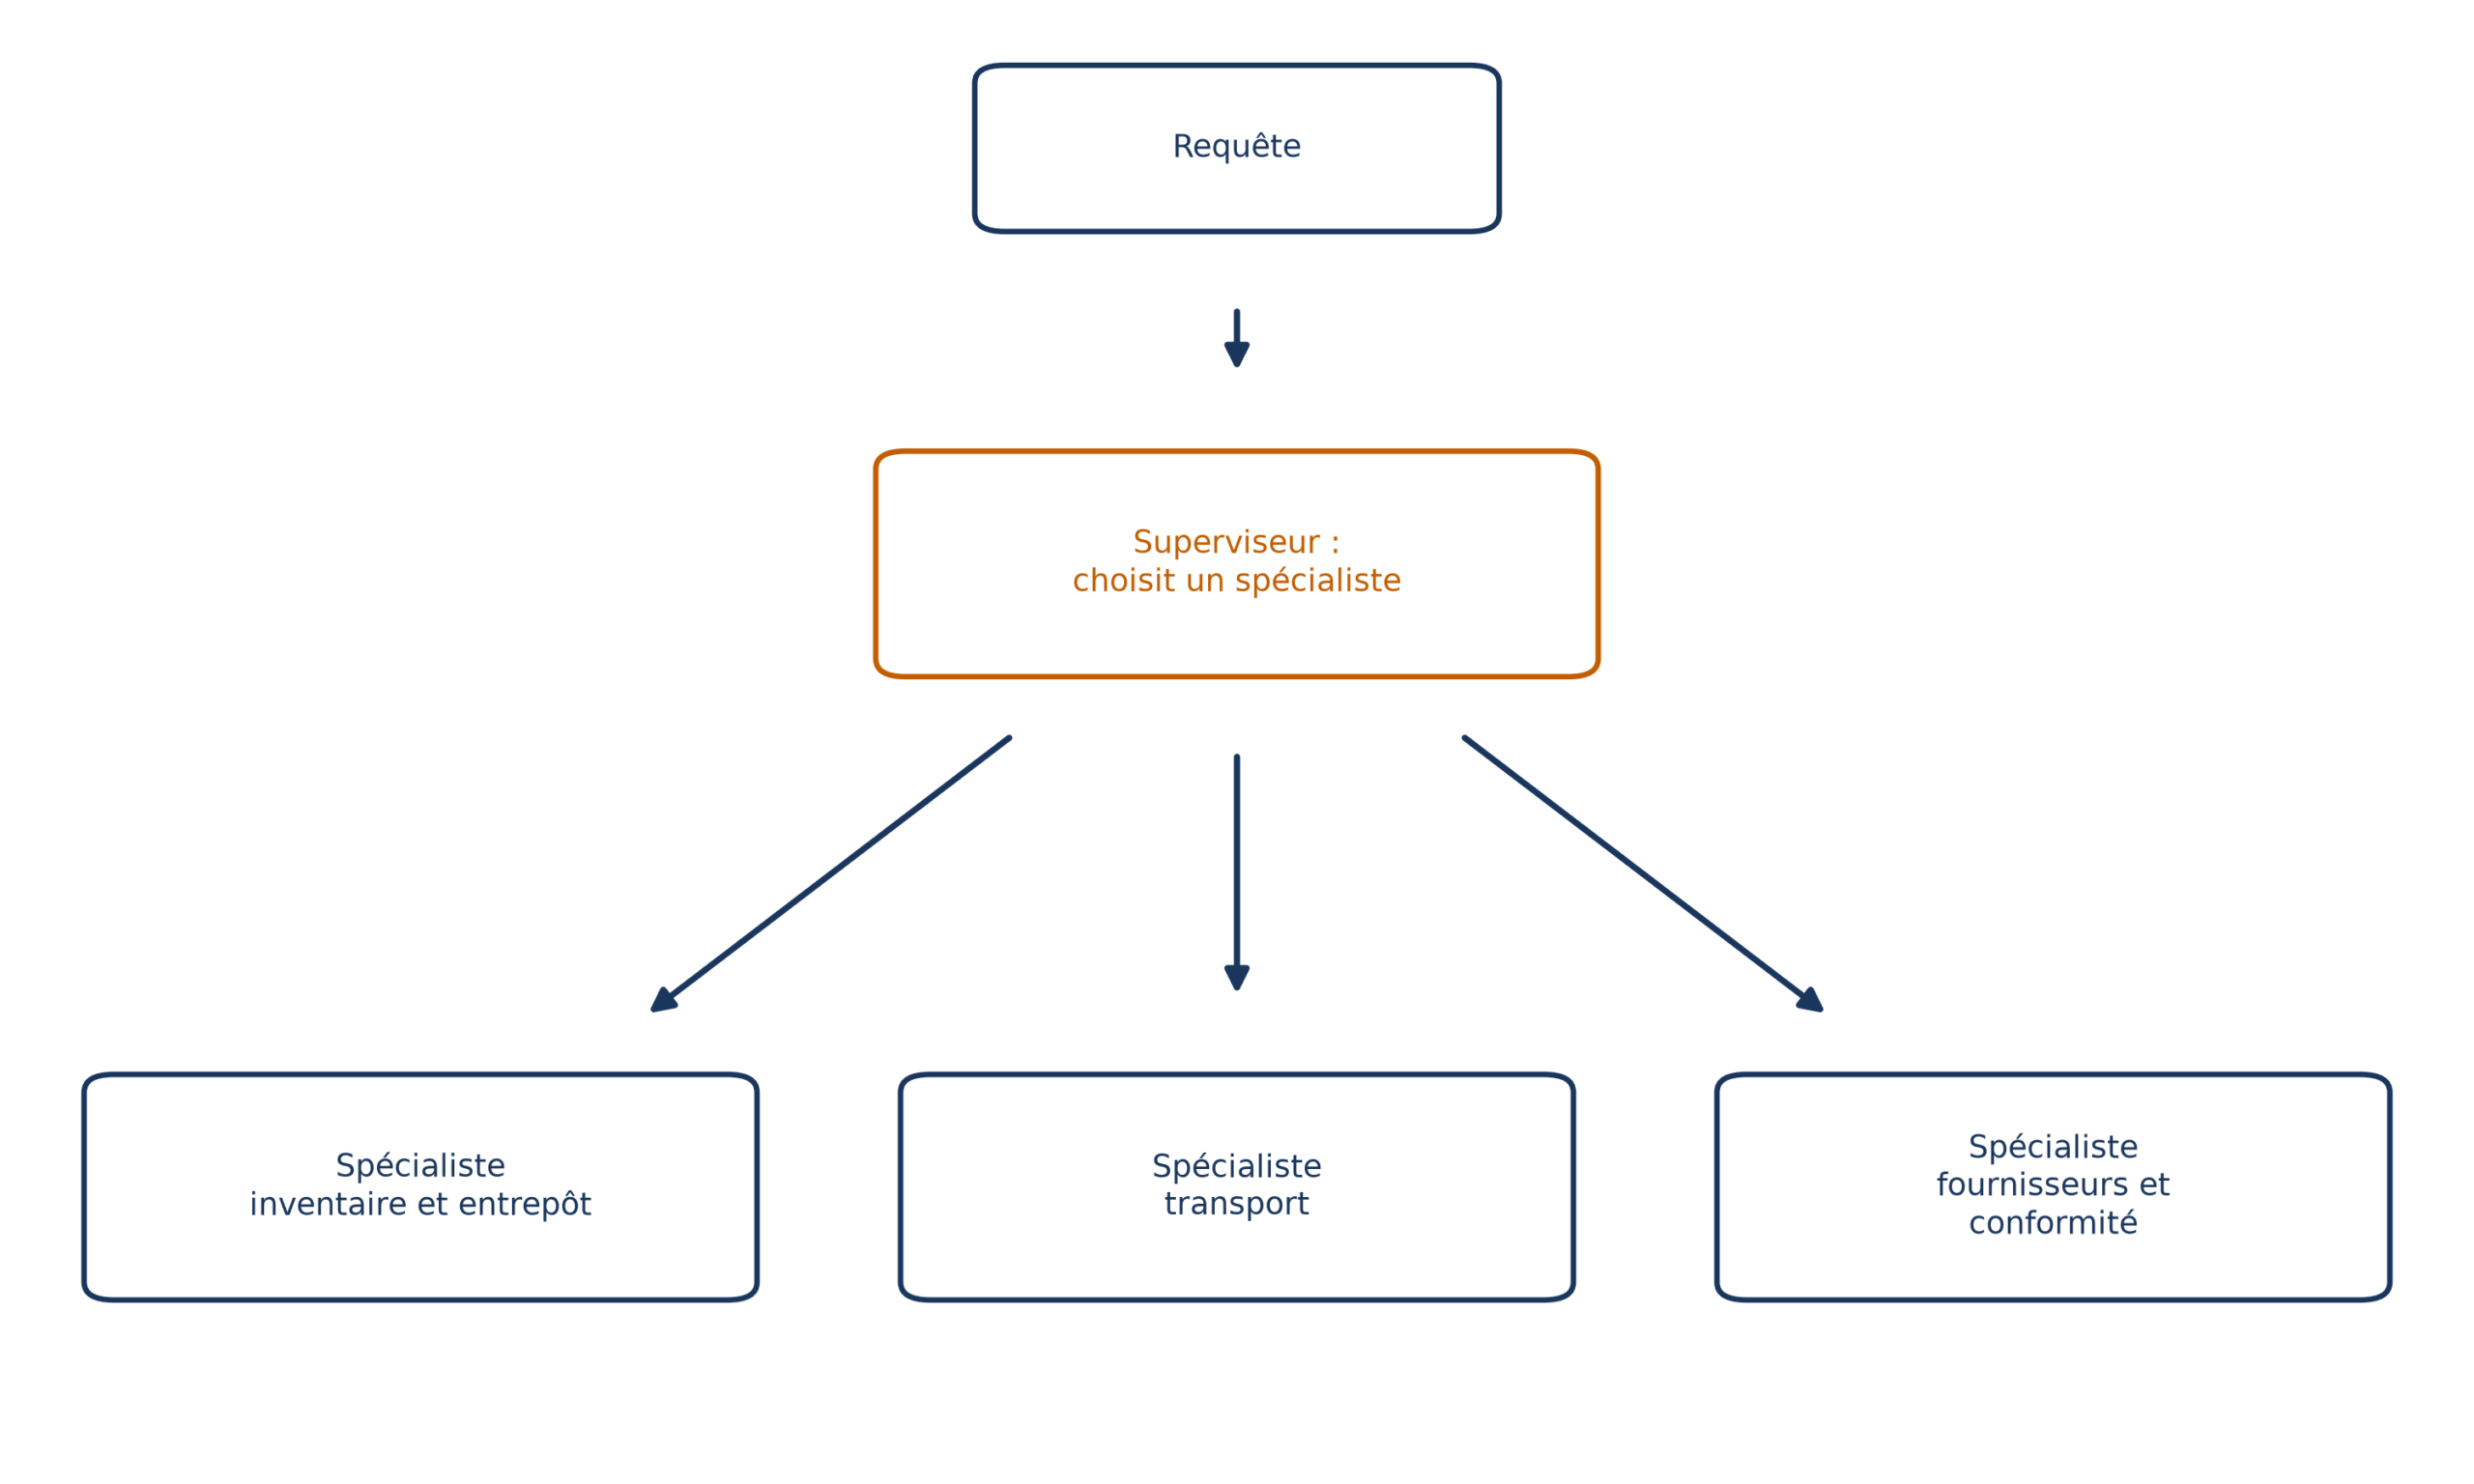
Cinq principes guident chaque ajout d’agent : décomposition, spécialisation, parcimonie, coordination et robustesse. Pèse toujours le coût de l’agent supplémentaire : il ajoute de la communication, de la coordination et de la maintenance.
Pièges et limites
Le RAG agentique surpasse le RAG standard sur la récupération adaptative, les requêtes complexes, l’intégration d’outils et le passage à l’échelle. Mais trois limites reviennent. La précision de sélection d’outils décline quand un même agent doit choisir parmi trop d’options. Aucun agent n’est fiable à 100 %, et les systèmes multiagents cumulent les taux d’erreur. Enfin, une autonomie accrue peut produire des actions non désirées si aucun garde-fou explicite n’existe.
Côté coût, les agents de recherche approfondie combinent plusieurs motifs et payent le prix : nombre d’appels élevé, latence, fragilité vis-à-vis des sources externes. Les agents ReAct offrent une chaîne de pensée qui aide au débogage, mais peuvent augmenter les coûts d’API et le temps de réponse.
⚠️ Piège L’injection d’invite n’est pas théorique. Le chatbot d’un concessionnaire Chevrolet a été manipulé pour proposer un véhicule de 76 000 dollars pour un dollar. Dans les flux multiagents, l’empoisonnement de mémoire fait aussi persister des données contaminées d’un agent à l’autre.
Les risques viennent aussi de l’intérieur : un agent peut mal interpréter un objectif ambigu, et ses sorties, probabilistes par nature, peuvent inclure des hallucinations. Il faut des limites opérationnelles claires, des règles qui valident ses décisions avant exécution, et des stratégies de repli : si une API tombe, l’agent bascule sur des données en cache ou prévient un opérateur.
Enfin, l’humain aussi a ses failles : le biais d’automatisation, où l’on se fie trop aux recommandations de l’agent, et la fatigue d’alerte qui fait rater les avertissements critiques.
Doser l’autonomie
Un outil de conception utile : le curseur d’autonomie, qui laisse l’utilisateur ajuster ce que l’agent peut faire seul, du mode manuel au mode assisté puis au mode agent. Les préférences varient avec la confiance, la familiarité avec la tâche, l’enjeu et la charge de travail.
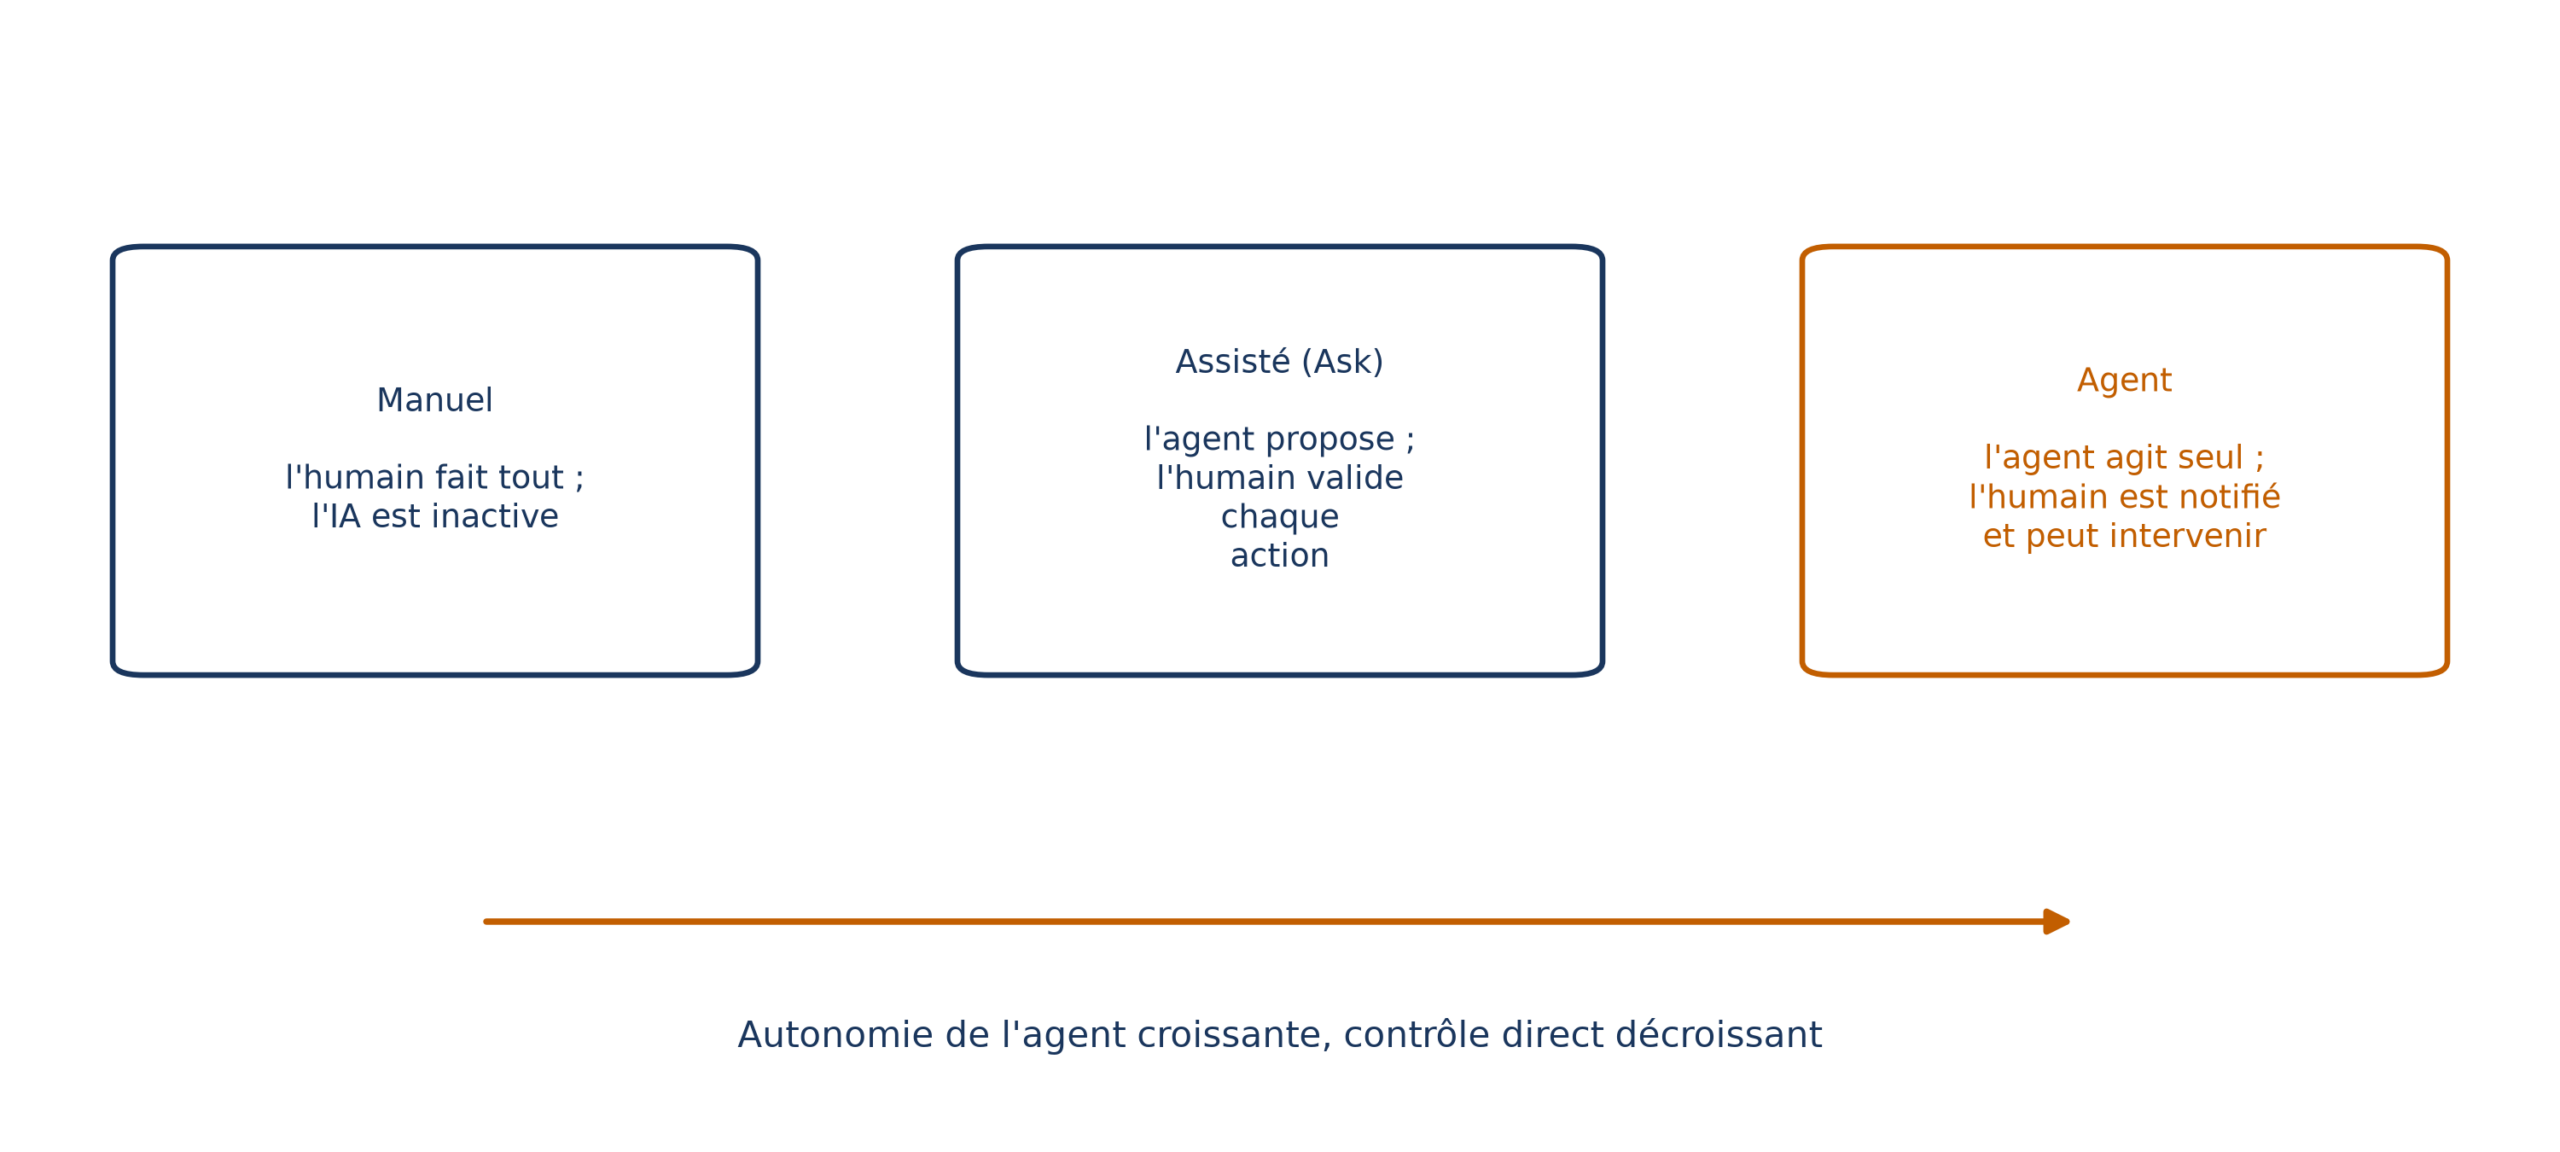
Mis en pratique, cela donne un support client à trois vitesses : en mode assisté, l’agent rédige des réponses que l’opérateur relit avant envoi ; en mode agent, il traite seul les demandes courantes (mot de passe, suivi de commande, FAQ) et n’escalade que les cas sensibles.
Aller plus loin
- Graphe de connaissances : quand l’information est structurée (entités et relations), le RAG par graphe permet un raisonnement multi-sauts, mais sa construction est coûteuse. Ce n’est pas une stratégie par défaut, plutôt une réponse ciblée à un besoin de raisonnement relationnel.
- LangGraph : cadre qui modélise l’application comme un graphe de nœuds et d’arêtes, avec cycles, branches conditionnelles et points de contrôle pour reprendre après un arrêt.
- Orchestration : le rôle de l’orchestrateur est de composer, planifier et superviser les compétences, en surveillant l’avancement et en reroutant le flux si besoin.
- Système multiagent : coordination démocratique, par gestionnaire, hiérarchique ou acteur-critique, avec des protocoles comme A2A pour faire dialoguer des agents hétérogènes.
À retenir
- Choisis la marche la plus basse de l’échelle qui suffit : code, workflow, RAG, puis agent. On ne met un agent que quand la variabilité des entrées l’exige.
- Le couplage tient en trois pièces : un routeur qui choisit l’outil, des retrievers ciblés qui exécutent, une critique qui contrôle.
- Donne à la critique une sortie de secours : « l’information manque » est une réponse valable.
- Teste chaque étape (choix d’outil, contexte, réponse) avec un jeu de cas varié qui inclut des questions sans réponse.
- N’ajoute mémoire, réflexion ou agents supplémentaires qu’en réponse à un problème mesuré, et prévois des garde-fous à chaque niveau d’autonomie.
Questions fréquentes
Faut-il un framework pour construire un système d’agents ?
Non, ces cadres ne sont pas obligatoires : de nombreuses équipes construisent directement sur les API des fournisseurs de modèles. Pour des prototypes, CrewAI ou le kit d’OpenAI démarrent vite ; pour la production, LangGraph et AutoGen apportent plus de contrôle.
Comment valider un changement sans risquer ses utilisateurs ?
Le déploiement fantôme envoie la requête réelle à l’agent de production et à une version candidate dont les résultats sont journalisés sans jamais être servis. Le déploiement canari répartit le trafic réel, par exemple 95 % vers la version de référence et 5 % vers la nouvelle.
À partir de combien d’outils faut-il séparer en plusieurs agents ?
Ce n’est pas une affaire de chiffre magique : la performance d’un agent se dégrade à mesure que le nombre d’outils possibles augmente (ils sont seize dans l’exemple de chaîne logistique). Essaie d’abord le regroupement ou la sélection sémantique, puis seulement la scission en agents.