Tu as une base qui range des films, des personnes et les liens qui les relient. Quelqu’un te demande : « Qui a réalisé le plus de films ? » La réponse n’est écrite nulle part, elle se compte, et pour la tirer de la base il faut une requête précise que presque personne n’a envie de rédiger à la main. Text2cypher confie cette rédaction à un modèle de langage. En fin de lecture, tu sauras ce qu’on lui donne à lire, ce qu’il rend, et pourquoi il se trompe parfois.
Sommaire
- L’essentiel en 30 secondes
- Une traduction, pas une recherche
- Le schéma : la carte que le modèle n’a pas
- Terminologie, exemples, format : trois garde-fous
- Le gabarit assemblé, et ce qu’il produit
- Ce que la traduction rend possible
- Où se range text2cypher
- Ce que text2cypher ne garantit pas
L’essentiel en 30 secondes
- Text2cypher traduit une question en requête Cypher : le modèle écrit la requête, la base de graphe l’exécute.
- Le modèle connaît déjà la syntaxe ; le vrai défi, c’est la justesse de la requête par rapport à la question et au graphe.
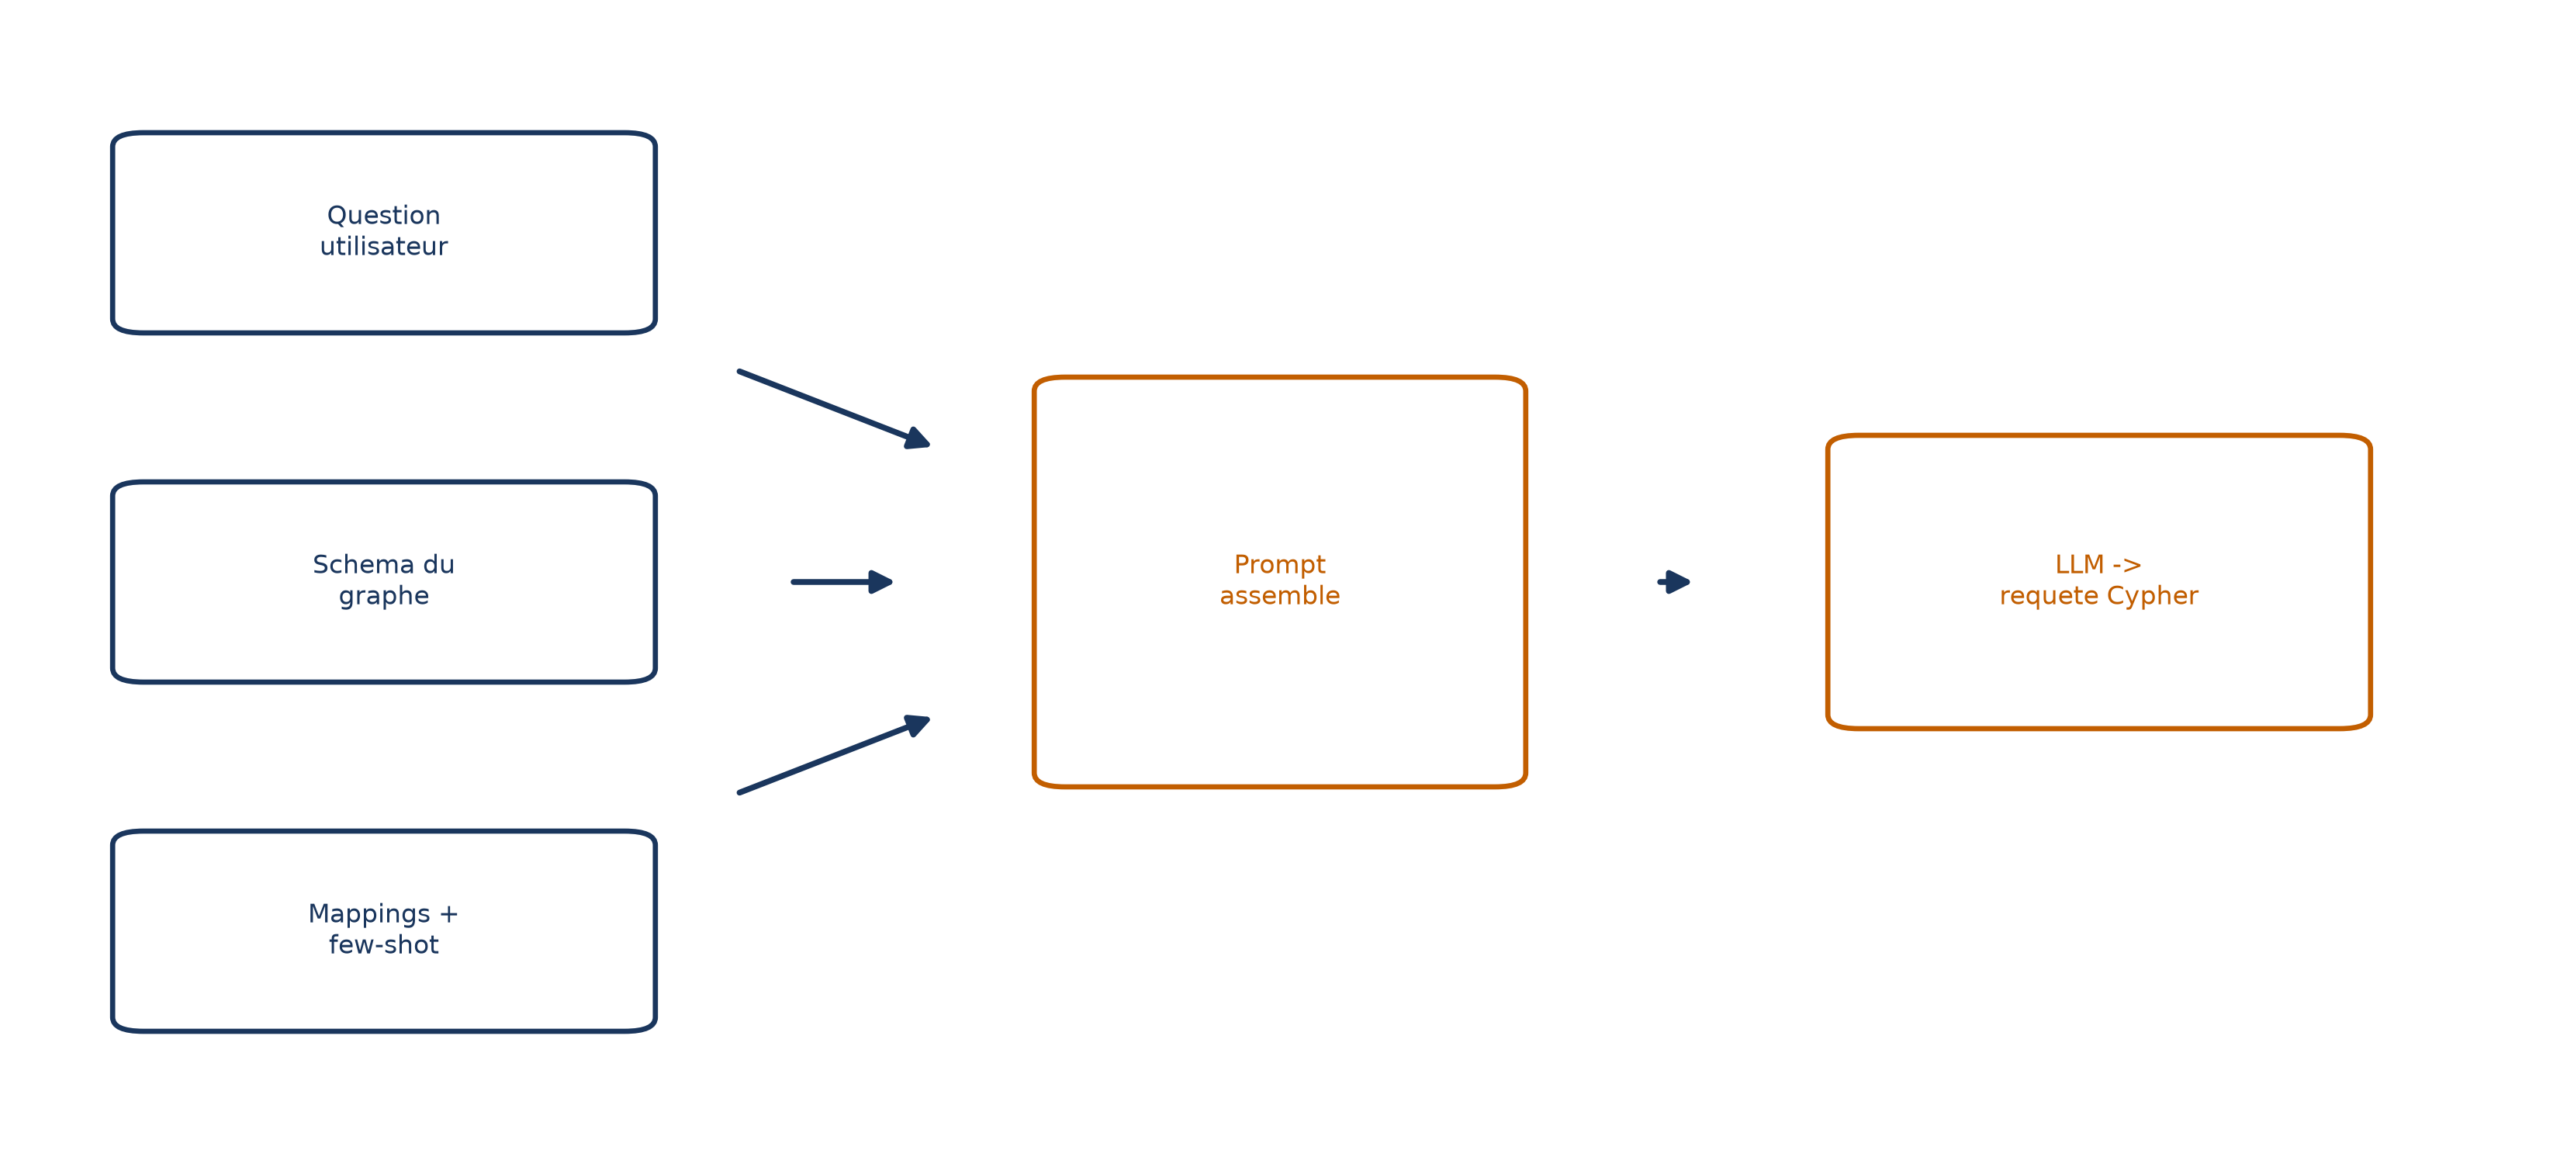
- Le prompt rassemble quatre ingrédients : le schéma du graphe, des correspondances de vocabulaire, des exemples question/requête et des consignes de format.
- Sans schéma, le modèle devine les noms des nœuds, des relations et des propriétés.
- Comptages, classements et parcours de relations deviennent possibles, mais certaines questions restent ratées : un exemple ajouté ou un outil dédié les rattrape.
Une traduction, pas une recherche
Text2cypher consiste à convertir une question en langage naturel en un langage que la base de données sait exécuter : Cypher, le langage des bases de graphe comme Neo4j. Le modèle ne va rien chercher dans la base. Il écrit la requête, et c’est la base qui répond.
Cypher est un langage déclaratif, à la syntaxe simple et lisible. Voici une requête minuscule, pour avoir un point de repère :
MATCH (a:Person)-[:FOLLOWS]->(b:Person)
WHERE a.name = "Alice"
RETURN b.name
Lis-la par ses trois verbes. MATCH décrit la forme que l’on cherche dans le graphe : une personne a reliée à une personne b par une relation FOLLOWS. WHERE fixe que a s’appelle Alice, et RETURN demande le nom de b, c’est-à-dire les personnes qu’Alice suit.
Ce langage n’est pas un dialecte maison : l’initiative openCypher le promeut comme standard d’interrogation des bases de graphe, et il est déjà adopté par Amazon, Memgraph, SAP HANA et d’autres. Un projet de langage officiel unifié, GQL, s’inspire d’ailleurs de Cypher en tête des langages existants.
Reste la difficulté. La plupart des modèles connaissent déjà Cypher et sa syntaxe de base ; le défi est de produire une requête correcte et pertinente, ce qui demande de comprendre la sémantique de la question autant que la structure du graphe interrogé.
Le schéma : la carte que le modèle n’a pas
Sans schéma, le modèle ne peut que deviner les noms des nœuds, des relations et des propriétés. Avec un schéma, il dispose d’une carte qui relie le sens de la question au modèle du graphe : quelles étiquettes existent sur les nœuds, quels types de relations, quelles propriétés, et comment tout cela se connecte.
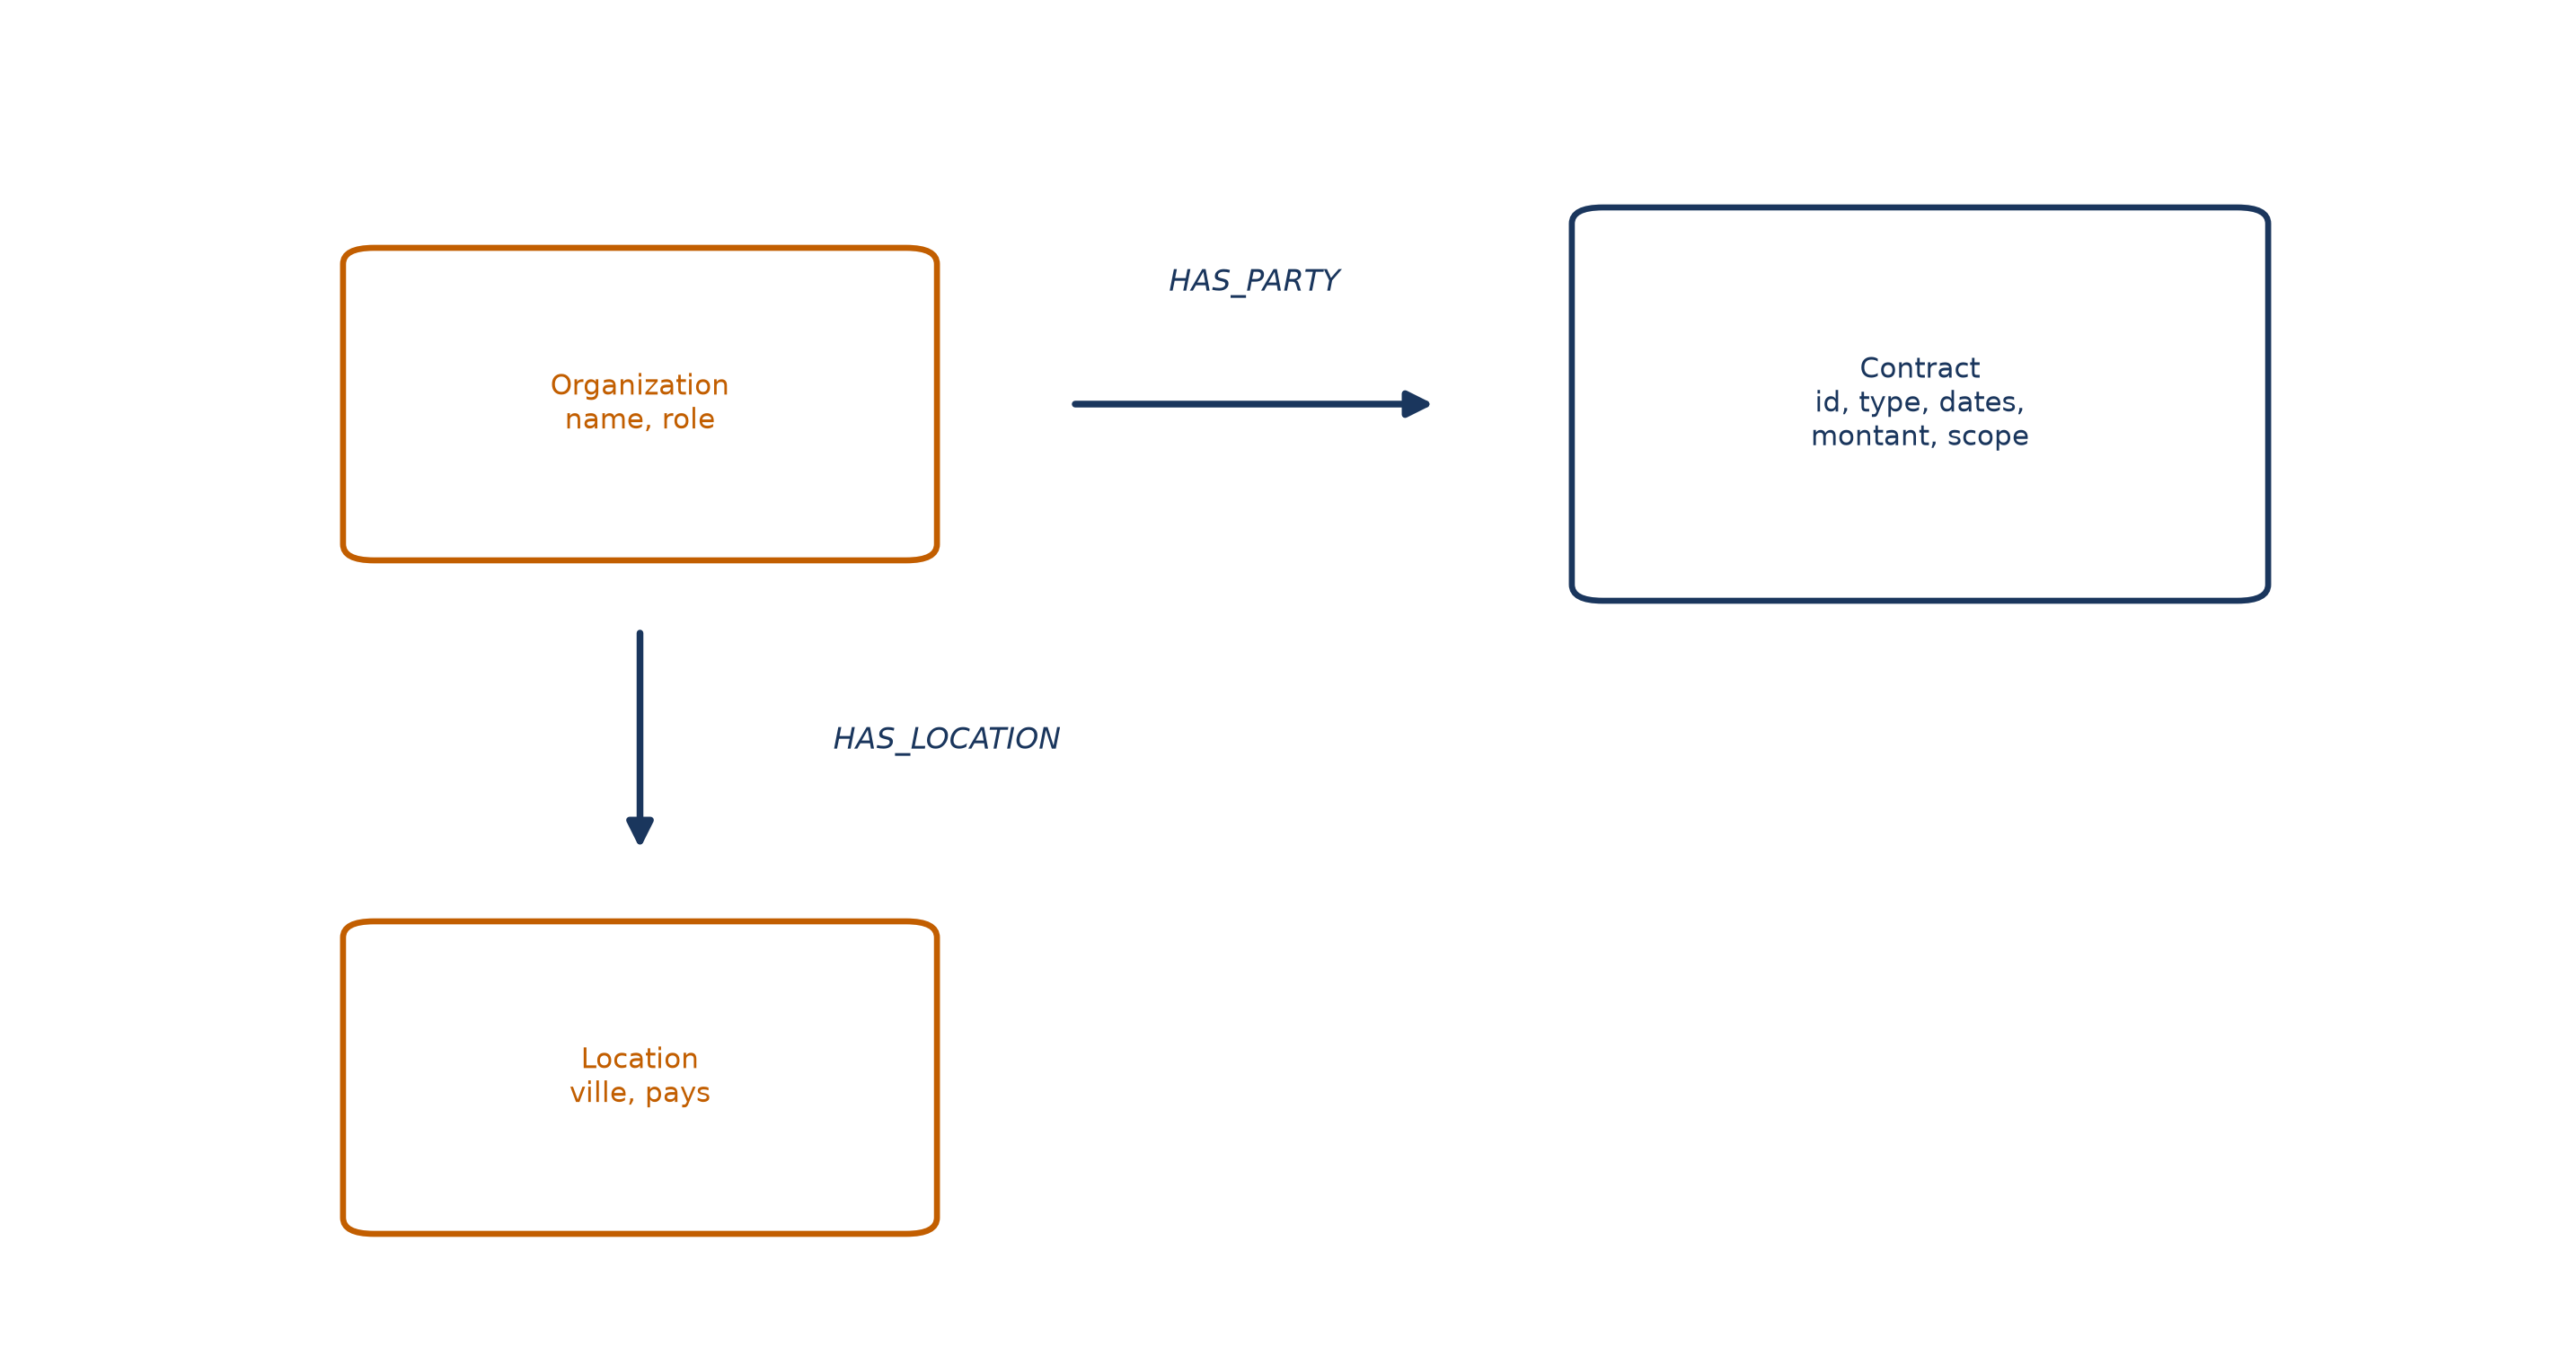
HAS_PARTY ne peut pas en inventer le nom juste.Dans le prompt, ce schéma doit dire clairement quelles étiquettes, quels types de relations et quelles propriétés sont disponibles, avec une consigne explicite : n’utiliser que ces éléments, jamais d’autres. Le format exact importe peu, selon les recherches internes de Neo4j. Tout exposer n’est pas toujours souhaitable : cela dépend de la taille du schéma et de sa pertinence pour le cas d’usage.
On peut aussi laisser la base se décrire elle-même. Sur de gros volumes, l’inférence automatique coûte cher et on échantillonne la base plutôt que de l’analyser entièrement ; elle repose sur la procédure apoc.meta.data() de la bibliothèque APOC, présente en auto-hébergé comme dans Aura.
NODE_PROPERTIES_QUERY = """
CALL apoc.meta.data()
YIELD label, other, elementType, type, property
WHERE NOT type = "RELATIONSHIP" AND elementType = "node"
WITH label AS nodeLabels, collect({property:property, type:type}) AS properties
RETURN {labels: nodeLabels, properties: properties} AS output
"""
REL_PROPERTIES_QUERY = """
CALL apoc.meta.data()
YIELD label, other, elementType, type, property
WHERE NOT type = "RELATIONSHIP" AND elementType = "relationship"
WITH label AS relType, collect({property:property, type:type}) AS properties
RETURN {type: relType, properties: properties} AS output
"""
REL_QUERY = """
CALL apoc.meta.data()
YIELD label, other, elementType, type, property
WHERE type = "RELATIONSHIP" AND elementType = "node"
UNWIND other AS other_node
RETURN {start: label, type: property, end: toString(other_node)} AS output
"""
Trois requêtes, trois questions posées à la base elle-même : quelles propriétés portent les nœuds, quelles propriétés portent les relations, et quels types de nœuds se relient entre eux. Une fonction les exécute puis range les résultats dans un dictionnaire ; une seconde le transforme en texte, avec trois rubriques lisibles (étiquettes de nœuds et propriétés, types de relations et propriétés, liste des relations). Séparer la récupération de la mise en forme permet d’essayer librement plusieurs présentations du schéma dans le prompt.
💡 Intuition Pense à un interprète à qui l’on remet, avant la réunion, le plan du quartier, un petit lexique, deux phrases modèles et une consigne de rendu. Il connaît déjà la langue d’arrivée ; ce qui lui manque, c’est le terrain.
Terminologie, exemples, format : trois garde-fous
Le schéma ne suffit pas toujours. Imagine que le modèle cherche le pays de production d’un film comme s’il s’agissait d’une propriété du nœud Movie, alors que le pays est un nœud à part entière du graphe. La requête s’écrit, elle a l’air plausible, et elle ne trouve rien.
Le remède est un exemple few-shot : quelques paires question/requête que l’on glisse dans le prompt, par opposition au zero-shot où rien n’est donné. Ces exemples sont propres au graphe interrogé et se construisent à la main ; ils servent surtout quand le modèle interprète mal le schéma ou répète la même erreur, par exemple en attendant une propriété là où il faut parcourir une relation.
Question: In what country was the movie Ready Player One produced?
Cypher: MATCH (m:Movie { title: 'Ready Player One' })-[:PRODUCED_IN]->(c:Country)
RETURN c.name
Cet exemple montre le bon chemin : du film vers le pays, en suivant PRODUCED_IN. Il ne corrige pas seulement la question d’origine, mais toute une famille de questions voisines, car le modèle dispose désormais d’un motif à reproduire pour retrouver un nom de pays.
Deuxième garde-fou : traduire le vocabulaire de l’utilisateur vers celui du schéma. Un schéma bien conçu emploie des noms et des verbes pour les étiquettes et les relations, des adjectifs et des noms pour les propriétés, mais le modèle peut malgré tout s’y perdre. Ces correspondances sont propres à chaque graphe et se réutilisent mal d’un graphe à l’autre.
TERMINOLOGY MAPPING:
Persons: When a user asks about a person by trade, they are referring to a node with
the label Person. Movies: When a user asks about a film or movie, they are referring
to a node with the label Movie.
Ce court passage lève l’ambiguïté entre « film » ou « personne » dans la bouche de l’utilisateur et les étiquettes Movie et Person du graphe, sans toucher au reste du prompt.
Troisième garde-fou : la forme de la réponse. Chaque modèle a ses habitudes : certains entourent la requête de balises de code, d’autres ajoutent du texte avant ou après. On uniformise en demandant explicitement la requête et rien d’autre. La dernière consigne de cette instruction, « NO CODE BLOCKS », suffit à éliminer l’essentiel des divergences de mise en forme d’un modèle à l’autre.
FORMAT INSTRUCTIONS:
Do not include any explanations or apologies in your responses. Do not respond to
any questions that might ask anything else than for you to construct a Cypher state-
ment. Do not include any text except the generated Cypher statement. ONLY
RESPOND WITH CYPHER, NO CODE BLOCKS.
Le gabarit assemblé, et ce qu’il produit
Les quatre ingrédients se réunissent dans un seul gabarit de prompt. Le texte est en anglais ; repère les emplacements entre accolades, que le code remplit avant l’envoi.
prompt_template = """
Instructions:
Generate Cypher statement to query a graph database to get the data to answer
the following user question.
Graph database schema:
Use only the provided relationship types and properties in the schema.
Do not use any other relationship types or properties that are not provided in
the schema.
{schema}
Terminology mapping:
This section is helpful to map terminology between the user question and the
graph database schema.
{terminology}
Examples:
The following examples provide useful patterns for querying the graph database.
{examples}
Format instructions:
Do not include any explanations or apologies in your responses.
Do not respond to any questions that might ask anything else than for you to
construct a Cypher statement.
Do not include any text except the generated Cypher statement.
ONLY RESPOND WITH CYPHER--NO CODE BLOCKS.
User question: {question}
"""
Chaque rubrique du gabarit correspond à un ingrédient : le schéma (avec la consigne de s’en tenir à ce qu’il contient), la table de terminologie, les exemples, le format, puis la question de l’utilisateur en dernier. Sur la base de films, avec le vrai schéma, une correspondance de vocabulaire et un exemple, la question du début, « Who directed the most movies ? », produit ceci :
MATCH (p:Person)-[:DIRECTED]->(m:Movie)
RETURN p.name, COUNT(m) AS movieCount
ORDER BY movieCount
DESC LIMIT 1
Lis la requête dans l’ordre. Elle cherche des personnes reliées à des films par DIRECTED, compte les films de chacune (COUNT(m)), trie du plus grand total au plus petit et garde la première ligne. La requête parcourt la relation DIRECTED au lieu de chercher une propriété qui n’existe pas, et c’est exactement ce que les éléments de contexte du prompt permettent.
Ce que la traduction rend possible
Les deux requêtes vues jusqu’ici montrent deux gestes différents. L’une calcule : compter, trier, retenir un maximum. L’autre suit un lien jusqu’à un autre nœud : du film vers son pays. Dans les deux cas, la réponse est un chemin dans le graphe ou un calcul sur des chemins, pas un passage de texte à retrouver.
LangChain emballe ce geste en quelques lignes. Ici, une chaîne combine un modèle et un graphe existant, puis répond à une question posée telle quelle.
from langchain.chains import GraphCypherQAChain
graphchain = GraphCypherQAChain.from_llm(
    llm, graph=graph, verbose=True, return_intermediate_steps=True
)
results = graphchain.invoke({"query":"People who have kids"})
print(results["result"])
llm est le modèle de langage et graph la connexion au graphe de connaissances déjà construit. La question « People who have kids » entre en langage naturel ; la chaîne génère la requête Cypher correspondante, l’exécute sur le graphe et rend le résultat. Tu écris en langage courant, un modèle écrit en Cypher.
Où se range text2cypher
Autour d’un graphe, d’autres moyens d’aller chercher l’information existent. Une recherche vectorielle sur un index, une recherche locale qui élargit le contexte à partir d’entités proches : leur requête Cypher est écrite une fois pour toutes, et seuls ses paramètres changent d’un appel à l’autre (le nombre de résultats voulu, le vecteur de la question, les plafonds à retenir). Avec text2cypher, la requête naît au moment de la question. C’est ce qui le rend souple, et ce qui le rend moins prévisible.
Côté modèle, un modèle généraliste bien guidé par un prompt structuré suffit pour démarrer. Il existe aussi des modèles spécialisés : un jeu de données d’entraînement ouvert est disponible sur Hugging Face, et des modèles en ont été ajustés à partir de Gemma2 ou de Llama 3.1. Ils restent derrière les plus grands modèles propriétaires ajustés, mais coûtent bien moins à exécuter, un atout quand la latence des gros modèles devient un problème en production.
Ce que text2cypher ne garantit pas
« Le modèle connaît Cypher, la requête sera donc bonne »
Connaître la syntaxe et comprendre ton graphe sont deux choses distinctes. La syntaxe de base est acquise pour la plupart des modèles ; ce qui reste à leur charge, c’est la justesse, et elle dépend de ce que tu mets dans le prompt. L’exemple du pays de production le montre : une requête syntaxiquement irréprochable peut viser une propriété qui n’existe pas.
« Une base de graphe, donc toute question trouve sa requête »
Pas toujours. Dans une évaluation sur la base de films, le système échoue sur « Who has the longest name among all actors ? » faute de générer la requête appropriée. Deux remèdes sont proposés : un exemple few-shot qui guide la génération, ou un outil dédié à ce type de question.
Pour repérer ces échecs, il vaut mieux noter les questions de test avec une requête Cypher de référence plutôt qu’avec une réponse figée. La requête de référence reste valable quand les données évoluent, alors qu’une réponse écrite à la main devient fausse.
« Traduire ne coûte rien »
Chaque traduction est un appel de plus à un modèle de langage. Dans la même évaluation, les questions qui peuvent s’en passer reviennent nettement plus vite : on économise un passage par le modèle. Text2cypher se justifie donc là où une requête précise est indispensable, pas partout.
📌 À retenir Un modèle de langage ne cherche rien dans le graphe : il rédige la requête qui ira chercher. Sa fiabilité se construit avec ce qu’on lui donne : le schéma d’abord, puis le vocabulaire, les exemples et le format.