Un hôpital suit des patients après un traitement. Au bout de quelques mois, certains sont toujours en vie, un autre a déménagé et ne répond plus au téléphone. Comment exploiter ces situations, où l’on ne connaît pas la fin de l’histoire ? Le modèle de Cox répond à cette question en décrivant un risque à chaque instant, plutôt qu’une durée de vie.
Sommaire
- L’essentiel en 30 secondes
- Pourquoi une régression classique ne suffit pas
- Le risque instantané, la pièce centrale
- Pas de forme à fixer : un modèle semi-paramétrique
- À quoi ça sert, face à la courbe de Kaplan-Meier
- Le lire en Python : l’exemple des patients atteints d’une tumeur
- Ce qu’il ne dit pas : trois idées reçues
- Sa place parmi les méthodes voisines
L’essentiel en 30 secondes
- Le modèle de Cox décrit un risque instantané, pas une date : à chaque instant, quelle est la chance que l’événement survienne ?
- Il multiplie un risque de base commun à tous par un facteur propre à chaque individu.
- Il n’impose aucune forme précise au risque de base, ce qui le rend semi-paramétrique.
- Il exploite les observations censurées au lieu de les écarter.
- Il estime plusieurs variables à la fois, là où Kaplan-Meier reste descriptif.
Pourquoi une régression classique ne suffit pas
Si l’on voulait prédire la durée de vie, une régression classique prendrait le temps observé comme réponse. Le problème : pour une partie des patients, le temps réel reste inconnu. L’étude s’est terminée, ou la personne a quitté le suivi, et l’on sait seulement que l’événement n’a pas eu lieu avant cette date. Cette information partielle s’appelle la censure, et c’est elle qui distingue fondamentalement l’analyse de survie de la régression classique.
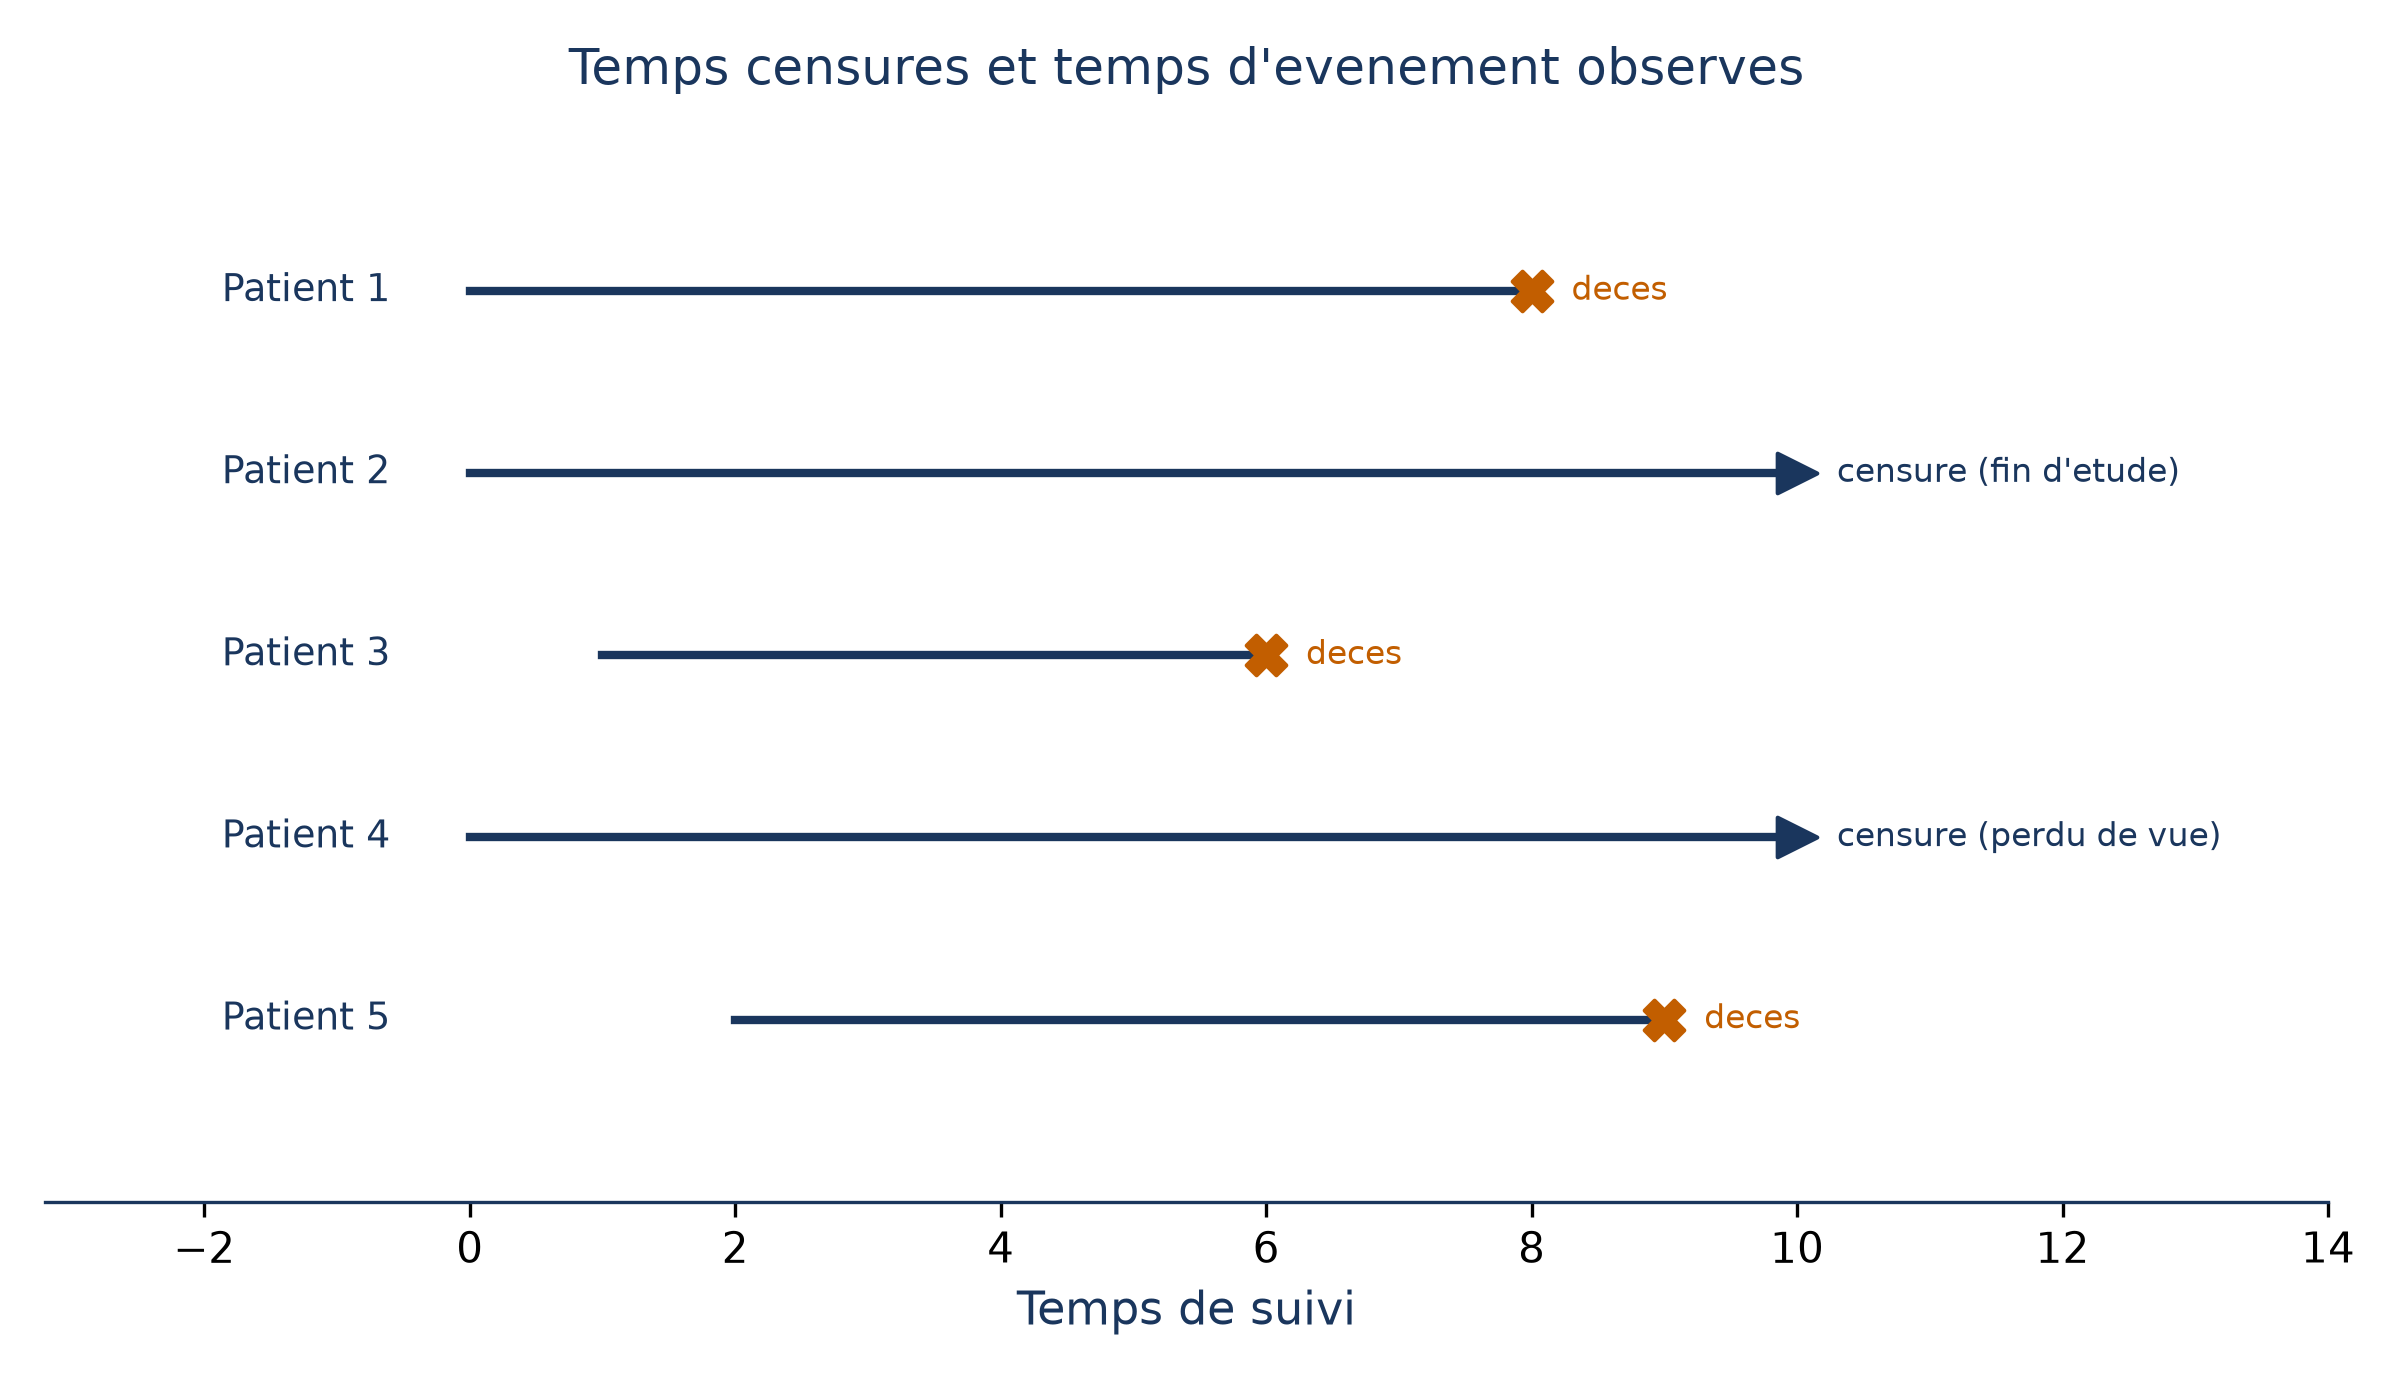
💡 Intuition Un patient censuré est un témoin partiel : on sait qu’il a tenu jusqu’à une certaine date, mais pas ce qui s’est passé ensuite.
Le risque instantané, la pièce centrale
Plutôt que de demander à quel moment l’événement arrive, le modèle de Cox regarde le risque instantané : le taux auquel il survient à l’instant  , sachant qu’il ne s’est pas produit jusque-là. Pour un individu
 qui porte des caractéristiques
 , le modèle écrit :
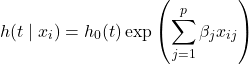
Le membre de droite se lit en deux morceaux. Le facteur  est le risque de base : il évolue avec le temps, et il est le même pour tout le monde. Le facteur exponentiel, lui, ne dépend pas du temps : il ne contient que les caractéristiques de l’individu, pondérées par des coefficients
 que le modèle apprend.
Le modèle ne fait donc que multiplier le risque de base par un facteur personnel. Sa force tient à ce qu’il n’exige jamais de fixer la forme exacte de : ce risque commun reste libre, et seule la partie individuelle est modélisée.
Pas de forme à fixer : un modèle semi-paramétrique
Le modèle de Cox se place à mi-chemin entre deux familles. Un modèle entièrement paramétrique impose une forme précise au risque. Une approche non paramétrique comme la courbe de Kaplan-Meier n’en impose aucune, mais ne sait pas gérer plusieurs variables à la fois. Le modèle de Cox ne fixe que la partie qui dépend des caractéristiques : c’est un modèle semi-paramétrique.
Comment estimer les coefficients sans connaître  ? Par la vraisemblance partielle. À chaque instant où un événement est observé, on compare l’individu concerné à tous ceux qui sont encore à risque à cet instant. Dans cette comparaison, le risque de base disparaît, et les coefficients restent.
À quoi ça sert, face à la courbe de Kaplan-Meier
La courbe de Kaplan-Meier estime la fonction de survie 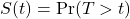 sans rien supposer. Elle avance pas à pas : à chaque événement observé, elle recalcule la proportion de survivants parmi ceux encore à risque, censure comprise. Elle décrit, et on l’obtient souvent groupe par groupe.
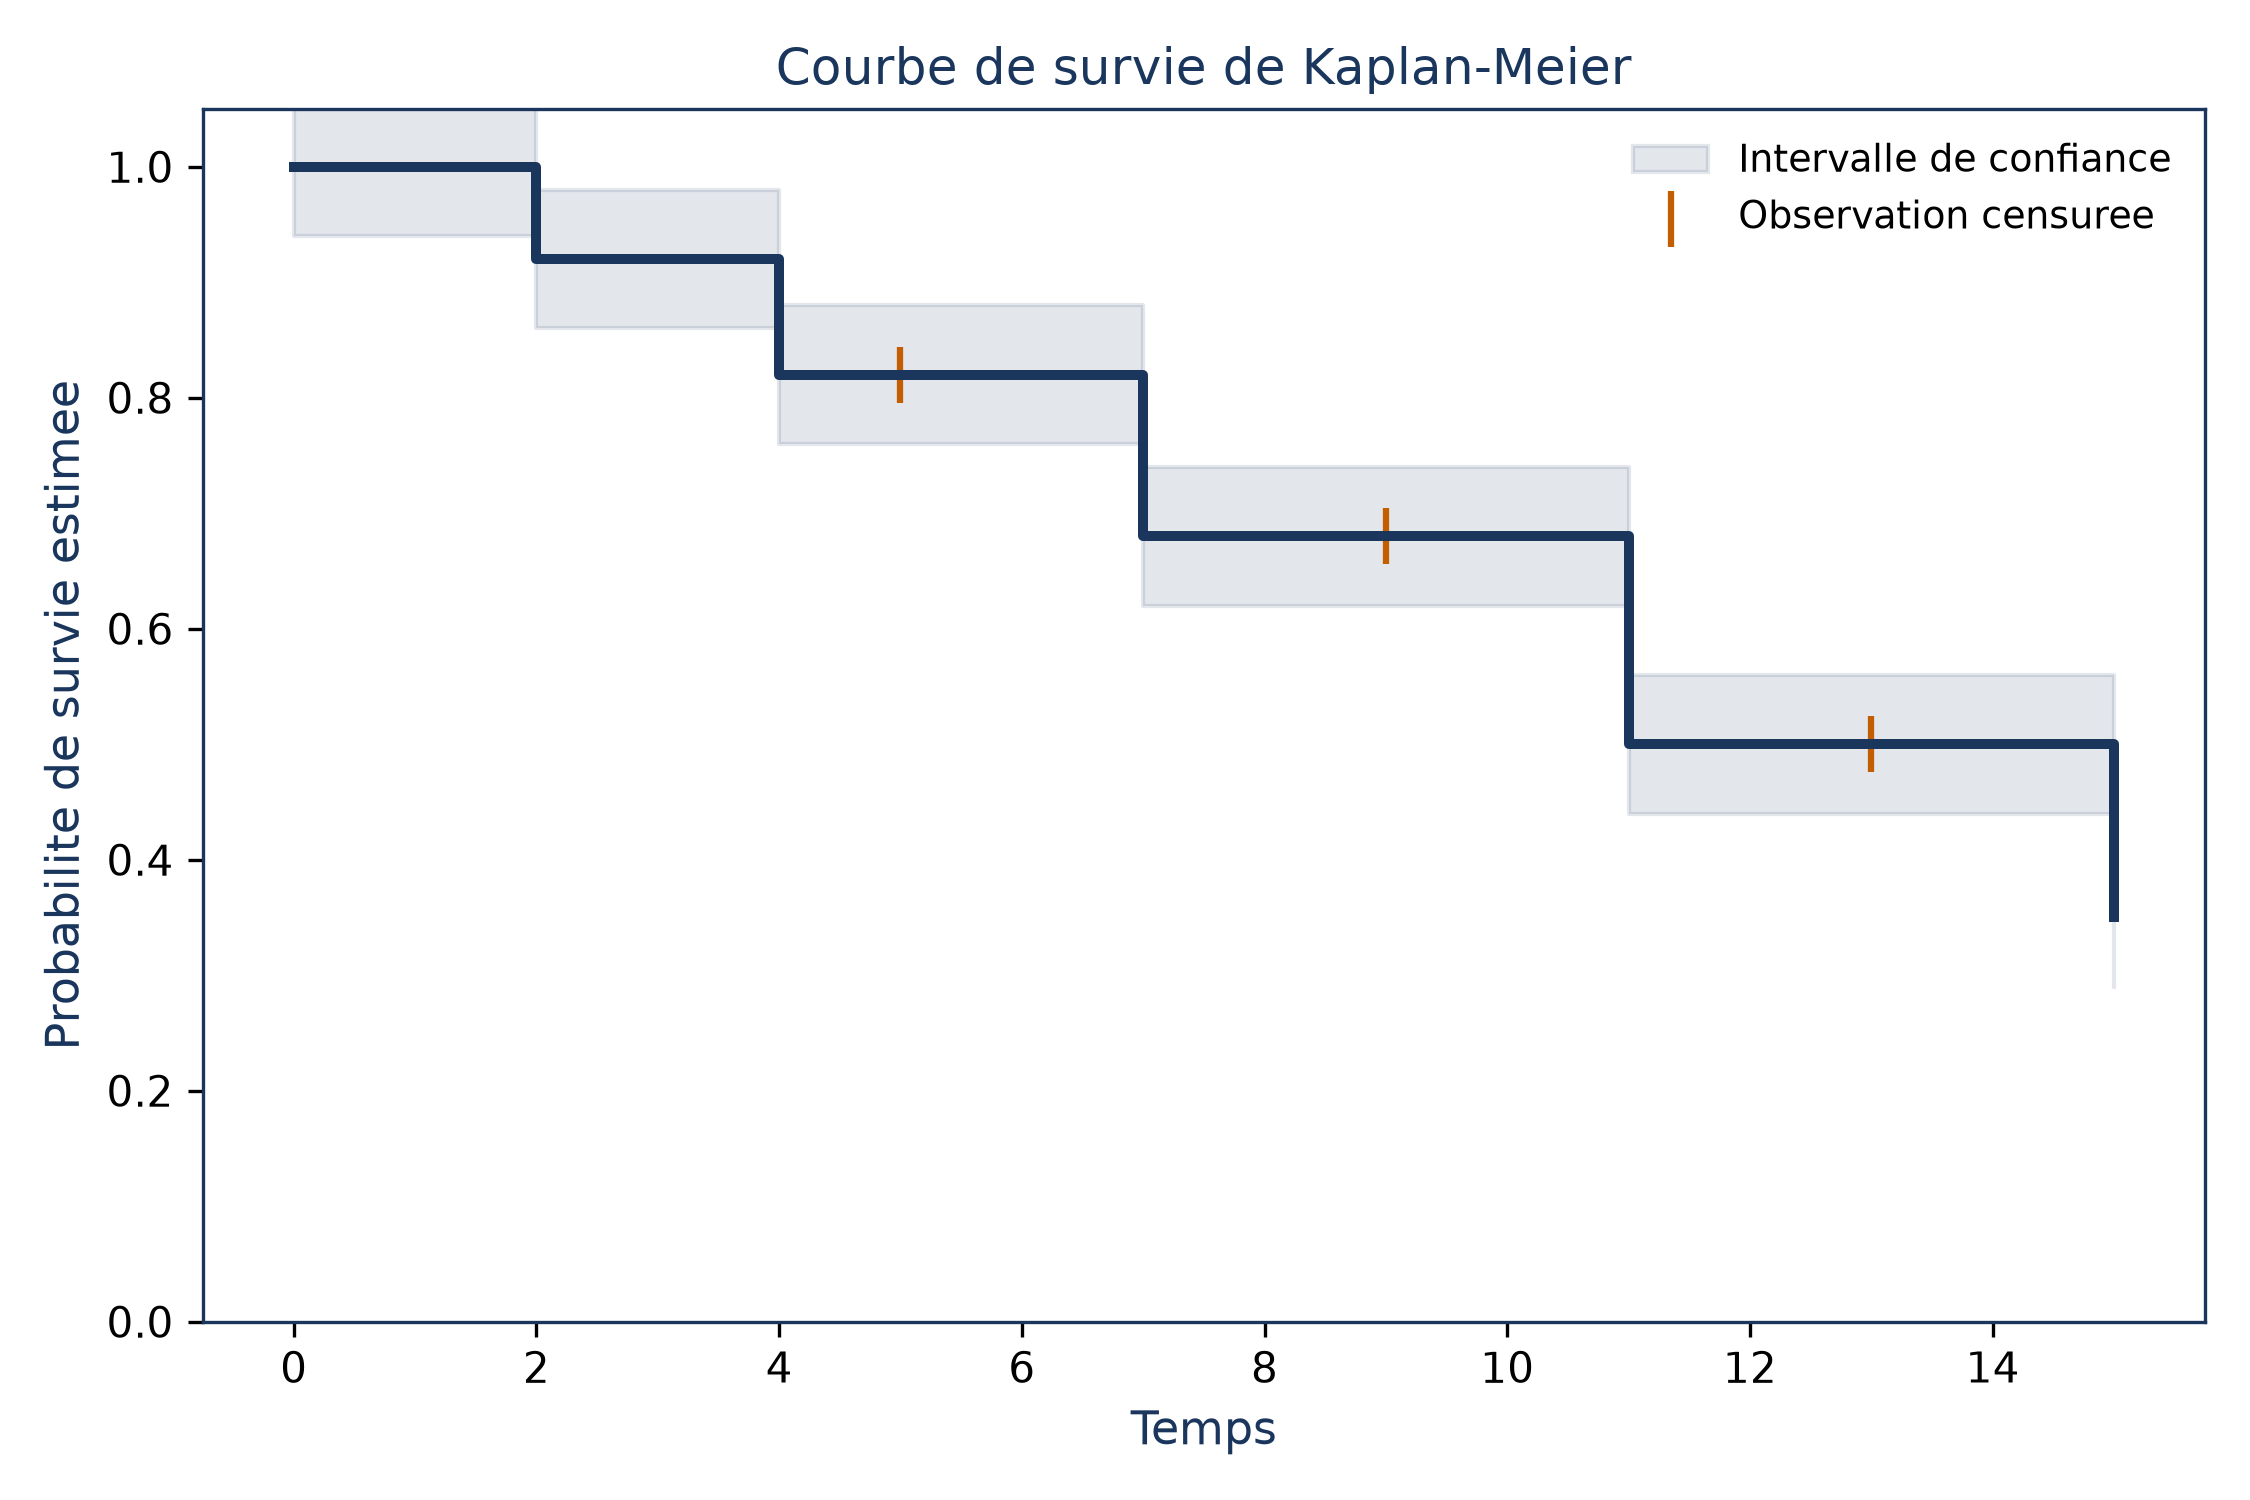
Il existe un lien remarquable avec le test du log-rank. Sur des données où la censure est rare et avec un seul prédicteur binaire, le test de Cox et le log-rank concluent presque de la même façon : deux approches en apparence distinctes, l’une descriptive et l’autre fondée sur un modèle, arrivent alors au même verdict.
Le même outillage sert bien au-delà de la médecine : une pièce mécanique qui tombe en panne, un abonnement qu’on résilie, sont des situations où l’on observe un temps jusqu’à un événement, parfois censuré.
Le lire en Python : l’exemple des patients atteints d’une tumeur
Le jeu de données BrainCancer suit des patients traités pour une tumeur cérébrale. Pour chacun, on a un temps de suivi et un indicateur de statut qui dit si ce temps correspond à un décès ou à une censure. Le code commence par charger ces données.
In [3]: BrainCancer = load_data('BrainCancer')
Avec le paquet lifelines, le modèle de Cox s’ajuste en quelques lignes, après avoir transformé la colonne sex en variables numériques. CoxPHFitter est la classe de lifelines qui ajuste le modèle, et MS l’alias de ModelSpec, qui transforme la table en matrice de modèle :
In [17]: coxph = CoxPHFitter
         sex_df = BrainCancer[['time', 'status', 'sex']]
         model_df = MS(['time', 'status', 'sex'],
                         intercept=False).fit_transform(BrainCancer)
         cox_fit = coxph().fit(model_df,
                                  'time',
                                  'status')
         cox_fit.summary[['coef', 'se(coef)', 'p']]
Dans fit, le temps et le statut sont lus comme la réponse ; les autres colonnes sont les prédicteurs. Le tableau summary affiche pour chaque variable un coefficient coef, son erreur type se(coef) et une p-valeur p. Le coefficient se traduit en risque relatif plutôt qu’en effet moyen sur une valeur.
Ce qu’il ne dit pas : trois idées reçues
« Il faut connaître le risque de base pour s’en servir »
Non. Le risque de base n’est pas spécifié, et les coefficients s’estiment sans lui, par la vraisemblance partielle.
« Les patients sortis du suivi n’apportent rien »
C’est l’erreur la plus coûteuse. Ceux qui restent le plus longtemps sont justement les plus susceptibles d’être censurés : les écarter sous-estime la survie réelle.
⚠️ Piège Une censure n’est pas une donnée manquante qu’on peut ignorer : elle porte une information partielle, que le modèle exploite.
« Le rapport des risques peut varier sans conséquence »
Le modèle suppose que le rapport des risques entre deux individus reste constant dans le temps. C’est une hypothèse à vérifier, pas un acquis. Une caractéristique qui change au cours du suivi, comme une mesure répétée, peut tout de même entrer dans le modèle, moyennant quelques aménagements.
Sa place parmi les méthodes voisines
Le modèle de Cox n’est pas isolé. Les méthodes de régularisation vues pour la régression linéaire s’y appliquent telles quelles : la pénalité lasso peut y sélectionner un sous-ensemble de prédicteurs.
Pour comparer deux modèles de survie, la mesure habituelle des classifieurs ne suffit pas, car la réponse est censurée. Le C-index joue ce rôle : il généralise l’aire sous la courbe ROC à ce cas.
📌 À retenir Le modèle de Cox garde le temps en tête sans le dire : il raisonne en risque à chaque instant, et il tire parti des patients sortis du suivi avant la fin.