Garde seulement une trentaine de valeurs singulières d’une image, et elle redevient presque indiscernable de l’originale ; avec trois, l’essentiel des détails a disparu. Pose maintenant la même question à la correction qu’il faut apporter aux poids d’un grand modèle : de combien de nombres a-t-elle vraiment besoin ? LoRA répond « très peu », et tout son principe tient dans ce pari. Quand tu auras tout lu, « faible rang » n’aura plus de mystère pour toi et une configuration LoRA se lira ligne par ligne.
Sommaire
- L’essentiel en 30 secondes
- Le rang d’une matrice : sa part d’information indépendante
- Trente valeurs pour toute une image : la compression par SVD
- LoRA applique ce pari à la correction des poids
- Lire une configuration LoRA ligne par ligne
- LoRA ne décide pas de l’objectif d’entraînement
- Où vit la partie entraînée : LoRA, adaptateurs, préfixes
- Ce que LoRA ne fait pas
L’essentiel en 30 secondes
- LoRA (Low-Rank Adaptation) n’entraîne qu’une correction ajoutée aux poids gelés du modèle, jamais les poids eux-mêmes.
- Cette correction s’écrit comme le produit de deux petites matrices, A et B, de rang faible.
- Le pari ressemble à celui de la compression d’image : peu de composantes suffisent à restituer l’essentiel.
- En code, tout se règle dans une configuration courte où le rang r et les matrices ciblées comptent le plus.
- LoRA ne change pas l’architecture du modèle : seul son comportement bouge.
Le rang d’une matrice : sa part d’information indépendante
Une matrice est un tableau de nombres, mais toutes ses colonnes ne disent pas des choses différentes. Si la troisième colonne d’un tableau n’est que la somme des deux premières, elle n’apprend rien de neuf : on dit qu’elle est linéairement dépendante des autres.
Le nombre maximal de colonnes linéairement indépendantes s’appelle le rang de la matrice. Il ne dépasse jamais la plus petite de ses deux dimensions, et il mesure en quelque sorte la quantité d’information réellement indépendante qu’elle contient. Retiens une conséquence : une matrice très étroite, avec peu de colonnes, est forcément de rang faible.
Pour voir ce rang à l’œuvre, il existe un outil : la décomposition en valeurs singulières, ou SVD. Toute matrice  de taille
 peut s’écrire
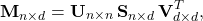
où  et
 sont des matrices orthogonales et
 une matrice diagonale. Les éléments de , les valeurs singulières, sont rangés par ordre décroissant, et leur nombre non nul égale le rang de .
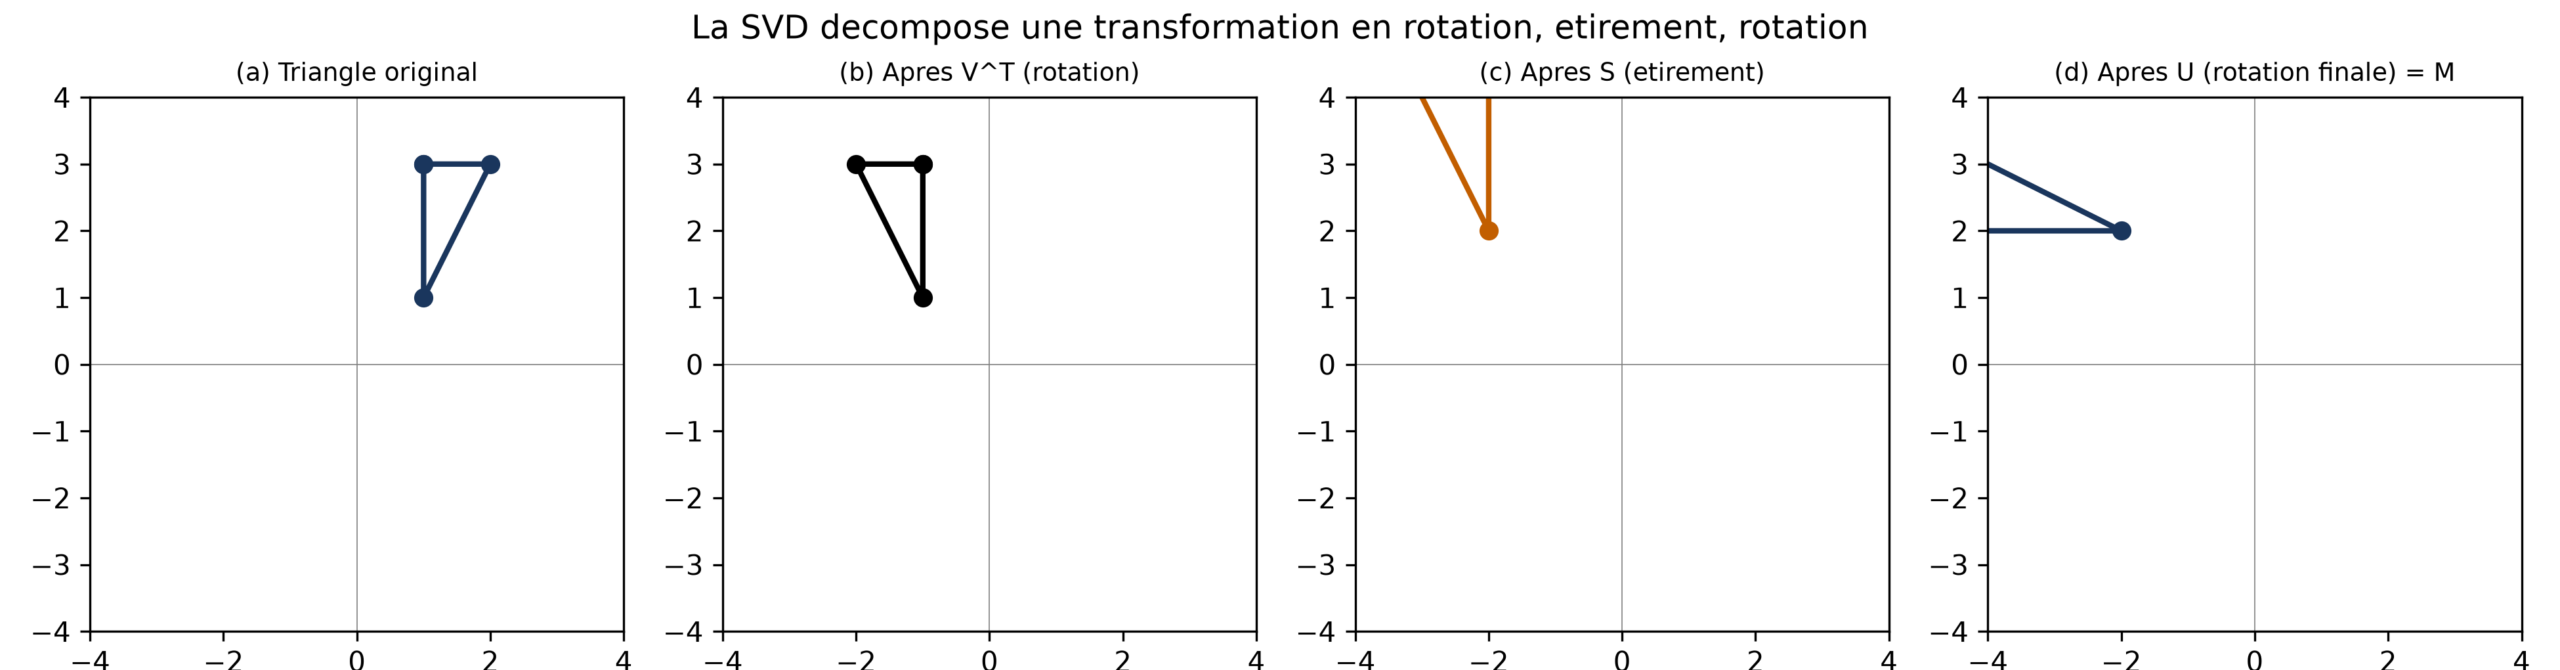 l’écrase presque en un segment quasi vertical, avant une dernière rotation. Toute transformation linéaire se découpe ainsi en trois gestes : tourner, étirer, tourner de nouveau. Les valeurs singulières mesurent l’intensité de l’étirement.
Trente valeurs pour toute une image : la compression par SVD
Une image en niveaux de gris n’est jamais qu’une matrice de valeurs de pixels. En ne conservant que les  premières valeurs singulières, celles qui portent l’essentiel de l’information, tu reconstruis une version très proche de l’original pour un espace de stockage bien moindre.
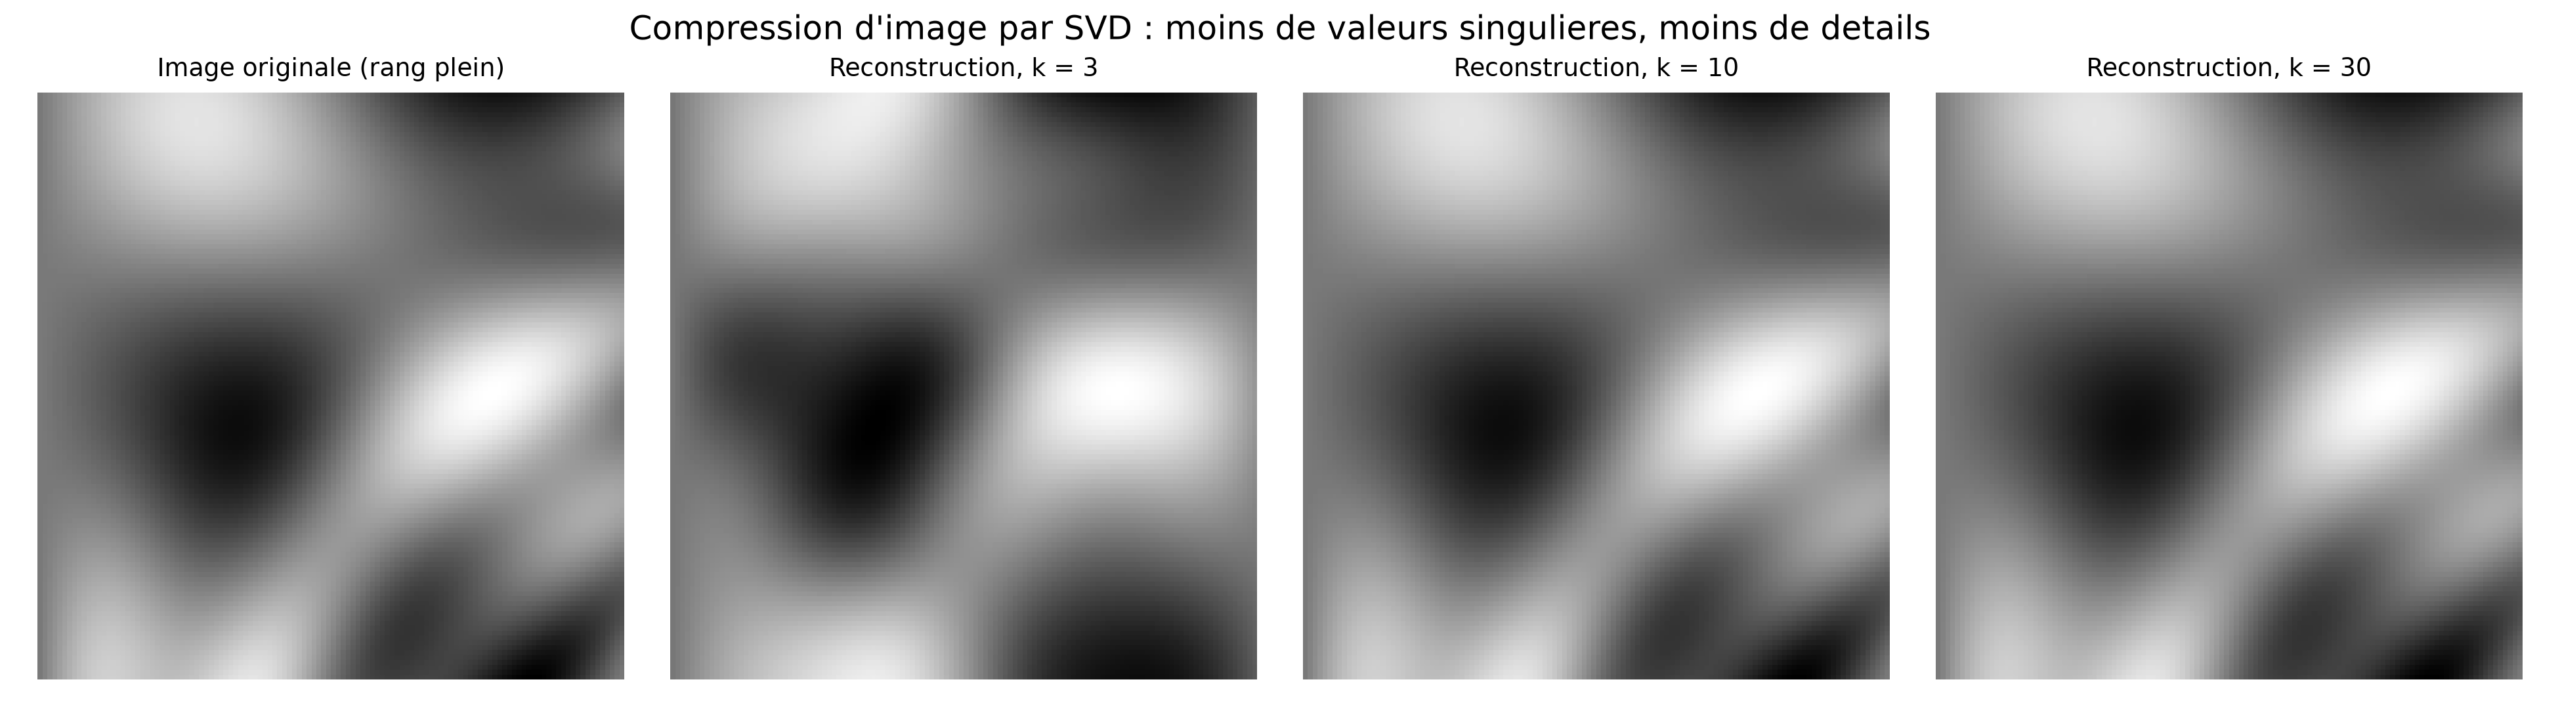
Compare les vignettes de gauche à droite : avec  , presque tous les détails ont disparu ; avec
 , la reconstruction se distingue à peine de l’original. Le compromis entre qualité et compression se lit dans le rapport entre la somme des carrés des valeurs singulières gardées et celle de toutes les valeurs singulières.
Ce que montre cette photo, c’est qu’une grande matrice peut cacher peu d’information indépendante. C’est exactement ce que suppose l’hypothèse du rang intrinsèque pour un réseau de neurones : les changements significatifs de ses poids se capturent avec une représentation de plus petite dimension.
LoRA applique ce pari à la correction des poids
Quand tu ajustes un modèle, ses poids  deviennent
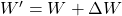 , où
 est la correction apprise pendant l’entraînement. LoRA refuse de stocker cette correction en entier : il la représente par le produit de deux petites matrices
 et
 , et n’entraîne qu’elles.
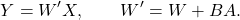
Lis cette formule de droite à gauche :  est la correction, le modèle d’origine qui ne bouge pas,
 leur somme, et
 ce que fait de l’entrée
 .
Pour que cette somme ait un sens, doit avoir la même taille que , car on n’additionne que des matrices de même taille. Or un produit n’existe que si le nombre de colonnes de la première matrice égale le nombre de lignes de la seconde.
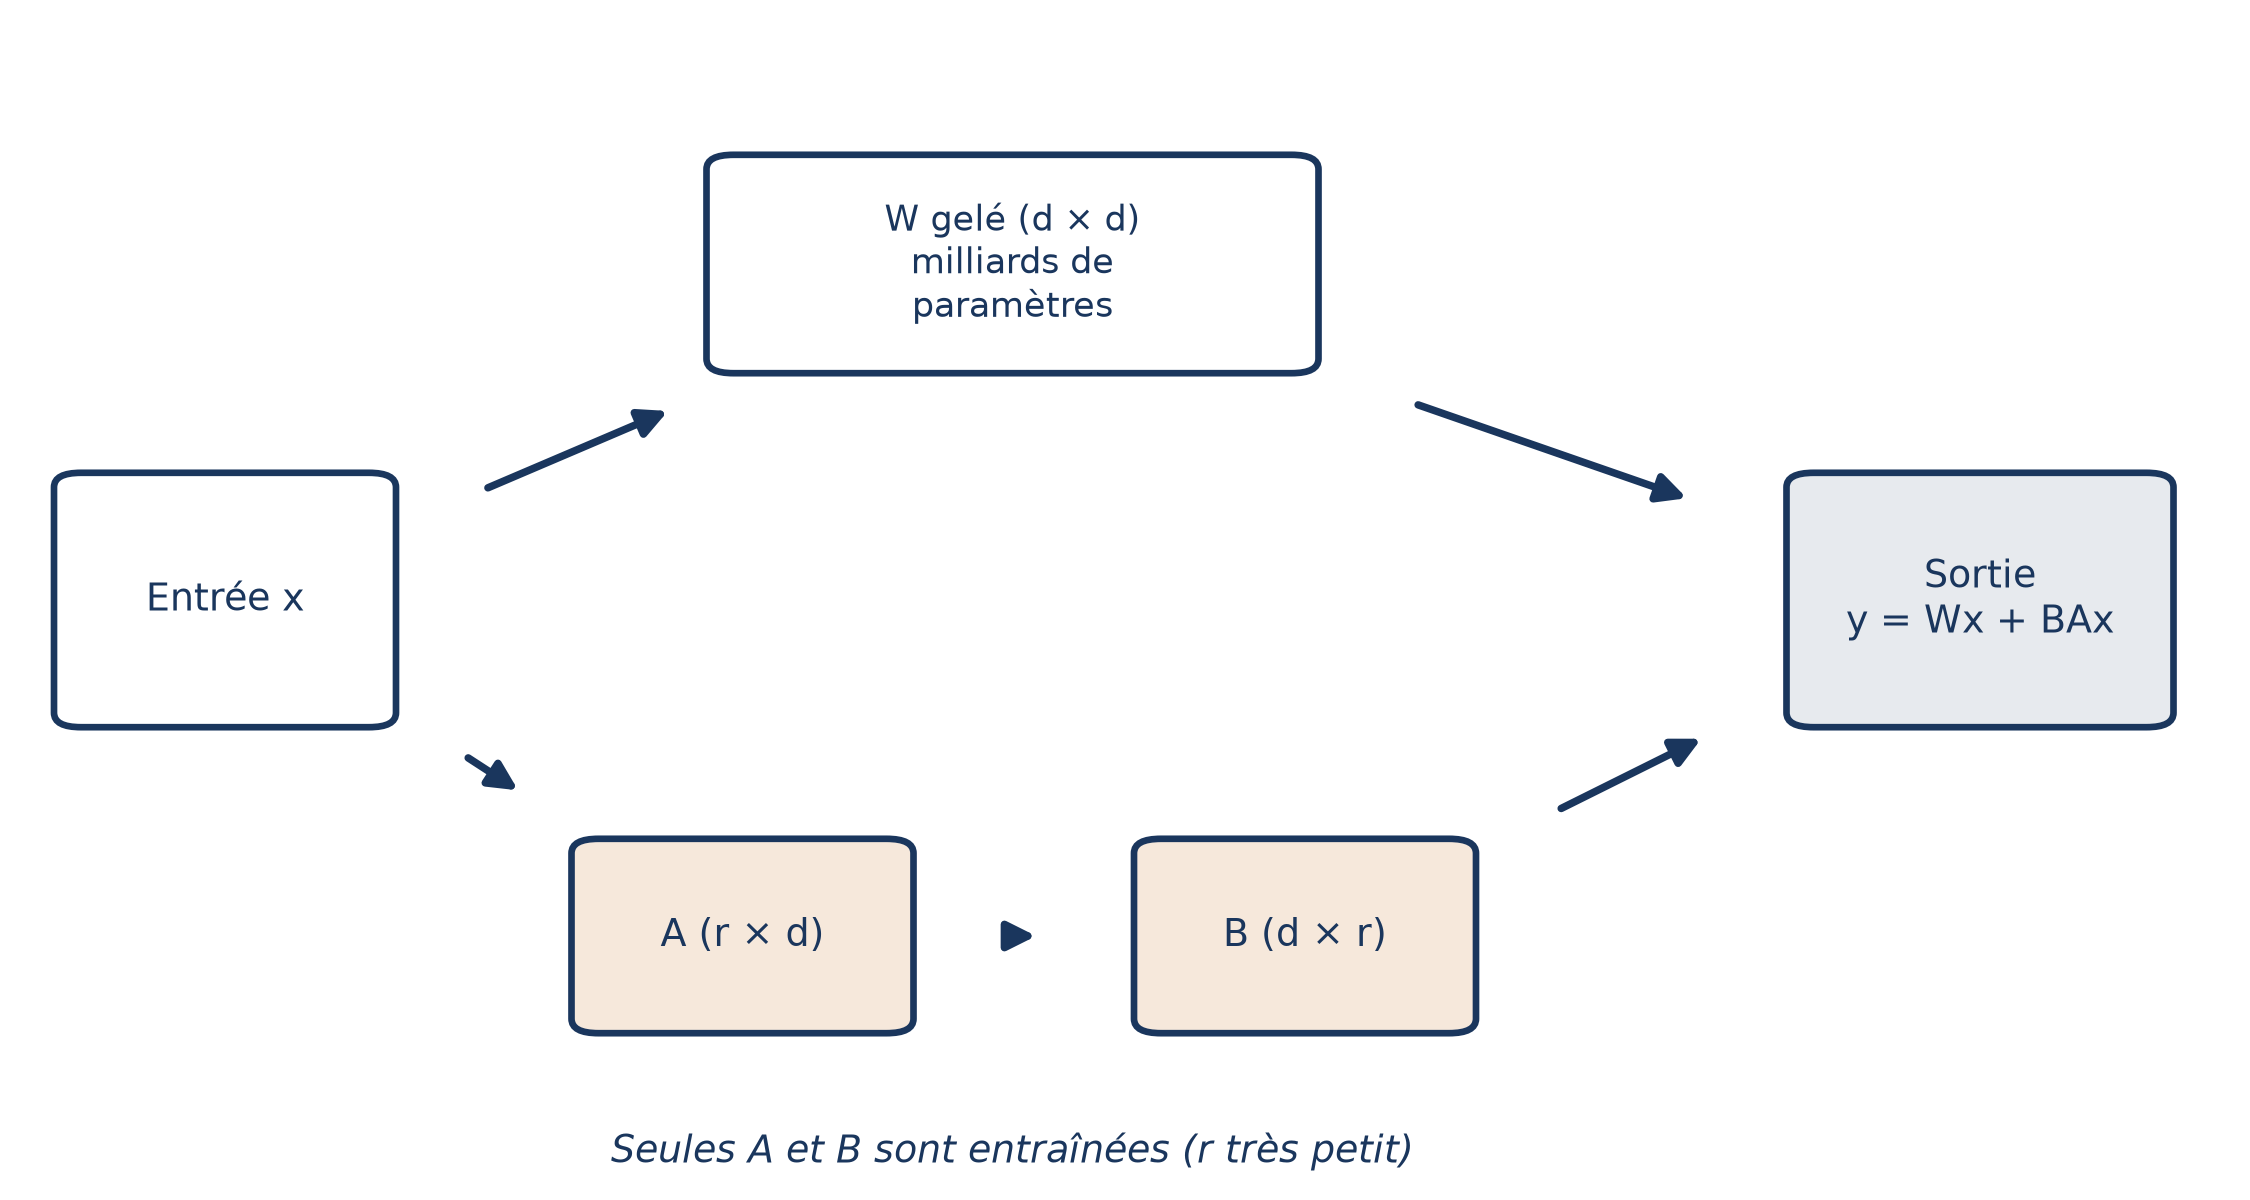
Regarde les étiquettes de tailles : est un grand carré  , alors que (
 ) et (
 ) sont deux rectangles étroits. Dans le produit , la dimension commune
 disparaît et il reste une matrice , de la taille de .
Comme la multiplication matricielle est associative, calculer  ou
 donne le même résultat, et la sortie de la figure s’écrit
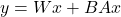 . Le nombre est la largeur du goulot que traversent et : par analogie, c’est le de la photo compressée, la place qu’on laisse à la correction.
💡 Intuition Imagine un calque transparent posé sur un plan : le plan n’est pas redessiné, on y trace seulement la correction. Et parce que cette correction est de rang faible, elle tient dans un petit rectangle.
Lire une configuration LoRA ligne par ligne
Tu veux ajuster Phi-3-mini, un modèle de 3,8 milliards de paramètres. Il faut deux gestes : charger le modèle sans saturer la mémoire, puis y brancher LoRA. Voici comment un exemple en Python les écrit avec les bibliothèques transformers et peft :
import torch, os
from transformers import AutoTokenizer, AutoModelForCausalLM, TrainingArguments,
    BitsAndBytesConfig
from peft import LoraConfig, get_peft_model
...
BASE_SFT_CKPT = "microsoft/Phi-3-mini-4k-instruct"
...
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_use_double_quant=True,
    bnb_4bit_compute_dtype=torch.bfloat16
)

base = AutoModelForCausalLM.from_pretrained(
    BASE_SFT_CKPT,
    device_map="auto",
    torch_dtype=torch.bfloat16,
    quantization_config=bnb_config
)

lora_cfg = LoraConfig(
    r=8,
    lora_alpha=16,
    lora_dropout=0.05,
   target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj",
                    "up_proj", "down_proj"],
    bias="none",
    task_type="CAUSAL_LM",
)
model = get_peft_model(base, lora_cfg)
Lis le bloc en trois temps, de haut en bas. D’abord BitsAndBytesConfig, qui décrit le chargement : le modèle de base passe en précision réduite, sur 4 bits, pour tenir en mémoire. C’est un réglage de chargement, distinct de LoRA.
Vient ensuite LoraConfig, qui décrit la correction. r=8 fixe le rang, donc la largeur du goulot des matrices et . target_modules liste sept noms de couches : les projections d’attention (q_proj, k_proj, v_proj, o_proj) et celles de la couche dense (gate_proj, up_proj, down_proj). Ce sont les seules couches à recevoir l’adaptation.
Deux lignes restent à situer. task_type="CAUSAL_LM" annonce un modèle de langage causal, qui prédit le jeton suivant d’après les précédents. lora_alpha, lora_dropout et bias sont trois réglages d’accompagnement, laissés tels quels dans cet exemple.
Reste le dernier geste : get_peft_model(base, lora_cfg) enveloppe le modèle de base dans les adaptateurs LoRA de rang 8. Le model obtenu est celui que tu donneras ensuite à l’entraînement.
LoRA ne décide pas de l’objectif d’entraînement
LoRA est-il une méthode d’entraînement au même titre que l’affinage supervisé ou l’optimisation directe des préférences (DPO) ? Les exemples de code répondent non, et le montrent par deux entrées différentes.
Pour l’affinage supervisé, la fonction d’entraînement reçoit la configuration sous le nom peft_cfg et la transmet à l’entraîneur par peft_config=peft_cfg. Pour l’optimisation des préférences, le modèle est d’abord enveloppé par get_peft_model, comme dans le bloc précédent, puis affiné avec un entraîneur DPO. Dans les deux cas, la perte et les données appartiennent à l’entraînement ; LoRA se contente de limiter les poids qui bougent.
Cette séparation explique pourquoi on le retrouve partout. Un exemple d’appel de fonctions l’emploie pour n’adapter que des couches ciblées, et LoRA comme QLoRA sont cités parmi les techniques qui réduisent le coût de l’ajustement, avec des bibliothèques comme TRL, Unsloth ou Axolotl pour le réaliser.
Où vit la partie entraînée : LoRA, adaptateurs, préfixes
LoRA fait partie d’une famille de méthodes qui n’entraînent qu’une poignée de paramètres : le finetuning à paramètres efficients, abrégé PEFT. Ce qui les distingue, c’est l’endroit où se loge la partie entraînée :
| Méthode | Ce qu’on entraîne | Où cela se loge |
|---|---|---|
| LoRA | deux petites matrices et |
en parallèle d’une matrice gelée, leur produit s’ajoute à sa sortie |
| Adaptateurs | de petites couches ajustables, de structure proche d’un autoencodeur | à l’intérieur des blocs du transformeur |
| Prompt tuning | un tenseur entraînable | devant les embeddings d’entrée |
| Prefix tuning | des tenseurs entraînables | dans les états cachés de toutes les couches |
Les deux dernières lignes touchent à ce que le modèle voit en entrée ou en cours de route, alors que LoRA ajoute sa correction à la sortie d’une matrice existante. Le prompt tuning et le prefix tuning peuvent d’ailleurs être instables, ce qui explique que LoRA et les adaptateurs dominent l’usage.
Ce que LoRA ne fait pas
« LoRA modifie l’architecture »
Non. Une même architecture se décline en plusieurs tailles, en plusieurs variantes (les versions « base » et « instruct » la partagent) et en un nombre illimité d’affinages, comme LoRA, qui changent le comportement mais pas l’architecture. C’est une bonne nouvelle pour l’exécution : les moteurs d’inférence se règlent sur une architecture, donc un déploiement optimisé pour elle profite à ses variantes.
« LoRA compresse le modèle »
⚠️ Piège L’analogie de la photo peut tromper : on compresse la correction, pas le modèle. Sur la figure,
Le passage en 4 bits du bloc de code est un autre levier : il appartient à la quantification, qui existe en deux grandes variantes, appliquée après l’entraînement ou prise en compte dès l’entraînement. Dans le code, les deux réglages vivent d’ailleurs dans deux objets séparés, BitsAndBytesConfig et LoraConfig.
📌 À retenir LoRA, c’est un modèle laissé intact auquel on ajoute une correction à goulot étroit. L’objectif d’entraînement, les données et la précision du chargement se décident ailleurs.