Calcule de tête 3×7 + 2×7 + 1×7. Tu viens d’enchaîner cinq opérations : trois multiplications, puis deux additions. Un GPU H100 en réalise 989 000 milliards chaque seconde (en FP16, calcul dense), et c’est ce nombre que les fiches techniques appellent « 989 téraFLOPS ». Tu vas voir ce qu’il compte, comment le faire parler et ce qu’il laisse dans l’ombre.
Sommaire
- L’essentiel en 30 secondes
- Une opération, puis des milliers de milliards par seconde
- Qui fait ces opérations dans un GPU
- Du travail au temps : une tête d’attention face à 989 téraFLOPS
- De 242 téraFLOPS à 5 pétaFLOPS : une gamme de GPU
- Ce que le chiffre ne dit pas
L’essentiel en 30 secondes
- Les FLOPS mesurent la cadence de calcul : le nombre d’opérations sur des nombres à virgule qu’un GPU peut enchaîner en une seconde.
- Un GPU de centre de données en aligne des téraFLOPS, voire des pétaFLOPS : des milliers de milliards d’opérations chaque seconde.
- Pour l’inférence, le chiffre de la fiche est celui des Tensor Cores, les unités à matrices, pas celui du GPU entier.
- Nombre d’opérations ÷ FLOPS donne un temps plancher, jamais une durée garantie : environ 9 microsecondes pour une tête d’attention de 4096 tokens sur un H100.
- Ce chiffre ne décrit que l’une des deux ressources d’un GPU ; la bande passante mémoire est l’autre.
Une opération, puis des milliers de milliards par seconde
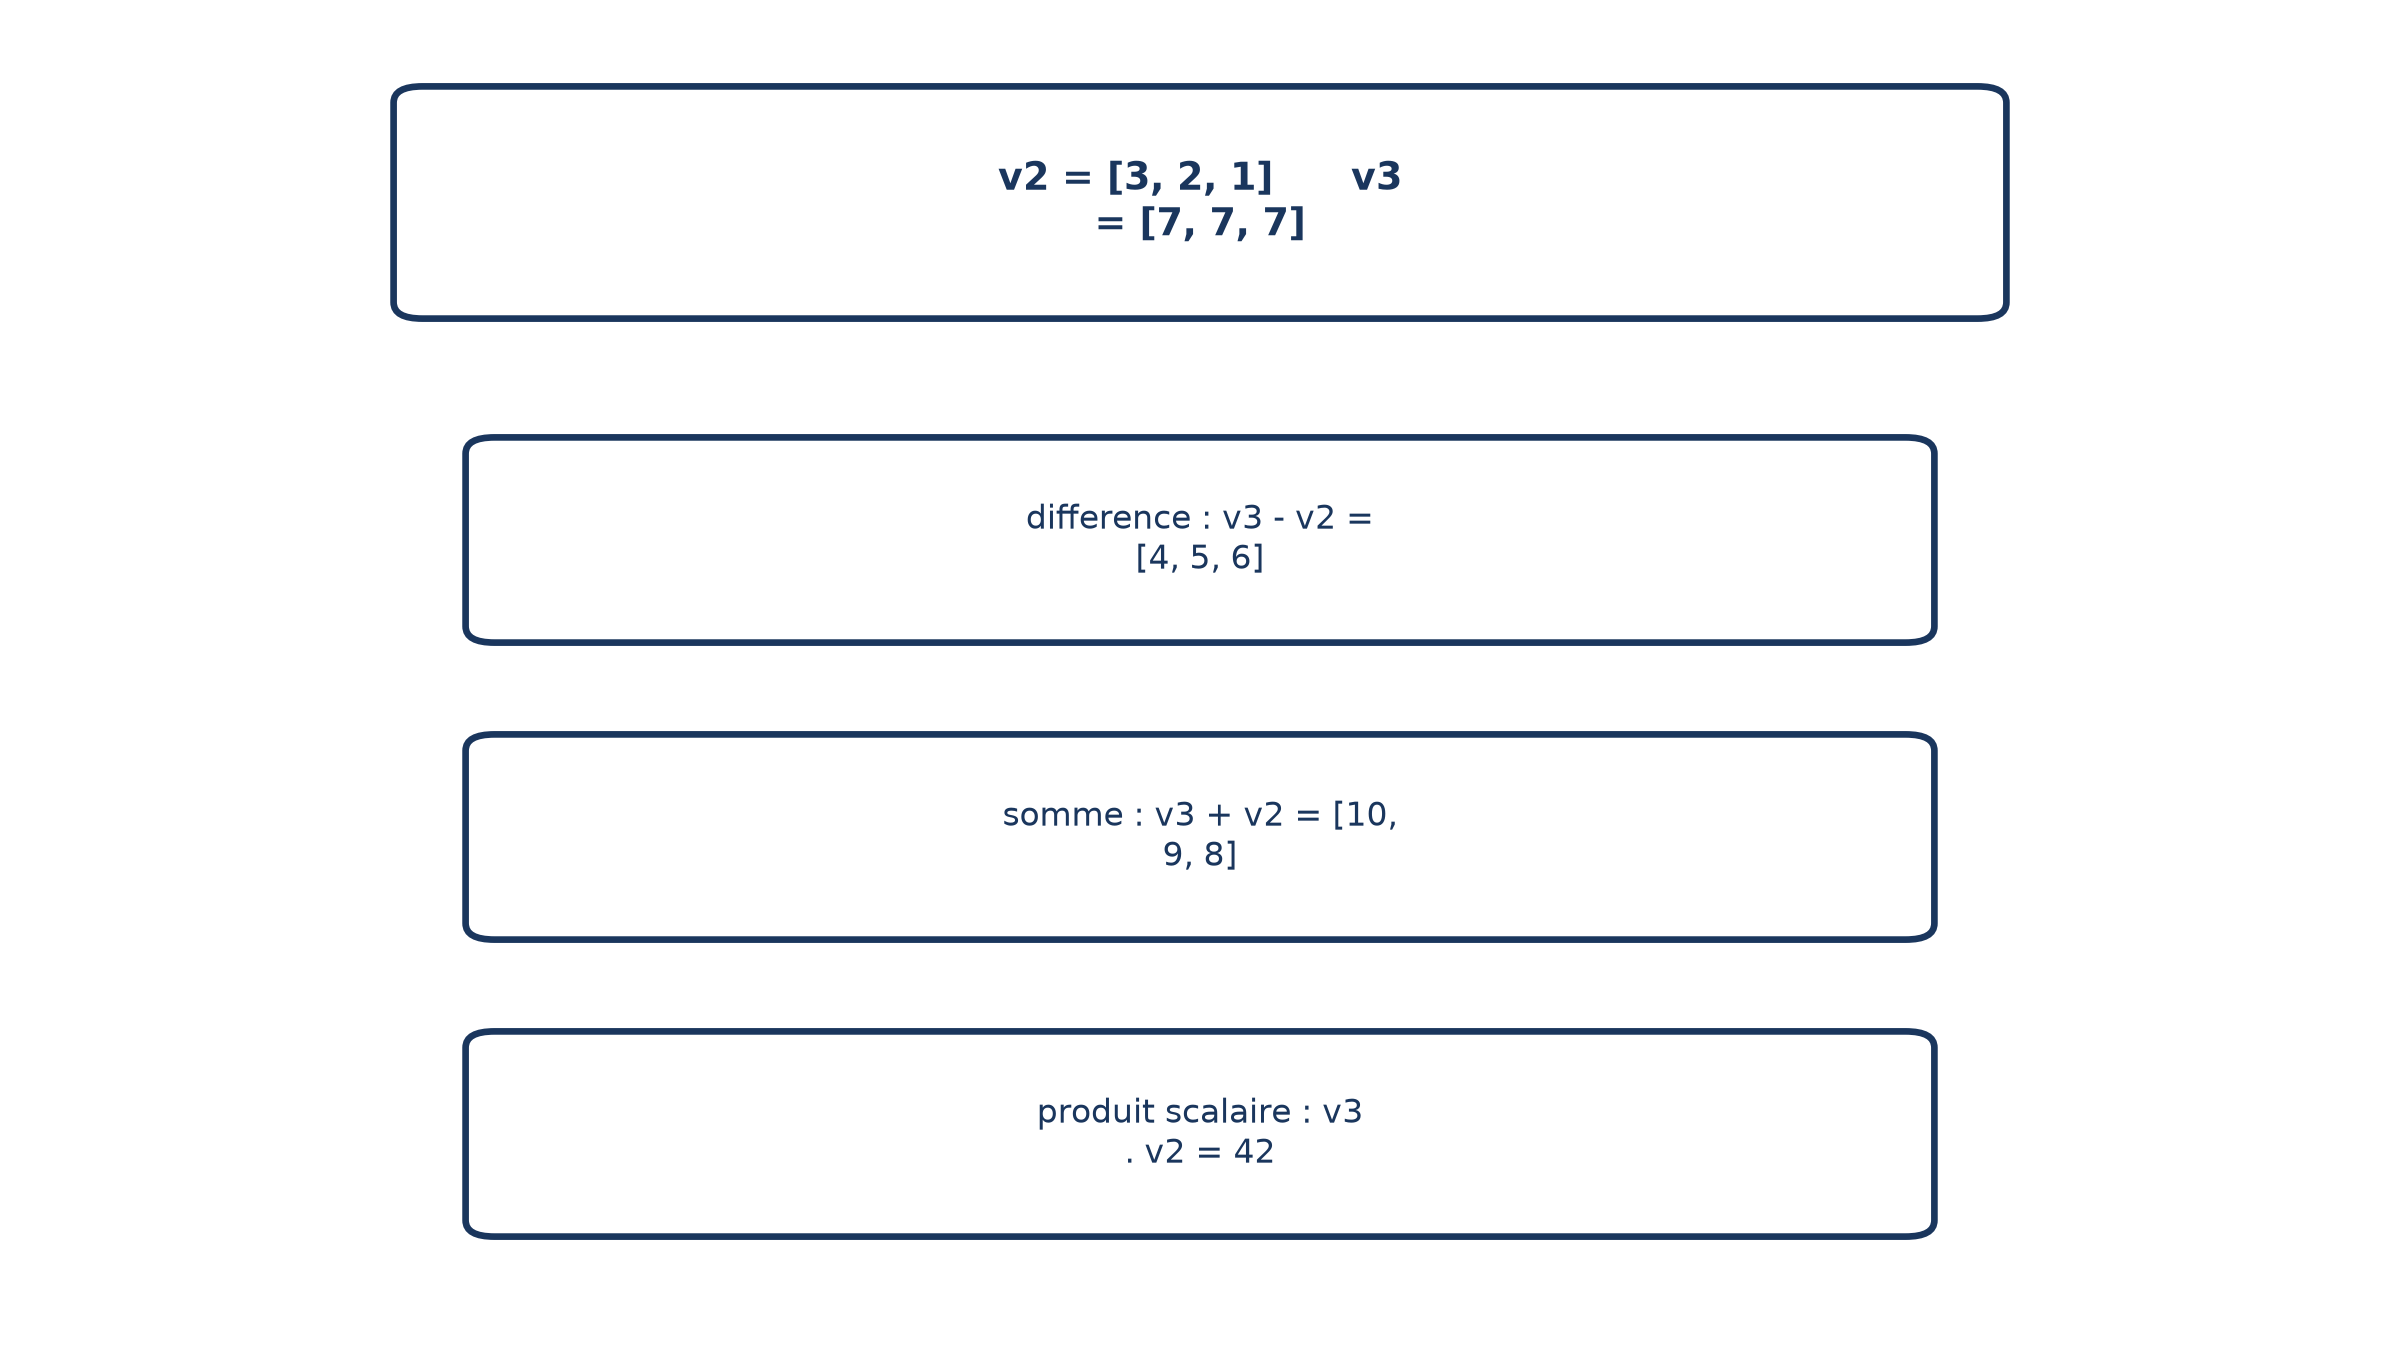
Reprends ton calcul du départ. Les deux listes [3, 2, 1] et [7, 7, 7] se multiplient terme à terme, puis on additionne les trois produits : 21 + 14 + 7 = 42. Ce résultat s’appelle un produit scalaire.
Le sigle FLOPS désigne les opérations en virgule flottante par seconde que le calcul d’un GPU peut atteindre. Le « S » final compte : le chiffre ne dit pas combien d’opérations un calcul demande, mais combien le GPU peut en enchaîner pendant une seconde. Le nombre d’opérations d’un calcul se compte à part, et tu en verras un exemple plus bas.
À l’échelle d’un GPU de centre de données, on parle de téraFLOPS, voire de pétaFLOPS : ces accélérateurs sont conçus pour effectuer des milliers de milliards d’opérations par seconde. Le H100 annonce ainsi 989 téraFLOPS en FP16 (calcul dense), soit près de 200 000 milliards de produits scalaires comme le tien, chaque seconde.
Qui fait ces opérations dans un GPU
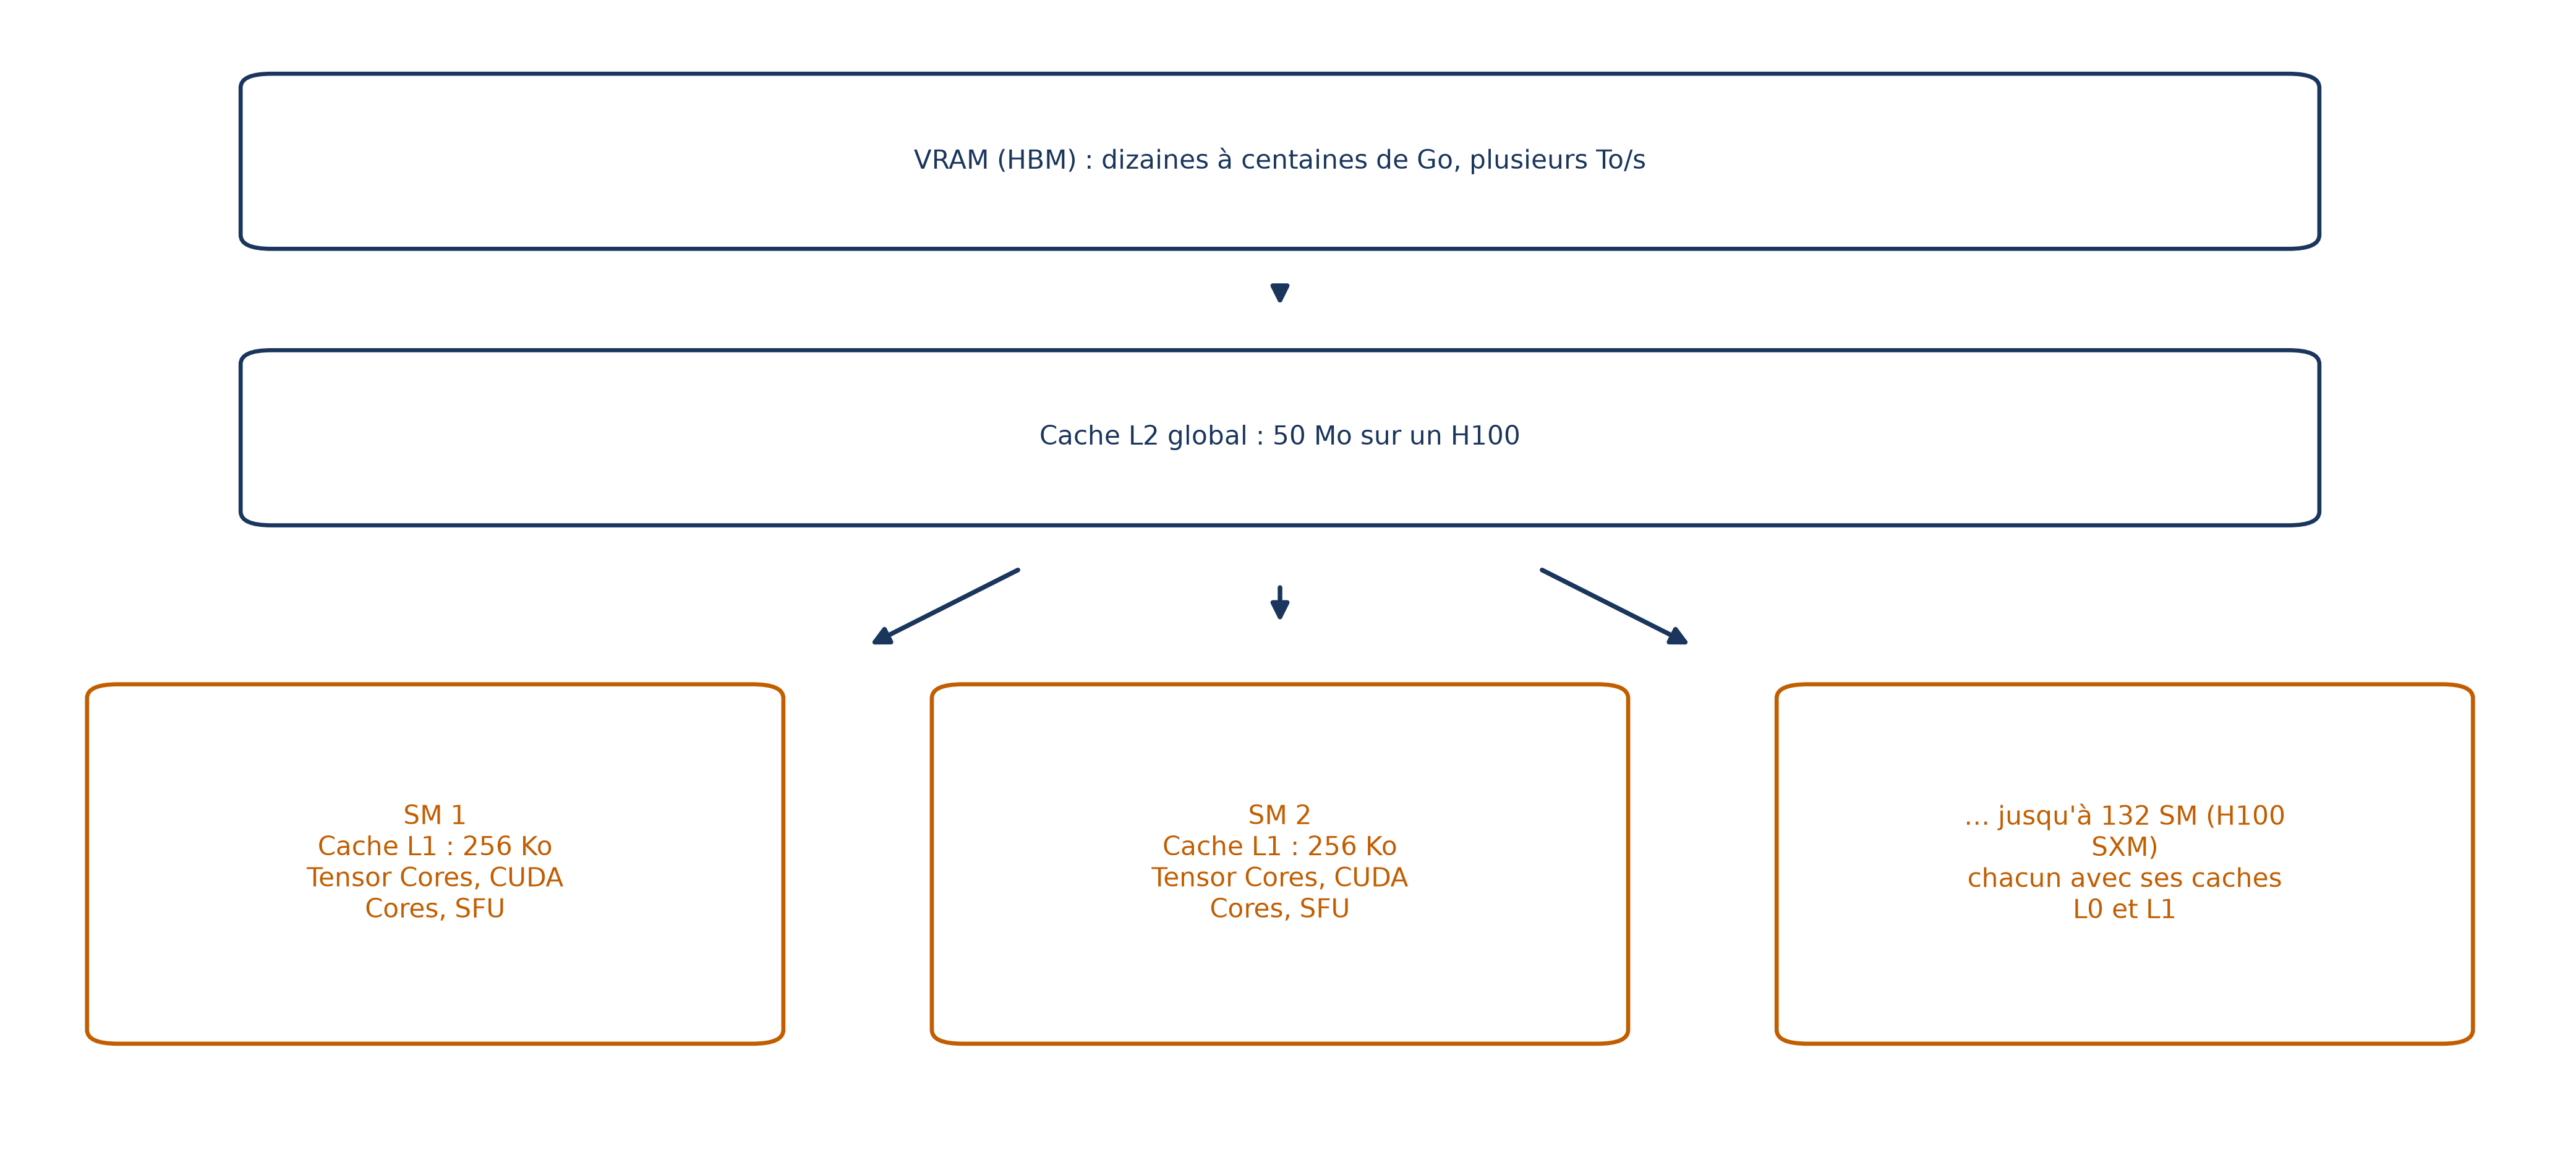
Un GPU n’est pas un processeur ordinaire en plus rapide : c’est une machine à débit. Là où un CPU excelle dans l’exécution séquentielle complexe, un GPU applique la même opération simple à des milliers de données indépendantes. Comme l’inférence d’un modèle est une suite de multiplications de vecteurs et de matrices, il s’y prête naturellement.
Le contraste se voit dans les fils d’exécution, ces petites tâches menées de front : un CPU en compte des dizaines à des centaines, un GPU des dizaines à des centaines de milliers qui travaillent en même temps.
Ces ouvriers sont de trois sortes :
- le cœur CUDA opère sur des nombres isolés, les scalaires ;
- le Tensor Core opère sur des vecteurs et des matrices ;
- l’unité de fonctions spéciales (SFU) accélère des fonctions comme sin, cos et log.
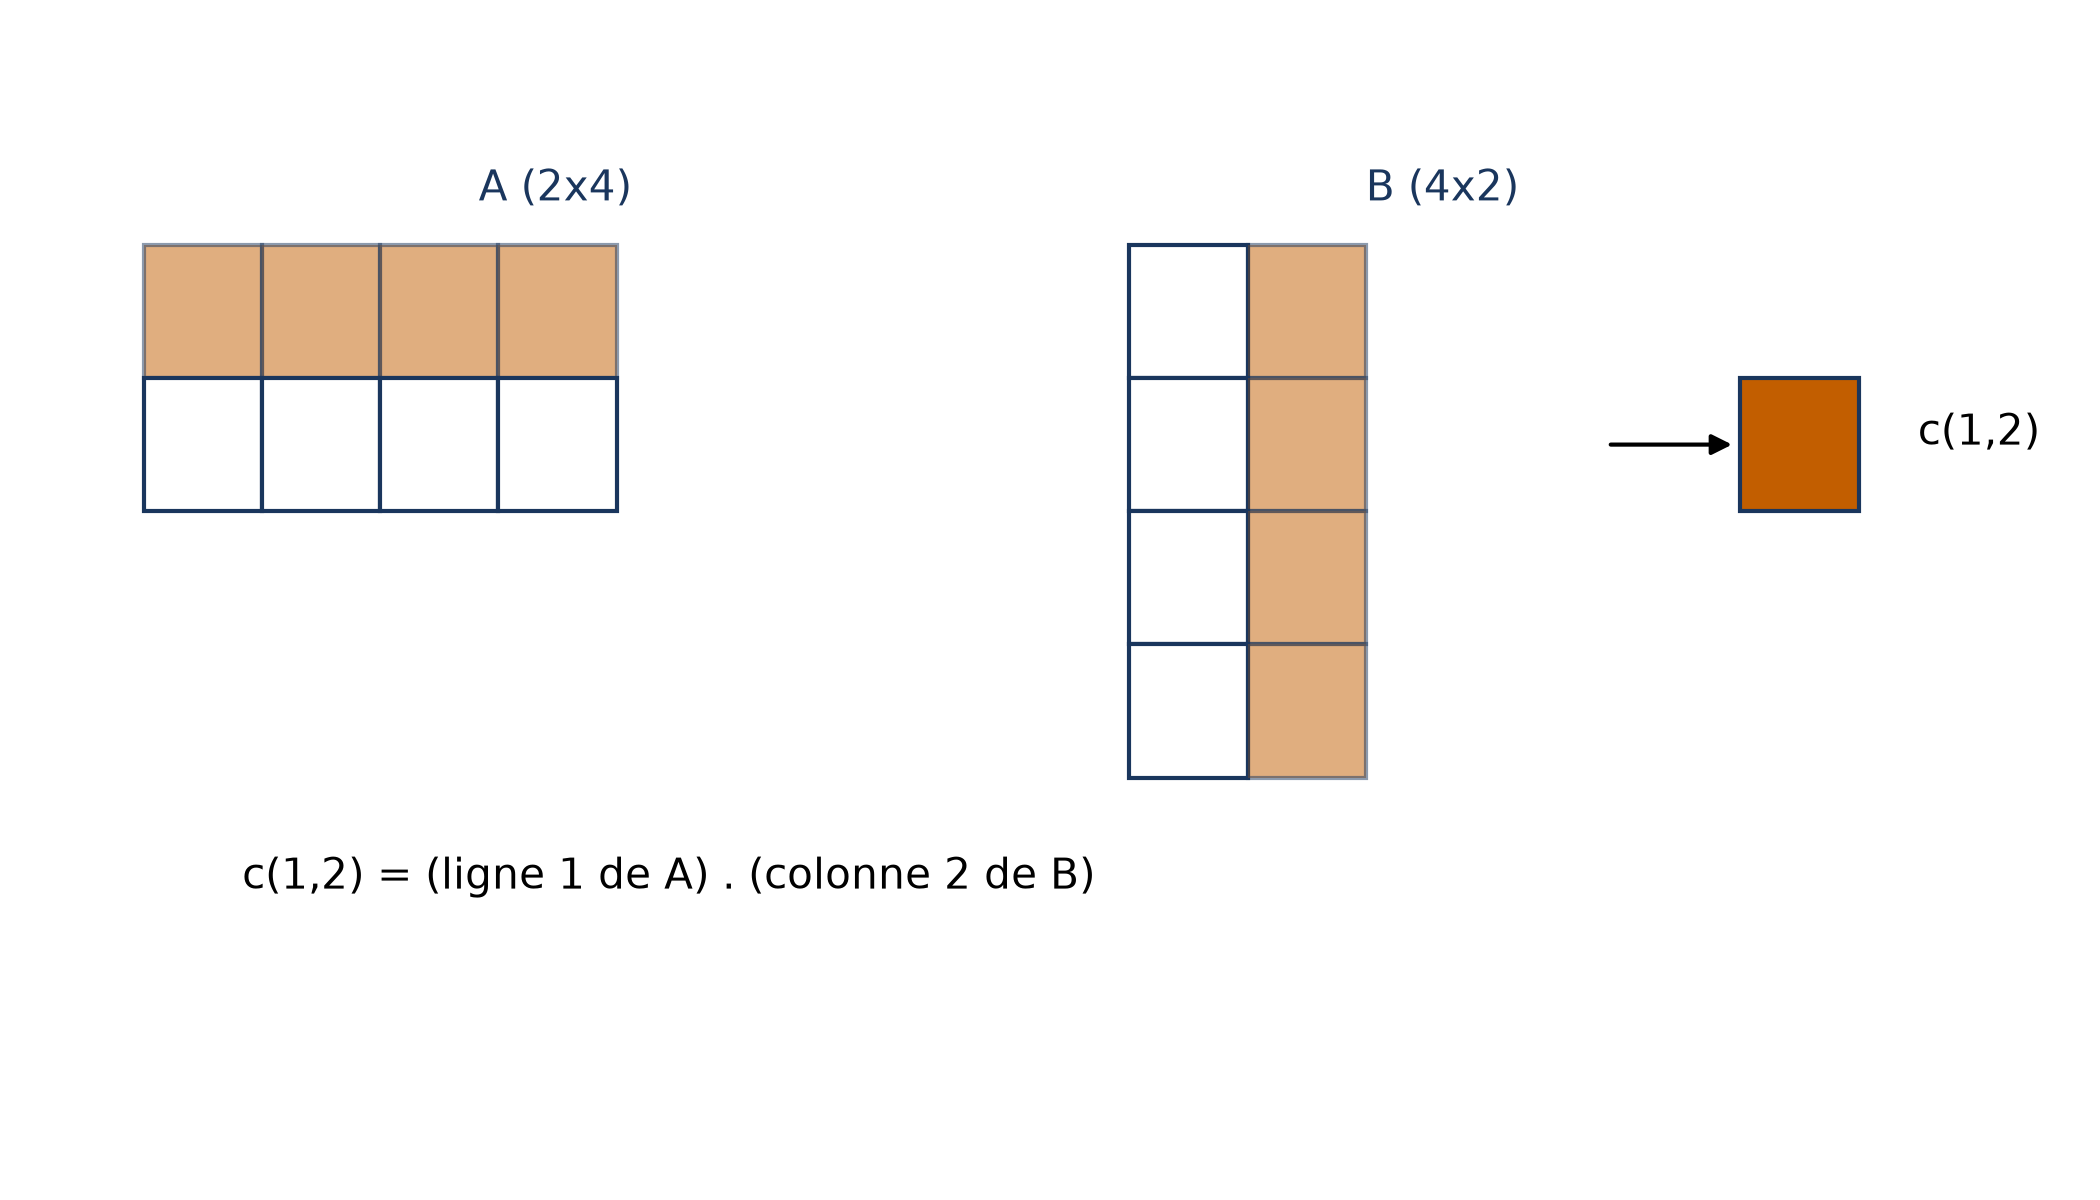
Pour l’inférence, c’est le Tensor Core qui compte. Ses instructions de multiplication-accumulation matricielle multiplient une matrice A par une matrice B, ajoutent une matrice C et rangent le résultat dans D. On mesure donc le calcul d’un GPU en puissance de Tensor Core.
Du travail au temps : une tête d’attention face à 989 téraFLOPS
Un chiffre de puissance ne prend son sens que face à un travail à effectuer. Compte les opérations de l’algorithme d’attention de base, non optimisé, pour une tête dont la dimension vaut  et un texte de
 tokens. Le total de ses trois étapes s’écrit :
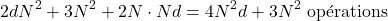
Ici  est le nombre de tokens lus et
 la dimension de la tête ; le total grandit comme le carré de la longueur de séquence. Avec nos valeurs,
 vaut environ 8,59 milliards et
 environ 50 millions : 8,6 milliards d’opérations en tout.
Divise ce travail par la puissance du H100 : 8,6 milliards ÷ 989 000 milliards par seconde, soit à peu près 0,000 009 seconde. Si le GPU tournait à son plafond, il faudrait donc environ 9 microsecondes. Plafond est le mot clé : la fiche annonce ce que le calcul peut atteindre, donc une durée calculée ainsi est un minimum.
💡 Intuition C’est le calcul d’un trajet. La distance divisée par la vitesse de croisière donne la durée d’un voyage sans le moindre bouchon. Ici, le nombre d’opérations est la distance, les FLOPS sont la vitesse affichée au compteur, et la durée obtenue est un minimum.
De 242 téraFLOPS à 5 pétaFLOPS : une gamme de GPU
Pour sentir l’échelle, place quelques GPU sur la même règle. Chacun vient d’une génération d’architecture : Lovelace pour le L4 et le L40, Hopper pour le H100, Blackwell pour le B200.
| GPU | Calcul annoncé | Sa place dans l’offre |
|---|---|---|
| L4 | 242 téraFLOPS (FP8) | Moyen économique de faire tourner de petits modèles : plongements de texte, vision par ordinateur |
| L40 | 362 téraFLOPS | Rarement un bon choix |
| H100 | 1 979 téraFLOPS (FP8, dense) | L’un des accélérateurs d’inférence les plus utilisés |
| B200 | environ 5 pétaFLOPS (FP8, dense) | Nouvel étalon pour l’inférence, avec la plus haute performance pour les grands modèles et la vidéo |
Du L4 au B200, le calcul annoncé est multiplié par une vingtaine de fois (5 000 ÷ 242 ≈ 21), un ordre de grandeur plutôt qu’une mesure exacte. Le FP8, un format flottant sur 8 bits, apparaît avec Hopper ; Lovelace, elle, est plus orientée graphisme alors que Hopper vise les applications d’IA.
Regarde le L40 : il annonce plus de calcul que le L4, et pourtant il est rarement un bon choix, parce qu’à empreinte mémoire égale des fractions de H100 offrent bien plus de calcul. Le chiffre de FLOPS, pris seul, ne classe donc pas les GPU.
Ce que le chiffre ne dit pas
Il ne résume pas tout le GPU
La fiche affiche la puissance des Tensor Cores, parce que ce sont eux qui exécutent les multiplications-accumulations de matrices, fondamentales pour l’inférence. Les cœurs CUDA et les SFU travaillent aussi, et les SFU sont essentielles pour le softmax. Le chiffre est donc un chiffre de matrices, pas une note globale.
Il ne parle que d’une ressource sur deux
Un GPU a deux ressources principales : le calcul, c’est-à-dire les opérations en virgule flottante par seconde qu’il peut atteindre, et la bande passante mémoire, c’est-à-dire les octets qu’il peut déplacer par seconde. Les FLOPS ne disent rien de la seconde : elle a son propre chiffre sur la fiche, et selon le calcul, c’est l’une ou l’autre qui sature pendant que l’autre attend.
Il ne dit pas si ton modèle saura le dépenser
Pour des modèles de quelques milliards de paramètres ou moins, il est difficile de bien utiliser les GPU récents, même avec de grandes tailles de lot. D’où les fractions de GPU : un H100 se découpe en jusqu’à sept morceaux grâce au GPU multi-instances (MIG), et un morceau de trois tranches de calcul dispose d’environ 3/7 du calcul.
Pour un petit modèle comme Orpheus, qui compte 3 milliards de paramètres, deux instances MIG utilisent parfois mieux les ressources qu’un GPU entier alloué à une seule instance.
📌 À retenir Une opération, c’est un calcul élémentaire sur des nombres à virgule. Les FLOPS en alignent des milliers de milliards par seconde, mais seulement dans les Tensor Cores, et seulement comme plafond : ils fixent un temps minimum, pas une promesse de vitesse.