Tu as sous les yeux deux fiches techniques. Le H100 et le H200 affichent exactement la même puissance de calcul, mais le H200 déplace ses données bien plus vite : 4,8 To/s contre 3,35. Une simple division suffit à dire ce que cet écart change : le rapport ops:octet. Voici ce qu’il est, comment le lire et dans quels pièges on tombe en le comparant.
Sommaire
- L’essentiel en 30 secondes
- Deux lignes de fiche technique, une division
- Que veut dire « 295 » ?
- Ne le confonds pas avec l’intensité arithmétique
- H100, H200, B200 : le même rapport ?
- Trois pièges en lisant une fiche technique
- Choisir un GPU selon son goulot
L’essentiel en 30 secondes
- Le rapport ops:octet est la puissance de calcul divisée par la bande passante d’un GPU.
- Il s’exprime en opérations par octet et donne le point d’équilibre du matériel : 295 pour un H100 en FP16.
- Il ne décrit pas un algorithme : c’est le seuil à comparer à l’intensité arithmétique pour savoir si l’on attend le calcul ou la mémoire.
- Il dépend de la précision et du type de FLOPS lus sur la fiche : compare toujours à précision identique, en mode dense.
- Il aide à choisir le GPU selon son goulot : plus de FLOPS pour le calcul, plus de bande passante pour la mémoire.
Deux lignes de fiche technique, une division
Un GPU possède une vitesse de calcul, en opérations par seconde, et une bande passante mémoire, en octets déplacés par seconde. En divisant la première par la seconde, les secondes s’annulent : il reste des opérations par octet. C’est exactement l’unité du rapport ops:octet.
Fais le calcul sur un H100 en FP16 : 989 téraFLOPS de calcul dense, face à 3,35 To/s de bande passante. 989 divisé par 3,35 donne environ 295.
Le numérateur se lit sur la ligne « Tensor Cores » de la fiche, puisque c’est la puissance de ces unités qui compte pour l’inférence. Il existe deux versions du chiffre, dense et parcimonieuse, et il faut prendre le FLOPS dense, qui est la valeur par défaut de l’inférence.
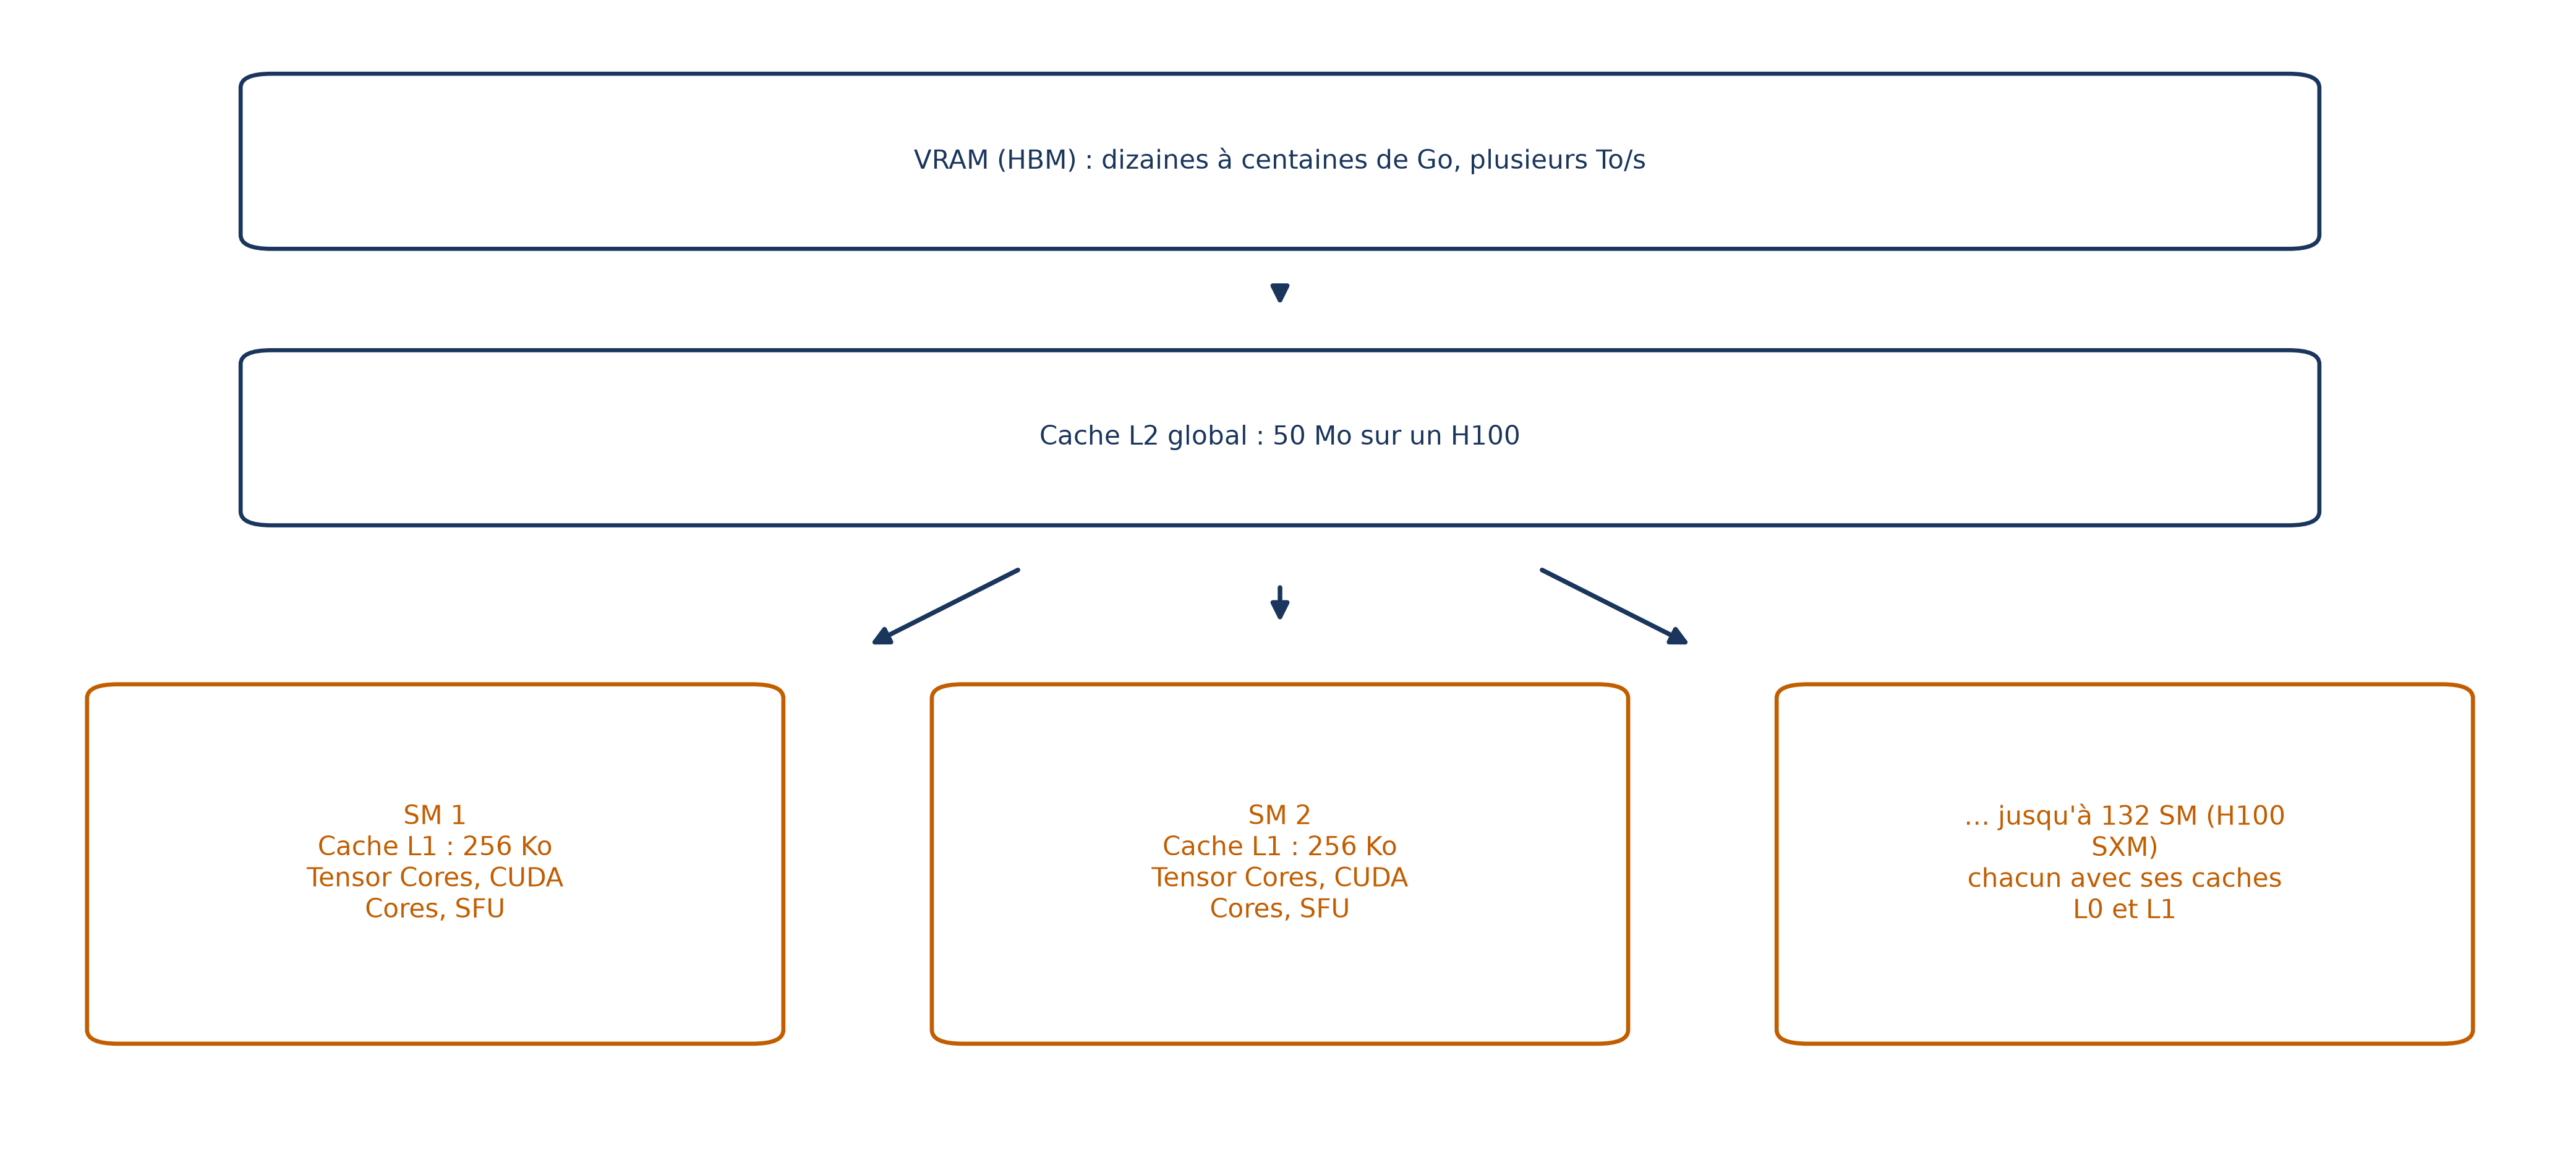
Le dénominateur, lui, mesure le débit maximal entre les cœurs et la mémoire embarquée du GPU (la VRAM), via le bus mémoire. Il fixe la vitesse à laquelle la VRAM alimente toute la hiérarchie de caches.
Que veut dire « 295 » ?
Imagine une cuisine de restaurant. Le plan de travail, c’est le calcul ; les livraisons depuis la réserve, c’est la bande passante. Le rapport ops:octet dit combien de gestes les cuisiniers peuvent faire pour chaque kilo d’ingrédients livré.
💡 Intuition Si chaque kilo livré ne demande que quelques gestes, les cuisiniers attendent la livraison : la réserve est le goulot. Si chaque kilo demande énormément de gestes, la livraison dort pendant que les cuisiniers s’épuisent : c’est le plan de travail qui bride. Le rapport ops:octet est le nombre de gestes par kilo où les deux tiennent exactement le même rythme.
Pour un H100 en FP16, ce nombre vaut 295. Pour que l’inférence soit parfaitement équilibrée, le système devrait donc effectuer 295 opérations par octet lu en mémoire.
Ce n’est donc pas une note de qualité du GPU. C’est un repère : tout calcul qui fait moins d’opérations par octet que ce repère laisse les unités de calcul en attente, tout calcul qui en fait plus laisse la mémoire en avance.
Ne le confonds pas avec l’intensité arithmétique
Deux nombres du même genre circulent, et ils n’ont pas le même propriétaire. Le rapport ops:octet appartient à la machine : c’est une mesure par seconde. L’intensité arithmétique appartient à un calcul précis, une fonction ou un algorithme : c’est le rapport entre le travail effectué et le trafic mémoire qu’il provoque. On l’appelle aussi intensité opérationnelle.
Pour les mettre face à face, on utilise un graphique appelé modèle roofline. En abscisse, l’intensité arithmétique ; en ordonnée, la performance atteignable en téraFLOPS ; les deux axes sont en échelle logarithmique.
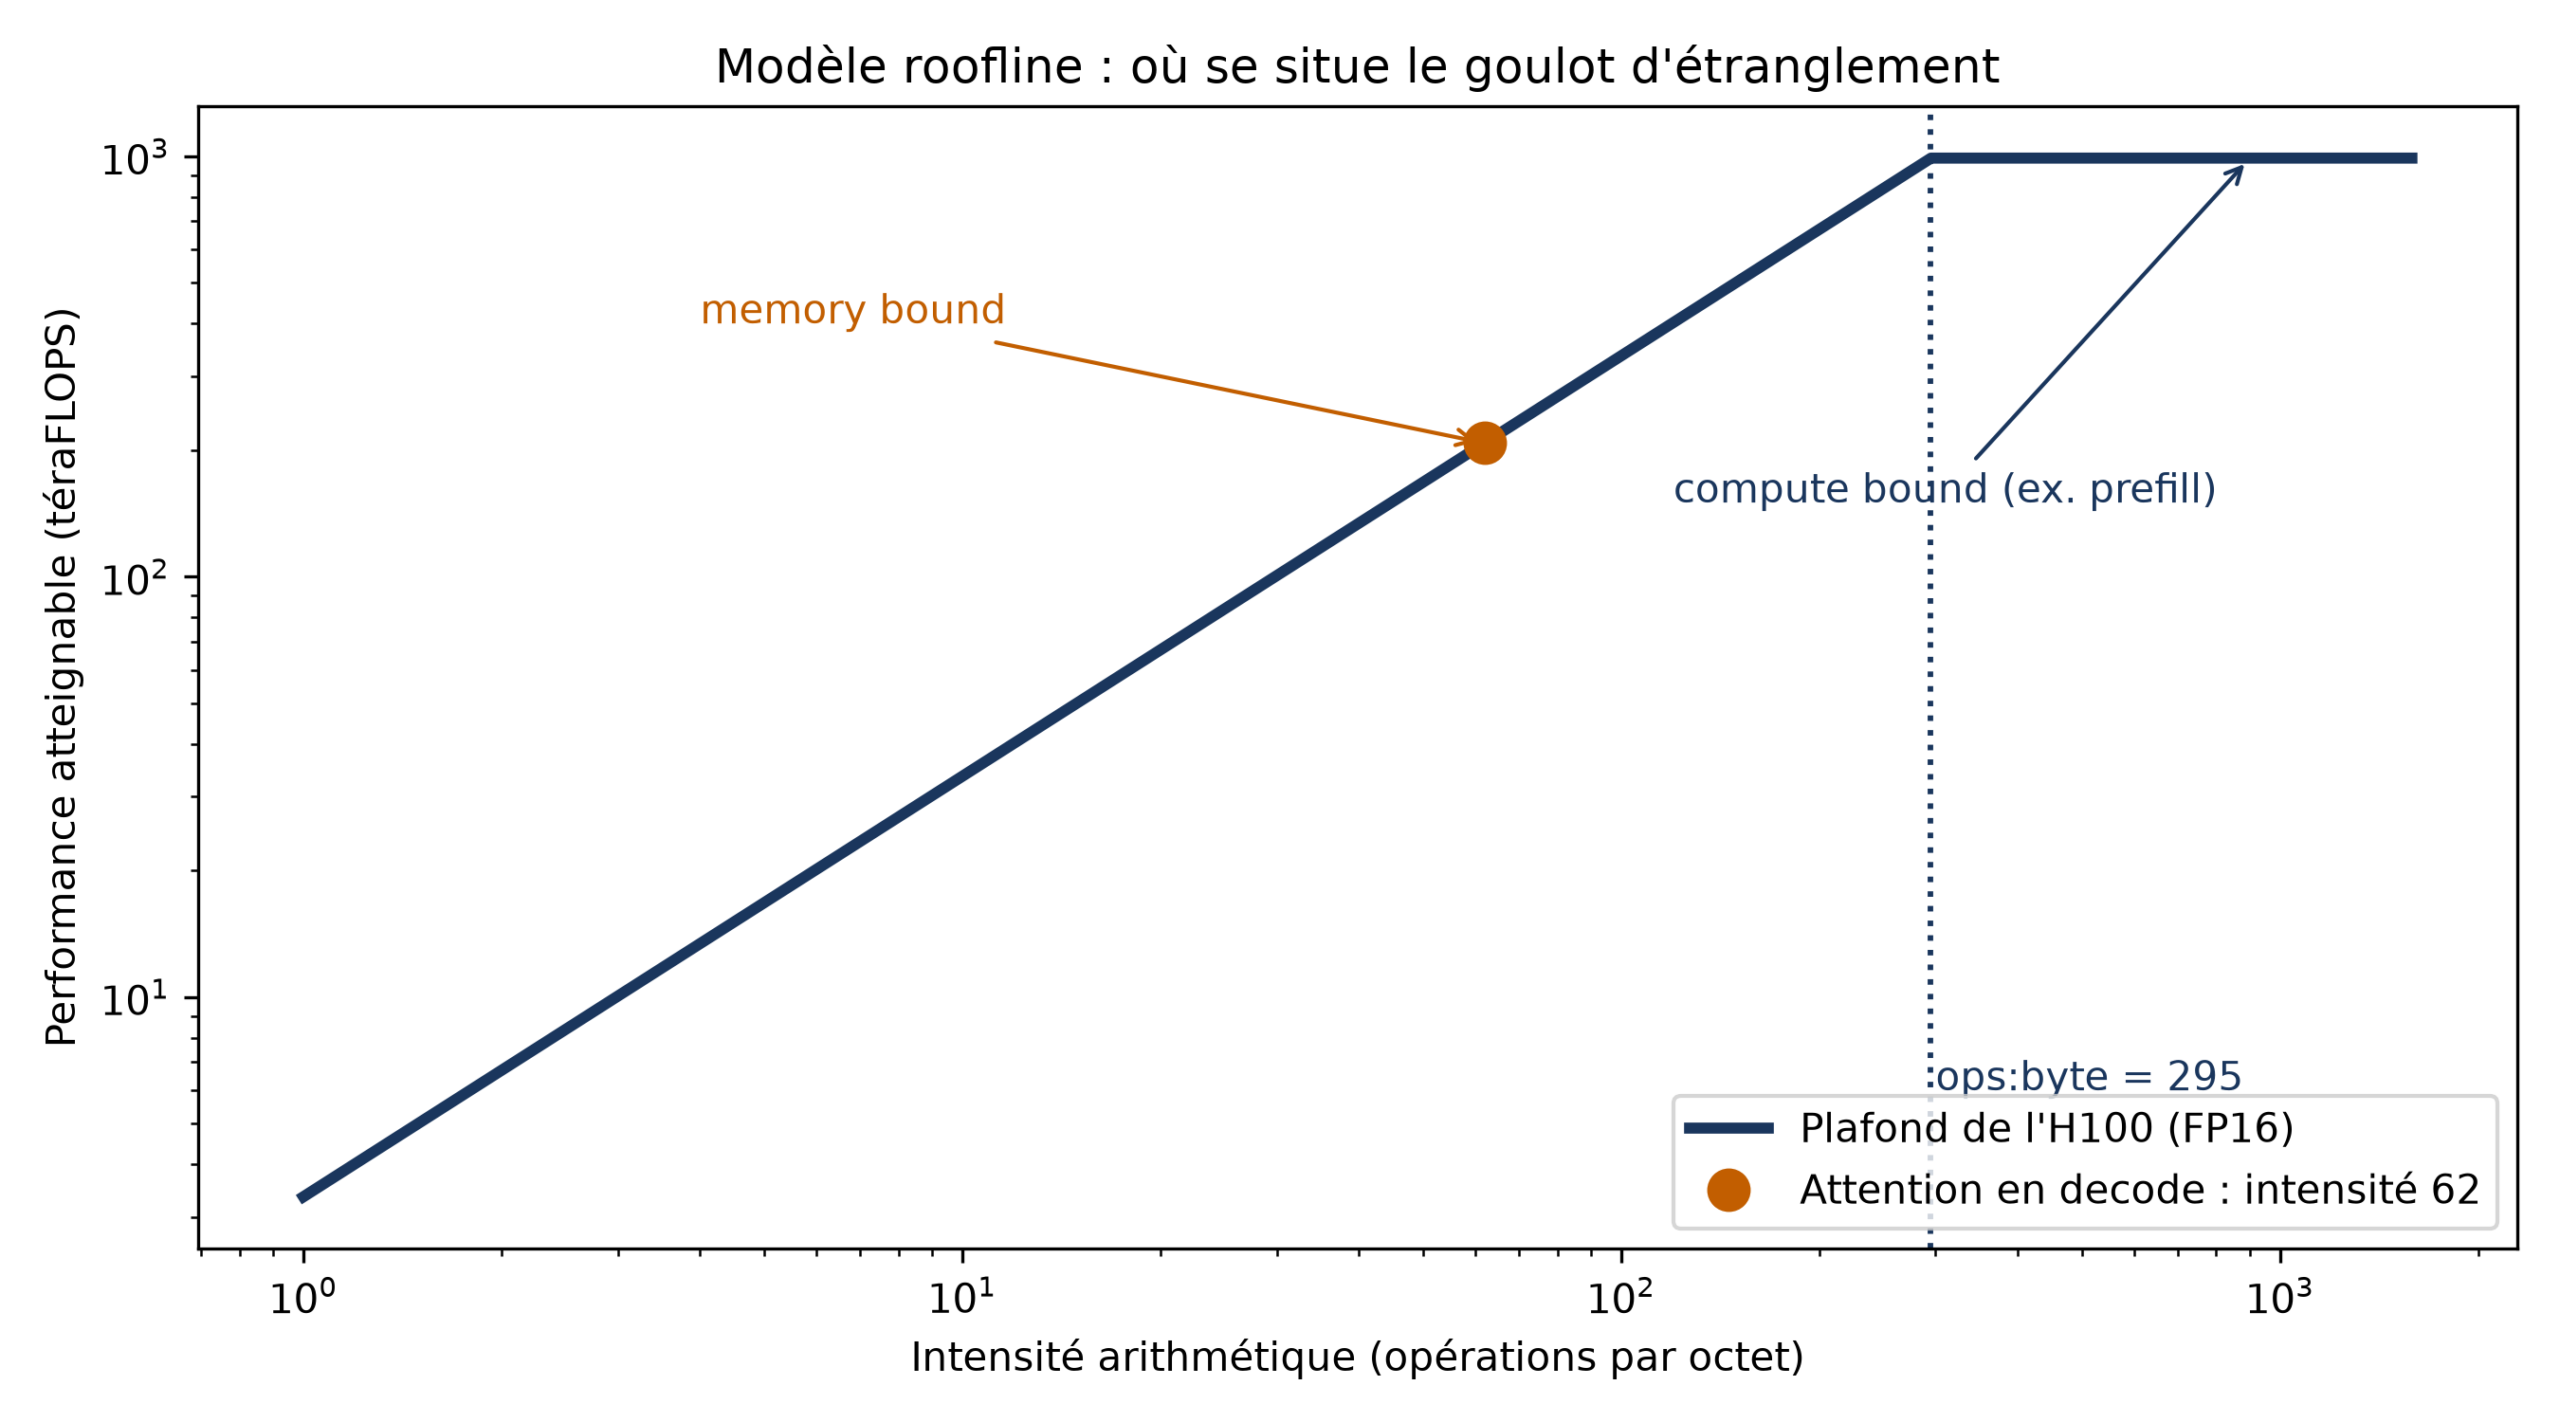
Le verdict est ensuite mécanique. Si l’intensité d’un calcul dépasse le rapport ops:octet du matériel et atteint le plateau, il est limité par le calcul ; si elle reste en dessous et touche la diagonale, il est limité par la mémoire.
H100, H200, B200 : le même rapport ?
Reprenons nos deux fiches. Les chiffres ci-dessous sont ceux des fiches en FP8 dense ; la dernière colonne, c’est toi qui la calcules en divisant.
| GPU | Calcul FP8 dense | Bande passante | Rapport ops:octet (FP8) |
|---|---|---|---|
| H100 | 1 979 téraFLOPS | 3,35 To/s | ≈ 591 |
| H200 | 1 979 téraFLOPS | 4,8 To/s | ≈ 412 |
| B200 | ≈ 5 pétaFLOPS | jusqu’à 8 To/s | ≈ 625 |
Deux enseignements. D’abord, le H200 a les mêmes FLOPS que le H100 mais plus de bande passante : son point d’équilibre descend de 591 à 412, de sorte qu’un plus grand nombre de calculs se retrouve à droite du trait, du côté où le calcul bride.
Ensuite, le rapport d’un même GPU n’est pas unique. Le H100 en FP16 affiche 989 téraFLOPS, soit 295, alors qu’en FP8 ses Tensor Cores sont deux fois plus rapides et son rapport grimpe vers 591, pour la même bande passante. Les FLOPS doublent en effet généralement à chaque division par deux de la précision.
Il y a une contrepartie : déplacer des valeurs FP8 demande moitié moins de bande passante que des valeurs FP16. Le seuil monte, mais chaque valeur à lire pèse moins.
Trois pièges en lisant une fiche technique
⚠️ Piège Comparer deux rapports ops:octet sans vérifier qu’ils portent sur le même type de FLOPS et la même précision revient à comparer des choux et des carottes.
Le premier piège est la parcimonie. Les fiches donnent aussi des FLOPS « parcimonieux », valables pour des tenseurs à structure 2:4 dont la moitié des valeurs est nulle. Ils valent souvent, mais pas toujours, le double des FLOPS denses : un rapport calculé avec eux est artificiellement gonflé.
Le deuxième est la précision. Un GPU capable d’un pétaFLOPS en 16 bits en fait deux en 8 bits, donc le même GPU affiche deux rapports différents selon le format numérique. Compare à précision identique, jamais un chiffre FP8 à un chiffre FP16.
Le troisième tient au dénominateur. La bande passante d’une fiche est un débit de pointe : le rapport que tu en tires est un repère théorique, pas une mesure de ce que ton programme obtiendra.
Choisir un GPU selon son goulot
Le rapport ops:octet ne sert pas à classer les GPU, mais à se demander quel chiffre de la fiche compte pour ta charge de travail. Pour le prefill d’un LLM et pour la génération d’images et de vidéos, le calcul est le goulot : on choisit l’accélérateur qui offre le plus de FLOPS.
Pour le decode, à taille de lot faible ou moyenne, c’est la bande passante mémoire qui limite. Pour générer plus de tokens par seconde, on prend alors l’accélérateur à plus forte bande passante : le H200 plutôt que le H100.
Une dernière colonne de la fiche échappe au rapport : la capacité de la VRAM. Elle doit loger les poids du modèle, avec au moins la moitié de leur taille en marge pour le cache KV ; sans cela, le chargement échoue par une erreur de mémoire insuffisante.
📌 À retenir Deux chiffres de fiche, une division, un seuil : en dessous, le calcul attend la mémoire ; au-dessus, la mémoire attend le calcul. Lis toujours le chiffre dense, à la précision de ta charge.