« Quels sont les trois films de Steven Spielberg les mieux notés, et leur note moyenne ? » Pose cette question à un assistant branché sur une base de films : aucune recherche par similarité ne peut y répondre, car on ne lui demande pas de retrouver ce qui ressemble à la question, mais de calculer. Quelqu’un doit donc aller chercher l’outil capable de ce calcul. Cet outil, c’est un agent retriever : en fin de lecture, tu sauras le définir, lire sa « fiche d’identité » et ne plus le confondre avec ce que le mot « agent » te fait imaginer.
Sommaire
- L’essentiel en 30 secondes
- Deux situations où un seul moteur de recherche ne suffit pas
- Une capacité de recherche mise sous étiquette
- Lire une étiquette : l’outil de repli
- Derrière l’étiquette, des corps très différents
- Trois façons de choisir le retriever à appeler
- Trois idées reçues
L’essentiel en 30 secondes
- Un agent retriever est une capacité de recherche mise sous étiquette : un outil de récupération que le système tient à disposition, parmi d’autres, pour trouver l’information d’une réponse.
- Il a deux faces : une étiquette que lit le modèle (nom, description, paramètres) et un corps qui s’exécute derrière, qu’il s’agisse d’une requête, d’une recherche vectorielle ou des deux.
- Il peut être très général ou très étroit : recherche vectorielle, text2cypher, ou gabarit de requête codé en dur.
- On en multiplie parce qu’une seule recherche par similarité ne sait ni agréger des données ni cloisonner des bases séparées.
- Le mot « agent » est trompeur : le pouvoir de décision reste au routeur, qui choisit le retriever à appeler.
Deux situations où un seul moteur de recherche ne suffit pas
Reprenons la question sur Spielberg. Pour y répondre, il faut une requête construite exprès, ici en Cypher, le langage de requête des bases de données de graphe comme Neo4j. Sa notation se lit comme un dessin : les parenthèses désignent des entités, les flèches les liens qui les relient.
MATCH (:Reviewer)-[r:REVIEWED]->(m:Movie)<-[:DIRECTED]-(:Director {name:
'Steven Spielberg'})
RETURN m.title, AVG(r.score) AS avg_rating
ORDER BY avg_rating DESC
LIMIT 3
Lis-la de gauche à droite. Un critique (Reviewer) a noté (REVIEWED) un film (Movie), et ce film a été réalisé (DIRECTED) par un Director nommé Steven Spielberg. La note de chaque critique se trouve dans r.score, AVG en fait la moyenne pour chaque film, puis on trie du meilleur au moins bon et on garde les trois premiers.
Cette requête ne cherche pas les entités les plus proches de la question : elle agrège des données d’une façon précise. Dès que tu veux autre chose que des voisins proches, ou que tu veux agréger, il te faut un retriever capable de produire ce genre de requête. C’est le terrain de text2cypher, que tu verras en détail plus bas.
Deuxième situation, sans aucun calcul cette fois. Une entreprise propose des services de banque, d’assurance et de finance, et un même assistant répond aux clients sur leurs comptes et transactions, leurs polices et sinistres, leurs conseils et placements. Pour des raisons de réglementation et de vie privée, il ne doit pas aller chercher dans les données d’un client rattachées à un autre service. Fouiller toutes les bases à chaque question serait de toute façon inefficace : de la latence, et des résultats hors sujet.
Dans les deux cas, la réponse n’est pas un moteur plus puissant mais plusieurs moteurs, chacun cantonné à son terrain, et un étage qui choisit lequel appeler.
Une capacité de recherche mise sous étiquette
Un agent retriever est une capacité de recherche présentée comme un outil. Le système en garde tout un éventail à disposition, et à chaque question l’un d’eux, ou plusieurs, est appelé pour aller chercher les données. Dans l’implémentation la plus courante, un modèle de langage choisit l’outil grâce à sa capacité à appeler des outils, que l’on nomme function calling.
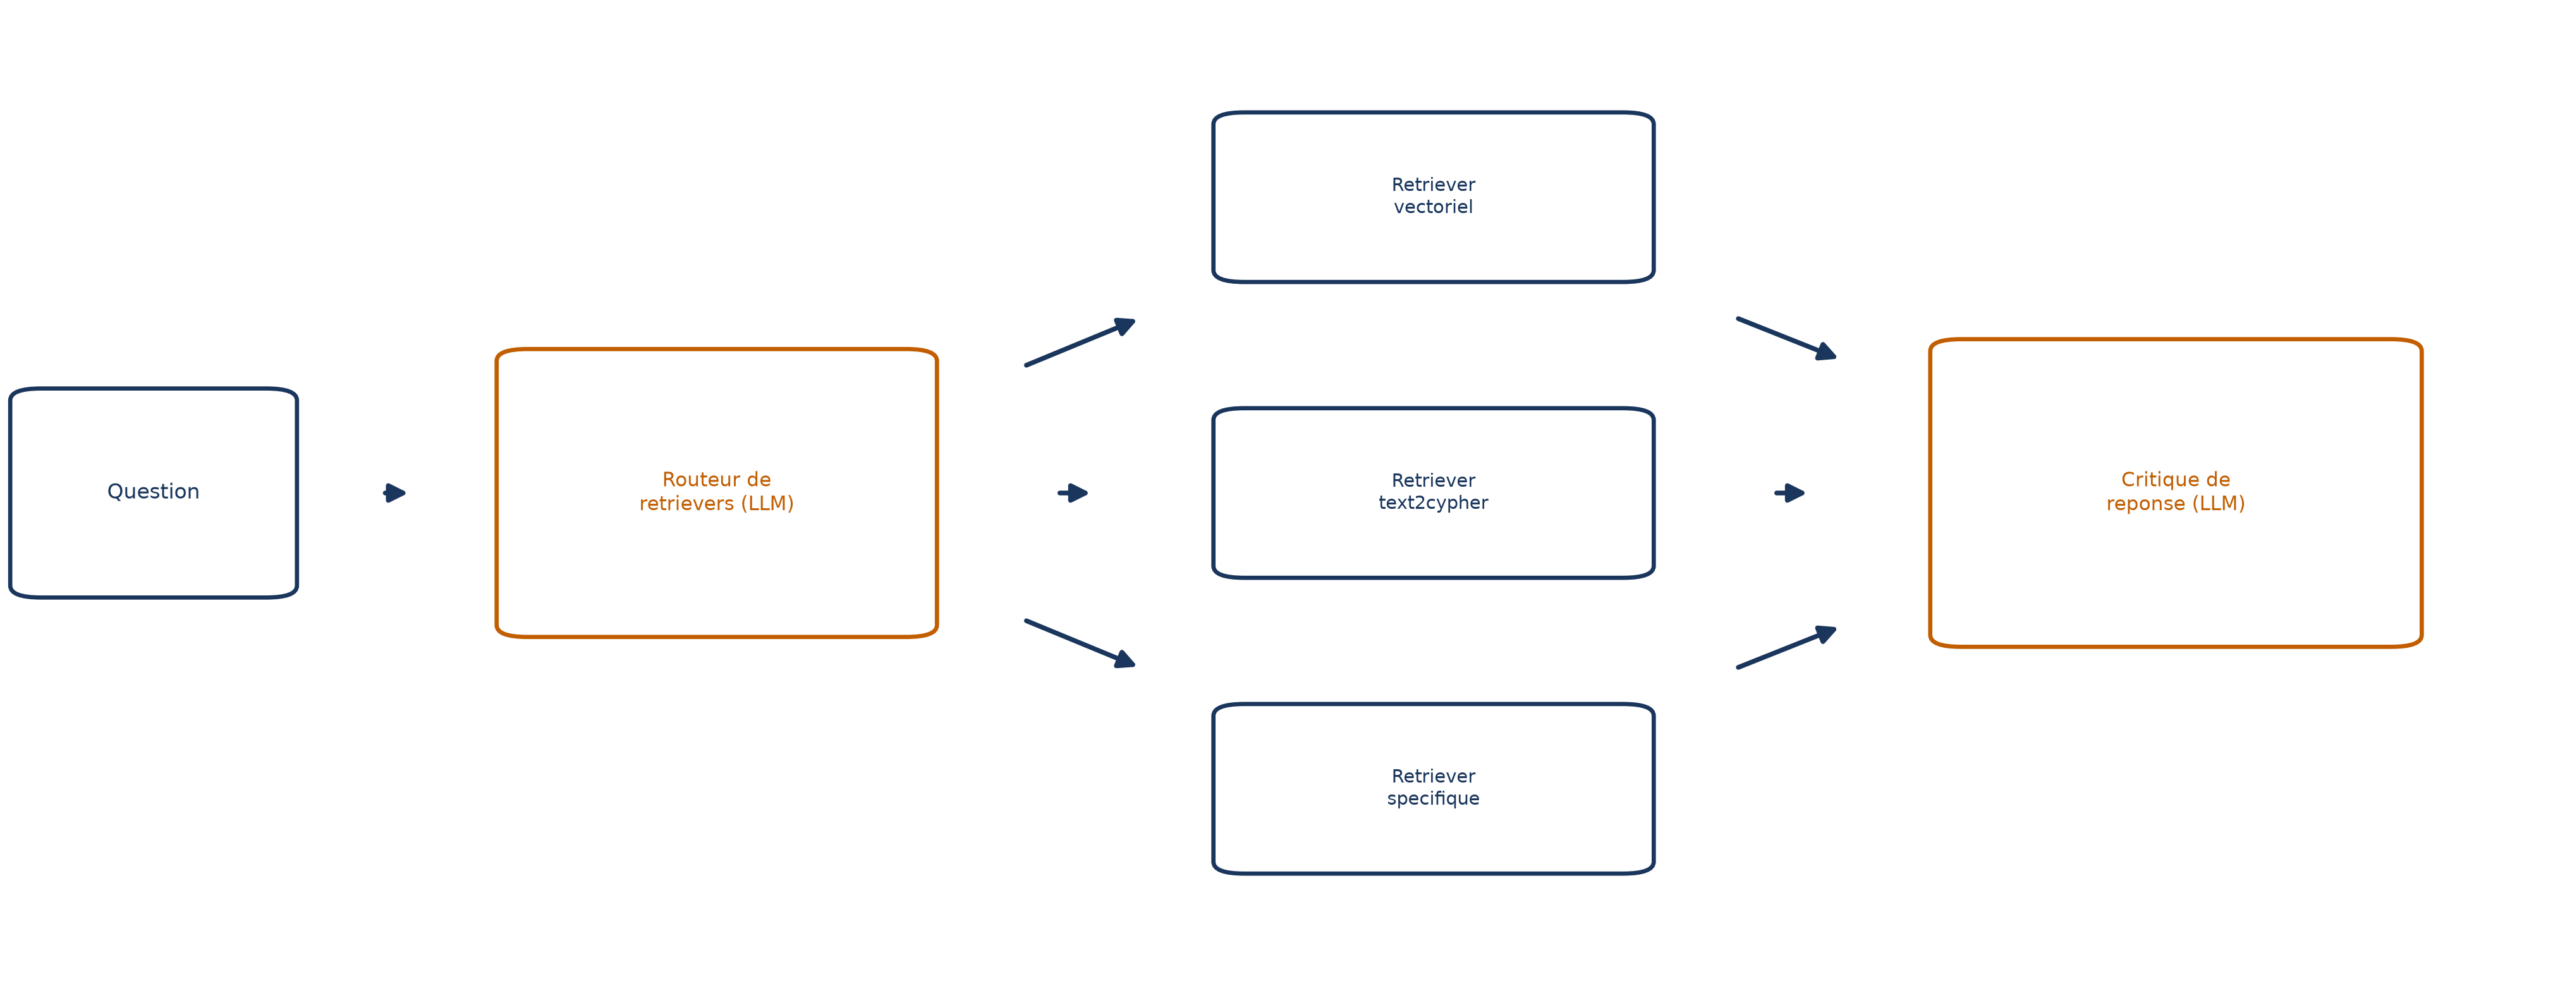
Ce qui définit l’agent retriever, c’est la séparation de ses deux faces. L’étiquette est ce que lit le modèle : un nom, une description en langage courant, la liste des paramètres à fournir. Le corps est ce qui s’exécute quand l’outil est appelé : une requête de base de données, une recherche vectorielle, ou les deux enchaînées.
| Étiquette | Corps | |
|---|---|---|
| Ce qu’elle contient | nom, description, paramètres attendus | la fonction qui interroge la base |
| Qui s’en sert | le modèle qui choisit l’outil | le système qui exécute l’appel |
| Ce qu’elle détermine | quel outil est retenu, avec quels arguments | ce qui est réellement cherché et renvoyé |
💡 Intuition Pense à une caisse à outils dont chaque outil porte une étiquette. Le chef de chantier ne démonte rien pour savoir à quoi sert un outil : il lit l’étiquette, puis dit « passe-moi celui-là, avec ces réglages ».
C’est ce qui distingue un agent retriever d’un retriever tout court, qui reçoit une requête et rend des documents classés par pertinence. La fiche permet à un modèle de le choisir parmi d’autres, et son corps ne se limite pas à classer des documents : celui que tu vas lire maintenant renvoie des lignes de résultat d’une requête.
Lire une étiquette : l’outil de repli
Dans la boîte à outils de l’exemple, deux outils étroits existent : l’un retrouve un film par son titre, l’autre par un acteur. Aucun ne sait agréger des notes, et c’est un troisième outil, s’appuyant sur text2cypher, qui prend les autres questions. Voici les deux faces de cet outil dans le même extrait.
text2cypher_description = {
    "type": "function",
    "function": {
        "name": "text2cypher",
        "description": "Query the database with a user question. When other
tools don't fit, fallback to use this one.",
        "parameters": {
            "type": "object",
            "properties": {
                "question": {
                    "type": "string",
                    "description": "The user question to find the answer for",
                }
            },
            "required": ["question"],
        },
    },
}

def text2cypher(question: str):
    """Query the database with a user question."""
    t2c = Text2Cypher(neo4j_driver)
    t2c.set_prompt_section("question", question)
    cypher = t2c.generate_cypher()
    records, _, _ = neo4j_driver.execute_query(cypher)
    return [record.data() for record in records]
Le premier bloc, text2cypher_description, est l’étiquette : un dictionnaire au format JSON schema. Il donne le nom de l’outil, sa description et un unique paramètre obligatoire, question, une chaîne de caractères qui reçoit la question de l’utilisateur telle quelle. Compare avec les outils étroits de la même boîte, dont l’un demande un title et l’autre un actor : outil étroit, paramètres précis : plus il se resserre, plus ses paramètres se précisent, alors que le retriever de repli se contente de la question brute.
Regarde la seconde phrase de la description : « When other tools don’t fit, fallback to use this one ». Le rôle de l’outil est écrit en toutes lettres. Le modèle qui choisit sait ainsi qu’il doit y recourir seulement quand aucun outil plus spécifique ne convient, sans qu’aucune règle supplémentaire soit nécessaire dans le système.
Le second bloc, la fonction text2cypher, est le corps. neo4j_driver relie le code à la base de graphe Neo4j. La question est d’abord glissée dans une section du prompt de la classe Text2Cypher, qui fabrique la requête Cypher (generate_cypher) ; execute_query la lance, et chaque ligne du résultat devient un dictionnaire.
Derrière l’étiquette, des corps très différents
Rien n’oblige un retriever à chercher d’une façon plutôt qu’une autre : la similarité vectorielle est la méthode la plus courante, sans être la seule. Derrière une étiquette, on peut donc loger des corps très différents :
- un gabarit de requête codé en dur, étroit mais très performant sur ce pour quoi il a été conçu ;
- une requête générée à la demande par un modèle, comme dans text2cypher ;
- une recherche par similarité vectorielle, adaptée aux sources non structurées.
Les deux premiers s’opposent par un compromis connu : un modèle de requête prédéfini est rigide mais fiable, une requête produite par un LLM est plus souple mais pas fiable à 100 %.
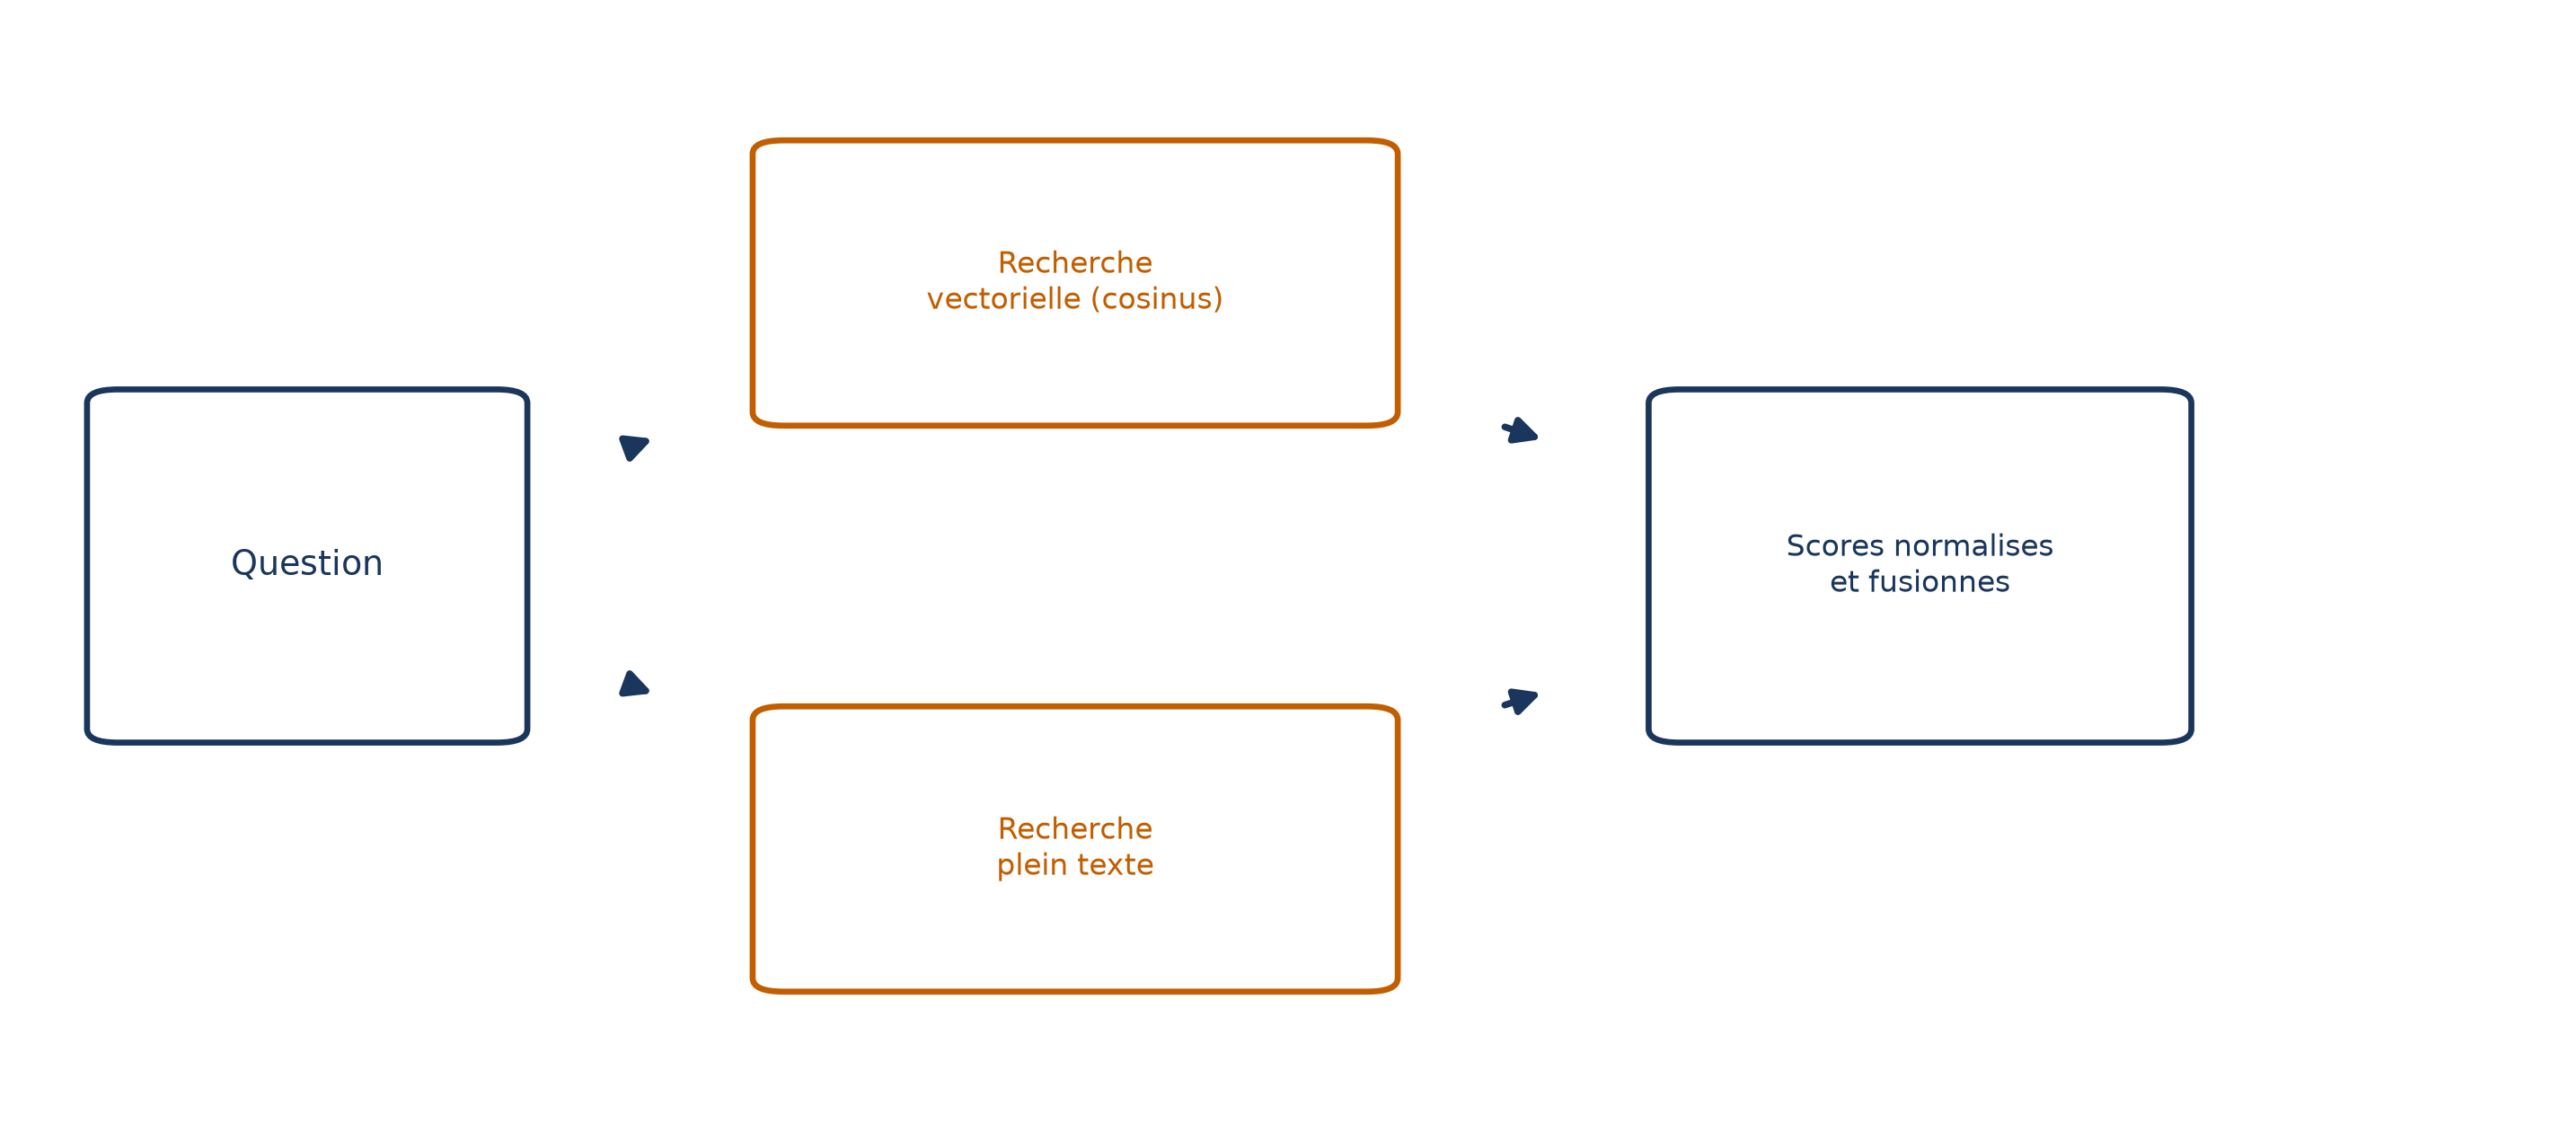
Un corps peut aussi faire travailler deux moteurs à la fois. Voici une recherche hybride, testée sur un article consacré aux brevets et inventions d’Einstein : elle interroge un index vectoriel et un index de texte intégral dans la même requête.
CALL {
    // vector index
    CALL db.index.vector.queryNodes('pdf', $k, $question_embedding)
YIELD node, score
    WITH collect({node:node, score:score}) AS nodes, max(score) AS max
    UNWIND nodes AS n
    // Normalize scores
    RETURN n.node AS node, (n.score / max) AS score
    UNION
    // keyword index
    CALL db.index.fulltext.queryNodes('ftPdfChunk', $question, {limit: $k})
    YIELD node, score
    WITH collect({node:node, score:score}) AS nodes, max(score) AS max
    UNWIND nodes AS n
    // Normalize scores
    RETURN n.node AS node, (n.score / max) AS score
}
// deduplicate nodes
WITH node, max(score) AS score ORDER BY score DESC LIMIT $k
RETURN node, score
Les trois mots précédés d’un  k
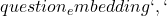 question
UNION réunit les deux listes, puis on garde pour chaque nœud son meilleur score, on trie et on coupe à $k.
Trois façons de choisir le retriever à appeler
Le choix le plus courant passe par la lecture des étiquettes : un modèle de langage reçoit la question et la liste des fiches, puis désigne l’outil retenu et ses arguments.
On peut aussi se passer de cette lecture. Tu prépares une liste de questions d’exemple, chacune associée à sa route (la base de la banque, celle de l’assurance, celle de la finance). Ces questions sont transformées en vecteurs et stockées ; à l’arrivée d’une nouvelle question, on cherche les exemples les plus semblables et l’on prend la route du meilleur d’entre eux.
Troisième voie : classer la question, par son intention, par des métadonnées ou par sa ressemblance avec un jeu de requêtes prédéfinies. Un assistant de support technique peut ainsi envoyer les questions techniques vers une base de dépannage et celles de facturation vers les informations de compte.
Quelle que soit la méthode, le retriever appelé reste le même objet. Seule change la manière de l’atteindre.
Trois idées reçues
« Un agent retriever est un agent autonome »
Le mot trompe. Dans cette architecture, un agent retriever peut n’être qu’un gabarit de requête codé en dur, qui prend des paramètres : la même requête, avec un autre nom ou un autre titre. Le point d’entrée du système, lui, est le routeur, dont le rôle est de trouver les retrievers les mieux adaptés à la tâche en cours. L’initiative est là-haut ; les retrievers exécutent.
« Le modèle écrira toujours la bonne requête »
Un retriever text2cypher fait rêver : une question en langage courant, une requête en sortie. Mais les modèles ont tendance à se tromper en générant du Cypher, surtout quand la question est complexe ou ambiguë, ou que les éléments du schéma ne sont pas nommés assez explicitement. Pour le fiabiliser, on soigne le prompt avec des exemples few-shot, le schéma du graphe, des correspondances de terminologie et des consignes de format. En ajoutant des exemples sur les types de questions qui posent problème, on voit la qualité des requêtes s’améliorer au fil du temps. Des modèles ajustés à cette seule tâche existent aussi et peuvent améliorer les performances, notamment en production, là où la latence compte.
« Un retriever vectoriel renvoie le texte qu’il a comparé »
Dans sa version la plus simple, oui. Mais rien n’oblige à transformer en vecteur exactement le texte que l’on veut renvoyer : on peut tout aussi bien le faire sur des sections plus pertinentes, des questions synthétiques ou des reformulations.
Le parent document retriever en est l’exemple. Le document d’origine, le parent, est découpé en fragments plus petits, les enfants, chacun transformé en vecteur séparément. Quand un enfant correspond à la question, c’est le parent entier qui est renvoyé, pour conserver tout le contexte utile au modèle. La raison : vectoriser un parent entier dilue ses idées distinctes par un effet de moyenne, ce qui complique la correspondance avec une question précise.
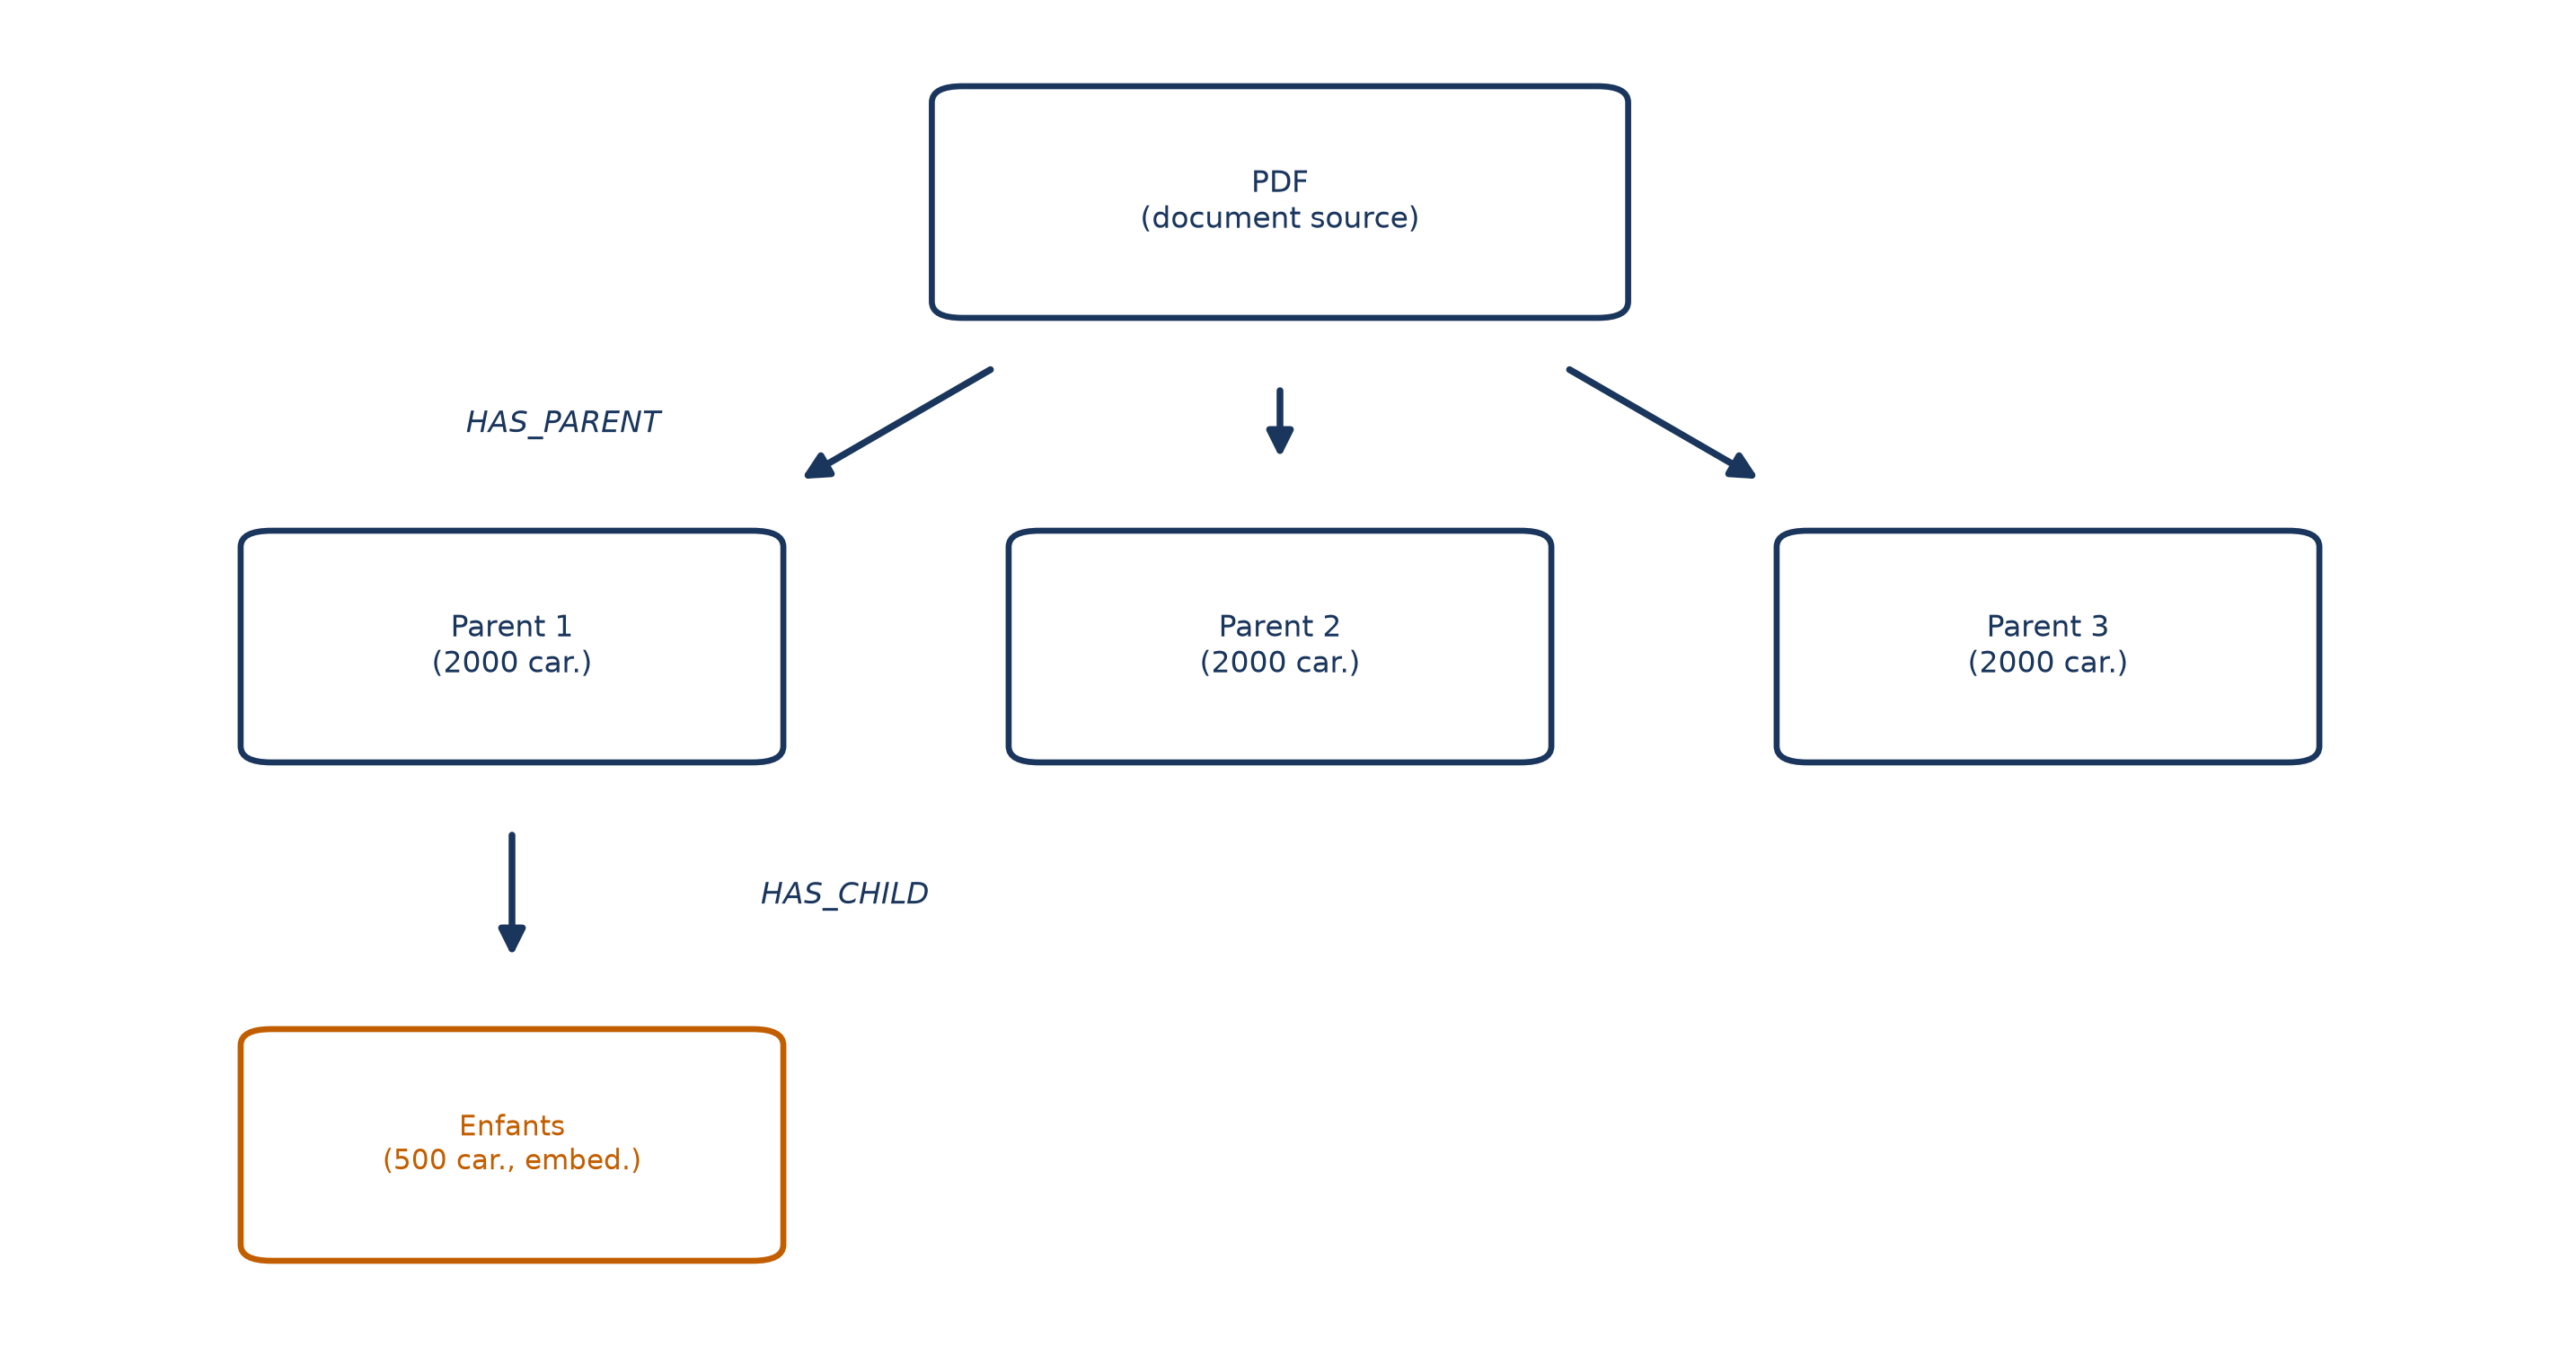
HAS_CHILD.CALL db.index.vector.queryNodes($index_name, $k * 4, $question_embedding)
YIELD node, score
MATCH (node)<-[:HAS_CHILD]-(parent)
WITH parent, max(score) AS score
RETURN parent.text AS text, score
ORDER BY score DESC
LIMIT toInteger($k)
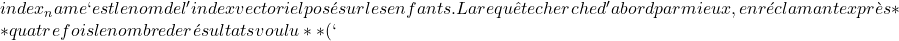 k * 4
MATCH (node)<-[:HAS_CHILD]-(parent) remonte à chaque parent, max(score) retient le meilleur enfant de chacun, puis on garde les $k premiers parents.
📌 À retenir Une étiquette lisible en haut, un corps libre en bas : cette séparation permet de ranger côte à côte un gabarit de requête, une génération de requête par modèle et une recherche hybride. Le routeur compare des étiquettes, jamais des corps.