Un agent dispose de plusieurs outils : un calculateur branché sur Wolfram Alpha, un déclencheur Zapier, un envoi de message Slack. Un utilisateur lui écrit « Solve this equation: 2x + 3 = 7 ». Le nom d’aucun outil n’apparaît dans la phrase, et la description du calculateur parle de « compute expressions », pas d’« equation ». Pourtant, il faut bien choisir. L’agent y parvient en cherchant ce qui est proche, jamais ce qui est identique : voilà ce qu’on appelle une recherche vectorielle, et tu vas la suivre pas à pas, du nombre jusqu’à l’index.
Sommaire
- L’essentiel en 30 secondes
- Chercher une position plutôt qu’un mot
- « Proche » se calcule : du produit scalaire au cosinus
- Une requête de bout en bout : choisir un outil
- Un index entre la question et les voisins
- Où ranger les vecteurs, et à quel prix
- Plus qu’une recherche de passages
- Trois choses qu’elle ne sait pas faire
L’essentiel en 30 secondes
- Une recherche vectorielle compare des positions, pas des mots : la requête et chaque texte deviennent des vecteurs, et l’on garde les plus proches.
- Un vecteur est une liste de nombres de longueur fixe, produite par un modèle d’embedding, le même pour la requête et pour les textes.
- La proximité se mesure surtout par le cosinus de l’angle, parce que le produit scalaire brut favorise les vecteurs longs.
- Un index range les vecteurs pour trouver vite les voisins, au prix d’une réponse parfois seulement approchée.
- Elle sert à retrouver des passages, mais aussi à choisir un outil ou une route ; elle ne sait ni compter ni agréger.
Chercher une position plutôt qu’un mot
Avant de chercher, il faut savoir ce qu’on cherche. Un vecteur n’a rien de mystérieux : c’est une liste ordonnée de nombres, chaque position désignant une valeur. On peut le dessiner comme une flèche partie de l’origine, dont la longueur (la norme) et la direction portent l’information. Multiplier par 2 double sa longueur ; multiplier par un nombre négatif retourne la flèche.
Reste à transformer un texte en flèche. C’est le métier d’un modèle d’embedding : il avale un texte de longueur quelconque, ou une image, et rend un vecteur de longueur toujours identique qui garde le sens de l’entrée. Tous les contenus se retrouvent alors dans un même espace, où l’on compare des distances avec de simples mathématiques. Le nombre de cases du vecteur, sa dimension, fixe la quantité d’information qu’il peut porter, au prix d’un calcul de plus en plus coûteux.
💡 Intuition Imagine chaque texte comme une épingle plantée sur une carte géante, avec des centaines de dimensions au lieu de deux. Poser une question, c’est planter une nouvelle épingle et regarder quelles épingles se trouvent tout autour.
La recherche vectorielle tient alors en deux gestes : convertir la requête en vecteur, puis retrouver les vecteurs les plus proches du sien. La règle d’or est d’utiliser le même modèle que pour les textes, sans jamais en changer en cours de route : un autre modèle placerait les épingles ailleurs, et il faudrait recalculer tout l’index.
« Proche » se calcule : du produit scalaire au cosinus
Dire que deux vecteurs sont proches suppose une règle de mesure. La plus directe est le produit scalaire : on multiplie les cases deux à deux, puis on additionne.
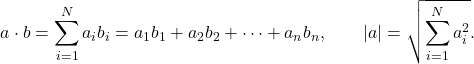
Ici  et
 sont les cases des deux vecteurs,
 leur dimension, et
 la norme de
 , c’est-à-dire sa longueur. Le résultat est grand quand les deux vecteurs ont de grandes valeurs dans les mêmes dimensions, et nul quand ils sont orthogonaux, donc sans rapport.
Le produit scalaire a pourtant trois défauts. Il favorise les vecteurs longs, il avantage les vecteurs aux valeurs élevées (en général ceux des mots très fréquents, donc peu utiles), et sa valeur n’est pas bornée : impossible de dire si un score est « bon » sans point de comparaison.
Le remède consiste à normaliser, c’est-à-dire à diviser par les normes. On obtient le cosinus de l’angle entre les deux vecteurs :
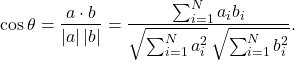
Au numérateur, le produit scalaire de tout à l’heure ; au dénominateur, le produit des deux longueurs. Une fois ces longueurs divisées, il ne reste que la direction.
Le résultat reste compris entre −1 et 1 : −1 pour des vecteurs opposés, 0 pour des vecteurs orthogonaux, 1 pour des vecteurs parfaitement semblables. Comme la longueur n’influence pas le résultat, étirer un vecteur ne change rien au score. Le calcul est rapide, il fonctionne en grande dimension, et il réagit moins à la fréquence des mots, donc il supporte mieux les valeurs aberrantes.
Le cosinus n’est pas le seul choix. La distance euclidienne en est un autre, où une petite distance signale des vecteurs proches. Pour des textes, on retient plutôt l’angle que l’intensité brute, ce qui convient bien aux agents conversationnels.
Une requête de bout en bout : choisir un outil
Revenons à notre agent. Les vecteurs de son catalogue d’outils se calculent une seule fois, puis restent prêts à être retrouvés. À l’arrivée d’une requête, on la code avec le même modèle, on interroge la base, et l’outil le plus proche sort.
def select_tool(query: str, top_k: int = 1) -> list:
   """
   Select the most relevant tool(s) based on the user's query using
   vector-based retrieval.

   Args:
       query (str): The user's input query.
       top_k (int): Number of top tools to retrieve.

   Returns:
       list: List of selected tool functions.
   """
   query_embedding = embeddings.embed_text(query).astype('float32')
   faiss.normalize_L2(query_embedding.reshape(1, -1))
   D, I = index.search(query_embedding.reshape(1, -1), top_k)
   selected_tools = [index_to_tool[idx] for idx in I[0] if idx in index_to_tool]
   return selected_tools
Lis la fonction ligne à ligne. embeddings, index et index_to_tool sont préparés en amont : le modèle d’embedding, l’index qui contient les vecteurs des outils, et un dictionnaire qui relie la position d’un vecteur à l’outil correspondant. La première ligne utile encode la requête, la deuxième normalise le vecteur.
Vient ensuite le cœur : index.search(…, top_k) renvoie deux tableaux, que le code nomme D et I. Seul I sert ici, parce qu’il donne les positions des voisins retrouvés ; top_k fixe leur nombre, ici un seul par défaut. La dernière ligne traduit ces positions en noms d’outils.
Pour « Solve this equation: 2x + 3 = 7 », on attend que l’outil de calcul remonte, sans qu’un seul mot de la requête ne coïncide avec sa description. Une fois l’outil choisi, un modèle de langage déduit ses paramètres à partir de la requête, puis l’outil est appelé.
Un index entre la question et les voisins
Dans la fonction précédente, index.search fait tout le travail. Qu’y a-t-il derrière ? Un index vectoriel, une structure de données qui organise les vecteurs pour en retrouver vite les plus proches. Il n’est pas strictement indispensable, mais il est vivement recommandé.
Prenons un autre exemple, dans une base de graphe. Chaque fragment de texte y devient un nœud portant deux propriétés : son texte et son embedding. L’index est bâti sur la seconde.
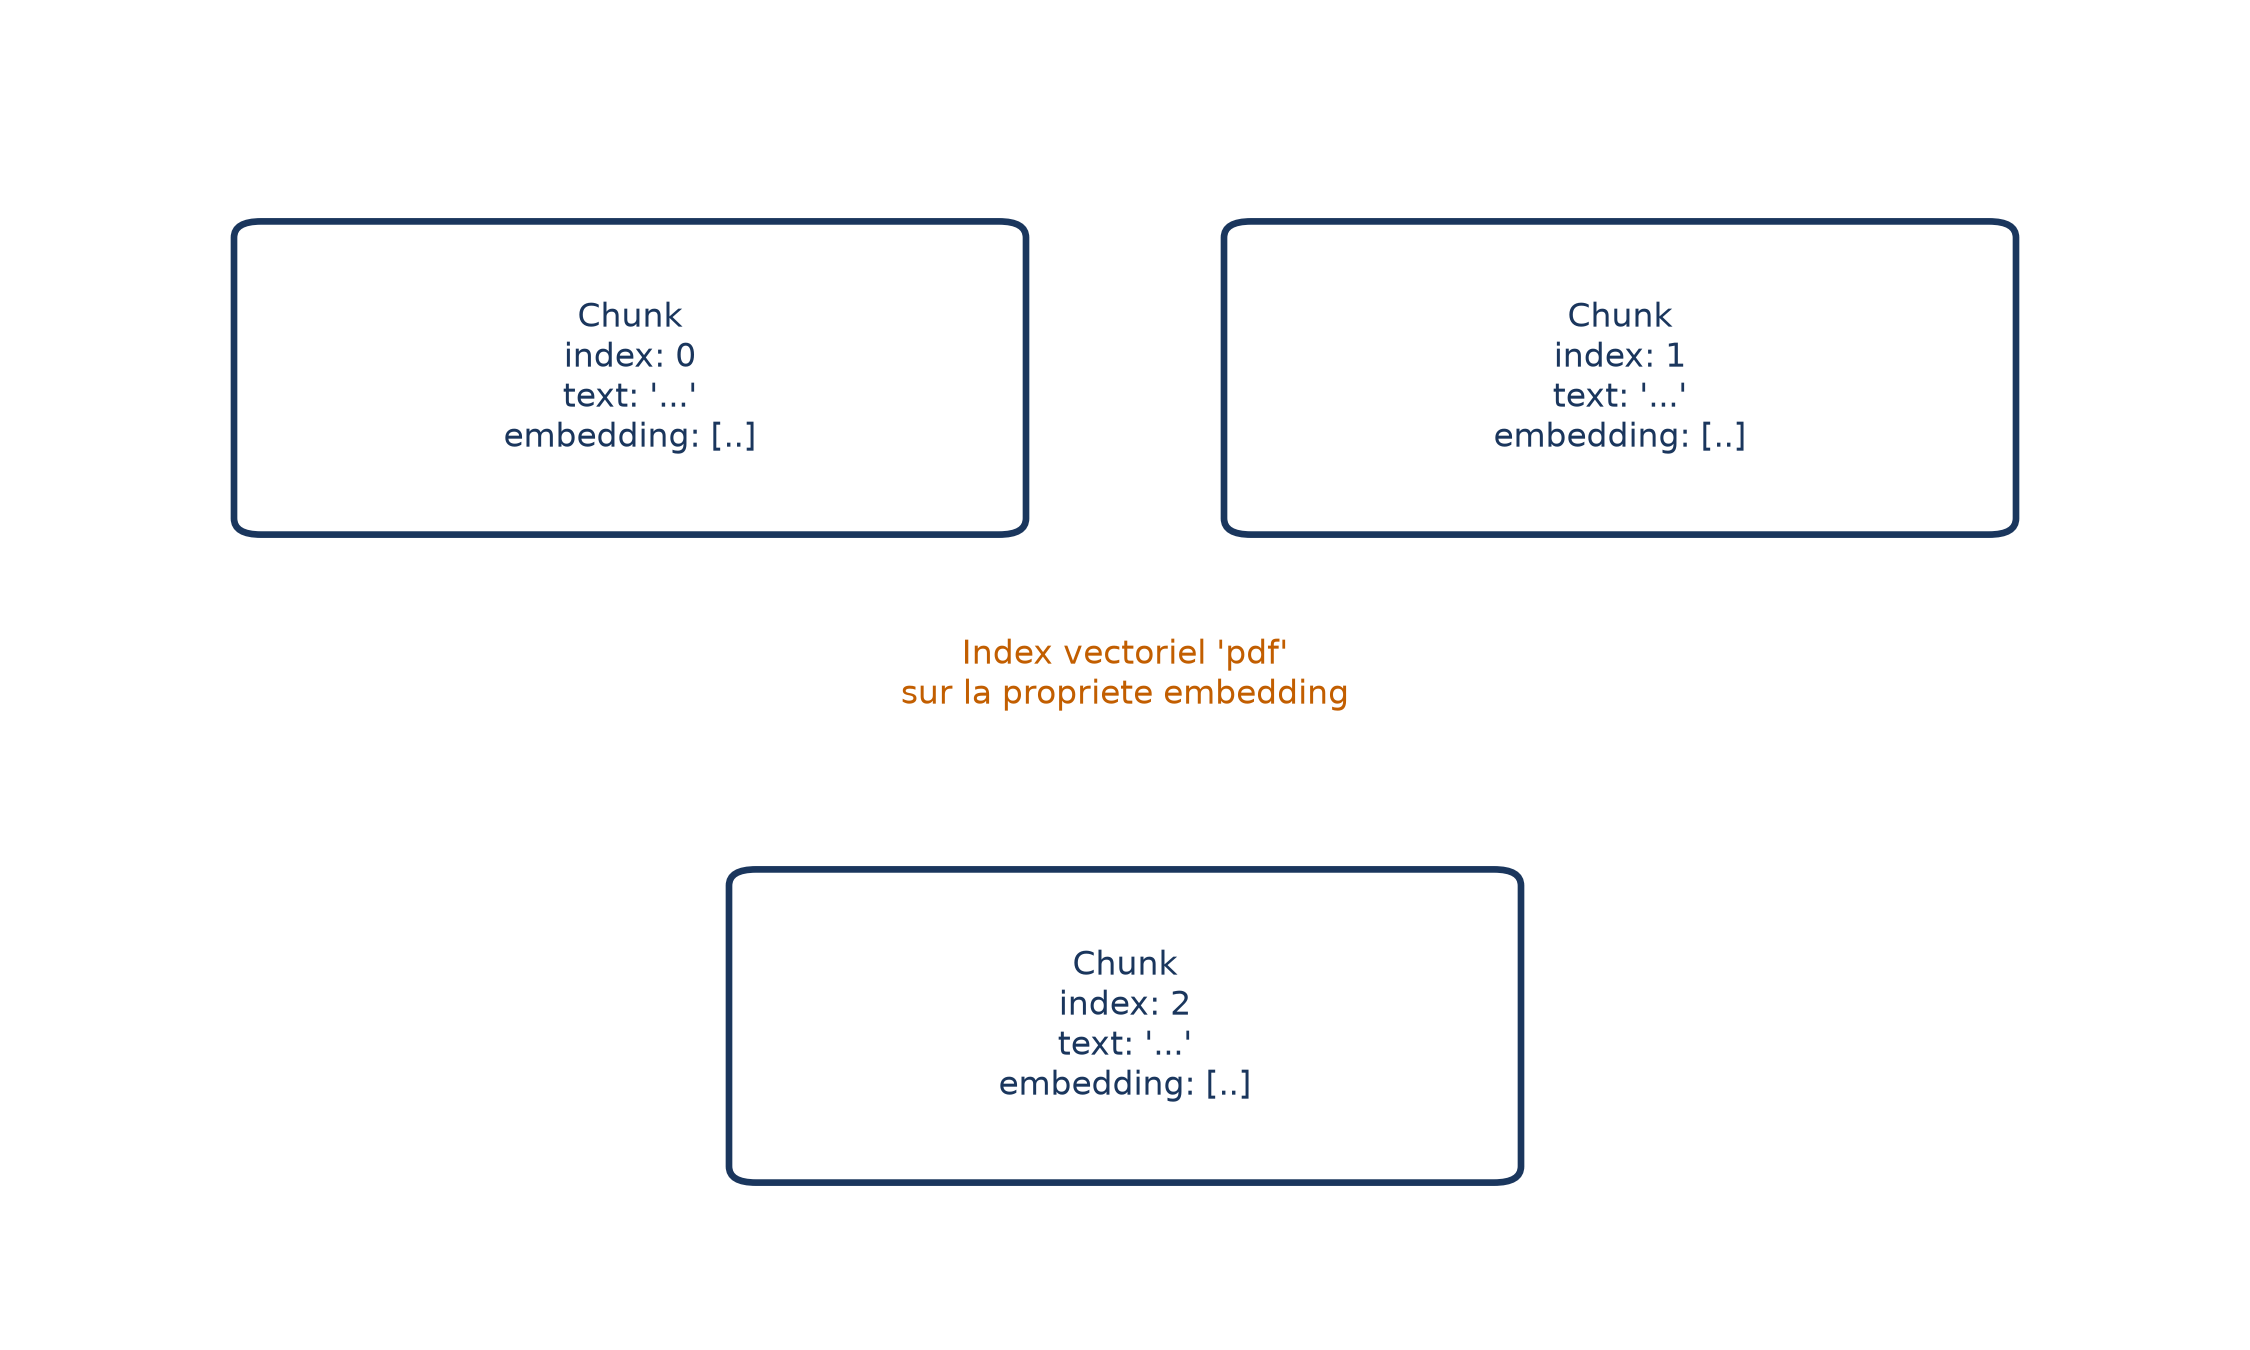
driver.execute_query("""CREATE VECTOR INDEX pdf IF NOT EXISTS
FOR (c:Chunk)
ON c.embedding""")
La commande crée, s’il n’existe pas déjà, un index nommé pdf sur les embeddings de tous les nœuds de type fragment. Il doit tenir compte du nombre de dimensions des vecteurs, ici 1536, puisque c’est ce que produit le modèle choisi ; il compare par similarité cosinus. Si tu changes un jour de modèle et que la dimension change, il faudra recréer l’index.
Pour l’interroger, on transforme la question en embedding avec le même modèle, puis on appelle l’index :
CALL db.index.vector.queryNodes('pdf', 2, $question_embedding) YIELD node
AS hits, score
RETURN hits.text AS text, score, hits.index AS index
queryNodes reçoit trois choses : le nom de l’index, le nombre de voisins voulus (ici 2) et le vecteur de la question. Il rend chaque nœud trouvé avec son score de similarité, dont la requête extrait le texte et la position.
Une question reste en suspens : l’index trouve-t-il le voisin exact ? Pas toujours. Beaucoup d’index pratiquent la recherche du plus proche voisin approchée : ils renvoient un voisin très proche, sans garantir que ce soit le tout premier, en échange de la vitesse. L’indexation Flat, elle, reste exacte mais bien plus lente ; HNSW accepte de perdre un peu de précision pour gagner beaucoup de temps.
📌 À retenir Un index promet des voisins très proches, rapidement. Il ne promet pas le plus proche à coup sûr : c’est le prix de la vitesse.
Où ranger les vecteurs, et à quel prix
Une base de données vectorielle est une base spécialisée pour stocker, indexer et chercher efficacement des vecteurs de grande dimension. Il en existe des dizaines, et il n’y en a probablement pas de meilleure dans l’absolu : il y en a une qui convient à ton projet. Les critères qui départagent :
| Critère | Ce qu’il tranche |
|---|---|
| Libre ou propriétaire | Transparence et personnalisation contre support dédié ; la licence peut être incompatible avec ton produit |
| Langages et maturité | Compatibilité avec ta pile technique ; stabilité et suivi en production |
| Performance | Vitesse d’insertion (le rythme d’ajout des vecteurs) et vitesse de requête (le temps de réponse) |
| Intégration | Toutes les bases n’acceptent pas un reranker ou une recherche hybride |
| Coût | Cloud parfois très cher, maintenance et support compris |
Le choix dépend aussi du trafic à servir. Deux profils s’opposent : les remplissages à haut débit (indexer des millions de documents, mettre à jour un catalogue) et les consultations à faible latence (requêtes d’utilisateurs, où chaque milliseconde compte). Si tu dois faire les deux et que le trafic justifie le coût, il vaut mieux bâtir un système distinct pour chacun.
Reste la taille du vecteur lui-même. Une piste consiste à entraîner l’encodeur pour que l’information essentielle se concentre dans les premières cases du vecteur, la perte d’entraînement tenant compte de la qualité à plusieurs dimensions. Résultat : on coupe la fin du vecteur sans trop perdre en performance, et la base stocke des vecteurs plus petits.
Plus qu’une recherche de passages
Retrouver des passages de texte est l’emploi le plus connu. Ce n’est pas le seul, car chercher du « proche » sert partout où l’on hésite entre plusieurs options.
Aiguiller une question. Un routeur sémantique garde une liste de requêtes d’exemple, chacune associée à sa route. Ces exemples sont convertis en vecteurs et rangés dans une base ; à l’arrivée d’une requête, on cherche l’exemple le plus semblable et l’on prend sa route. Imagine une entreprise avec trois domaines, banque, assurance et finance : pour des raisons de réglementation et de vie privée, le chatbot ne doit pas fouiller les dossiers d’un autre service, et chercher partout serait lent et brouillon.
Ouvrir la porte d’un graphe. Pour une question centrée sur une entité (« What are the healing properties of chamomile ? »), une recherche vectorielle repère d’abord les entités du graphe qui ont un rapport de sens avec elle. Ces entités deviennent des points d’entrée pour récupérer leurs voisines directes, leurs relations, des résumés de communauté et des fragments de texte.
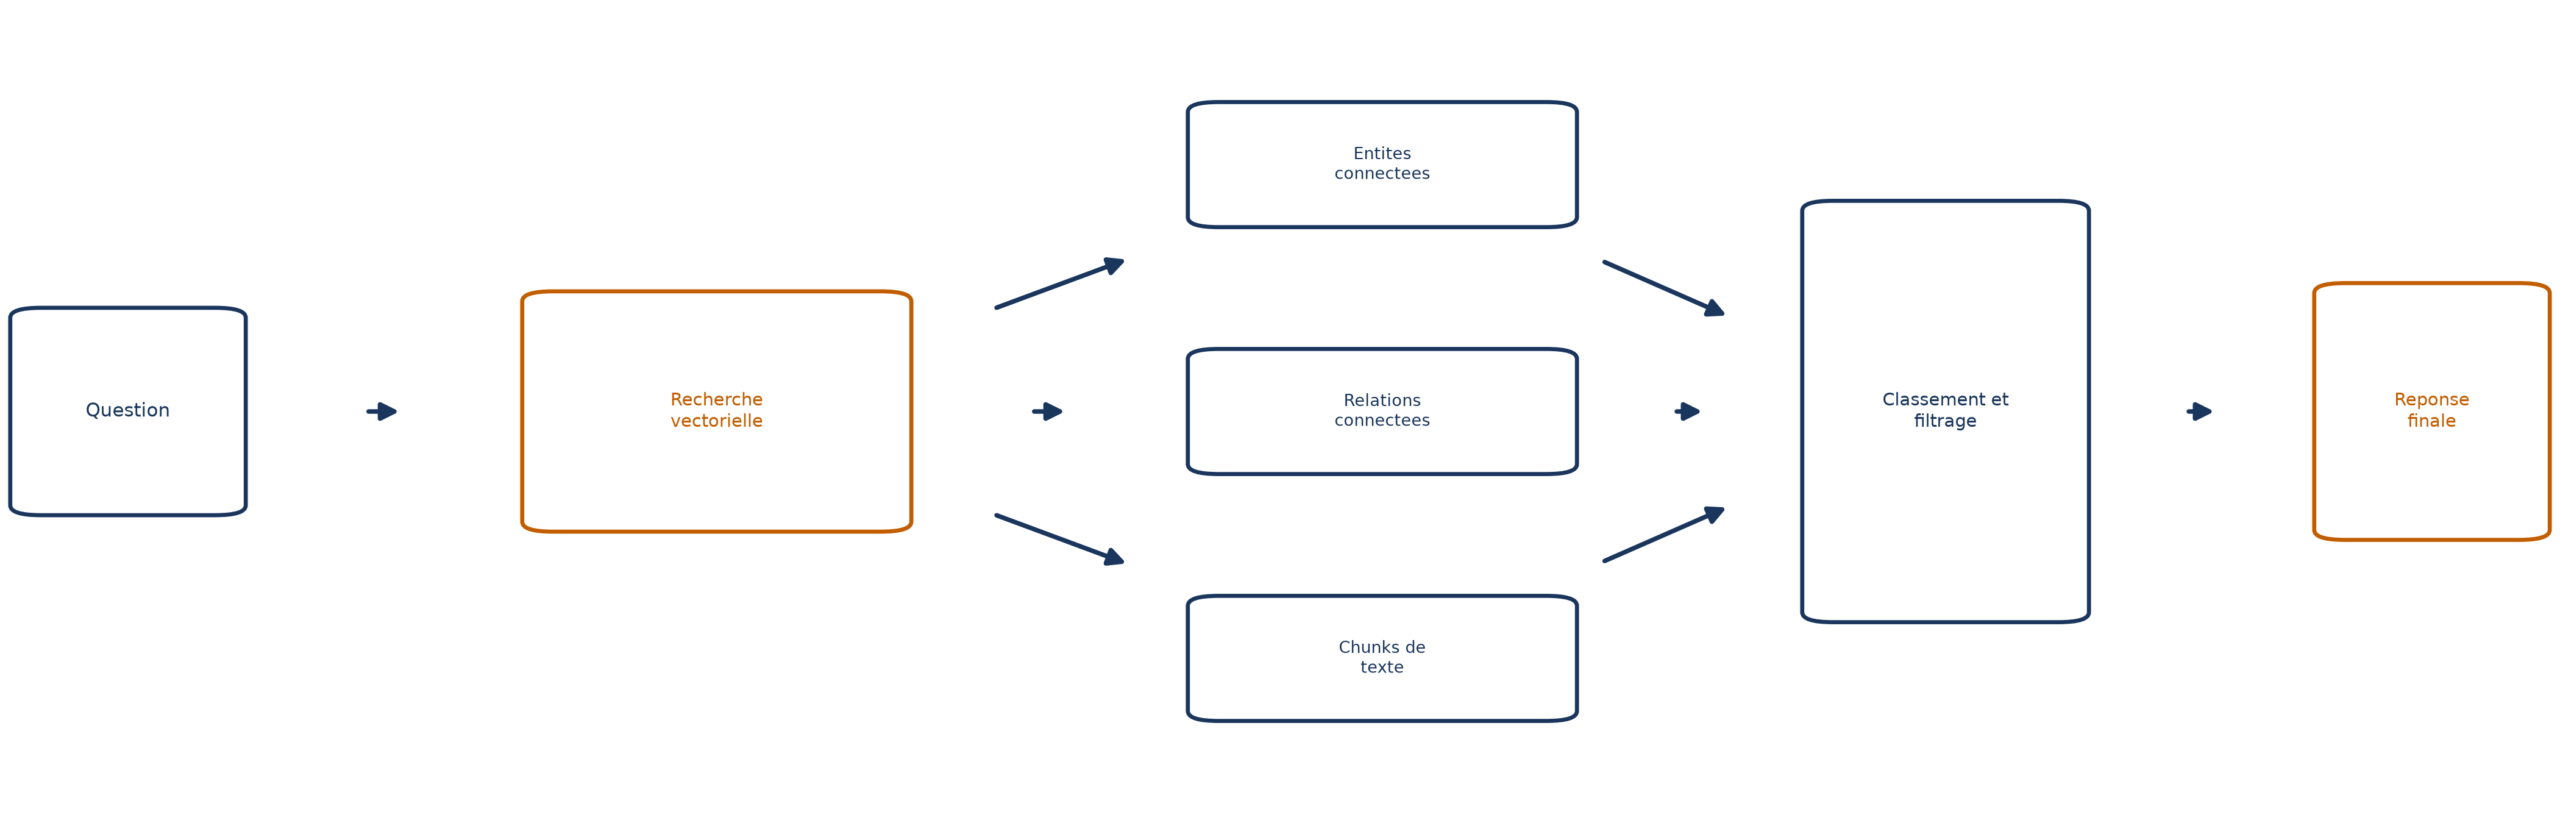
Ces mêmes vecteurs, rangés dans une base, alimentent aussi les mémoires d’agents, la recherche et les systèmes de recommandation.
Trois choses qu’elle ne sait pas faire
Compter, trier, agréger. Prends la question « List the top three highest-rated movies directed by Steven Spielberg and their average score ». Aucune recherche par similarité ne peut y répondre : il faut une requête précise.
MATCH (:Reviewer)-[r:REVIEWED]->(m:Movie)<-[:DIRECTED]-(:Director {name:
'Steven Spielberg'})
RETURN m.title, AVG(r.score) AS avg_rating
ORDER BY avg_rating DESC
LIMIT 3
Cette requête ne cherche pas les nœuds les plus similaires : elle calcule une moyenne par film, trie et garde trois résultats. Voilà un travail d’agrégation, pour lequel une recherche de voisins n’est pas conçue.
⚠️ Piège Une recherche vectorielle répond toujours par « les plus proches », même quand la question demande autre chose que de la proximité. Un résultat qui a l’air plausible ne prouve donc pas que la bonne méthode a été employée.
Décider seule combien de résultats garder. Après une recherche vectorielle, on renvoie les  meilleurs, une coupure arbitraire fixée à l’avance, qui peut faire perdre une information pertinente. Augmenter est la parade la plus simple, mais on ne peut pas tout renvoyer : les résultats ne tiendraient pas dans la longueur de contexte du modèle, et celui-ci peinerait à manier une telle masse d’information.
Rattraper des textes mal décrits. La recherche ne vaut que ce que valent les textes qu’elle compare. Pour des outils, on donne à chacun un nom concis et descriptif (calculate_sum plutôt que process_numbers) et un résumé d’une phrase sur sa finalité propre. Même ainsi, quand le catalogue grandit, le chevauchement des descriptions devient souvent une source d’erreurs de sélection.
Retiens donc l’image de départ : une recherche vectorielle plante ta question sur une carte et lit ce qui l’entoure. Elle excelle quand la réponse est une affaire de voisinage, et se trompe d’outil quand la réponse demande de compter.