« Qu’a fait Geoffrey Hinton ? » Voilà une question toute simple, et pourtant un RAG de base peut y échouer : si aucun fragment récupéré ne couvre ses actions de manière exhaustive, le système n’a rien de complet à lire.
Ce n’est pas un défaut de réglage, c’est le plan même du pipeline : il cherche une fois, lit une fois, et ne vérifie rien. À la fin de cet article, tu sauras décrire ce pipeline de bout en bout, dire ce qui le rend « naïf » et repérer l’endroit exact où une réponse se perd.
Sommaire
- L’essentiel en 30 secondes
- Une seule passe : récupérer, puis lire
- Une question, trois gestes, zéro contrôle
- À quoi il sert : des faits simples, pas des vues d’ensemble
- Où la réponse se perd entre la question et la phrase finale
- Ce que sa structure l’empêche de voir
- Quelle panne, quel ajout : le chemin vers le RAG avancé
- Trois idées reçues à ranger
L’essentiel en 30 secondes
- Un RAG naïf est le pipeline de base : un embedder, une base vectorielle et un LLM, sans étape en plus.
- Il suit le schéma « récupérer puis lire » : une seule recherche, une seule génération, aucun contrôle entre les deux.
- Il est à l’aise sur les faits simples et les questions directes, avec une mise à jour à très faible coût.
- Ses pannes se rangent par étape : trouver, lire, relier ; chacune a son diagnostic.
- Le RAG avancé n’est pas un autre outil : c’est le même pipeline avec un correctif par panne.
Une seule passe : récupérer, puis lire
Un RAG naïf est la forme de base de la génération augmentée par récupération. Il se compose de trois éléments simples : un embedder, qui transforme les textes en vecteurs, une base vectorielle qui sert à la récupération, et un LLM qui génère la réponse. Le texte est d’abord plongé dans la base ; à l’arrivée d’une question, on cherche les fragments qui s’y rapportent et on les donne au LLM.
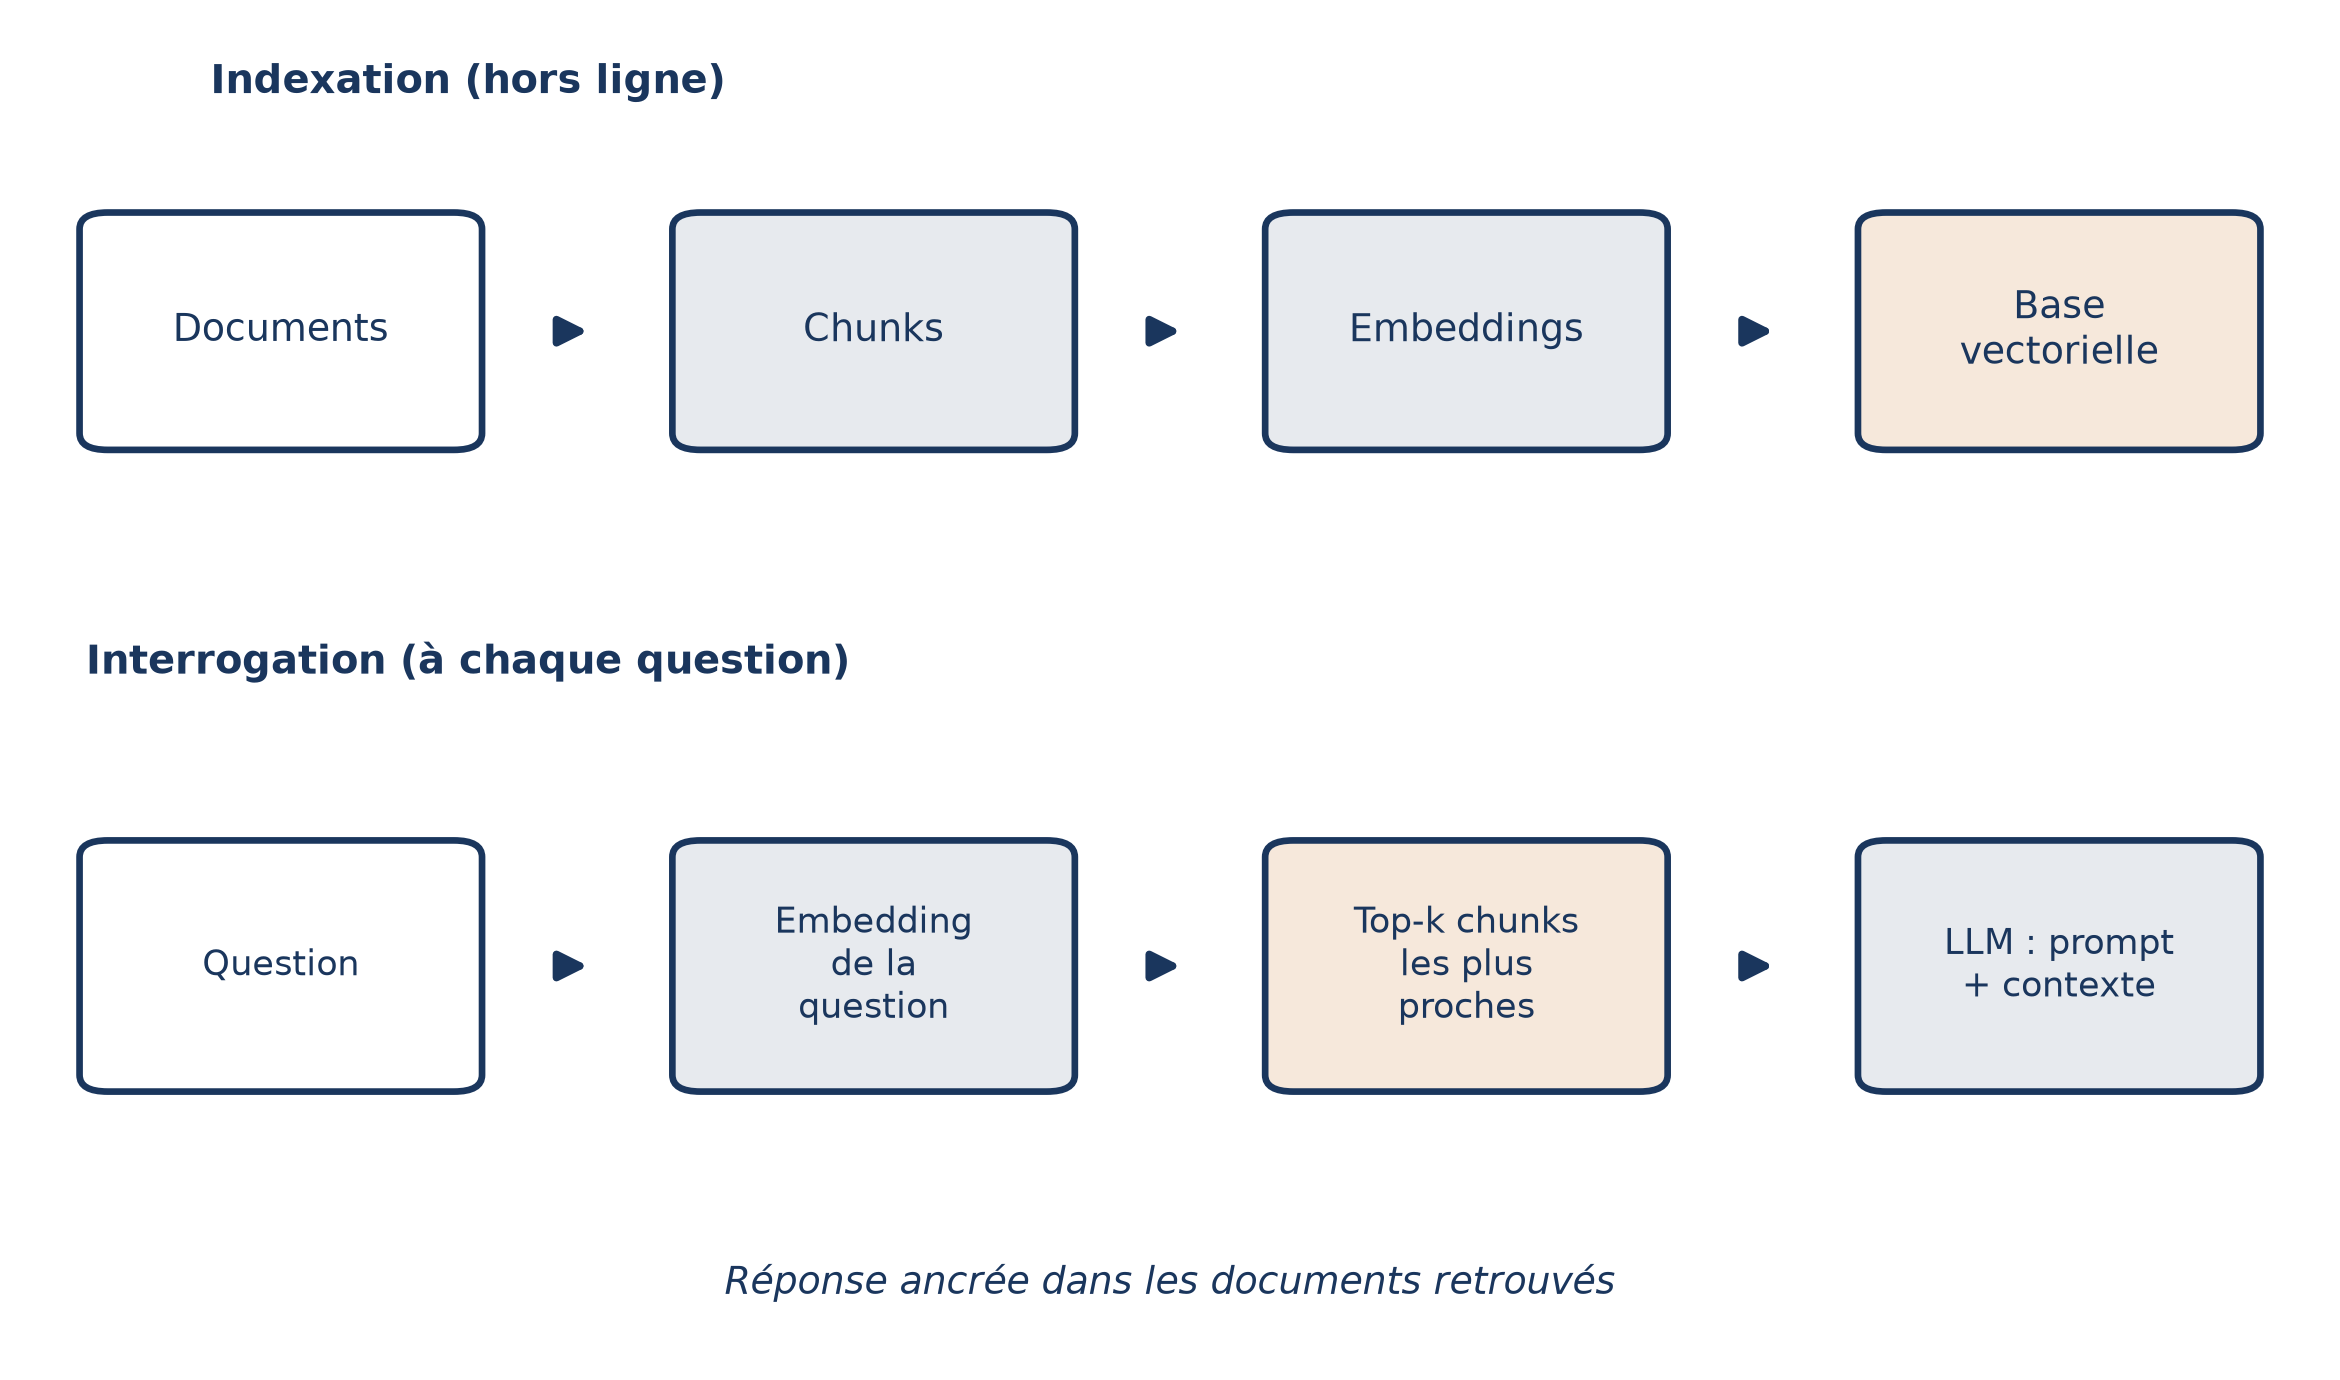
Cette linéarité donne son sens au mot « naïf » : on récupère, puis on lit, et rien d’autre ne se passe entre les deux. Quatre absences expliquent l’adjectif :
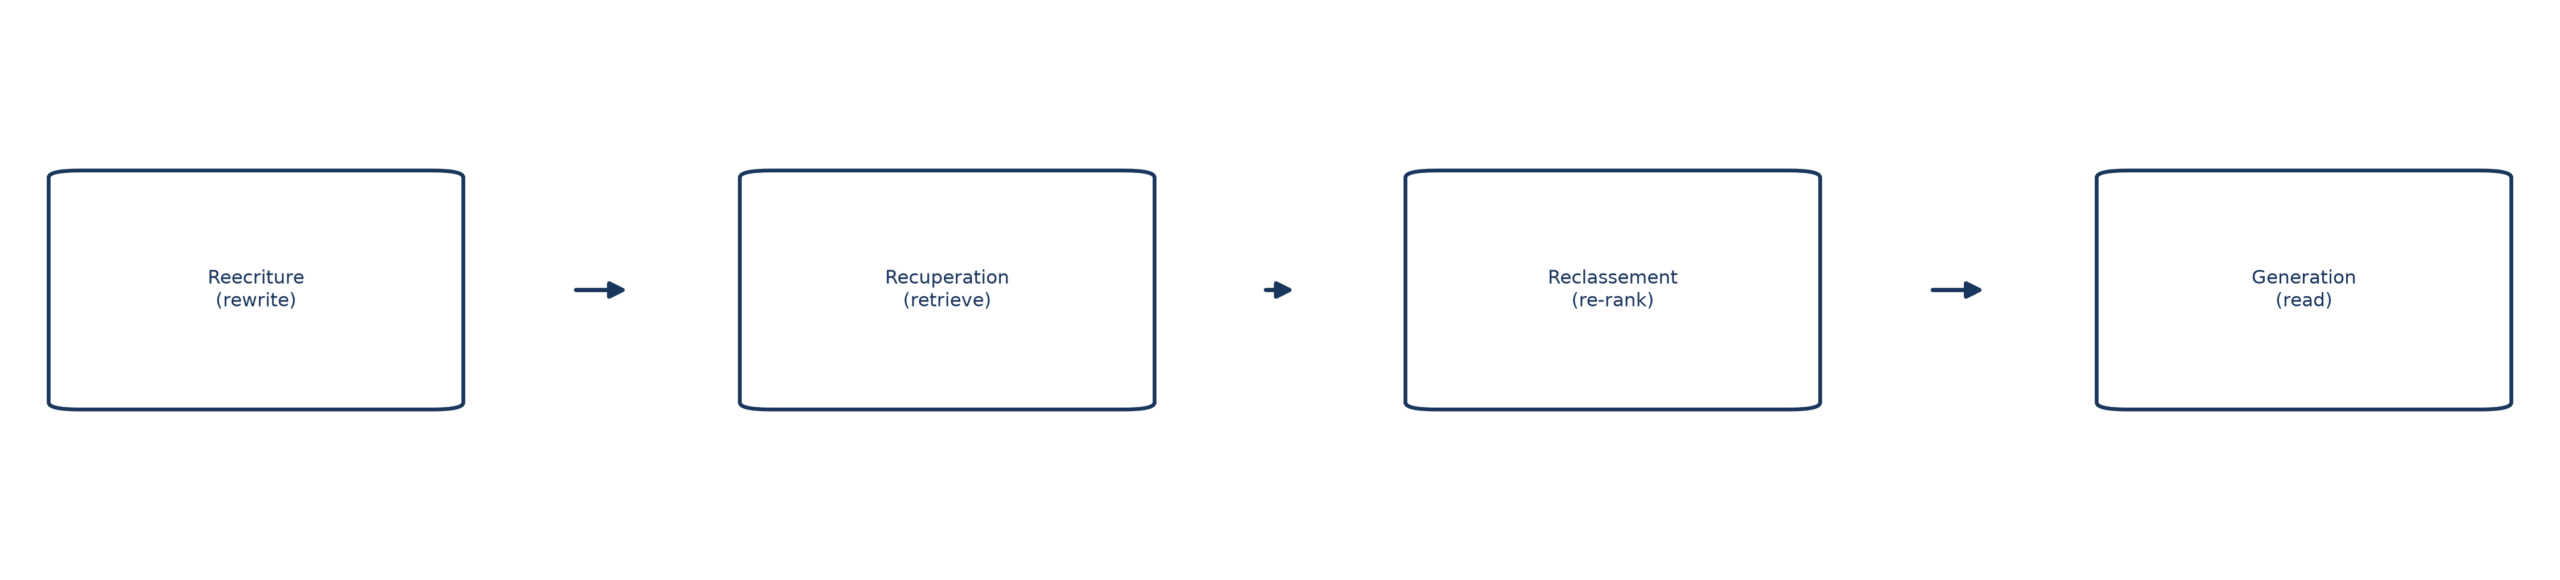
- aucune réécriture de la question avant la recherche, ni re-classement des résultats avant la lecture : les versions plus évoluées ajoutent justement ces deux étapes ;
- un seul niveau de fragments, tous équivalents quel que soit le document d’origine ;
- une seule passe : on récupère une fois, puis on génère, c’est la pratique standard ;
- aucun module de validation qui évalue la réponse et le contexte récupéré pour repérer erreurs ou incohérences.
💡 Intuition Pense à un stagiaire qui reçoit une question, ouvre le classeur à l’endroit dont les mots ressemblent le plus à la question, puis recopie la réponse sans relire ni douter. Rien de honteux, tant que la question est simple et que le classeur est bien rangé.
Une question, trois gestes, zéro contrôle
Suis maintenant une question dans la rangée du bas. Premier geste : on la transforme en vecteur, avec le même encodeur que celui des documents. Deuxième geste : on calcule un score de similarité entre ce vecteur et ceux de la base, puis on garde les K fragments les mieux classés, le top-K. Troisième geste : on assemble un prompt cohérent avec la question et les fragments retrouvés, puis on le passe au LLM.
Combien de code faut-il pour le deuxième geste ? Presque rien. L’exemple ci-dessous recharge un index déjà construit sur la page d’un tournoi sportif, puis l’interroge avec k=2, c’est-à-dire en gardant les deux fragments les plus proches de la question.
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings
import os
os.environ["OPENAI_API_KEY"] = "<YOUR_API_KEY>"

embeddings = OpenAIEmbeddings(model="text-embedding-3-small")
vector_store = FAISS.load_local(
    folder_path="../../Assets/Data",
    index_name="CWC_index",
    embeddings=embeddings,
    allow_dangerous_deserialization=True
)
query = "Who won the 2023 Cricket World Cup?"
retrieved_docs = vector_store.similarity_search(query, k=2)
La dernière ligne concentre toute la décision : similarity_search classe les fragments par proximité avec la question et rend les deux premiers. Aucune ligne ne vérifie qu’ils répondent vraiment : la similarité est le seul juge.
Reste le troisième geste. Quand le LLM lit le prompt, il écrit sa réponse mot après mot, selon la formule suivante :
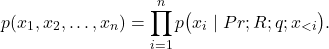
Ici  sont les jetons (grosso modo, les mots) de la réponse,
 la consigne du prompt,
 les fragments récupérés,
 la question et
 les jetons déjà écrits. Le produit multiplie, jeton après jeton, la probabilité de choisir
 sachant tout ce qui précède. Les fragments font partie des conditions de cette probabilité : rien d’autre dans la formule ne contrôle ce que le modèle en fait.
À quoi il sert : des faits simples, pas des vues d’ensemble
Avant de choisir ce pipeline, vérifie que tu en as besoin. Le système a-t-il besoin de données absentes de l’entraînement du modèle, de données récentes ou fréquemment mises à jour, de faits à l’exactitude critique, de sources citées ? Écrire un texte créatif, traduire ou corriger la grammaire n’en ont généralement pas besoin ; un agent de support client, qui doit répondre avec des informations produit à jour et vérifiables, en a clairement besoin.
Quand le besoin est là, ses composants répondent efficacement aux requêtes. Il est efficace pour les faits simples ou les questions directes. Les questions-réponses sur une documentation ou sur des produits en sont l’exemple courant : réduire les hallucinations et assurer la transparence y est crucial, la personnalisation bien moins, ce qui donne l’avantage à la récupération sur l’ajustement du modèle.
Côté coût, le pipeline se met à jour souvent, à très faible coût, et s’accommode de types de données variés. L’ajustement d’un modèle, lui, exige de préparer et de curer des jeux de données de qualité, coûteux et laborieux, puis de payer le réentraînement. La contrepartie : la recherche rallonge chaque réponse, donc la latence monte.
Tout cela vaut pour un fait que quelques passages suffisent à porter. Dès que la réponse se disperse, les ennuis commencent.
Où la réponse se perd entre la question et la phrase finale
Chaque problème du RAG naïf se rattache à une étape précise du pipeline. Suis la question du début à la fin et note où elle peut dérailler.
Quand le bon passage n’arrive pas
Au moment de la récupération, deux mesures posent problème : la précision (les fragments trouvés sont mal alignés avec la question) et le rappel (trouver tous les fragments pertinents). Les causes sont variées :
- une base périmée, ou mal indexée ;
- un embedder trop petit, ou inadapté au domaine, dont la représentation sémantique est faible ;
- le top-K coupe des fragments décisifs : en gardant les k premiers, on peut conserver des fragments moins pertinents et ne pas renvoyer ceux qui comptent vraiment ;
- la bonne information est trouvée, mais en trop de fragments pour la longueur de contexte du LLM.
⚠️ Piège Un découpage identique pour tous les types de fichiers (PDF, HTML, texte brut) est une cause classique de mauvaise indexation : des documents de types variés sont alors mal traités.
Quand le passage arrive sans être bien lu
Imagine que le bon fragment soit dans le prompt. Rien n’est gagné pour autant.
-
Extraction échouée : le bon contexte est renvoyé, mais le LLM n’en tire pas la bonne réponse, en général à cause de trop de bruit ou d’informations contradictoires.
-
Redondance : une base qui mêle plusieurs corpus contient beaucoup de documents redondants, de styles et de tons différents ; le LLM peut alors répéter, halluciner ou mal intégrer l’information.
-
Mauvais format ou mauvaise spécificité : le LLM ignore la consigne de présentation (puces, tableau), ou répond de façon trop vague ou trop technique pour un public d’étudiants, par exemple.
-
Réponse incomplète : pas fausse, mais l’information nécessaire n’a pas été toute trouvée, ou le LLM l’a mal utilisée. Une requête trop complexe (« résume les points A, B et C ») gagne à être modifiée.
Ce que sa structure l’empêche de voir
Certains échecs ne viennent pas d’un mauvais réglage mais du plan même du pipeline.
Premier angle mort : un seul niveau de fragments. Avec beaucoup de documents, latence et performance en pâtissent ; avec de gros documents, il devient difficile de trouver les fragments pertinents ; et la hiérarchie que beaucoup de corpus possèdent reste inexploitée.
Deuxième angle mort : les relations. Les textes d’une base sont interconnectés, non isolés, mais le RAG ne capture pas le savoir relationnel structuré quand la similarité sémantique ne peut pas le saisir. En science, un réseau de citations relie un article à des travaux antérieurs : on retrouve des articles semblables à la requête, pas ce réseau.
Troisième angle mort : la vue d’ensemble. Les fragments retrouvés ne sont pas représentatifs de l’information globale, ce qui gêne surtout les tâches de résumé. Relier des points dispersés relève de la même logique : c’est exactement le cas de la question sur Hinton, qui échoue dès qu’aucun fragment ne rassemble l’ensemble de ses actions.
Reste la passe unique : récupérer une fois puis générer peut être insuffisant pour des problèmes complexes qui exigent un raisonnement en plusieurs étapes. Là, la limite de raisonnement du système dépend du LLM : la récupération ne sert qu’à trouver le contexte.
Quelle panne, quel ajout : le chemin vers le RAG avancé
Le RAG avancé n’est pas un autre outil : c’est le même pipeline, avec un correctif posé sur chaque panne, avant et après la recherche. Les techniques de pré-récupération optimisent l’index et la requête ; celles de post-récupération optimisent le contexte avant la génération. Le processus enrichi se résume à « réécrire puis récupérer puis re-classer puis lire ».
| Ce qui casse | Ce qu’on ajoute | Où |
|---|---|---|
| Beaucoup de documents, ou de gros documents : latence et fragments introuvables | Indexation hiérarchique : résumés des grandes sections, embeddings à plusieurs niveaux, métadonnées | Avant la recherche |
| Un fragment isolé qui perd le contexte de son document | Résumé du document entier ajouté à chaque fragment, au prix de calcul et de stockage en plus | Avant la recherche |
| Une information obsolète qui remonte | Filtrage par métadonnées (par exemple la date) avant la recherche par similarité | Avant la recherche |
| Un contexte redondant | Résumé du contexte trouvé, pour en éliminer l’information redondante | Après la recherche |
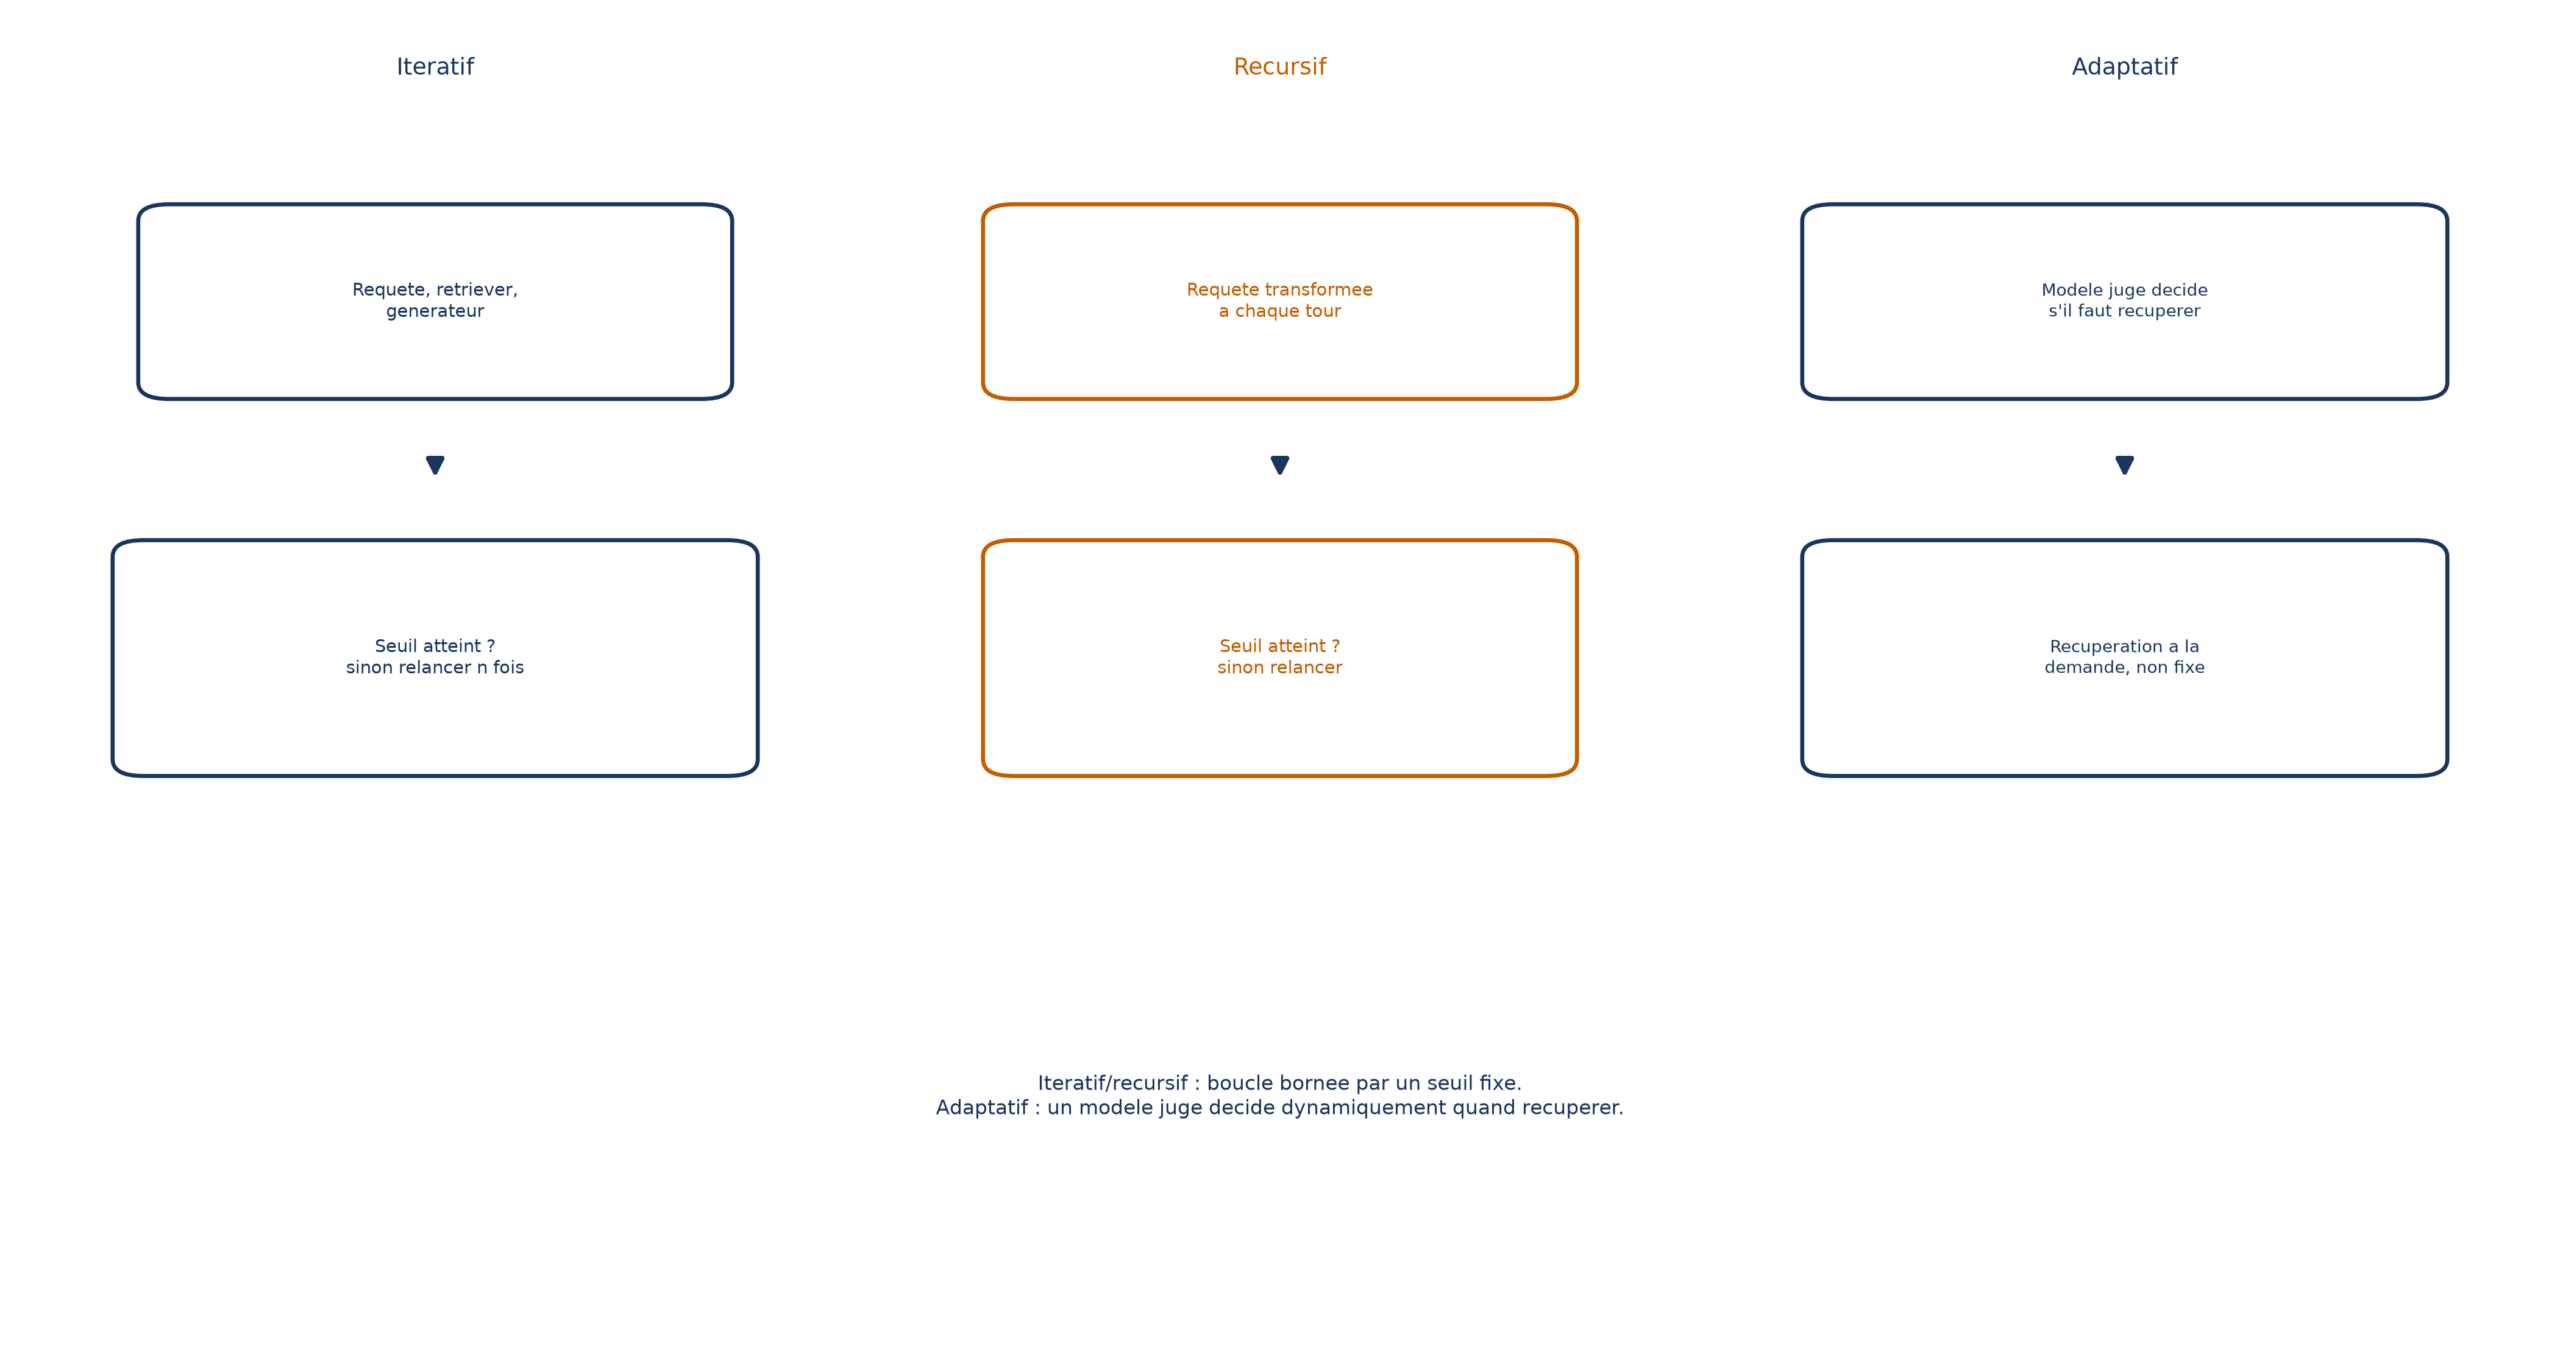
| Une passe unique qui ne suffit pas | Récupération itérative, récursive ou adaptative | Autour de la boucle |
| Aucun contrôle de la réponse | Module de validation : on passe de « récupérer et lire » à « récupérer, lire et réécrire » | Architecture modulaire |
Les trois variantes de la cinquième ligne méritent un coup d’œil, puisqu’elles remettent en cause la passe unique elle-même.
Trois idées reçues à ranger
« Plus on récupère de fragments, plus on a de chances. » Faux : plus de fragments, plus de redondance. Le contexte du LLM est une série de fragments concaténés ; les modèles acceptent de plus en plus de contexte mais peinent avec la redondance, et ce qui n’est pas essentiel pour répondre réduit la performance.
« Si la recherche est bonne, la réponse l’est aussi. » Non : le bon contexte ne suffit pas. Le LLM peut ne pas en extraire la bonne réponse, noyé dans le bruit ou des informations contradictoires. Et face à un domaine très technique, un modèle généraliste aura du mal : ajuster l’embedder et le LLM peut être une solution.
« Un bon réglage de k viendra à bout de tout. » Non : ni les relations perdues, ni la vue d’ensemble absente, ni le raisonnement en plusieurs étapes ne se règlent avec un paramètre de recherche. C’est pour cela que le tableau précédent range les remèdes par panne.
📌 À retenir Un RAG naïf se décrit en une ligne : un embedder, une base vectorielle, un LLM, une seule passe. Quand une réponse déraille, ne cherche pas un coupable général : demande-toi à quelle étape elle s’est perdue (trouver, lire ou relier), puis choisis le correctif de cette étape.