Ton agent de débogage bute sur un type d’erreur. Tu ajoutes dans son invite un exemple de la bonne solution : le changement prend effet instantanément, et l’agent s’en sort. Mais il n’a vécu que le temps de la session : tu la fermes, et tout ce qu’il vient d’apprendre disparaît. Rien n’a bougé dans le modèle, et rien n’a été rangé quelque part. Ce qui manquait à cet agent, c’est une mémoire non paramétrique : à la fin de cet article, tu sauras la définir, comprendre comment elle s’écrit, se relit et se réécrit, et repérer les cas où elle déraille.
Sommaire
- L’essentiel en 30 secondes
- Un savoir qu’on change sans toucher au modèle
- Pourquoi les poids ne suffisent pas
- Écrire un souvenir, puis le retrouver
- Quand la mémoire se réécrit elle-même
- Entre le prompt et les poids
- Ce que cette mémoire ne règle pas
L’essentiel en 30 secondes
- Une mémoire non paramétrique, c’est un savoir rangé hors des poids : on l’enrichit sans modifier un seul paramètre du modèle.
- Elle compense ce que le modèle ne sait pas faire seul : apprendre après son entraînement.
- Elle se manie en trois gestes : écrire un souvenir, le retrouver par similarité, le remettre sous les yeux du modèle.
- Elle peut même se réécrire elle-même, en distillant des règles à partir des expériences accumulées.
- Elle a ses propres pannes : des souvenirs périmés, hors sujet ou trop nombreux.
Un savoir qu’on change sans toucher au modèle
Un modèle de fondation se définit par ses paramètres, et il existe deux manières de le faire progresser. La première entraîne ou affine ces paramètres. La seconde améliore automatiquement la performance du système en les laissant tels quels : c’est l’apprentissage non paramétrique, et la mémoire qui lui sert de support est la mémoire non paramétrique.
Le mot déroute. Il ne dit pas que le modèle n’a pas de paramètres : il garde les siens, simplement intacts. Ce qui évolue, c’est ce qui se trouve à côté de lui, dans un stockage persistant où l’on consigne des exemples, des enseignements ou des documents.
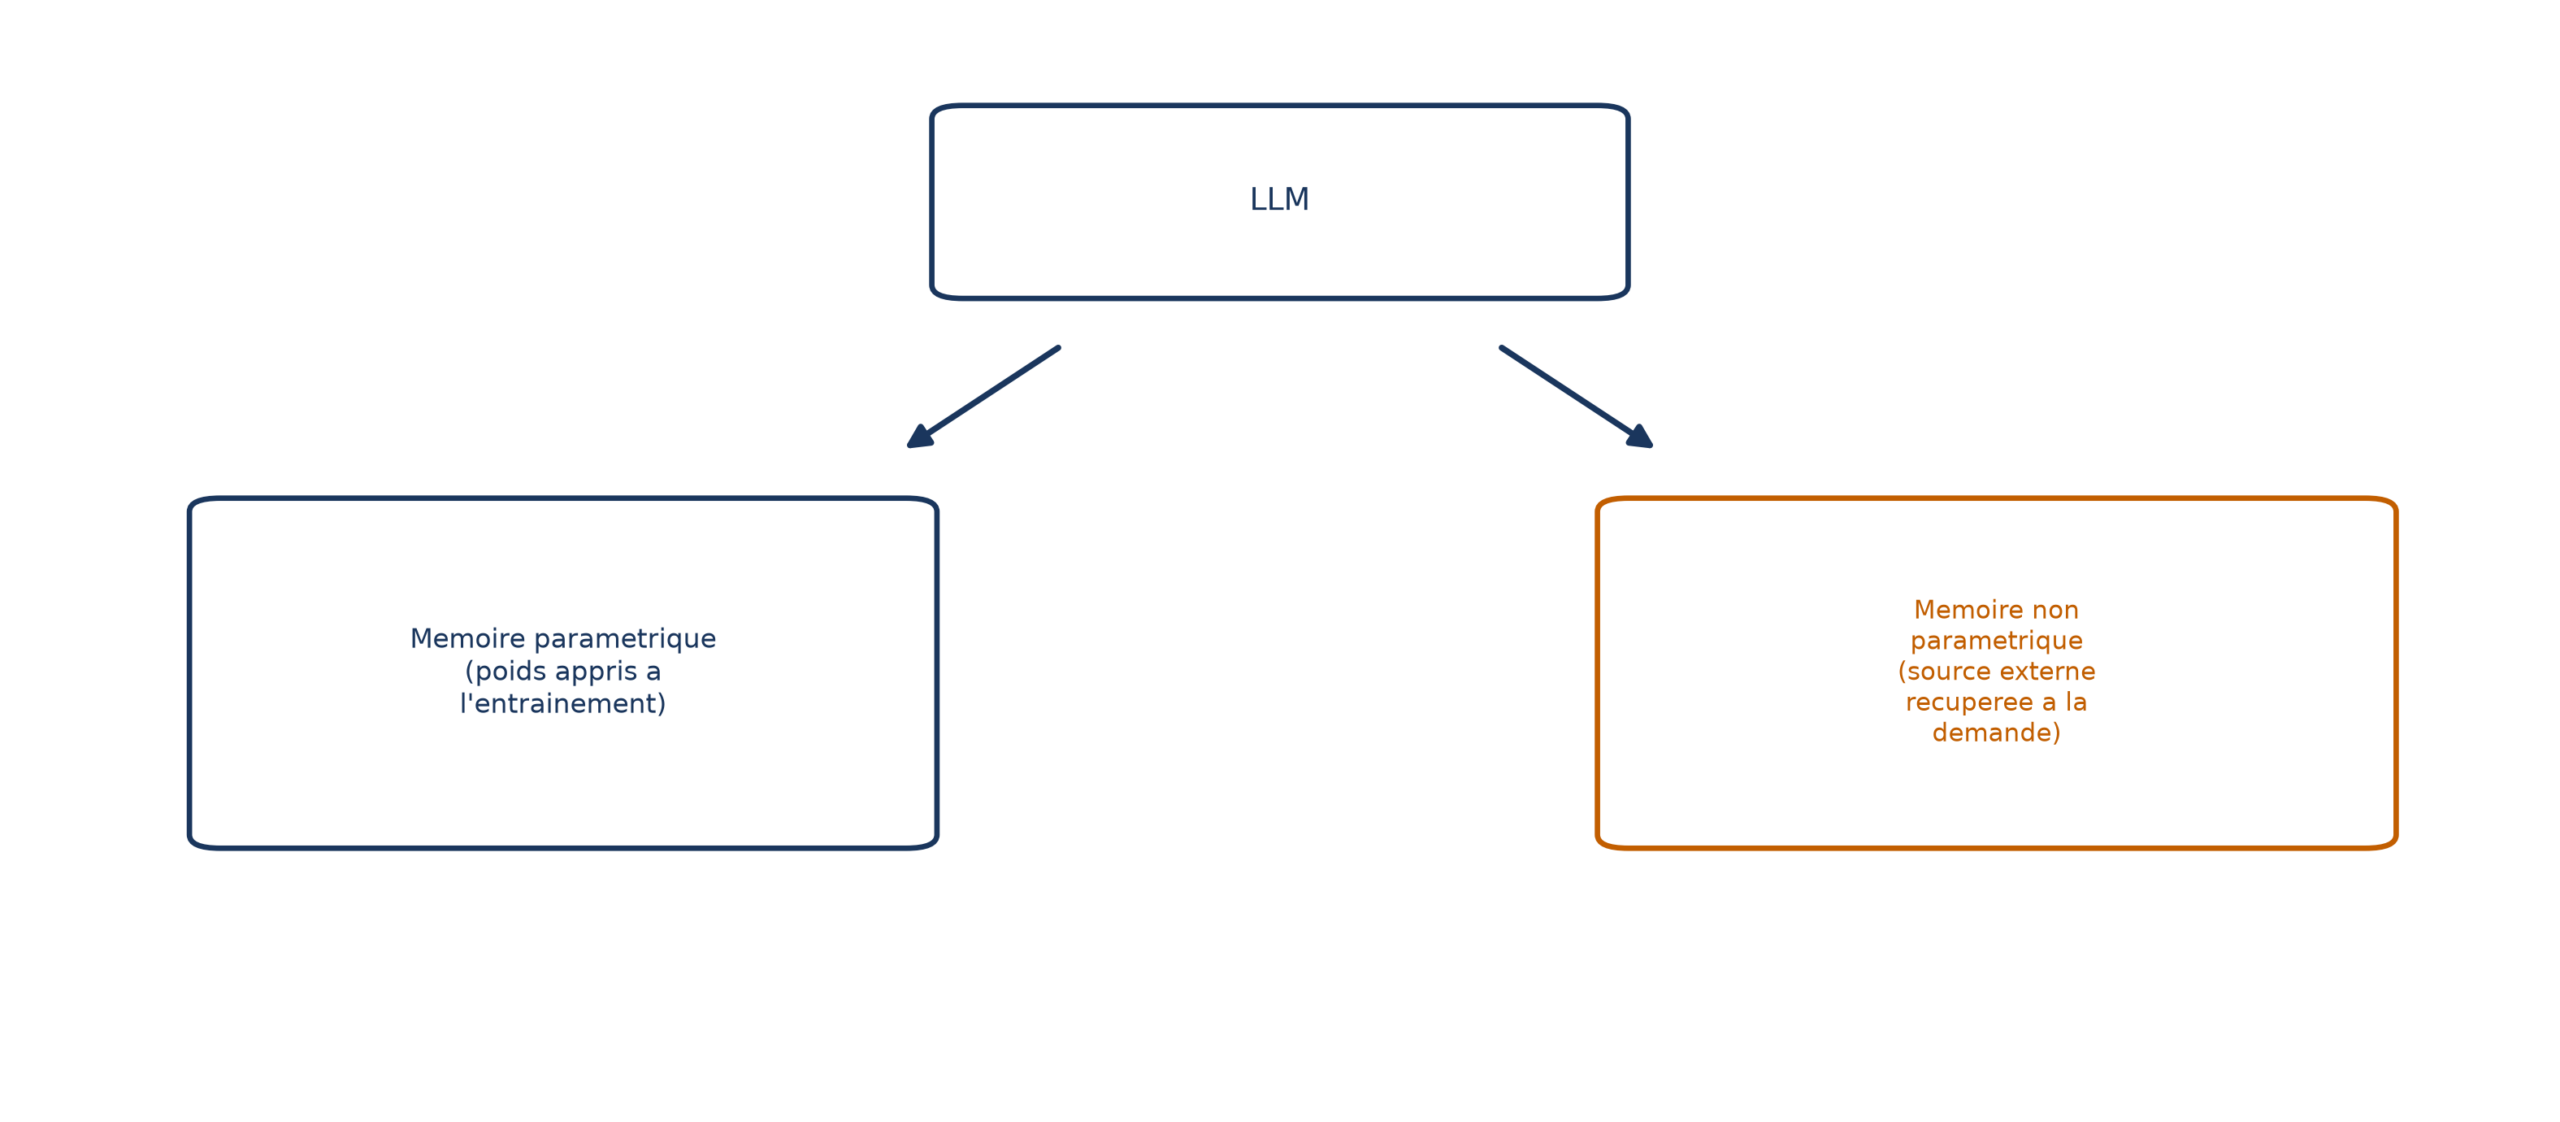
💡 Intuition Les poids, c’est ce que le modèle est devenu. La mémoire non paramétrique, c’est ce qu’il a sous la main au moment de répondre.
Pourquoi les poids ne suffisent pas
Une fois son pré-entraînement terminé, un modèle n’apprend plus. Le réajuster coûte cher et ne se répète pas à volonté : l’apprentissage continu reste un problème ouvert. Un humain, lui, se souvient des stratégies employées sur des problèmes semblables, et en forge de nouvelles face à l’inconnu.
Revenons à ton agent de débogage. Glisser un exemple dans l’invite est la première parade, et elle a de vraies forces : elle personnalise les réponses aux préférences d’un utilisateur, intègre ses corrections en temps réel et guide le raisonnement par des étapes explicites. Sa limite tient en un mot : l’adaptation est éphémère. Pour garder ce qui a marché, il faut le promouvoir vers un mécanisme plus durable.
C’est précisément la place d’une mémoire non paramétrique. Elle permet à l’agent d’apprendre de son interaction avec l’environnement, de s’adapter à des conditions qui changent et d’affiner ses stratégies. On y gagne en simplicité, en rapidité et en réactivité au monde réel.
Un dernier avantage se voit en regardant l’autre côté. Corriger ou retirer un savoir précis dans les poids exige d’intervenir « de façon chirurgicale » sur les paramètres sans détruire d’autres connaissances, et l’édition est plus délicate encore que le désapprentissage. Dans une mémoire externe, tu travailles sur un stockage : s’il gère les opérations de base (créer, lire, modifier, supprimer), tu as une prise directe sur le contenu.
Écrire un souvenir, puis le retrouver
Une mémoire non paramétrique se manie en deux gestes. Pour écrire, on consigne les détails de chaque interaction : le contexte, les actions entreprises, les résultats et les retours reçus. Pour lire, l’agent cherche dans sa banque les cas semblables à la situation présente, regarde les solutions qui ont servi et les adapte si besoin.
Quels souvenirs remettre sous les yeux du modèle ?
La version la plus simple écrit les exemples en dur dans l’invite, où ils ne changent plus. Dès que les exemples se multiplient, l’invite gonfle : le coût et la latence montent, et tous les exemples ne sont pas utiles pour toutes les entrées. La solution courante consiste à sélectionner dynamiquement ceux qui comptent.
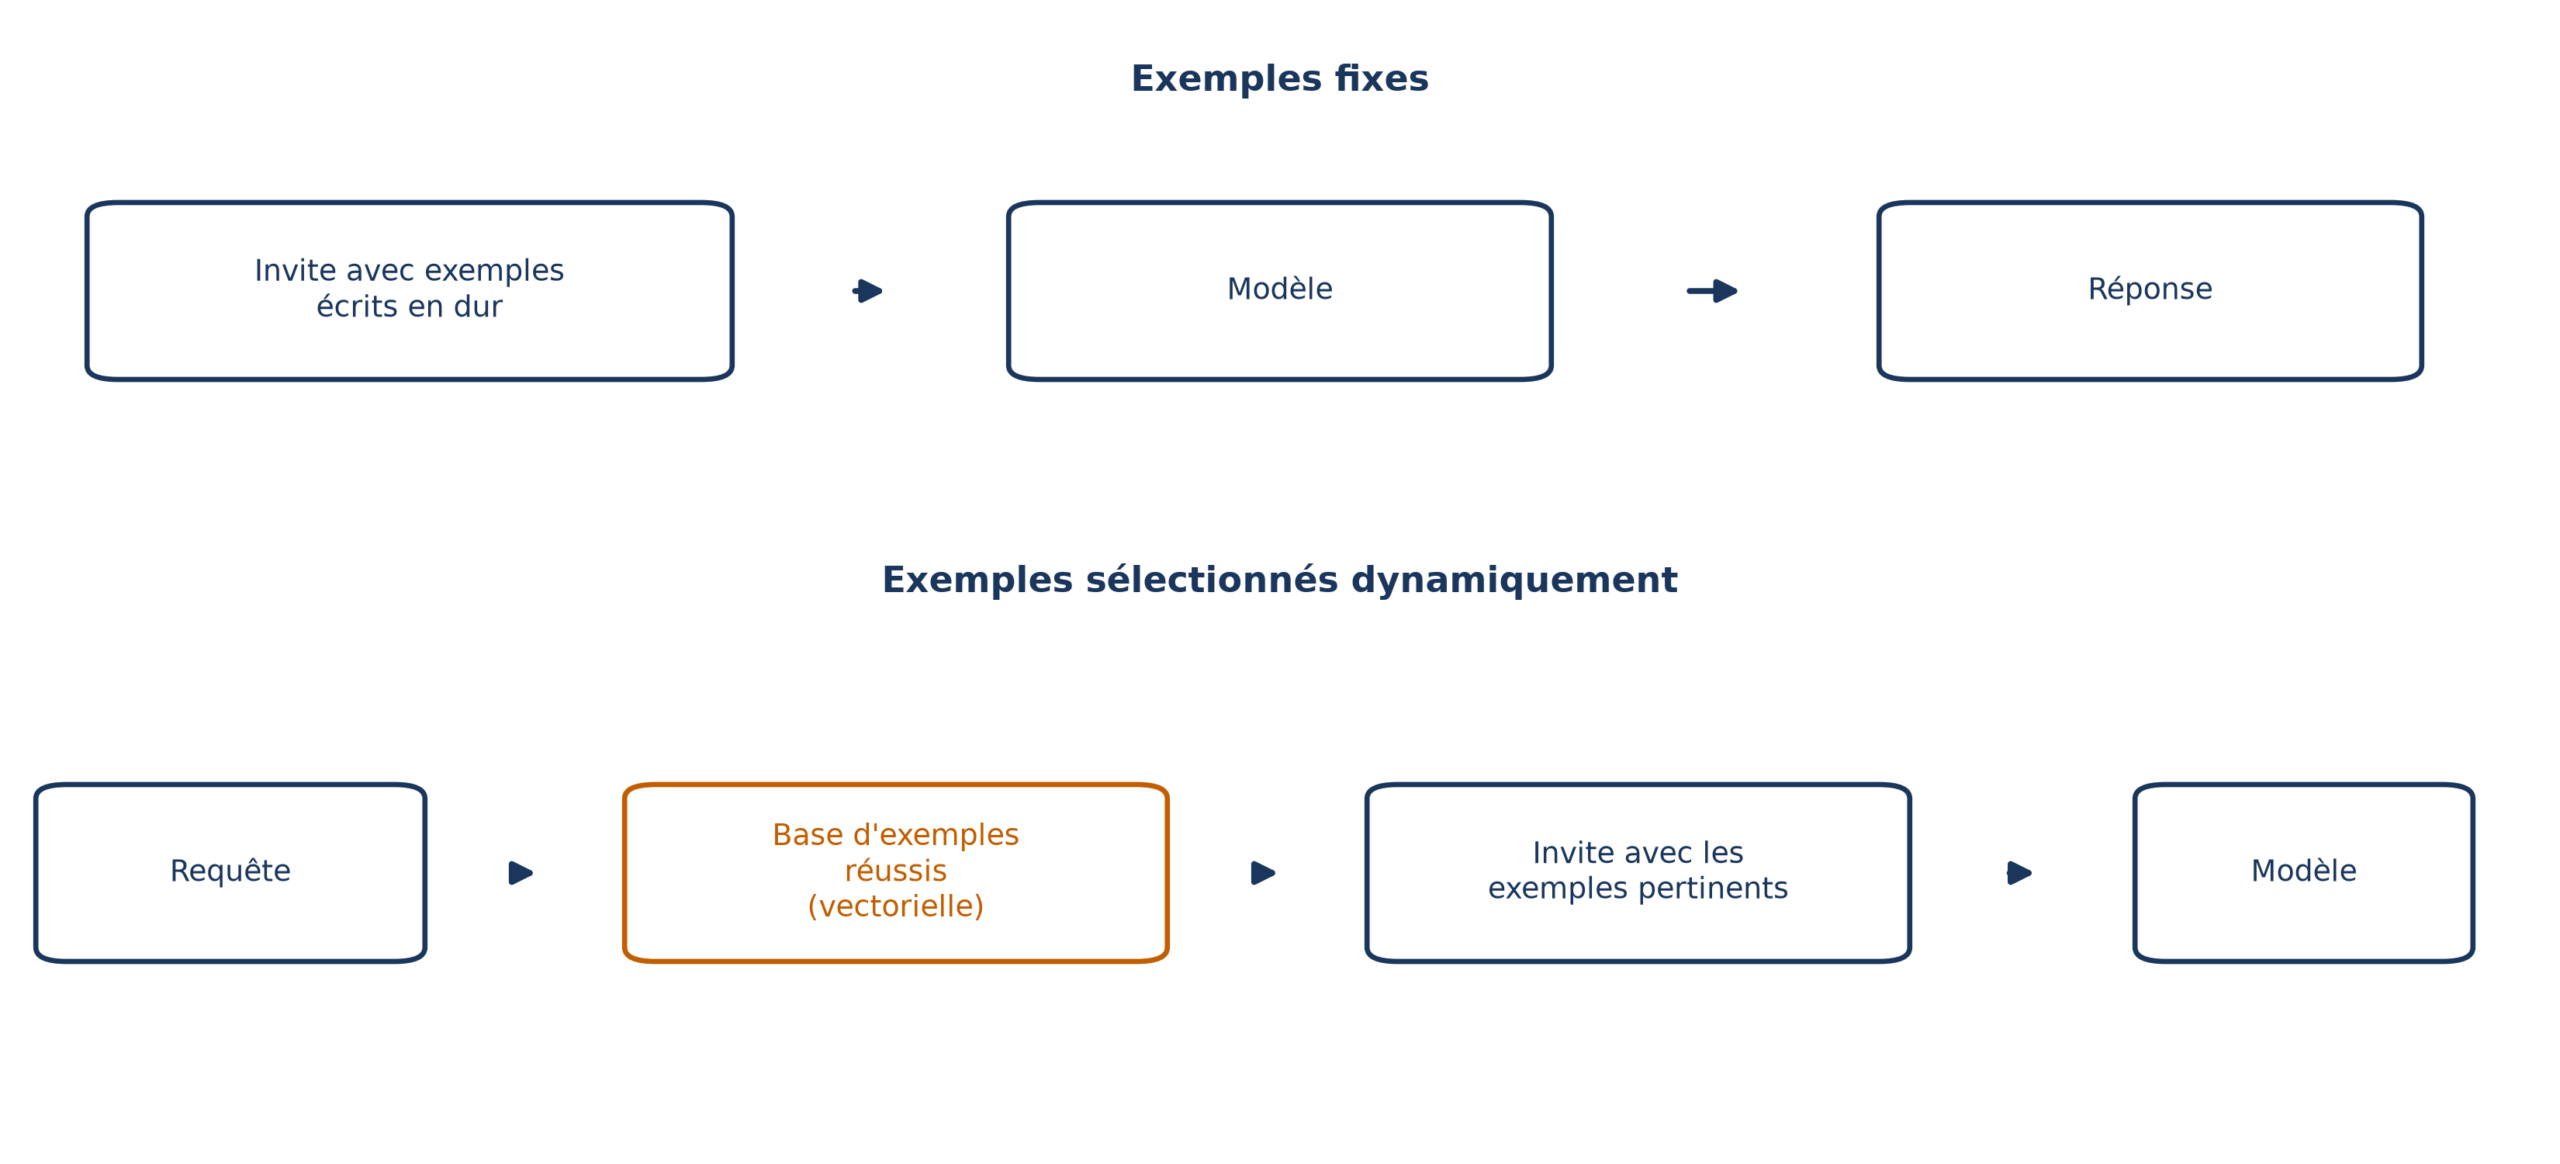
À mesure que les exemples réussis s’accumulent, on les retrouve par type, par recherche textuelle ou par recherche sémantique.
Comment la mémoire sait ce qui se ressemble
La recherche sémantique repose sur des vecteurs. On encode d’abord chaque texte à retenir en un vecteur dense, avec un modèle de fondation ou une autre technique de traitement du langage, puis on range ces vecteurs dans une base vectorielle conçue pour manier de grandes dimensions. Quand une requête arrive, on l’encode de la même façon et on cherche les vecteurs les plus proches : c’est la méthode dominante pour ce type de mémoire.
Reste à mesurer la proximité. Le plus courant est la similarité cosinus entre le vecteur de la requête  et celui d’un souvenir
 :
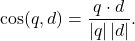
Au numérateur, le produit scalaire des deux vecteurs ; au dénominateur, le produit de leurs longueurs. Le résultat mesure l’angle entre eux : proche de 1 pour des textes très semblables, proche de 0 pour des textes sans rapport, proche de −1 pour des sens opposés. Un souvenir qui dit la même chose avec d’autres mots reste donc proche de la question, là où une recherche par mots exacts passerait à côté.
Le voir tourner en quelques lignes
Comment un agent retrouve-t-il, parmi deux textes enregistrés, celui qui éclaire la relation entre intelligence artificielle et apprentissage automatique ? Le code ci-dessous crée une mémoire vectorielle avec la bibliothèque vectordb, qui découpe chaque texte en fenêtres glissantes de 128 jetons avec un recouvrement de 16. Il y range deux textes avec leurs métadonnées (titre, URL), puis retrouve les trois meilleures correspondances.
from vectordb import Memory
memory = Memory(chunking_strategy={'mode':'sliding_window', 'window_size': 128,
'overlap': 16})
text = """
Machine learning is a method of data analysis that automates analytical
model building. It is a branch of artificial intelligence based on the
idea that systems can learn from data, identify patterns and make
decisions with minimal human intervention. Machine learning algorithms
are trained on datasets that contain examples of the desired output.
For example, a machine learning algorithm that is used to classify
images might be trained on a dataset that contains images of cats
and dogs. Once an algorithm is trained, it can be used to make
predictions on new data. For example, the machine learning algorithm
that is used to classify images could be used to predict whether a new
image contains a cat or a dog.
"""
metadata = {"title": "Introduction to Machine Learning", "url":
"https://learn.microsoft.com/en-us/training/modules/" +
    "introduction-to-machine-learning"}
memory.save(text, metadata)
text2 = """
Artificial intelligence (AI) is the simulation of human intelligence in machines
that are programmed to think like humans and mimic their actions.
The term may also be applied to any machine that exhibits traits associated with
a human mind such as learning and problem-solving.
AI research has been highly successful in developing effective techniques for
solving a wide range of problems, from game playing to medical diagnosis.
"""
metadata2 = {"title": "Artificial Intelligence for Beginners", "url":
"https://microsoft.github.io/AI-for-Beginners"}
memory.save(text2, metadata2)
query = "What is the relationship between AI and machine learning?"
results = memory.search(query, top_n=3)
Trois appels portent toute la logique. Memory(...) règle la façon de découper les textes, memory.save(text, metadata) écrit un souvenir avec ses métadonnées, et memory.search(query, top_n=3) relit les trois plus proches de la question. Les métadonnées servent à garder la trace d’où vient chaque souvenir.
Quand la mémoire se réécrit elle-même
Garder chaque expérience brute a un défaut : elles s’empilent. Une autre voie les distille : l’apprentissage expérientiel part d’une réserve d’expériences, en tire des enseignements, puis les condense en une courte liste de règles grâce à quatre opérations : ajouter, modifier, retirer, approuver.
Le point de départ est simple : on demande au modèle de fondation de réfléchir aux observations renvoyées par l’environnement, pour y repérer des enseignements qui amélioreraient la performance future. À quoi cela ressemble-t-il dans le code ?
class InsightAgent:
   def __init__(self):
       self.insights = []
       self.promoted_insights = []
       self.demoted_insights = []
       self.reflections = []

   def generate_insight(self, observation):
       # Use the LLM to generate an insight based on the observation
       messages = [HumanMessage(content=f'''Generate an insightful analysis based
           on the following observation: '{observation}'''')]
       # Build the state graph
       builder = StateGraph(MessagesState)
       builder.add_node("generate_insight", call_model)
       builder.add_edge(START, "generate_insight")
       graph = builder.compile()

       # Invoke the graph with the messages
       result = graph.invoke({"messages": messages})
       # Extract the generated insight
       generated_insight = result["messages"][-1].content
       self.insights.append(generated_insight)
       print(f"Generated: {generated_insight}")
       return generated_insight
La classe tient quatre listes : les enseignements, ceux qu’on promeut, ceux qu’on rétrograde, et les réflexions. La méthode generate_insight construit une invite à partir d’une observation, la fait passer par un petit graphe d’état, puis stocke le résultat. StateGraph, MessagesState et START appartiennent au cadre LangGraph, et call_model est l’enveloppe qui isole l’appel au modèle, pour que chaque nœud du graphe reste ciblé.
Avec assez de retours, ce procédé apprend des interactions avec l’environnement et améliore la performance dans le temps. Il permet aussi de s’adapter à un environnement qui change : si l’agent doit ajuster sa politique, il le peut. Ces approches restent pratiques, abordables et faciles à mettre en œuvre, parfois en quelques lignes de code. Une variante, Reflexion, enregistre et réinjecte des réflexions sur les échecs.
💡 Intuition Les expériences sont les notes brutes d’un carnet ; les règles, la fiche de révision qu’on en tire. Une règle qui a fait ses preuves se promeut, une règle qui ne sert plus se retire.
Entre le prompt et les poids
Ce qu’un agent apprend se range à trois niveaux, du plus fugace au plus durable. L’invite d’une session, d’abord. La mémoire non paramétrique, ensuite, qui persiste et se consulte. Au-dessus, des mécanismes plus permanents : ingénierie d’invite, mises à jour de flux, ou réentraînement complet du modèle.
L’apprentissage en contexte sert souvent de première ligne : il permet de tester vite et à faible risque des améliorations dans des interactions réelles, avant de les codifier. En production, la boucle se referme ainsi : les retours de terrain font remonter les problèmes, l’expérimentation valide les correctifs, et l’apprentissage continu les inscrit pour un effet immédiat ou durable.
Où sont les poids dans cet escalier ? Tout en haut, en dernier recours. On commence par les approches non paramétriques, plus simples et plus rapides ; quand on dispose de nombreux échantillons, l’affinage devient une option à considérer.
Ce que cette mémoire ne règle pas
« Non paramétrique veut dire sans paramètres. » Le modèle garde les siens, seulement intacts : c’est la mémoire autour de lui qui évolue.
« Plus de souvenirs, c’est mieux. » Ajouter des exemples fait monter le coût et la latence, et tous ne servent pas à toutes les entrées. Même quand les bons documents sont trouvés, ils peuvent être trop nombreux pour tenir dans le contexte du modèle.
« Ce qu’on retrouve est toujours juste. » Il faut tester qu’une préférence obsolète ou erronée ne remonte pas à cause d’une fuite de données ou d’une erreur d’indexation. Il faut aussi vérifier qu’une donnée voisine mais hors sujet ne soit pas retrouvée sur une simple ressemblance de formulation. La base elle-même peut être périmée, ou mal indexée.
« On peut écrire dans n’importe quel index. » Certaines bibliothèques vectorielles sont statiques : leurs données d’index sont immuables, ce qui complique l’ajout d’informations nouvelles. FAISS n’a pas été conçu pour les opérations de création, lecture, modification et suppression ; il convient quand la base est immuable et qu’on se contente d’y lire. Un système dont la mémoire doit évoluer demande donc un stockage choisi pour cela.
⚠️ Piège Plus la mémoire couvre large, plus elle est sensible. Un agent d’équipe qui se rappelle une chose dite dans une conversation privée, ou un agent de département qui fait remonter des données confidentielles d’une unité à l’autre, provoque une rupture de confiance ou de conformité. Les frontières de confidentialité doivent être respectées, auditables et applicables.
Reste à savoir si la mémoire tient debout : on teste ses temps de récupération sous charge croissante, et on simule l’indisponibilité de la base, la corruption de données ou une migration de version pour vérifier que l’agent se rétablit proprement.
📌 À retenir Tu peux voir la mémoire non paramétrique comme un carnet que l’agent écrit, relit et révise : ses poids restent les mêmes, c’est le carnet qui grandit. À toi d’en soigner le contenu, car ce que l’agent retrouve conditionne tout ce qu’il fera ensuite.