Demande à un LLM l’identifiant WikiData des Dallas Mavericks. Il répond sans hésiter, avec le même aplomb que pour une réponse juste. Sauf que le numéro donné est celui d’un film, Womanlight, et pas celui d’une équipe de NBA. Où était donc rangé ce que le modèle « savait » de cette équipe ? Tu vas voir où se cache son savoir, et pourquoi il est à la fois si vaste et si fragile.
Sommaire
- L’essentiel en 30 secondes
- Des milliards de nombres, pas une bibliothèque
- Comment elle se remplit : deviner le mot suivant
- Ce qu’elle retient bien, ce qu’elle retient mal
- Une mémoire arrêtée à une date
- Ce qui la modifie, ce qui la laisse intacte
- Trois mémoires, trois rôles
- Quatre idées reçues à ranger
L’essentiel en 30 secondes
- La mémoire paramétrique, c’est tout ce qui est stocké dans les poids du modèle à l’entraînement.
- Elle se remplit en apprenant à prédire le mot suivant, pas en rangeant des faits dans un tiroir.
- Elle retient bien les concepts et mal les dates, chiffres et faits rares.
- Elle est figée à la date de l’entraînement : seul un nouvel entraînement ou un affinage y touche.
- Pour en savoir plus, on lui adjoint une mémoire externe, sans changer ses poids.
Des milliards de nombres, pas une bibliothèque
Un LLM est un réseau de neurones dont chaque connexion porte un nombre, un poids, ajusté pendant l’entraînement. Ces poids sont les paramètres du modèle. Tout ce qu’il a retenu tient dedans : c’est sa mémoire paramétrique.
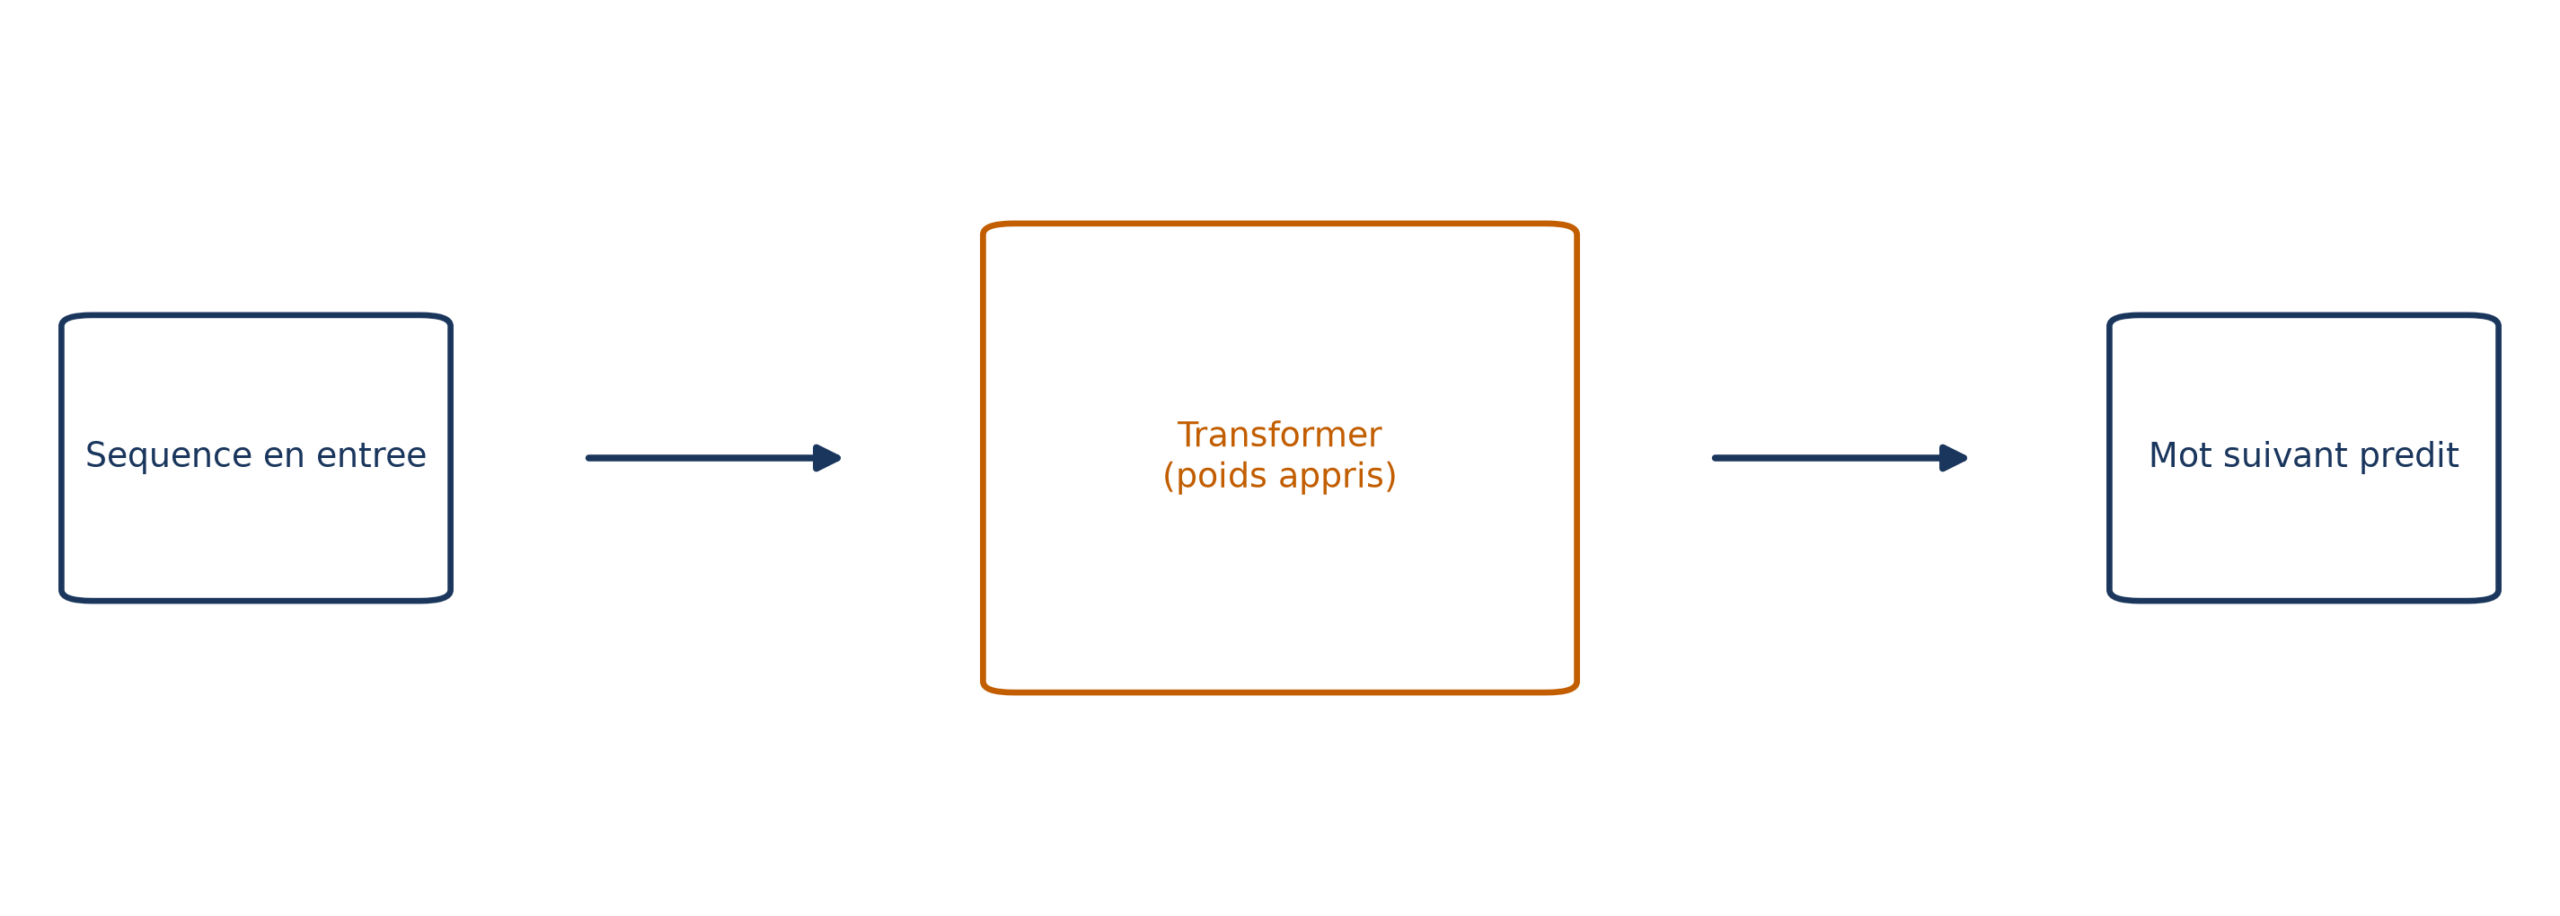
Les ordres de grandeur donnent le vertige. Le plus grand modèle de la famille Llama 3 compte 405 milliards de paramètres, et GPT-4 en compterait, selon la rumeur, plus de mille milliards. On parle de LLM à partir de 10 milliards de paramètres environ.
Trois choses font grossir ce total : la couche d’embedding (sa taille dépend de celle des vecteurs et du vocabulaire), le mécanisme d’auto-attention, et la profondeur, puisque chaque bloc ajouté apporte ses propres paramètres. Dans un bloc, la plus grande part des poids se trouve dans le réseau feed-forward, devant les sous-couches d’attention.
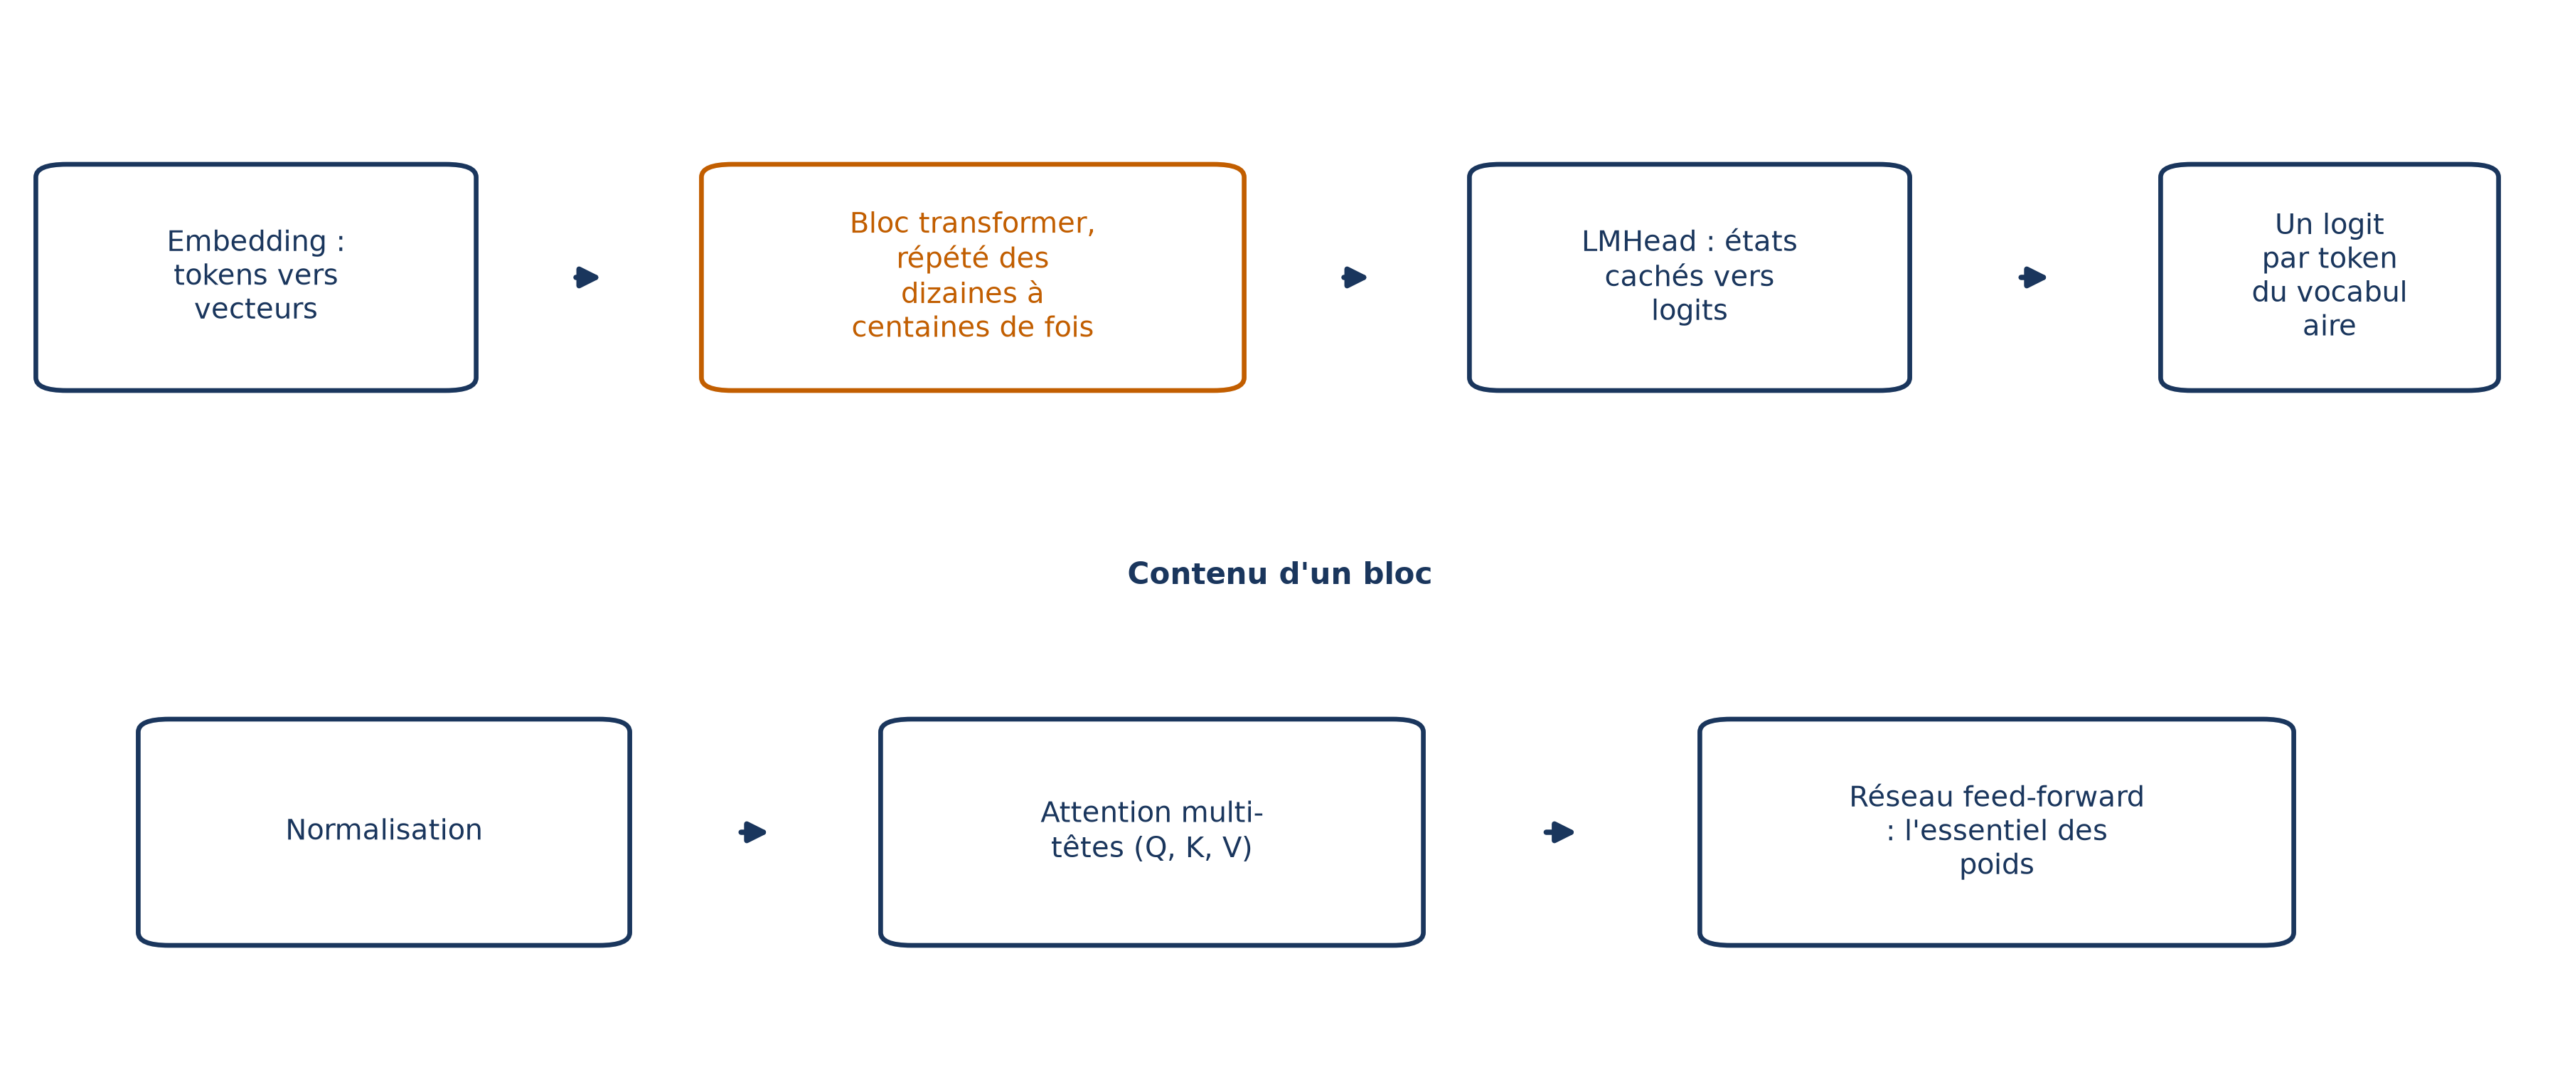
Cette mémoire a une limite : elle est nécessairement limitée par le nombre de paramètres et par la nature des données d’entraînement. Plus de paramètres permettent d’intérioriser plus de connaissances, c’est-à-dire plus d’informations, d’entités et de différences entre sujets.
Le même mot qu’en statistique
Le mot « paramétrique » n’est pas propre aux LLM. En statistique, une méthode paramétrique fait d’abord une hypothèse sur la forme de la fonction à estimer, par exemple une droite :
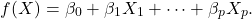
Il ne reste ensuite qu’à ajuster les  coefficients
 sur les données d’entraînement. Une méthode non paramétrique, elle, ne fige aucune forme, mais exige beaucoup plus d’observations.
Garde l’analogie : dans les deux cas, ce qu’on a appris des données est condensé dans des nombres ajustés, et plus rien n’est consulté ailleurs. Un LLM fait simplement cela avec des milliards de coefficients au lieu de quelques-uns.
Comment elle se remplit : deviner le mot suivant
Pour remplir cette mémoire, on ne dicte aucun fait au modèle. On lui montre d’énormes quantités de texte et on lui demande, encore et encore, de prédire la suite. Soumets « Never gonna » à un modèle qui a lu assez de culture populaire : il répondra « give you up ».
Deux méthodes d’entraînement existent. Dans la première, le modèle prédit le mot suivant à partir des seuls mots précédents. Dans la seconde, il reconstruit un mot masqué en s’appuyant à la fois sur ce qui précède et ce qui suit.
La première version est celle des LLM actuels. La probabilité d’un mot  sachant l’historique
 qui le précède se décompose ainsi :
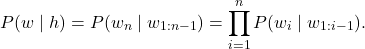
Ici  est le
 -ème mot et
 tous ceux qui le précèdent. La probabilité d’une phrase entière est le produit des probabilités de chaque mot sachant les précédents. Le modèle n’a besoin d’aucune étiquette, le texte lui fournit sa propre correction.
Ce qu’il lit détermine ce qu’il pourra retenir. Pour GPT-3, on parle de 410 milliards de jetons issus de Common Crawl, 12 et 55 milliards pour Books1 et Books2, et 3 milliards pour Wikipédia. Aujourd’hui, on dépasse mille milliards de jetons.
💡 Intuition Remplir cette mémoire est l’étape la plus lourde de la vie d’un modèle : le pré-entraînement mobilise des milliers de GPU pendant des mois. Les étapes suivantes (exemples de bonnes conversations, comparaison de réponses, renforcement) sont bien plus légères.
Ce qu’elle retient bien, ce qu’elle retient mal
Un concept qui revient mille fois sous des formes voisines finit par être bien ancré. Une date, une valeur numérique ou une information rare n’apparaît qu’une poignée de fois, voire une seule : la répétition qui renforce le savoir leur fait défaut.
À cela s’ajoute un problème de fond : les données d’entraînement contiennent du vrai et du faux, souvent contradictoires. Au moment de répondre, le modèle échantillonne une distribution et doit choisir parmi ce qu’il a appris, d’où des hallucinations. Monter la température, c’est tirer des mots moins probables, donc en produire davantage.
C’est exactement ce qui est arrivé à nos Dallas Mavericks. Le modèle a appris à produire un identifiant qui ressemble à un identifiant WikiData, pas à vérifier qu’il correspond à la bonne équipe. Il est entraîné à deviner la suite la plus plausible d’un texte, pas à contrôler des faits.
Ce que le modèle sait vraiment bien se range en trois familles : la connaissance linguistique (sémantique et syntaxe d’une langue), la connaissance du sens commun (les règles que presque tout le monde connaît sans qu’on les écrive) et la connaissance de domaine (médecine, programmation…).
La dernière est la plus fragile. La perte étant calculée sur l’ensemble des textes, l’entraînement favorise le savoir général plutôt que l’information spécialisée : un modèle généraliste se comporte moins bien dans un domaine pointu, quel que soit son nombre de paramètres.
Une mémoire arrêtée à une date
Une mémoire figée a deux défauts, et le second est le plus sournois. Le premier est l’ignorance : interrogé sur un événement de 2024 avec une coupure en octobre 2023, un modèle répond qu’il n’en sait rien, ce qui est la réponse la plus honnête possible.
Le second est la péremption. Fin 2023, Mark Cuban a vendu sa participation majoritaire dans les Mavericks à la famille Adelson et aux Dumont, en gardant une part minoritaire. Un modèle entraîné avant cette vente continuera à le présenter comme seul propriétaire de l’équipe.
Sa réponse était exacte le jour de l’entraînement, elle ne l’est plus, et rien dans son ton ne le signale.
D’autres choses n’ont jamais été dans cette mémoire : les informations internes à une organisation, par définition absentes de ses données d’entraînement. Le modèle ne peut pas non plus apprendre de nouvelles informations en cours de route, ni se souvenir de tes échanges passés.
Ce qui la modifie, ce qui la laisse intacte
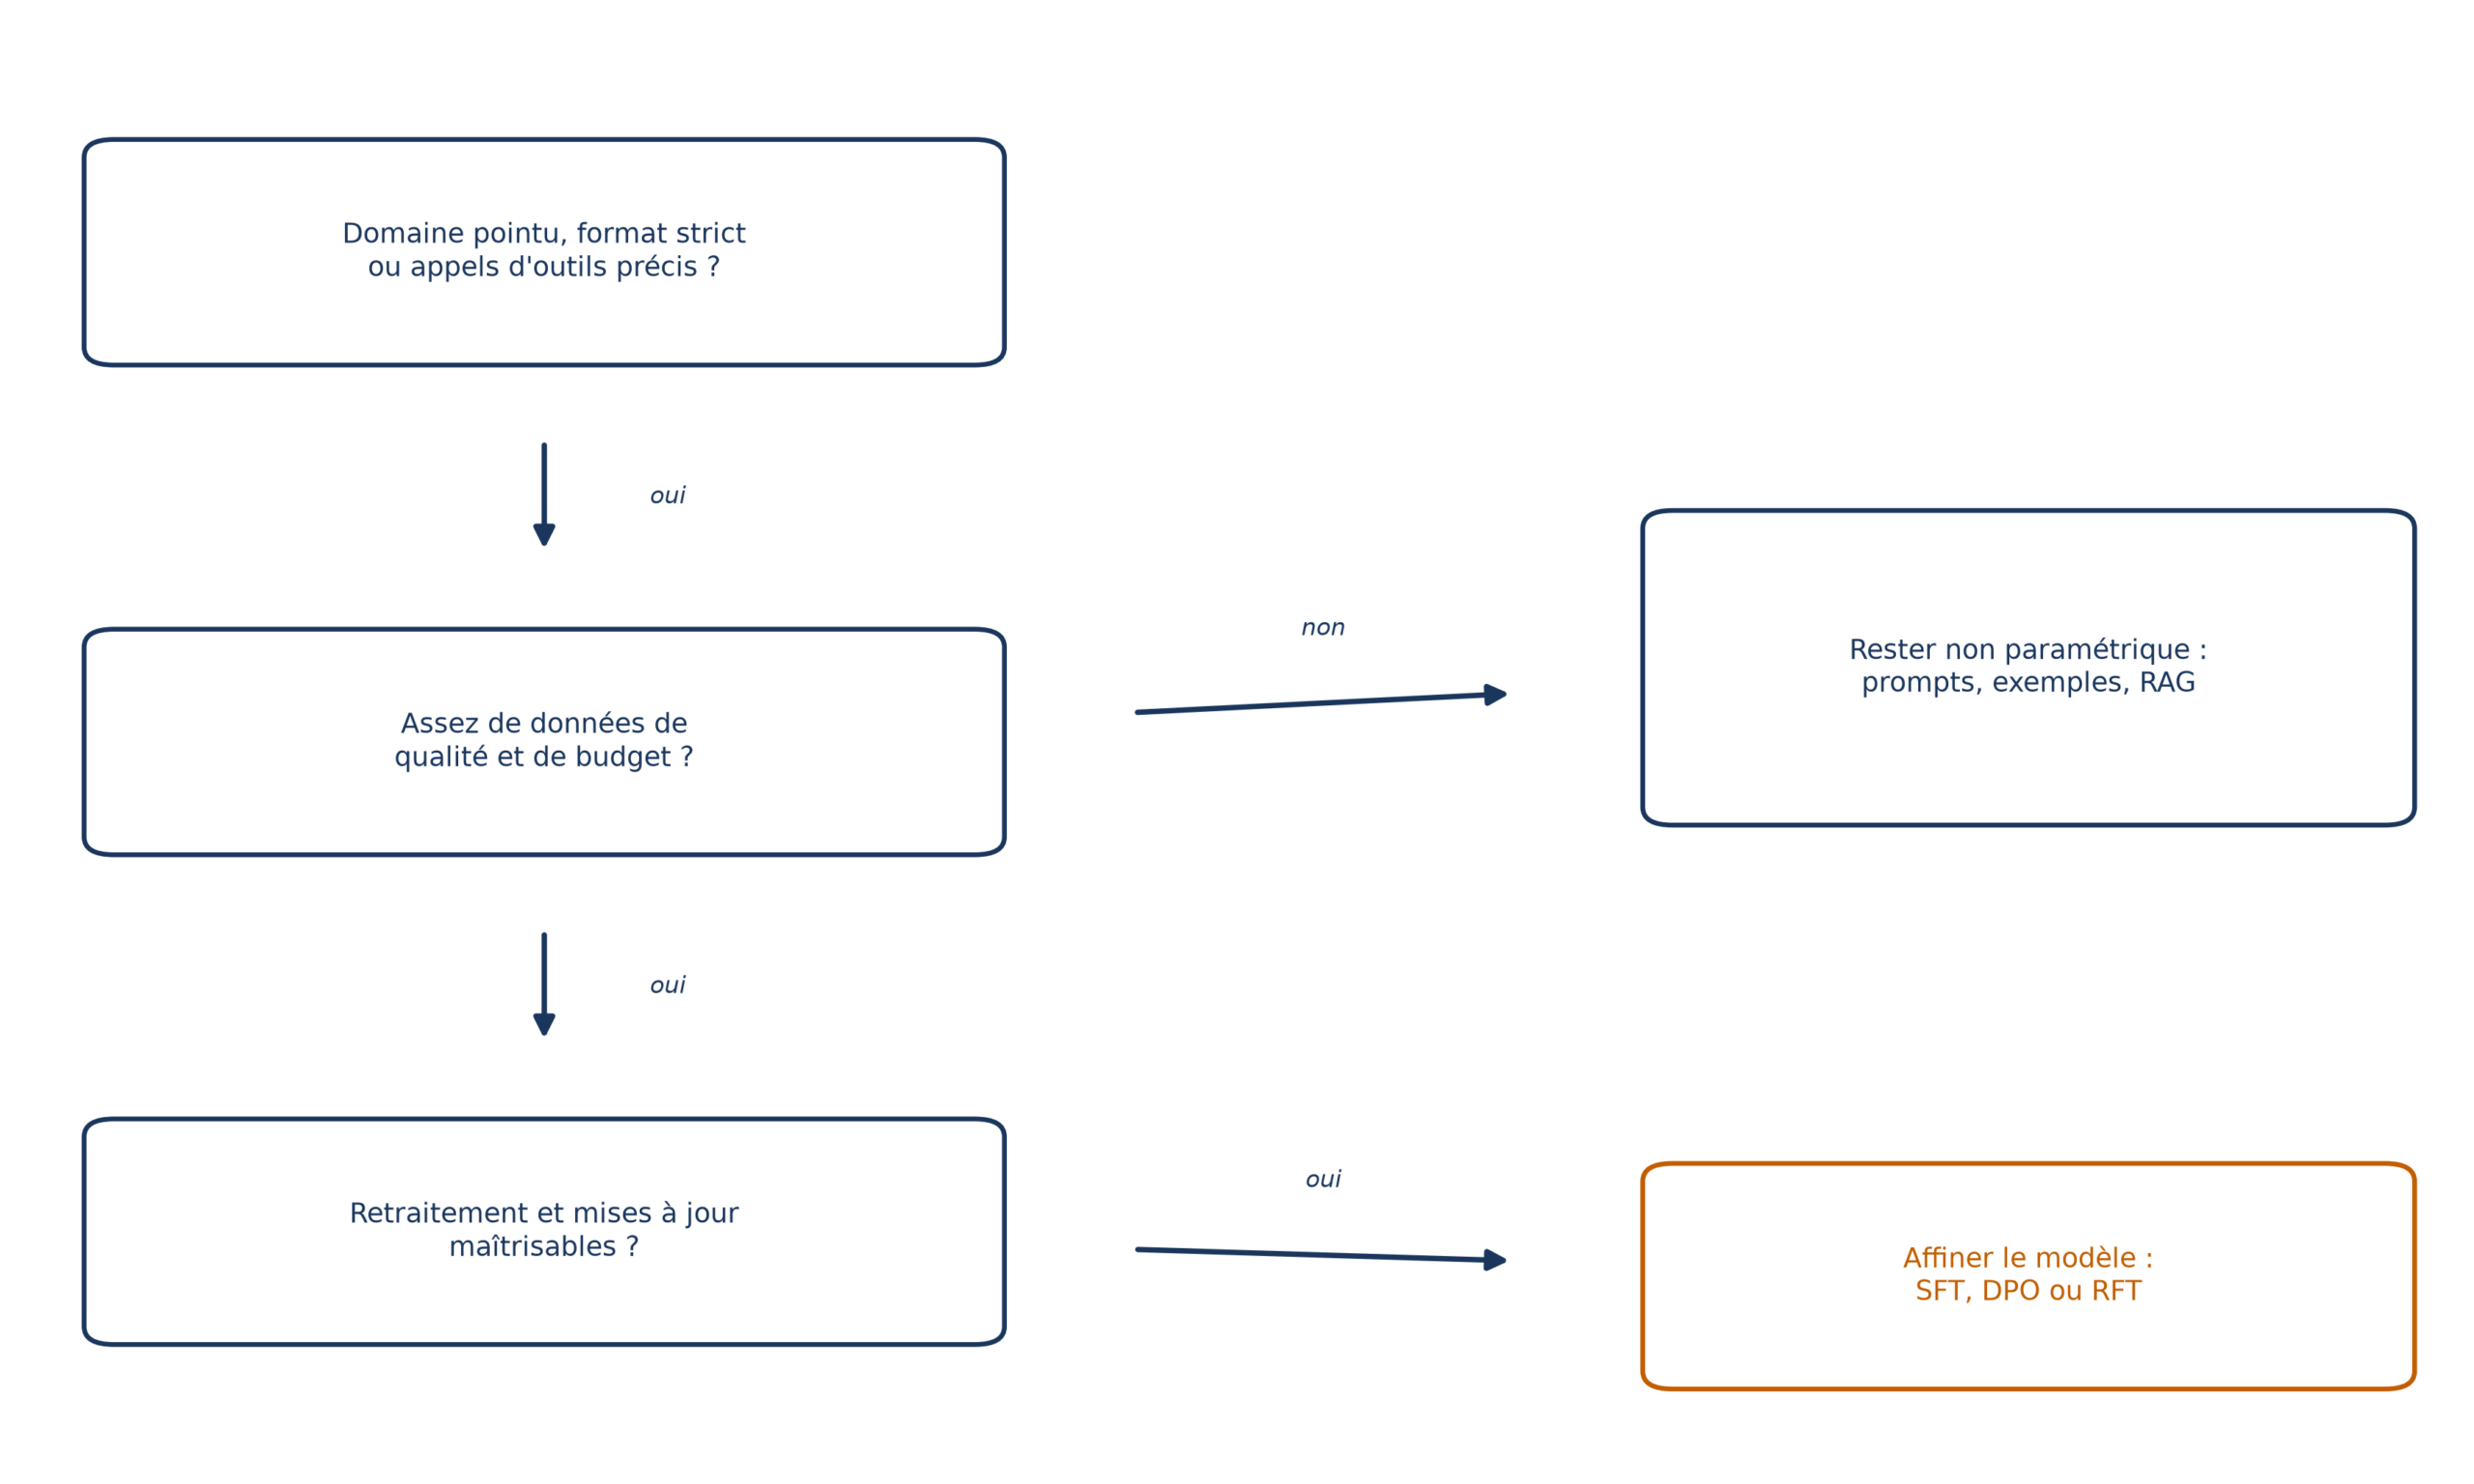
Pour améliorer un système, on distingue deux familles. L’apprentissage paramétrique ajuste les poids du modèle. L’apprentissage non paramétrique améliore la performance sans toucher à aucun paramètre.
Côté poids, on reprend un modèle déjà entraîné et on le modifie par petites touches : par des paires (invite, réponse) soigneusement choisies, par des paires « bonne réponse contre mauvaise », ou par des sorties notées par des experts. Entraîner un modèle de zéro sur des trillions de jetons reste réservé aux grands laboratoires.
Faut-il alors affiner pour y glisser un fait manquant, par exemple que les Denver Nuggets ont gagné le championnat NBA 2023 ? Les études divergent : certaines montrent un gain de fiabilité factuelle, d’autres que les LLM peinent à apprendre de nouveaux faits par ce biais.
L’affinage trouve plutôt sa place quand la spécialisation de domaine est critique, quand un format ou un ton doit rester constant, quand les appels d’outils doivent être précis. Il demande aussi des centaines à des milliers d’exemples soignés, des heures de GPU et un plan de réentraînement.
⚠️ Piège Mettre des exemples dans le prompt n’est pas une mise à jour de la mémoire. Le mot « apprendre » est impropre ici : aucun paramètre n’est modifié, donc la compétence acquise n’est que passagère.
Ce que fait le modèle dans ce cas, c’est exploiter ce qu’il a appris à l’entraînement pour retrouver la relation entre entrée et sortie des exemples. Pas de mise à jour, donc rapide, mais rien n’est retenu après coup.
On peut même organiser cette amélioration sans toucher aux poids. Il suffit d’enregistrer chaque expérience réussie dans une banque de mémoire, puis de retrouver les cas semblables pour les remettre dans le prompt : c’est simple, transparent et léger.
Trois mémoires, trois rôles
Dans une application construite autour d’un LLM, le modèle joue le rôle du cerveau. Il possède sa mémoire paramétrique, obtenue à l’entraînement, mais on peut lui en ajouter une externe : base vectorielle ou graphe de connaissances.
Il faut alors distinguer deux apports. La connaissance apporte au moment de la génération des contenus vérifiables (spécifications, politiques, catalogues), en plus de ce que le modèle stocke dans ses poids. La mémoire, elle, garde l’histoire propre de l’agent : échanges passés, sorties d’outils, états.
Entre les deux, la fenêtre de contexte joue le rôle de mémoire à court terme : l’historique d’une conversation y est inséré, et sa longueur limite ce que l’agent peut garder en tête.
📌 À retenir La mémoire est l’endroit où le savoir est stocké ; l’ingénierie de contexte est la façon de l’exploiter pour produire un bon comportement. Les poids sont la première de ces mémoires, jamais la seule.
Quatre idées reçues à ranger
« Plus de paramètres, donc plus juste. » Un modèle plus gros intériorise davantage, mais il reste généraliste : sur un domaine précis, il peut faire moins bien, quelle que soit sa taille.
« Le modèle apprend ce que je lui montre. » Les exemples du prompt ne modifient aucun poids. Ils guident la réponse du moment, rien de plus.
« Il explique bien, donc il sait. » Un LLM expose très bien des concepts, mais retient mal le détail précis : dates, valeurs numériques, informations rares. Une explication fluide n’est pas un indice d’exactitude.
« Affine-le avec le fait manquant. » Voir plus haut : les résultats sont partagés, et la méthode demande bien plus de curation, de calcul et de maintenance qu’on ne l’imagine.
Retiens la règle simple : ce que ton LLM sait, il le sait parce que des milliards de poids l’ont absorbé un jour, sous forme de statistiques et non de fiches. Pour tout le reste, il faut lui apporter la source.