Ton modèle affiche un intervalle de confiance étroit et une p-valeur minuscule : tout indique un résultat solide. Pourtant, une hypothèse du modèle peut être violée en silence, et le modèle se montre alors plus sûr de lui qu’il n’en a le droit. Cette hypothèse concerne les erreurs, et sa violation porte un nom : la corrélation des erreurs. À la fin, tu sauras ce qu’elle désigne, ce qu’elle fausse et dans quelles situations penser à elle.
Sommaire
- L’essentiel en 30 secondes
- Des erreurs qui se répondent
- Deux terrains où elle apparaît
- Pourquoi la confiance devient illusoire
- Un diagnostic parmi six
- Deux malentendus à écarter
L’essentiel en 30 secondes
- La corrélation des erreurs viole une hypothèse centrale du modèle linéaire : celle qui veut que les erreurs ne se répondent pas.
- Elle apparaît typiquement dans les séries temporelles et entre observations qui partagent un contexte commun.
- Les erreurs types calculées sous-estiment l’incertitude réelle, de façon systématique.
- Résultat : intervalles trop étroits, p-valeurs trop faibles, c’est-à-dire une confiance illusoire.
- C’est l’un des six diagnostics systématiques à passer après un ajustement linéaire.
Des erreurs qui se répondent
Un modèle de régression pose que la réponse se compose de deux parties :
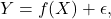
Ici  est la part systématique, fixe mais inconnue, qui relie les prédicteurs
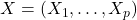 à la réponse. Quant à
 , c’est l’aléa qui absorbe tout le reste : sa moyenne est nulle et il ne dépend pas de
 . Chaque observation arrive avec sa part de ce reste.
Des erreurs corrélées sont des erreurs liées entre elles : connaître celle d’une observation te renseigne sur celle d’une autre. Le modèle linéaire standard suppose qu’il n’en est rien, et c’est ce qu’on appelle une hypothèse centrale : si elle tombe, les conclusions qui en dépendent tombent avec elle.
💡 Intuition Ne confonds pas deux corrélations. La colinéarité concerne des prédicteurs fortement corrélés entre eux ; ici, il s’agit des erreurs, de ce qui reste une fois que
Deux terrains où elle apparaît
Deux situations reviennent typiquement : les séries temporelles, où les observations se suivent dans le temps, et les observations qui partagent un contexte commun, regroupées par ce qu’elles ont en commun.
Dans les deux cas, tes lignes de données ne sont pas des tirages sans lien : elles sont rangées dans le temps, ou groupées par un contexte. Avant de lancer l’ajustement, pose donc deux questions à ton jeu de données : mes observations sont-elles ordonnées dans le temps ? Partagent-elles un même contexte ? Si l’une des réponses est oui, l’hypothèse mérite d’être testée plutôt que tenue pour acquise.
Pourquoi la confiance devient illusoire
Un intervalle de confiance encadre un paramètre inconnu autour de son estimation ponctuelle, avec une marge d’erreur qui dépend du niveau de confiance, de la variance des données et de la taille de l’échantillon. Pour un coefficient de régression  (on le trouve aussi noté
 ), il s’écrit :
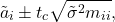
avec  , la valeur critique tirée de la loi de Student,
 , la variance résiduelle estimée, et
 , l’élément diagonal correspondant de la matrice
 . La racine, elle, joue le rôle d’erreur type : le nom donné à l’écart-type d’une distribution d’échantillonnage.
Tout repose donc sur cette erreur type. Or, si les erreurs sont corrélées, les erreurs types calculées sous-estiment systématiquement la véritable incertitude. Tu le lis à deux endroits de tes résultats : la marge autour de chaque coefficient se resserre à tort, et la p-valeur descend plus bas qu’elle ne devrait.
⚠️ Piège Rien dans ces chiffres ne ressemble à une erreur : un intervalle étroit et une p-valeur minuscule ont l’allure d’un bon résultat. C’est ce qui rend la confiance « illusoire ».
Un diagnostic parmi six
La corrélation des erreurs n’est pas seule à surveiller : elle s’ajoute à la non-linéarité, à l’hétéroscédasticité, aux points aberrants, aux points à fort levier et à la colinéarité pour former une batterie de six problèmes que tout modèle linéaire doit passer au crible. Sa signature à elle : une erreur type sous-estimée.
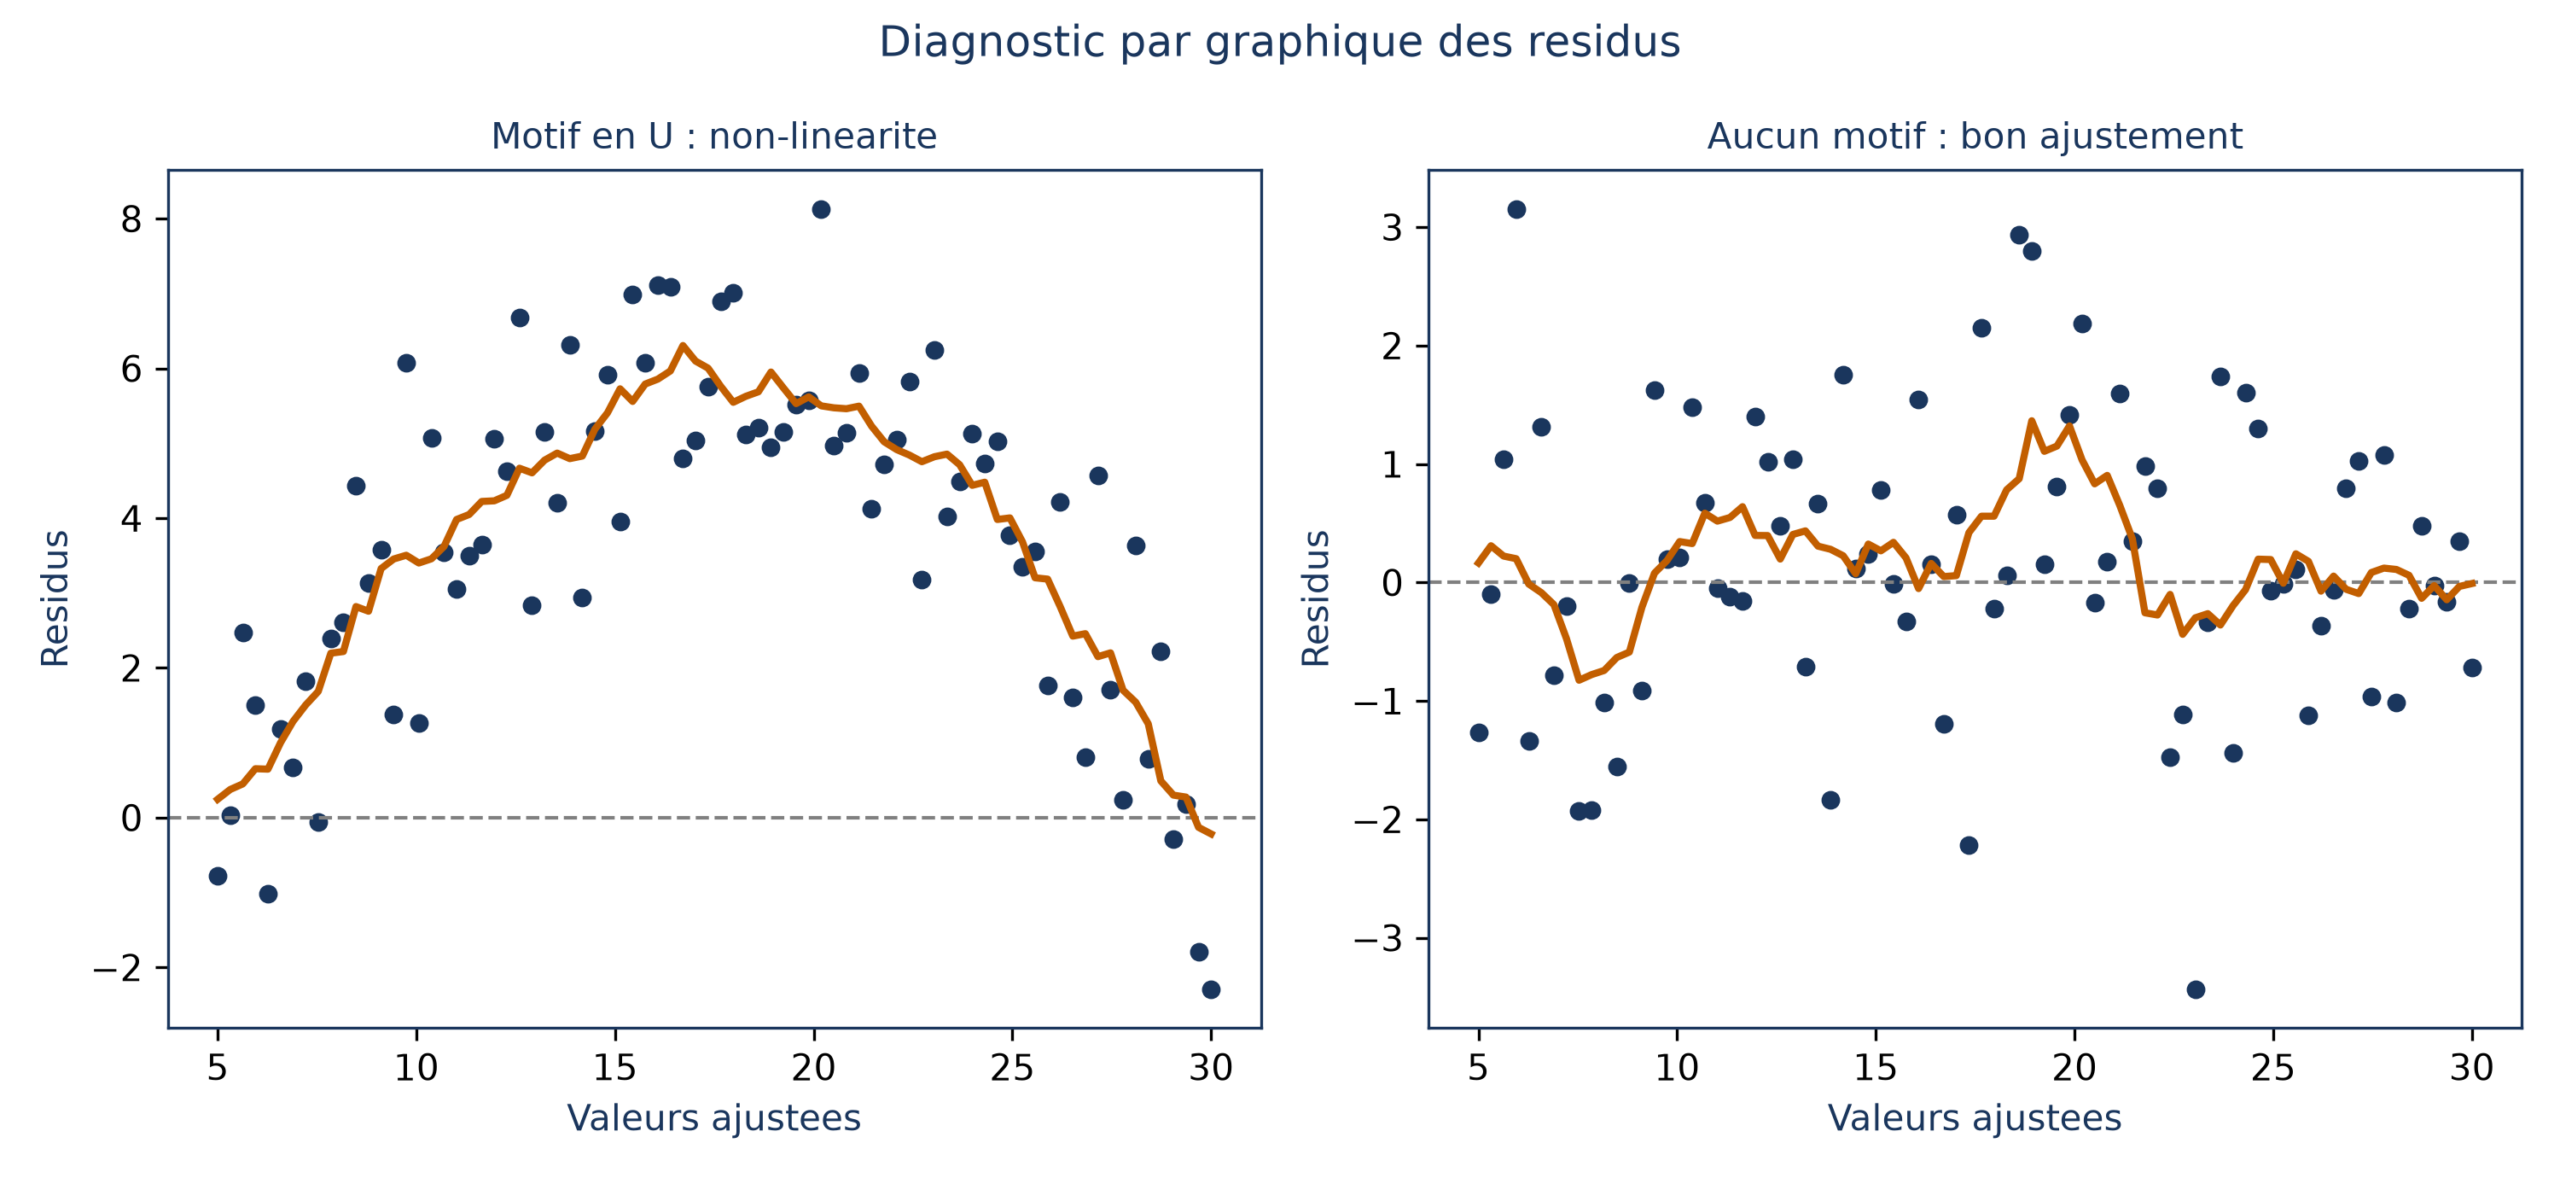
Pour ausculter un modèle, le geste de base est de tracer ses résidus. Si l’on y devine une tendance, droite ou courbe, c’est que le modèle a laissé de côté une structure des données.
Deux malentendus à écarter
« P-valeur minuscule, effet solide. » Ni l’étroitesse d’un intervalle ni la petitesse d’une p-valeur ne prouvent que l’incertitude a été bien mesurée. Si les erreurs sont corrélées, ces deux chiffres sont systématiquement trop flatteurs : c’est la mesure de l’incertitude qui est en cause, pas la taille de l’effet observé.
« Mes résidus sont non corrélés, c’est démontré. » Il existe bien une propriété de ce type : les résidus d’une régression par moindres carrés sont, par construction, toujours non corrélés avec les variables du modèle. Mais cette propriété parle de la relation entre résidus et prédicteurs. La corrélation des erreurs pose une autre question : celle d’une relation entre les erreurs elles-mêmes, d’une observation à l’autre.
📌 À retenir Des erreurs corrélées, typiquement dans une série temporelle ou entre observations d’un même contexte, violent une hypothèse centrale du modèle : les erreurs types sous-estiment alors l’incertitude, et la confiance affichée est illusoire.