Imagine un prévisionniste qui ne regarde aucune donnée et répond toujours la même valeur : la moyenne de tout ce qu’il a déjà vu. C’est le rival que ton modèle doit battre. Le coefficient de détermination, ou R², dit de combien il le bat, sur une échelle de 0 à 1. En quelques minutes, tu sauras le calculer, le lire et repérer ce qu’il ne te dira jamais.
Sommaire
- L’essentiel en 30 secondes
- Le rival le plus paresseux : toujours répondre la moyenne
- Lire un R² : de la moyenne pure au sans-faute
- Corrélation au carré : un lien exact, mais pour une seule variable
- Calculer le R² avec scikit-learn
- Ce que le R² ne te dit pas
L’essentiel en 30 secondes
- Le R² mesure la part de variabilité expliquée de la réponse, sur une échelle de 0 à 1.
- Il se calcule par 1 − RSS/TSS : l’erreur de ton modèle rapportée à celle de la simple moyenne.
- Proche de 0, il signale un modèle à peine meilleur que la moyenne ; à 1, un ajustement parfait des données observées.
- Avec une seule variable explicative, il est égal à r², le carré du coefficient de corrélation.
- Un seul nombre ne montre pas le dessin des résidus : il faut le regarder à part.
Le rival le plus paresseux : toujours répondre la moyenne
Pour savoir si ton modèle apporte quelque chose, il lui faut un adversaire. Le plus facile à battre ignore toutes les variables explicatives et répond, pour chaque observation, la moyenne  des réponses. Le R² dit de combien ton modèle fait mieux que ce rival.
Voici la formule, d’abord dans sa forme courte :
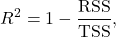
où RSS est la somme des carrés des résidus de ton modèle et TSS la variabilité totale de la réponse avant toute régression. Développée, elle devient :
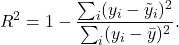
Au numérateur,  est la réponse observée et
 la valeur prédite par ton modèle (on la trouve aussi notée
 ) ; les écarts élevés au carré, additionnés, donnent le RSS. Au dénominateur, la même opération avec à la place de la prédiction : c’est l’erreur du rival paresseux.
Le rapport RSS/TSS est donc la fraction de l’erreur du rival qui subsiste avec ton modèle. Retranche-la de 1 : il reste l’erreur que ton modèle a fait disparaître, ce qu’on appelle la variabilité expliquée.
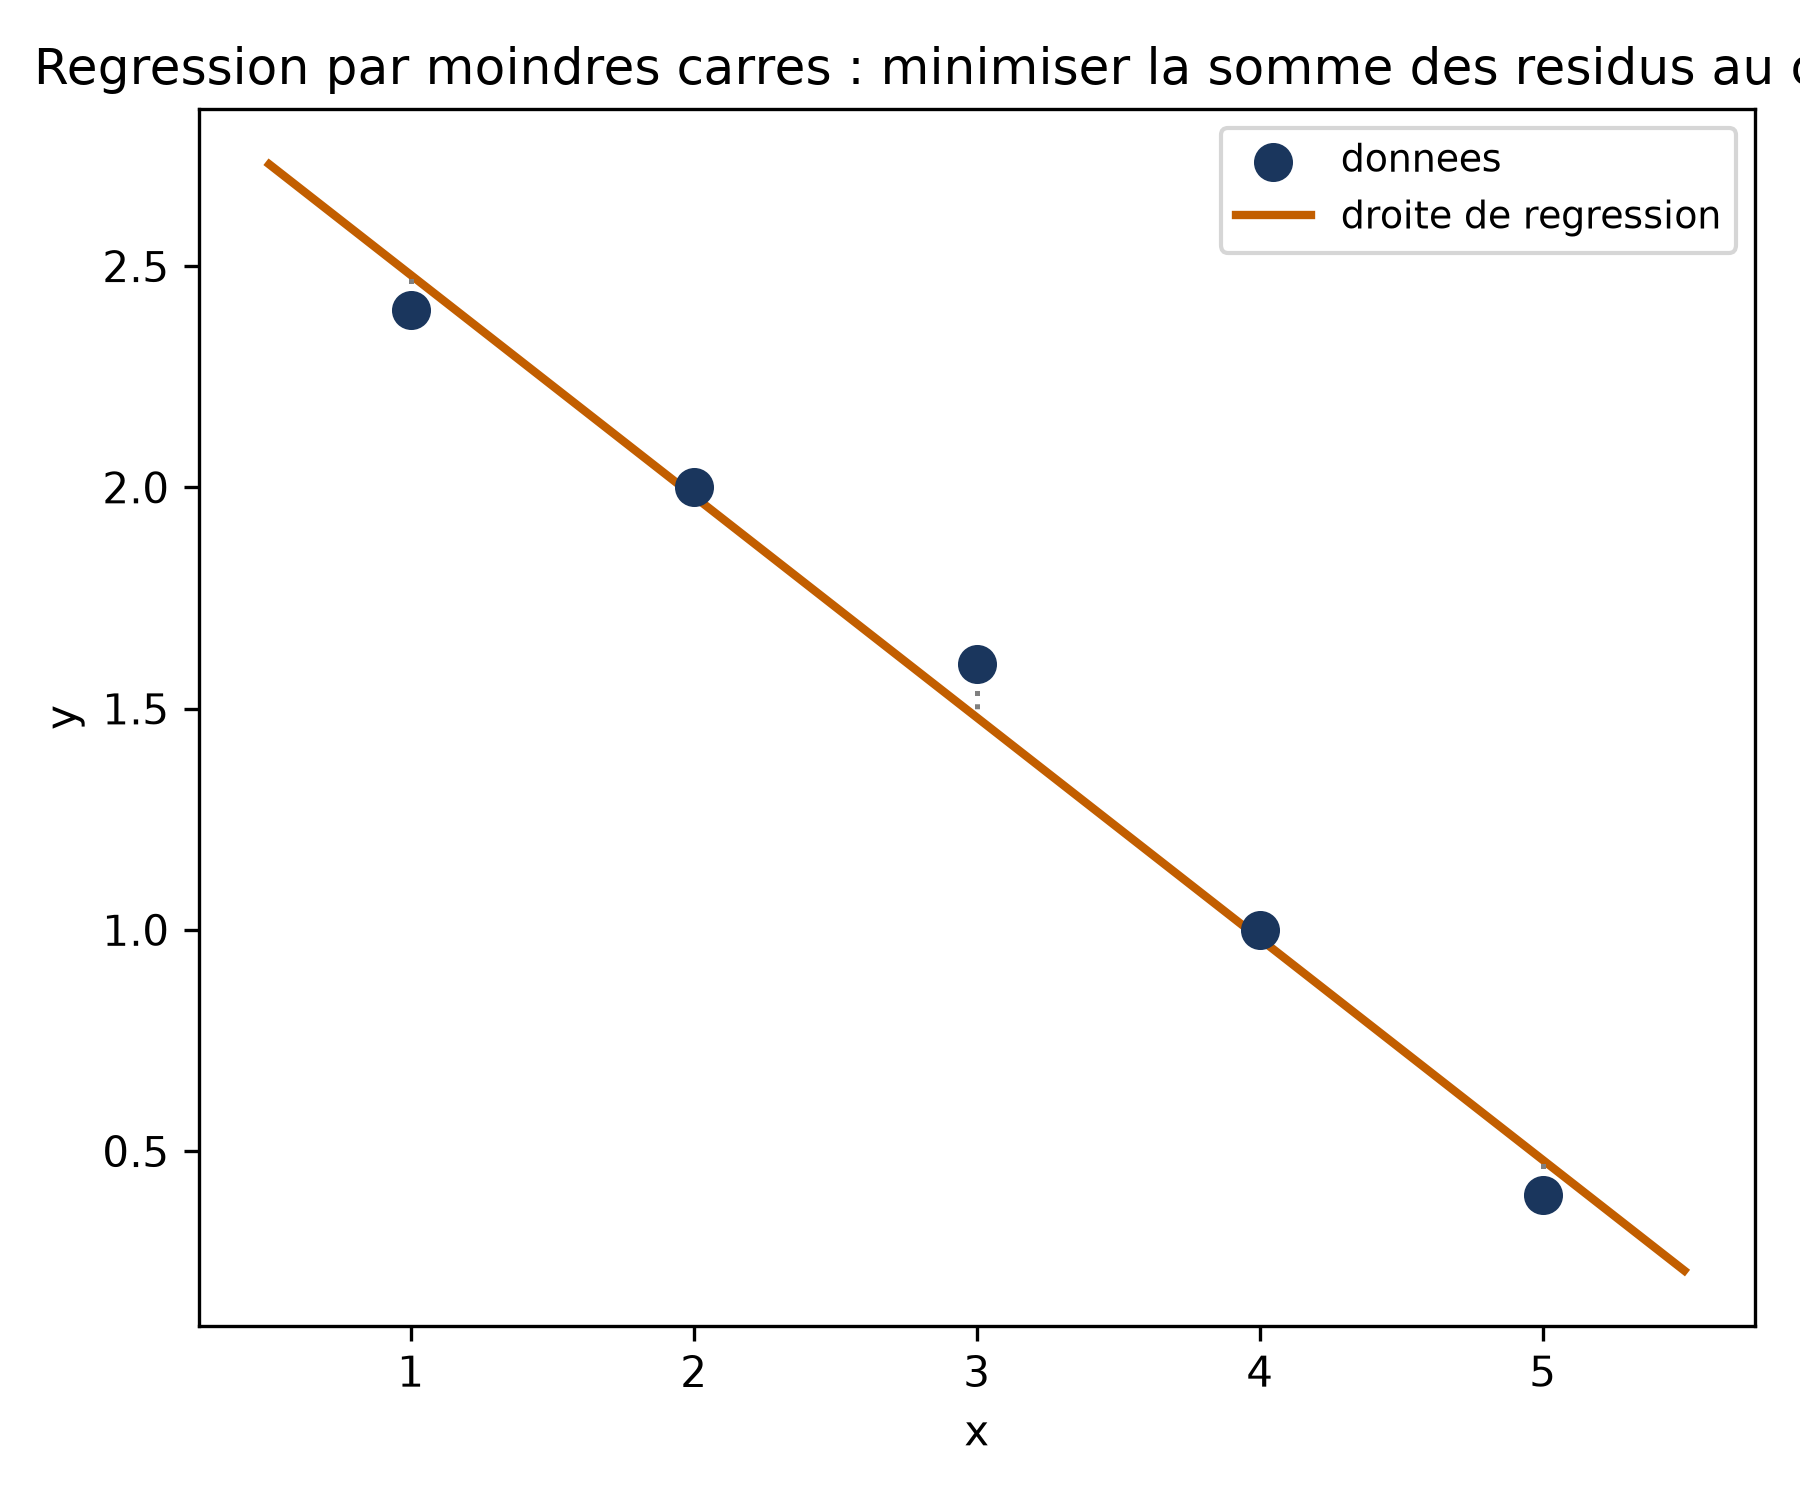
💡 Intuition Si ton modèle répond lui aussi la moyenne partout, son RSS est égal au TSS et son R² tombe à zéro : il n’a rien expliqué.
Lire un R² : de la moyenne pure au sans-faute
Deux valeurs servent de bornes. Un R² de 1 signifie que le modèle explique parfaitement les données observées ; un R² proche de 0 indique qu’il fait à peine mieux que répondre la moyenne partout. Entre les deux, plus la valeur se rapproche de 1, meilleur est l’ajustement. C’est l’un des indicateurs les plus utilisés pour évaluer un modèle de régression.
Prends un R² de 0,61, obtenu en régressant des ventes sur le seul budget télévisé. Il signifie que le RSS vaut encore 39 % du TSS : 39 % de variabilité inexpliquée.
Corrélation au carré : un lien exact, mais pour une seule variable
Avec un seul prédicteur, élève au carré la corrélation entre X et Y : tu retrouves ton R² à la virgule près. Cette corrélation, version normalisée de la covariance, reste toujours entre −1 et 1 ; au carré, elle perd son signe. Le R² ne dit donc rien du sens de la relation.
Avec plusieurs prédicteurs, cette égalité tombe : il n’y a plus un X unique dont prendre la corrélation. Le R² garde pourtant son rôle, celui de la proportion de variabilité de la réponse expliquée.
Calculer le R² avec scikit-learn
Passons à la pratique. Tu disposes de couples (X, Y) fabriqués selon la relation 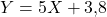 à laquelle s’ajoute un bruit, dont un point aberrant a déjà été retiré. Tu veux un chiffre qui dise quelle part de la variabilité de Y ta droite explique, sur les points qui l’ont formée comme sur des points mis de côté.
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import r2_score
import matplotlib.pyplot as plt
import pandas as pd
import numpy as np

# Load cleaned dataset
cleaned_data = pd.read_csv('cleaned_data.csv')

X_clean = cleaned_data[['X']].values
y_clean = cleaned_data['Y'].values

# Split data (70% train, 30% test)
X_train, X_test, y_train, y_test = train_test_split(
X_clean, y_clean, test_size=0.3, random_state=42)

# Train model
model = LinearRegression()
model.fit(X_train, y_train)

# Predict and evaluate
y_pred = model.predict(X_test)

train_r2 = r2_score(y_train, model.predict(X_train))
test_r2 = r2_score(y_test, y_pred)

print("\nModel Report:")
print(f"Coefficient (slope): {model.coef_[0]:.4f}")
print(f"Intercept: {model.intercept_:.4f}")
print(f"Training R²: {train_r2:.4f}")
print(f"Test R²: {test_r2:.4f}")
La fonction r2_score reçoit les vraies réponses, puis les prédictions du modèle. Elle est appelée deux fois : sur les 70 % de points d’entraînement, puis sur les 30 % réservés, dont y_pred contient les prédictions.
À l’exécution, le R² d’entraînement avoisine 0,95 et celui de test 0,97 : la droite explique environ 95 % puis 97 % de la variabilité des réponses. Elle n’atteint pas 1 parce que chaque point porte son bruit, que même la relation exacte n’effacerait pas.
Ce que le R² ne te dit pas
Un seul nombre ne raconte pas tout. Première limite : il se calcule sur les points qu’on lui donne. Un R² de 1 parle des données observées, d’où le second appel de l’exemple précédent, qui l’évalue sur des points réservés.
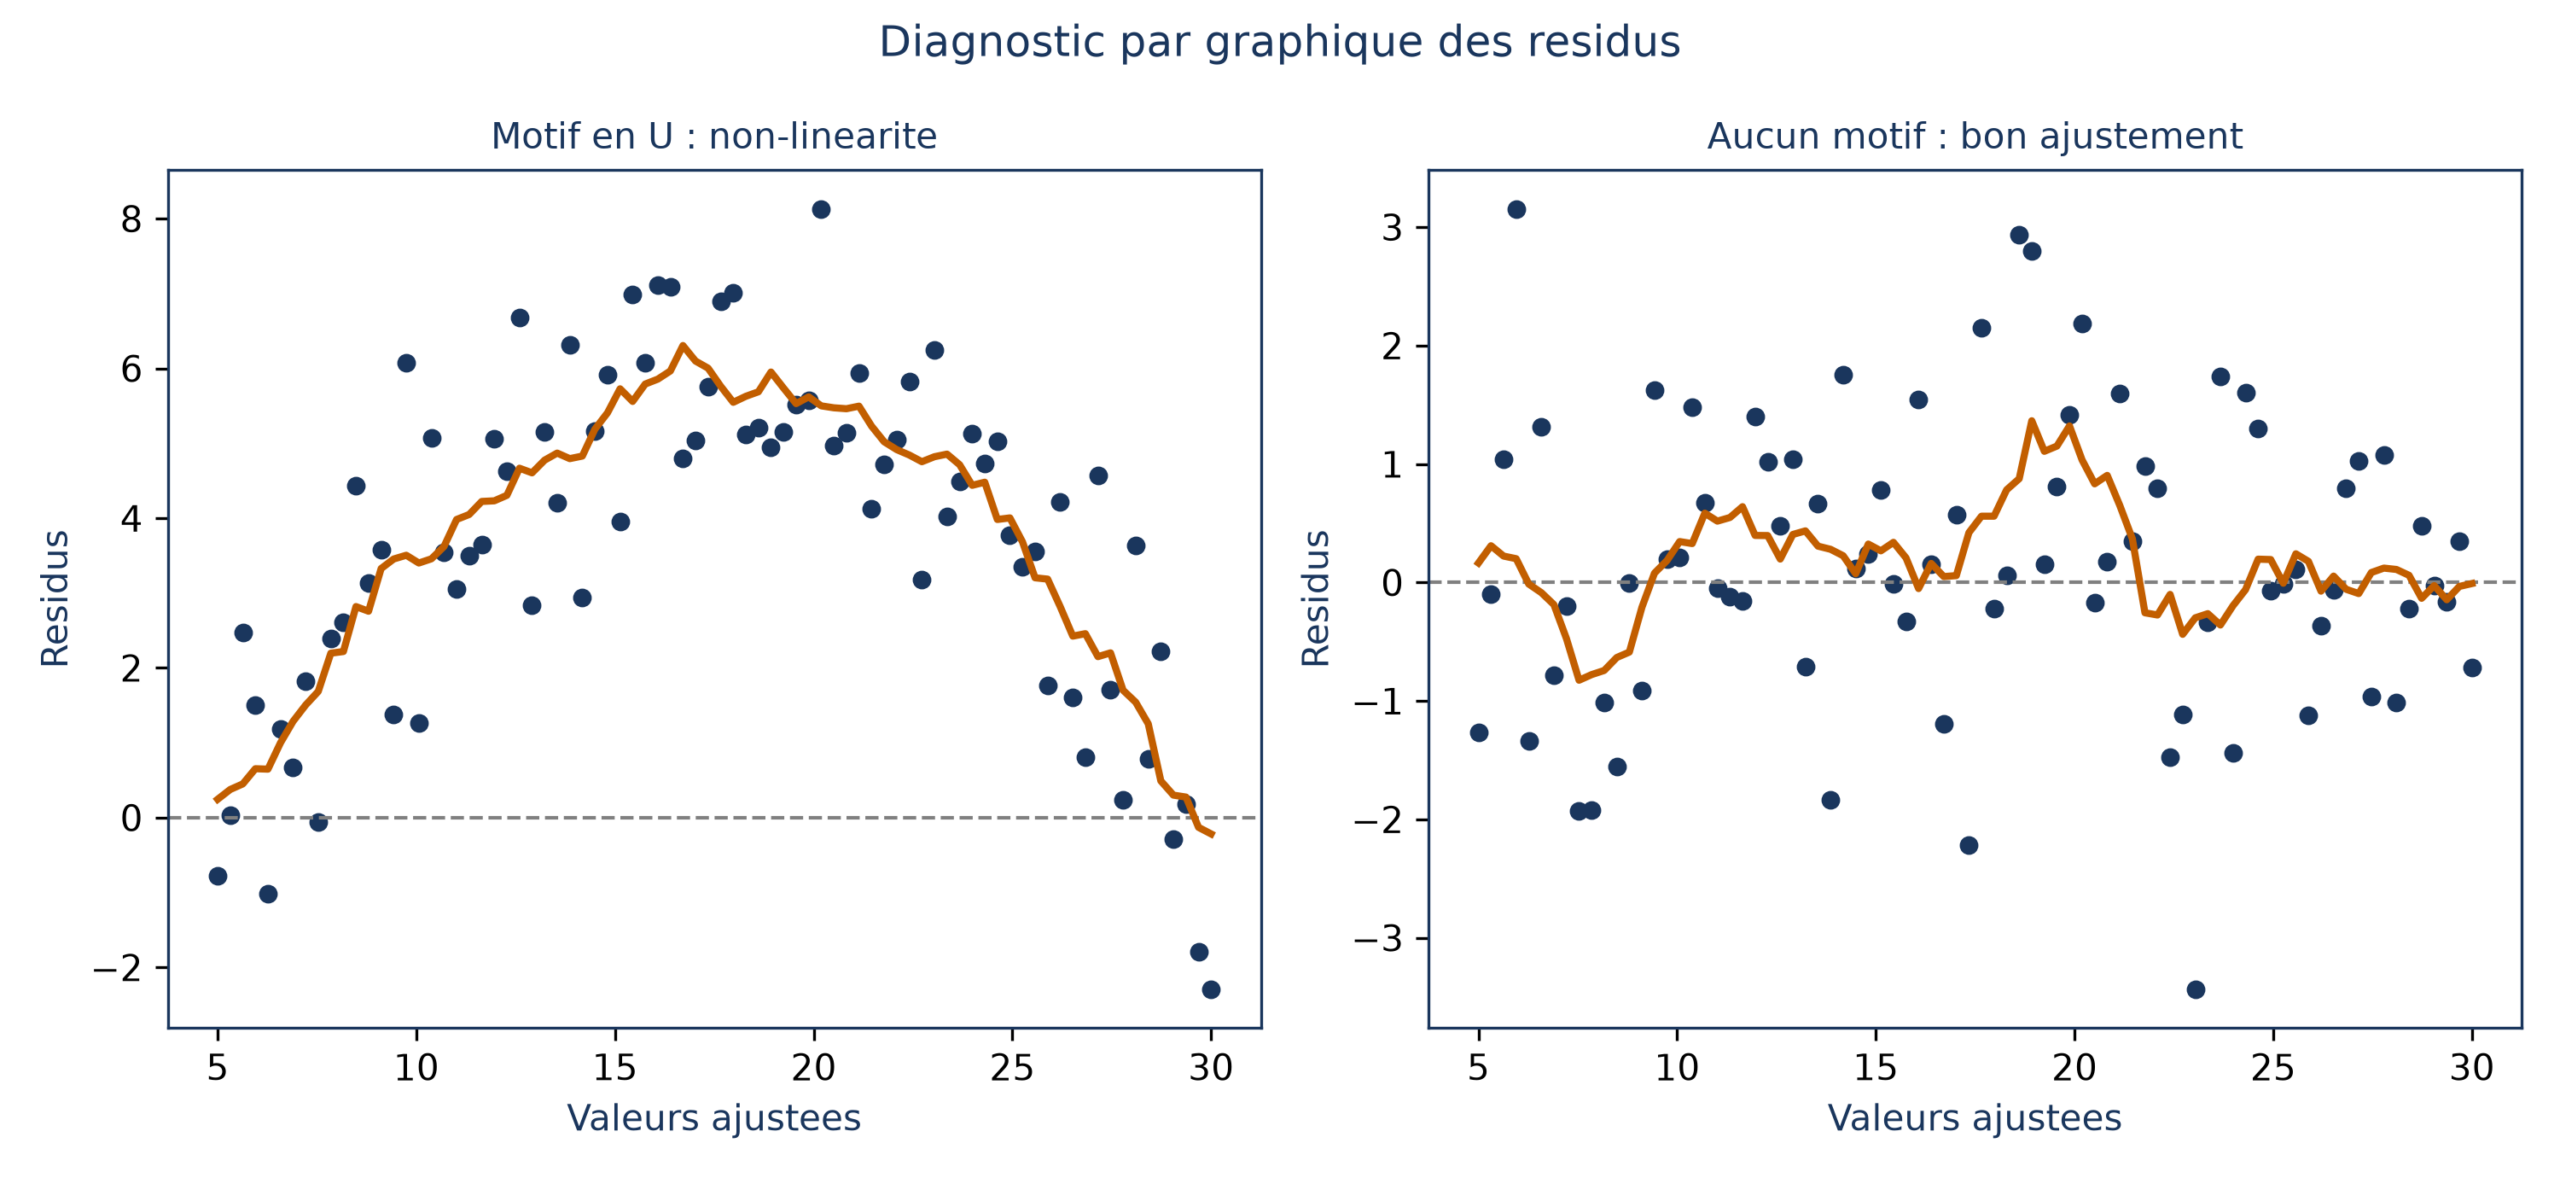
Deuxième limite : comme le R² condense tous les résidus en un seul rapport, il n’en montre pas le dessin. Pour le voir, on trace les résidus contre les valeurs prédites : un nuage qui laisse apparaître une tendance, linéaire ou courbe, signale que le modèle omet une structure présente dans les données.
📌 À retenir Le R² répond à une seule question : quelle fraction de l’erreur du prédicteur « toujours la moyenne » ton modèle a-t-il supprimée ? Pour voir la forme des erreurs, il faut d’autres outils.