Un programme qui dépasse les meilleurs joueurs d’échecs, un assistant conversationnel qui répond poliment, un robot qui apprend une tâche : rien ne relie ces trois mondes, sauf une idée. Dans chacun, personne ne sait écrire à l’avance la bonne action pour chaque situation, alors on laisse le système essayer et on lui dit si c’était bien. Cette page passe en revue les terrains où cette idée fonctionne, de celui où elle règne à ceux où elle peine encore.
Sommaire
- L’essentiel en 30 secondes
- Un seul critère pour trier les terrains : le prix d’un essai
- Les jeux : rater autant de fois qu’il le faut
- Les modèles de langage : le « score » est un jugement humain
- Les robots : le monde physique ne se rejoue pas
- Voiture, santé, énergie : décider avec plusieurs critères en tête
- Ce qui change d’un terrain à l’autre
L’essentiel en 30 secondes
- Le renforcement vise les problèmes où aucun exemple corrigé n’est disponible : le modèle n’a que le résultat de ses actions.
- Les jeux sont le terrain rêvé : un essai n’y coûte rien, et un programme peut s’y entraîner en jouant contre lui-même.
- Pour les modèles de langage, le « score » vient des classements d’évaluateurs humains, appris par un modèle de note.
- Dès qu’on touche au monde physique, un essai devient lent, coûteux ou risqué, d’où le recours aux simulations.
- Pour juger un terrain, pose deux questions : qui dit « c’est bien » ? et combien d’essais peut-on s’offrir ?
Un seul critère pour trier les terrains : le prix d’un essai
Le renforcement est l’outil des problèmes où un modèle doit apprendre de ses actions plutôt que de se faire montrer un exemple positif à imiter. Sa version la plus simple, une machine à sous aux leviers truqués, ressemble déjà à des situations réelles : choisir le meilleur traitement pour un patient, comparer deux variantes dans un test A/B, mesurer une influence sur les réseaux sociaux.
Apprendre de ses actions suppose pourtant d’en tenter beaucoup. Or un essai n’a pas le même prix partout : il ne coûte rien dans une partie qu’on rejoue, mais devient coûteux, dangereux ou long dès que l’interaction se fait avec le monde réel, en robotique ou pour des véhicules autonomes.
Ce prix sert de fil rouge. Les terrains défilent ci-dessous du moins cher au plus délicat, avec pour chacun la même question : d’où vient le signal qui dit « c’est bien » ?
Les jeux : rater autant de fois qu’il le faut
Un jeu est un terrain d’essai sûr : une partie ratée ne coûte rien, ce qui en fait un banc de test pour des idées destinées ensuite à d’autres terrains, la robotique par exemple.
Mesure ce que le renforcement change en regardant les moteurs d’échecs d’avant. À chaque coup, ils construisaient l’arbre de tous les coups légaux, le parcouraient jusqu’à une certaine profondeur et notaient les positions finales avec des règles d’évaluation écrites par des humains : sécurité du roi, structure de pions, contrôle du centre. Ils élaguaient ensuite les branches peu prometteuses. Le résultat restait fait de coups souvent sous-optimaux, pour un calcul coûteux.
AlphaZero, mis au point par DeepMind en 2017, a pris le problème autrement. Il a dépassé les meilleurs joueurs humains aux échecs, au shogi et au go, en partant des seules règles de base. Un unique réseau de neurones porte deux têtes : l’une désigne les coups à considérer, l’autre estime la probabilité de gagner depuis la position.
Pour choisir un coup, il simule des parties possibles avec une recherche arborescente de Monte Carlo : il planifie plusieurs coups à l’avance et explore d’abord les branches que les deux têtes jugent prometteuses. Puis il s’entraîne en jouant contre lui-même. Chaque partie laisse des positions, des coups choisis et un résultat, qui servent à corriger le réseau.
💡 Intuition Quand l’environnement est un simulateur, il fabrique lui-même les exemples que personne n’aurait le temps d’annoter : l’auto-jeu génère bien plus de données d’entraînement que l’étude de parties humaines.
Du plateau au jeu vidéo
Le jeu vidéo ajoute une difficulté : l’agent ne reçoit que des images. Super Mario Bros sert de banc d’essai parce que ses observations en pixels ressemblent à celles des tâches de vision du monde réel. L’agent n’y voit qu’une partie de la situation, il doit donc explorer, et chaque niveau réclame d’autres stratégies, avec une difficulté croissante.
Les compétences mises à l’épreuve sont concrètes : sauter au bon moment par-dessus obstacles et gouffres, décider d’éviter ou d’affronter un ennemi, se repérer dans l’espace pour planifier un trajet. Les pièces ramassées donnent une récompense immédiate, terminer le niveau une récompense différée, qui oblige à viser le long terme.
Pour l’entraîner, plusieurs agents jouent en parallèle et partagent un même modèle global : chacun explore des zones différentes, ce qui produit des expériences plus variées et une stratégie plus générale. Un terme d’entropie décourage les choix trop gloutons et évite à l’agent de rester coincé dans une stratégie médiocre. Le même modèle s’applique ensuite à d’autres jeux vidéo.
Les modèles de langage : le « score » est un jugement humain
Après son entraînement initial, un modèle de langage sait surtout prédire le mot suivant : un autocomplete sophistiqué, qui a pourtant absorbé un vaste savoir. Cet objectif n’a rien à voir avec ce qu’on attend d’un assistant, qui doit être utile, honnête et inoffensif. Laissé tel quel, le modèle peut produire un texte biaisé ou dangereux, ou suivre mal les consignes.
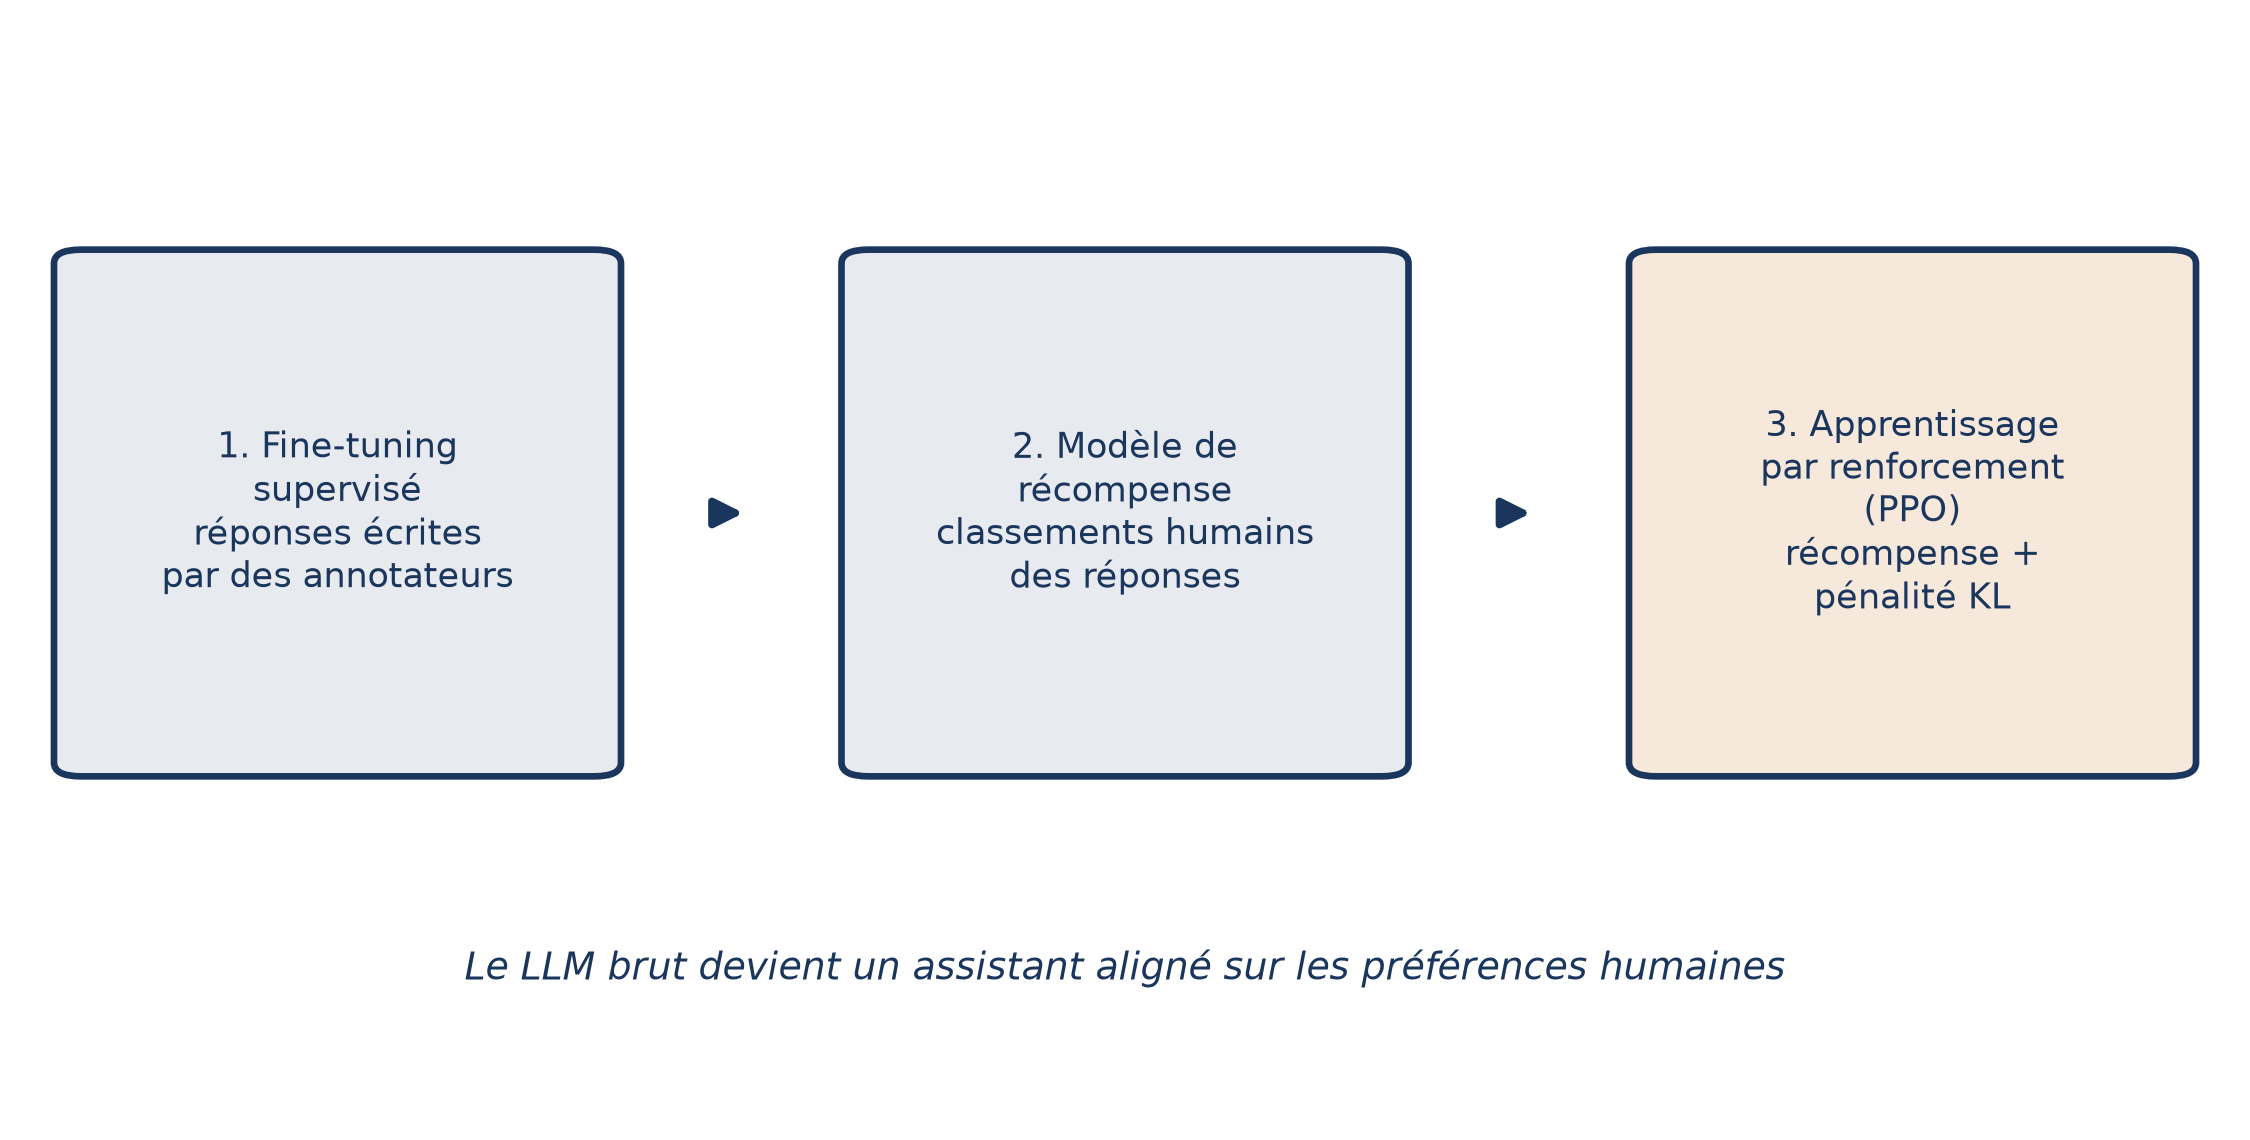
Écrire cette attente en formule est impossible, car les valeurs humaines sont subjectives. On a donc fait entrer l’humain dans la boucle. Derrière le succès de ChatGPT, il y a le RLHF, l’apprentissage par renforcement à partir du retour humain, qui se déroule en trois étapes :
- Imiter : des annotateurs écrivent les réponses attendues à une liste de consignes (de 10 000 à 100 000 paires), et le modèle est ajusté pour les imiter.
- Apprendre à noter : le modèle propose plusieurs réponses par consigne, les annotateurs les classent de la plus à la moins appréciée, et un second modèle apprend de ces classements à fournir une note unique.
- Optimiser : l’algorithme de renforcement PPO met à jour le modèle pour que ses réponses obtiennent une meilleure note, avec une pénalité qui l’empêche de trop s’éloigner de son texte d’origine.
Ce score humain a un prix. Collecter des préférences exige d’embaucher des annotateurs, qu’il faut sélectionner pour éviter une qualité inégale, et le procédé reste complexe et instable.
Le renforcement sert aussi à écrire les consignes elles-mêmes. Choisir le texte à donner à un modèle se pose comme un problème de renforcement : un agent construit des consignes adaptées à chaque requête, ou un réseau apprend à les générer, et elles se transfèrent souvent d’un modèle à l’autre. Détail surprenant : certaines consignes optimisées sont du charabia grammatical, preuve qu’un bon prompt n’a pas à imiter le langage humain.
Les robots : le monde physique ne se rejoue pas
Ici, impossible de compter sur une partie qu’on relance à volonté. Il n’existe pas de jeux de données de qualité pour entraîner un robot dans un environnement : le renforcement réclame des données sur ses actions et leurs effets, et celles collectées pour une tâche ne servent pas forcément à une autre. Celles d’un robot chien ne conviennent pas à un robot humanoïde.
L’entraînement exige en outre une interaction avec l’environnement, laborieuse et lente.
⚠️ Piège Pour contourner la lenteur du réel, on s’entraîne dans des jeux et des simulations. Mais ils simplifient le monde, et ce qui marche en simulation peut ne pas suffire une fois le robot en situation.
Un autre obstacle tient à la façon de demander la tâche. Des utilisateurs différents formulent leurs instructions de manière hétérogène, ce qui complique l’apprentissage ; un modèle de langage peut les traduire en un langage formel standard, plus facile à apprendre pour l’agent.
Voiture, santé, énergie : décider avec plusieurs critères en tête
Au volant, l’agent évolue dans un environnement changeant et complexe, où le renforcement sert à décider. Il doit croiser des capteurs variés, visuels, lidar, radar, avec du contexte : code de la route, comportement des autres usagers, imprévus.
La difficulté se déplace alors vers la récompense. Elle peut tenir compte non seulement de la sécurité, mais aussi du confort des passagers et de l’efficacité du moteur.
On retrouve le renforcement en santé, où il sert à apprendre des recommandations et des suggestions, et dans l’énergie : usage, transport, conversion et stockage, avec un rôle attendu dans des technologies futures comme la fusion nucléaire.
Quand les décisions comptent, comprendre l’agent devient une exigence. Le renforcement explicable cherche à expliquer clairement à un humain le comportement d’un agent : un modèle de langage peut dire en langage naturel pourquoi il a pris telle décision, ce qui permet de vérifier sa sûreté. La qualité de l’explication dépend toutefois de la capacité de ce modèle à comprendre l’environnement et la logique de l’agent.
Ce qui change d’un terrain à l’autre
Mis côte à côte, ces terrains partagent le même cœur. Ce qui varie, c’est l’origine du signal et le prix d’un essai.
| Terrain | Pourquoi il se prête au renforcement | Ce qui complique |
|---|---|---|
| Jeux | une partie ratée ne coûte rien, le jeu fournit ses propres données | observations en pixels, vision partielle de la situation |
| Langage | aucune formule ne dit ce qu’est une bonne réponse, d’où un modèle de note appris | annotateurs à recruter, procédé complexe et instable |
| Robots | des tâches physiques où l’on apprend en agissant | peu de données, interaction lente, simulation qui simplifie le réel |
| Conduite | des décisions dans un environnement changeant, nourries par des capteurs variés | une récompense qui doit arbitrer sécurité, confort et efficacité |
📌 À retenir Un terrain se juge moins à sa discipline qu’à deux réponses : d’où vient le signal qui dit « c’est bien », et combien d’essais peut-on s’offrir ?