Lundi matin, ta boutique en ligne reçoit un message : « Ma tasse est arrivée fêlée. » Une photo est jointe. Puis un client laisse un message vocal, et un autre pose une question sur ta politique de retour. Texte, image, voix : trois formats, et pourtant une seule famille d’architectures sait s’attaquer aux trois. Voici la carte des problèmes réels où un Transformer s’applique, avec de quoi placer le tien dessus.
Sommaire
- L’essentiel en 30 secondes
- Une architecture, six familles de problèmes
- Chercher dans tes documents par le sens
- Relier une photo et une phrase
- Fabriquer des images, des voix, des sons
- Écrire avec toi : conversation, terminal et code
- Tenir un métier : les agents
- Donner un plan d’action à un robot ou à un véhicule
- Là où ça se gâte
- Repérer ton problème : étroit, mesurable, testé
L’essentiel en 30 secondes
- Un Transformer s’applique à tout ce qui devient une suite de jetons : texte, morceaux d’image, son, notes de musique, ADN.
- Sur le texte, il sert à chercher par le sens dans tes propres documents, puis à rédiger la réponse.
- Avec l’image et la voix, il permet de relier photo, légende et parole, et de fabriquer des images.
- Côté conversation et code, il équipe des assistants, terminaux et copilotes ; avec des outils, il devient un agent de métier.
- Les échecs coûteux viennent d’actions mal contrôlées : commence par un cas étroit, mesurable et testé.
Une architecture, six familles de problèmes
Pour savoir à quelle porte frapper, regarde ce qui entre et ce qui sort. Un modèle se décrit par sa modalité : les types d’entrées qu’il accepte et les types de sorties qu’il crée.
| Ce qui entre | Ce qui sort | Problème typique |
|---|---|---|
| Texte | Texte | conversation, assistant, aide au code |
| Texte ou image | Vecteur de nombres | recherche par le sens, regroupement |
| Texte et image (ou vidéo) | Texte | poser des questions sur une photo |
| Voix | Texte | transcription |
| Texte | Voix | synthèse vocale |
| Texte | Image | génération d’images |
Ce qui rend ce tableau possible tient en une phrase : si l’on sait transformer un type de données en vecteurs, on peut le donner aux blocs d’un Transformer. Il reste à trouver, pour chaque type de donnée, la bonne représentation numérique ; la suite du travail est la même.
Quant à la façon de produire la sortie, deux mécanismes dominent : prédire le jeton suivant, ou partir d’un bruit aléatoire et le raffiner pas à pas.
Chercher dans tes documents par le sens
Un client demande : « Puis-je être remboursé si ma tasse arrive fêlée ? » La réponse dort dans ta politique de retour, mais la question et le texte ne partagent peut-être aucun mot. Ce qui les rapproche, c’est leur sens, et c’est exactement ce que capturent les embeddings.
Un ordinateur ne traite que des nombres : un embedding transforme un mot, une phrase ou un document en vecteur, et le modèle apprend à placer côte à côte ce qui signifie la même chose. Avec une seule dimension, on peine à représenter fidèlement « chien », « aboyer » et « voler » ; plus de dimensions donnent plus de finesse au sens.
En pratique, tu n’entraînes presque jamais ce modèle toi-même. Il en existe de prêts à l’emploi : ceux d’OpenAI sortent des vecteurs de 1 536 ou 3 072 dimensions, celui de Google jusqu’à 768, et d’autres viennent de Mistral AI ou de Cohere. Certains sont spécialisés par domaine, comme voyage-law-2 pour le juridique et voyage-code-2 pour le code.
Pour choisir, le classement MTEB compare ces modèles sur plusieurs tâches : classification, recherche, regroupement.
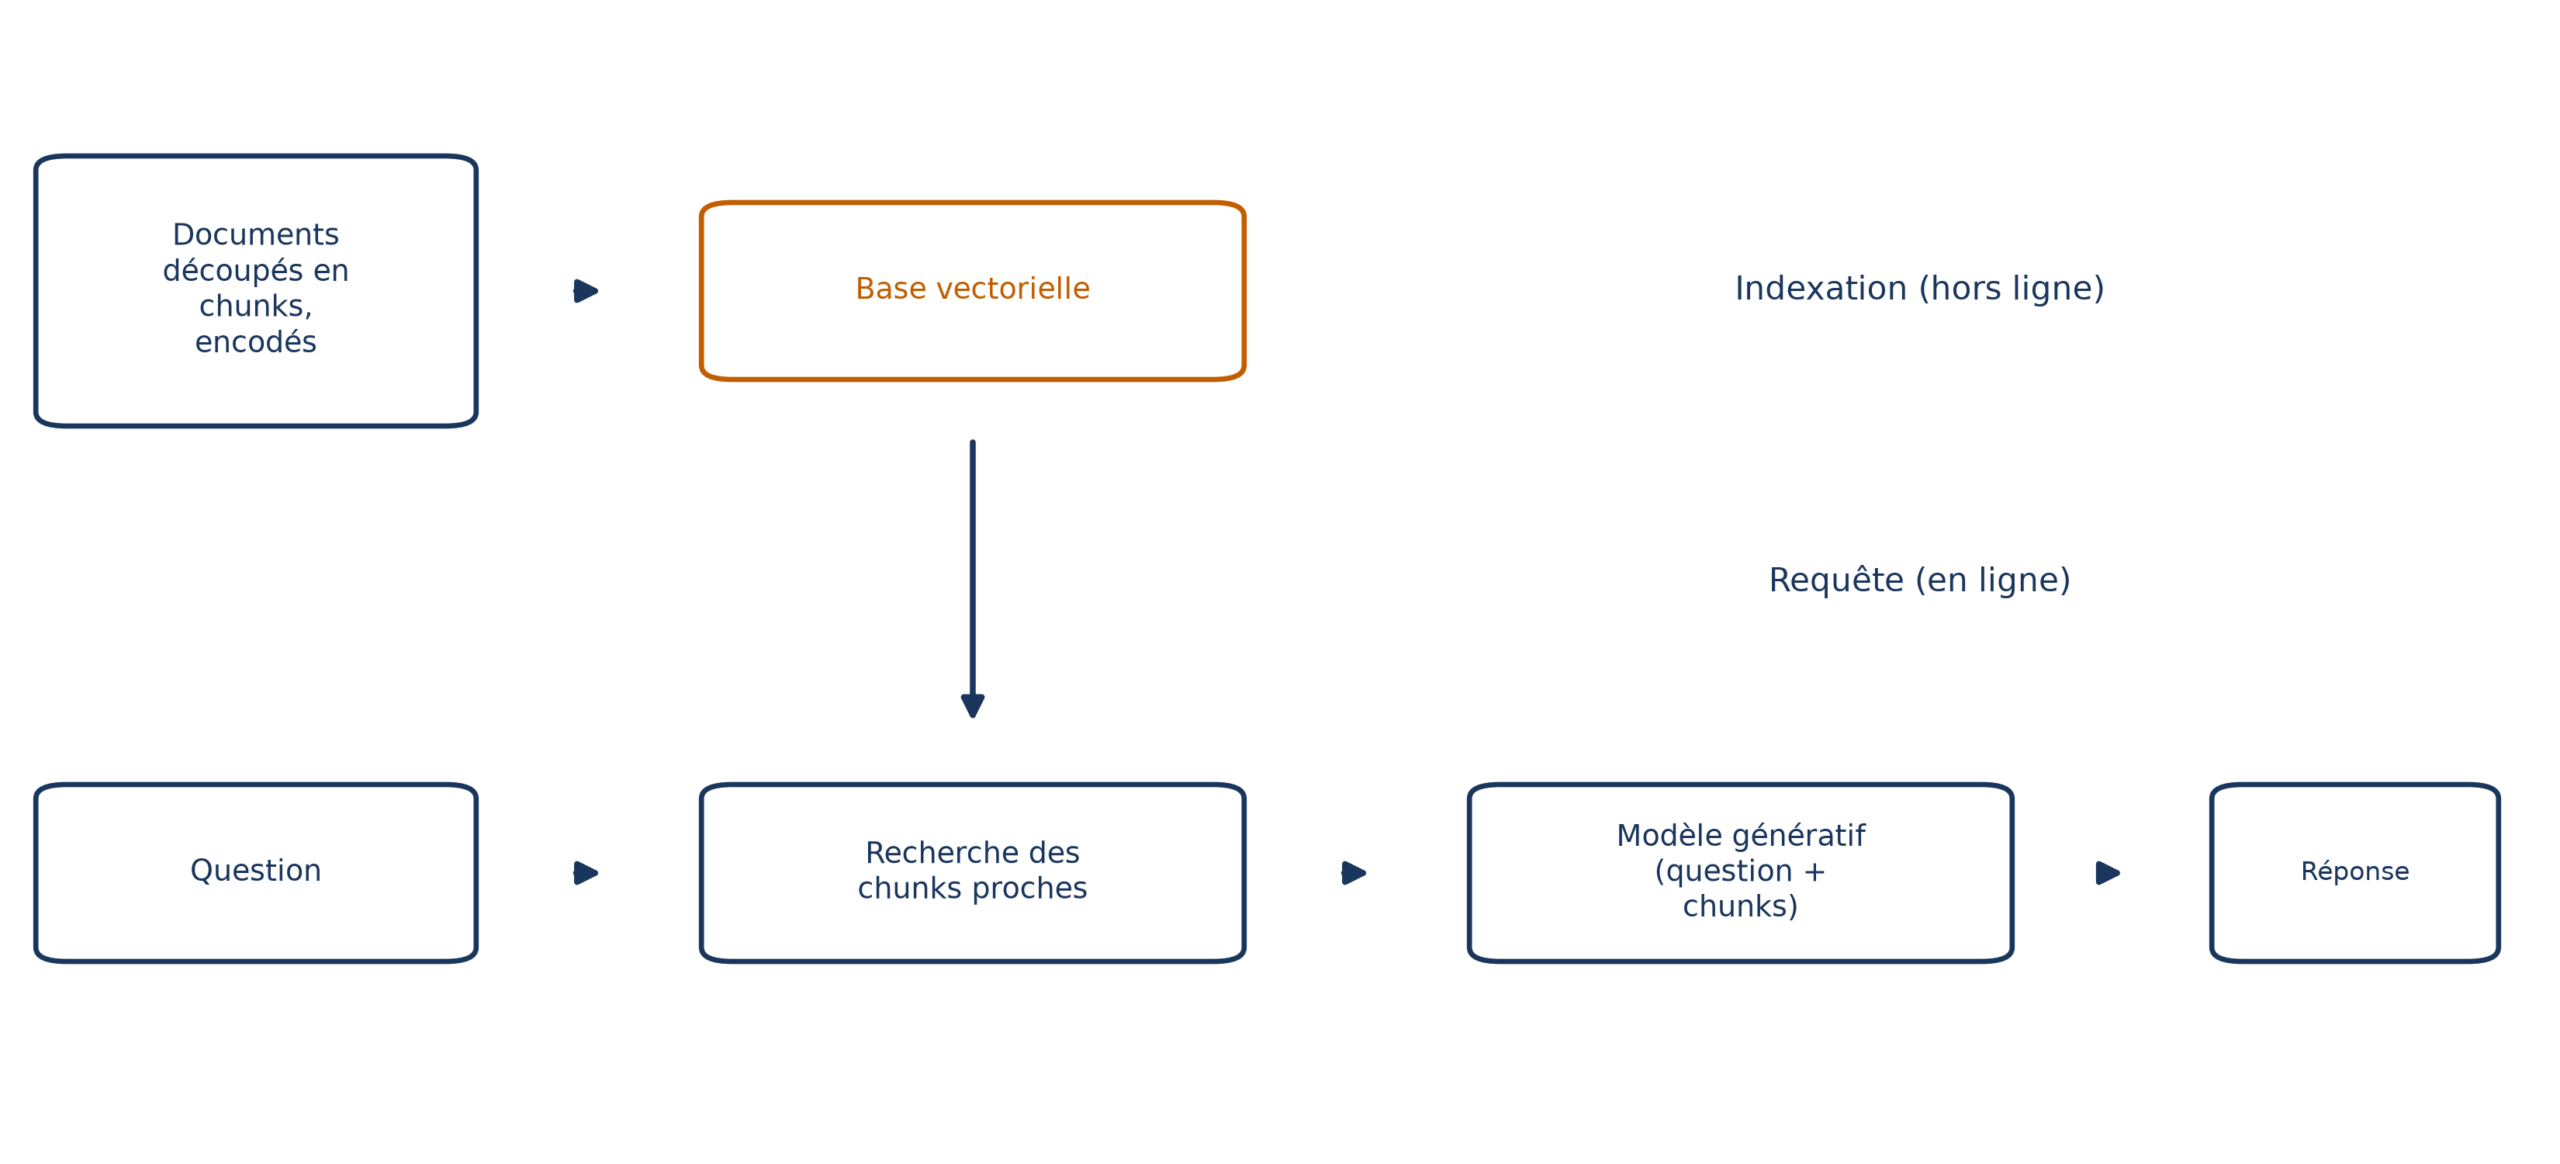
Reste à fabriquer la réponse. On découpe d’abord les documents en petits morceaux, car le modèle, comme une personne, n’a pas besoin de relire toute une longue ressource, seulement la partie utile. On encode ces morceaux et on les range dans une base vectorielle.
Relier une photo et une phrase
Ton client a joint la photo de la tasse. Pour les images, les Transformers ont fait leur entrée avec le Vision Transformer (ViT), supérieur aux réseaux convolutifs sur plusieurs tâches : classification d’images, détection d’objets, segmentation.
Le principe est de transformer l’image en suite de jetons. Une image de  pixels de haut sur
 de large, coupée en carrés de
 pixels de côté, fournit :

 est le nombre de jetons que reçoit le Transformer : plus les carrés sont petits, plus l’image fournit de jetons. Chaque jeton a ensuite pour longueur
 , où
 vaut 3 pour une image en couleur et 1 en noir et blanc, avant d’être projeté à une taille choisie.
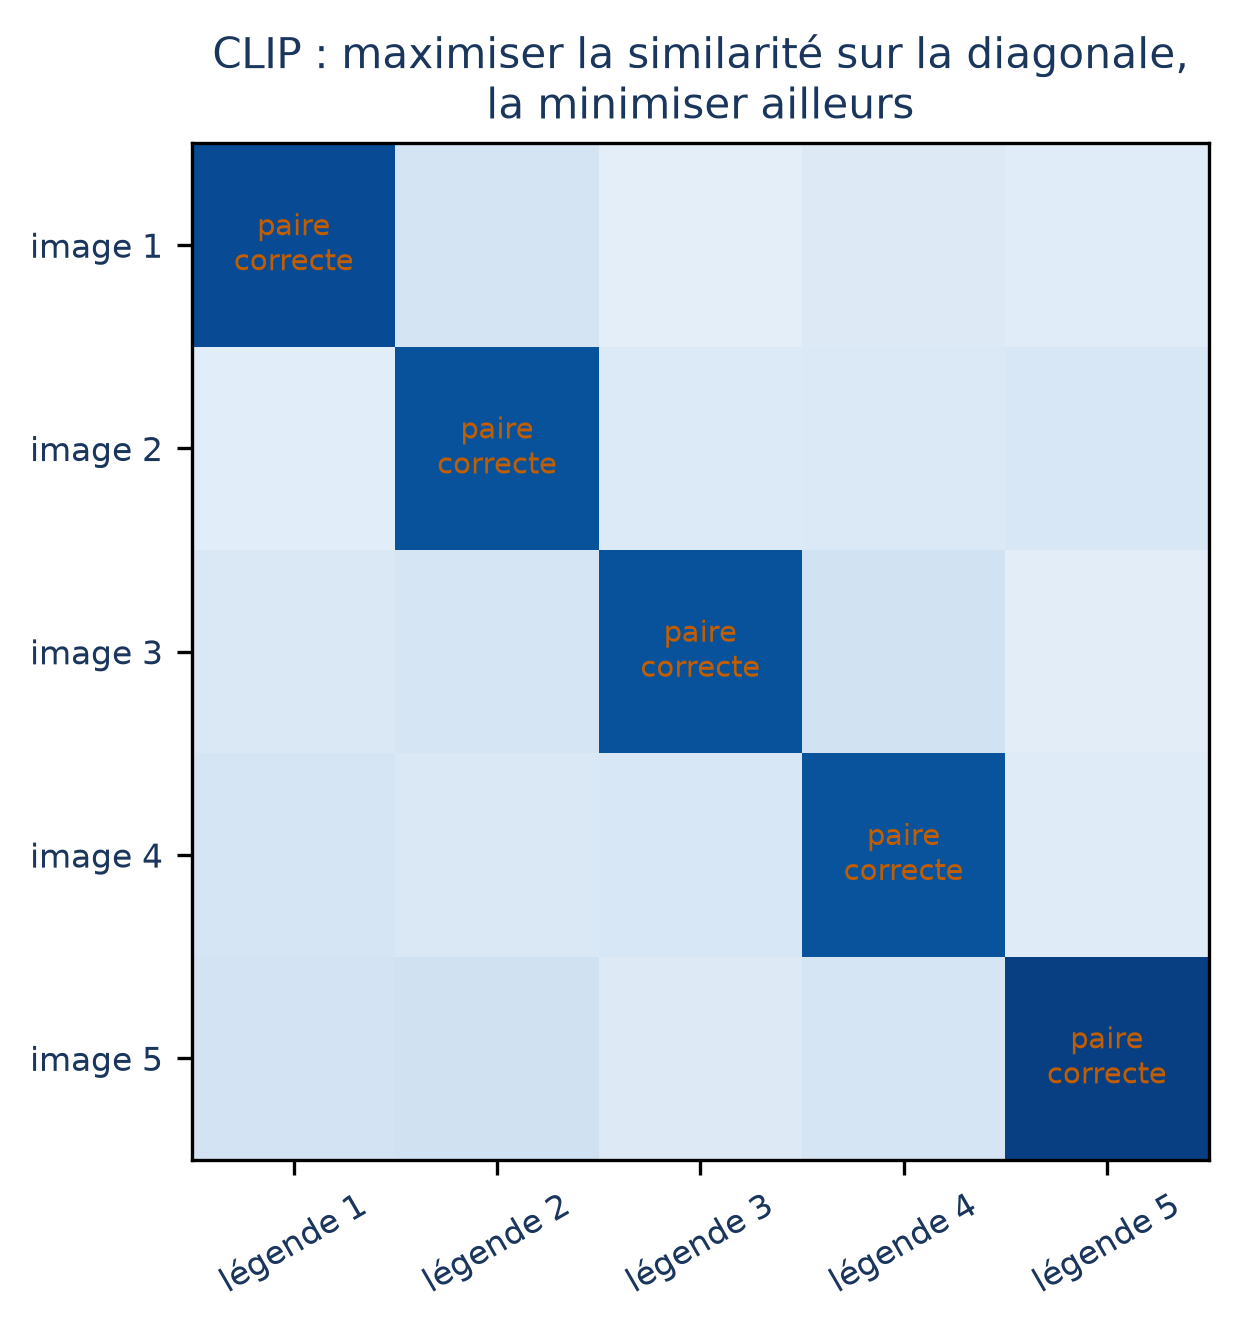
Classer une photo ne suffit pas pour la relier à du texte. Il faut un espace commun où une image et sa légende deviennent voisines : c’est ce que fait CLIP, entraîné sur 400 millions de paires (image, texte) collectées sur internet. Un Transformer encode les images, un autre les légendes, et l’entraînement maximise la similarité d’une image avec sa bonne légende tout en la minimisant avec les autres.
Avec une bibliothèque de modèles prêts à l’emploi, comparer images et légendes tient en quelques lignes. On suppose ici que images et captions sont deux listes préparées, des images et leurs légendes :
from sentence_transformers import SentenceTransformer, util
model = SentenceTransformer('clip-ViT-B-32')
image_embeddings = model.encode(images, convert_to_tensor=True)
caption_embeddings = model.encode(
    captions, convert_to_tensor=True)
similarity_matrix = util.cos_sim(
    image_embeddings, caption_embeddings)
La matrice obtenue compare chaque image à chaque légende. Elle ouvre trois problèmes concrets : classer une image sans l’avoir vue (classification dite zero-shot, à partir d’une simple liste d’étiquettes), chercher dans de grands jeux d’images, et regrouper des images puis nommer les groupes avec des mots-clés.
CLIP a une limite : il ne produit pas de texte. Pour décrire la photo de la tasse ou répondre à des questions sur elle, il faut un modèle vision-langage. BLIP-2 en donne la recette : au lieu de partir de zéro, on relie un LLM et un ViT par un petit pont, le Q-Former, qui est la seule partie entraînée. Le modèle sait alors décrire une image et dialoguer à son sujet.
Fabriquer des images, des voix, des sons
Les Transformers ne font pas que comprendre : ils créent. Stable Diffusion, jalon de la génération texte-image, comprend trois éléments : un encodeur de texte (souvent CLIP) qui rend un vecteur, un générateur (un U-Net) qui produit une représentation compacte de l’image, dite latente, et un décodeur qui la transforme en image.
Les modèles d’images plus récents reposent sur des transformeurs de diffusion, qui traitent des petits carrés de 2 × 2 ou 4 × 4 pixels, avec recouvrement, dans cet espace latent.
Le progrès se mesure en comparant SDXL à la famille Qwen Image. Cette dernière dépasse largement l’ancien modèle en fidélité au texte demandé, en exactitude des visages, des mains et des détails, et en rendu lisible du texte. Elle prend aussi en charge l’image-vers-image. Le débruiteur passe de moins de 4 à 20 milliards de paramètres, soit cinq fois plus.
Ces gains ne tiennent pas à une idée neuve : ils viennent de composants plus gros et de pipelines plus complexes.
Côté son, la liste est longue : la transcription convertit la voix en texte, la synthèse vocale fait l’inverse, et d’autres modèles font de la parole à parole, de la musique, de la vidéo ou de la 3D.
Pour ton message vocal, la voix pose un problème de fond : elle transporte des informations absentes de l’écrit (intonation, pauses) qui peuvent changer le sens d’un message. Une musique, une série temporelle ou une séquence d’ADN restent des séquences, qu’un Transformer sait lire.
Écrire avec toi : conversation, terminal et code
La modalité la plus répandue reste le texte : chatbots de service client, assistants de productivité, outils en ligne de commande. Il convient quand la communication doit être claire, asynchrone ou consultable, car il laisse une trace de chaque échange.
Le terminal en est un bon exemple. Warp traduit des commandes en langage naturel, complète intelligemment la saisie et explique les erreurs ; Claude Code et Gemini CLI vont jusqu’à générer du code, l’exécuter et manipuler des fichiers depuis la ligne de commande. Là où il fallait mémoriser des options, tu décris ton intention et l’outil l’interprète.
Un défaut guette ces interfaces : la découvrabilité. Rien ne dit à l’utilisateur ce que l’agent sait faire. La parade consiste à annoncer ses fonctions dès l’accueil : annuler une commande, suivre une livraison, modifier un compte.
Les interfaces graphiques prennent le relais quand la structure visuelle compte. Des éditeurs comme Cursor, Windsurf ou Cline intègrent le langage naturel au flux de codage : poser des questions, générer du code, refactoriser, recevoir des explications. Perplexity, lui, produit des fiches structurées, des listes de références et des tableaux adaptés à la question.
Le texte brille surtout quand précision, traçabilité et échanges asynchrones comptent : support client, messageries comme Slack, Teams ou WhatsApp, traitement de sinistres, recherche documentaire.
Tenir un métier : les agents
Un assistant qui ne fait que répondre s’arrête là où ton problème commence souvent : il faut agir. Rembourser, mettre à jour une commande, isoler une machine : ce sont les outils, des capacités précises qu’un agent peut déclencher, qui permettent de faire de vrais changements.
Voici sept métiers où l’on construit déjà de tels agents :
| Métier | Ce que fait l’agent |
|---|---|
| Support client | traite les demandes courantes, gère les remboursements, met à jour les commandes, escalade vers un humain |
| Services financiers | aide sur les comptes et les prêts, enquête sur la fraude, rééquilibre un portefeuille |
| Accueil en santé | enregistre les patients, vérifie les assurances, évalue les symptômes, planifie les consultations |
| Support informatique | gère les accès, dépanne réseaux et systèmes, répond aux incidents de sécurité |
| Revue juridique | relit des contrats, contrôle la conformité, suit les échéances |
| Centre d’opérations de sécurité | trie les alertes, interroge les journaux, isole les machines compromises |
| Chaîne logistique | optimise les stocks, suit les expéditions, prévoit la demande |
Plusieurs agents peuvent aussi se partager un travail long. Dans un laboratoire virtuel, des agents jouent le doctorant, le post-doctorant, l’ingénieur ML et le professeur : ils font la recherche bibliographique, écrivent et testent le code, puis rédigent un rapport en LaTeX.
Le point clé est la place de l’humain : les agents prennent les tâches répétitives et laissent la main là où la créativité ou le jugement comptent. Le retour humain à diverses étapes améliore sensiblement la qualité des résultats.
Donner un plan d’action à un robot ou à un véhicule
Dernier territoire : l’apprentissage par renforcement, où un agent apprend par essais et erreurs en agissant sur un environnement qui lui renvoie un retour. Les LLM peuvent l’aider de quatre façons.
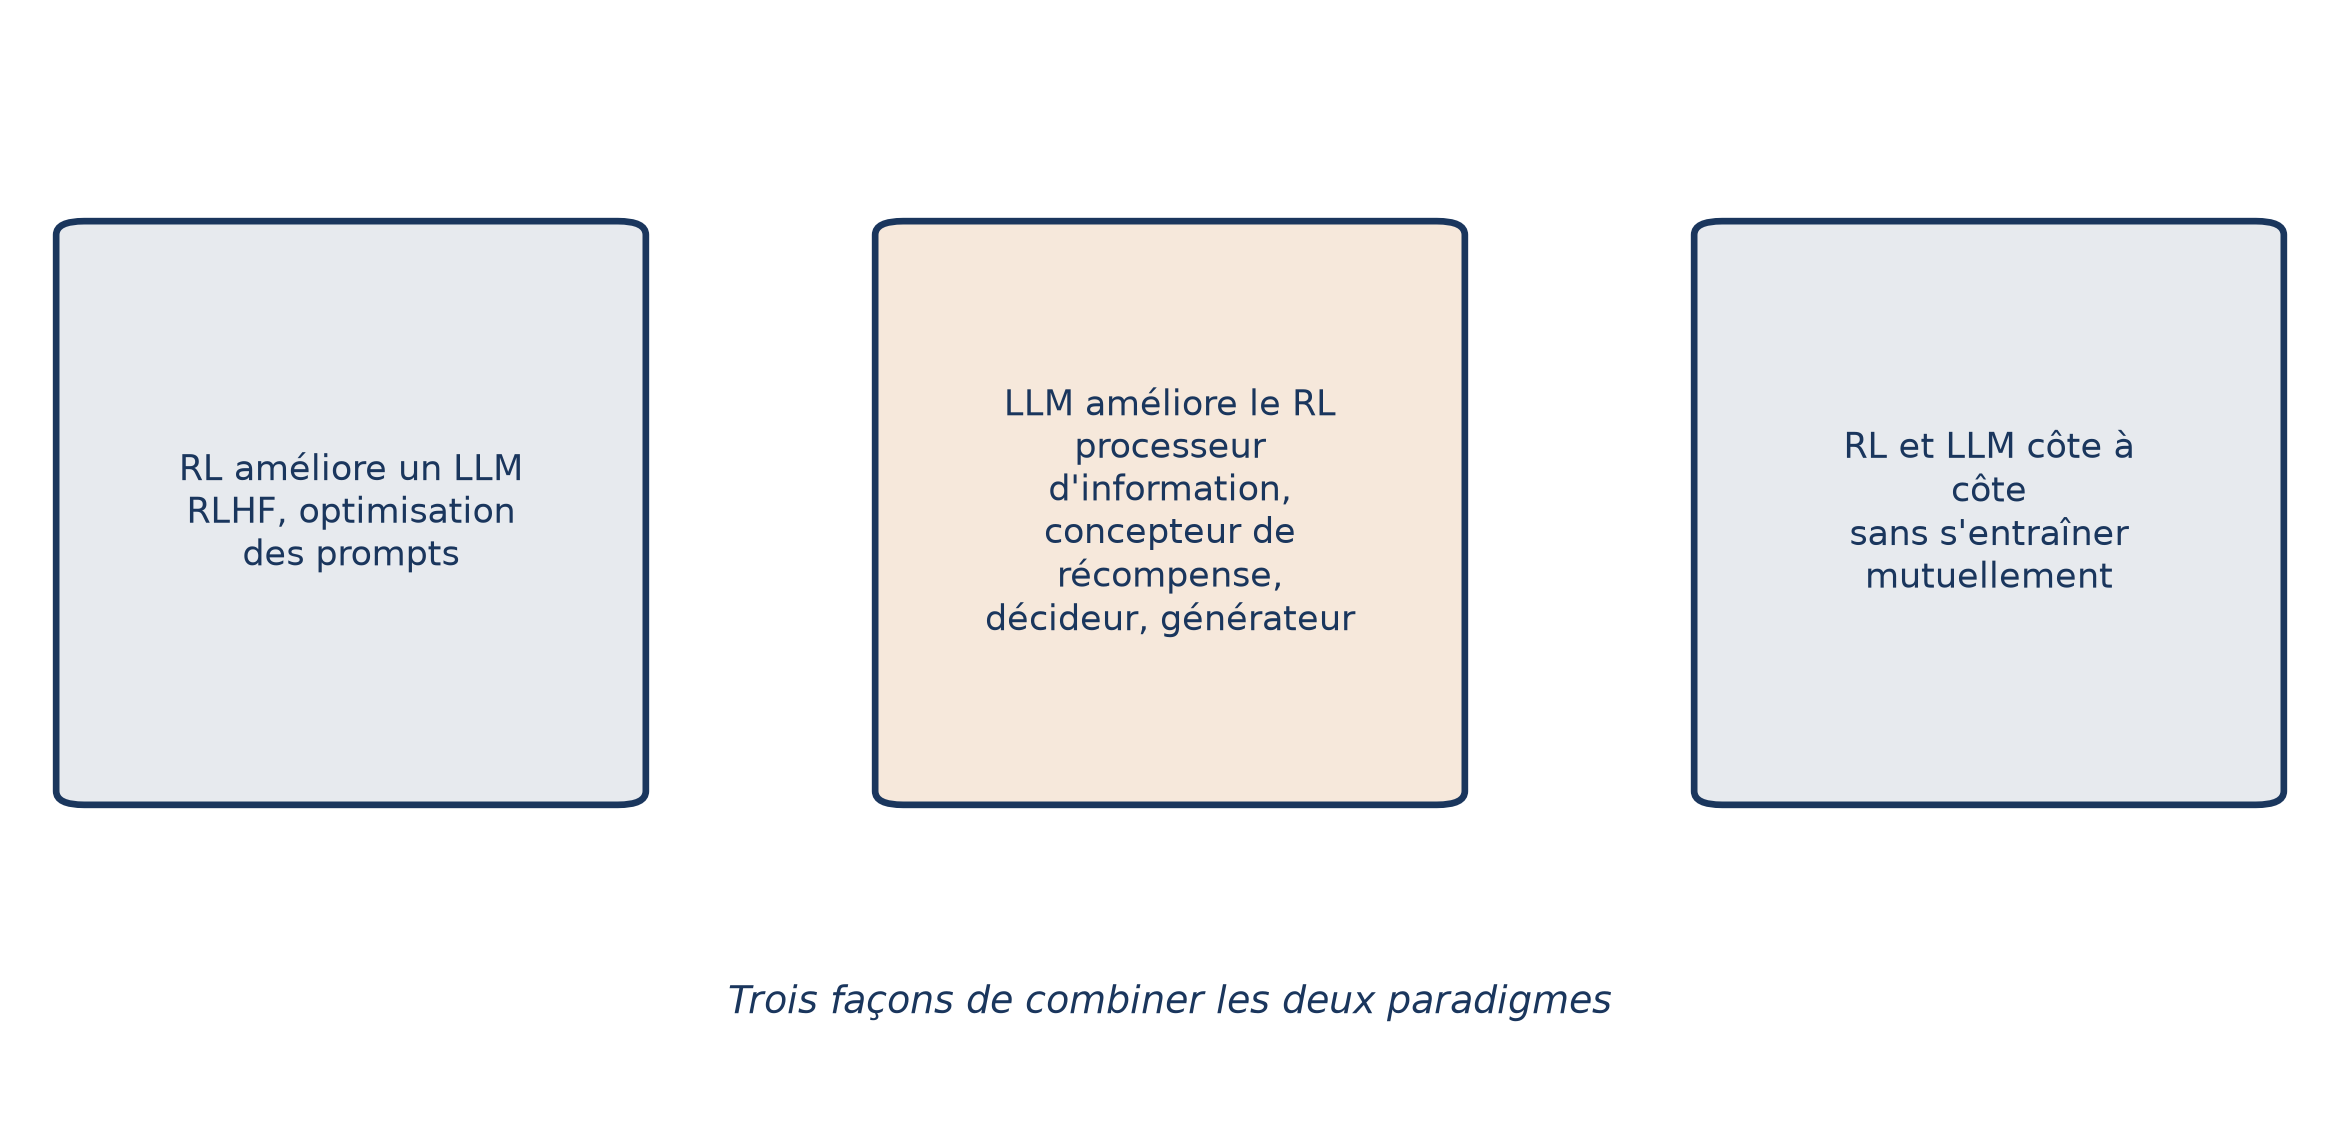
- Processeur d’information : un robot reçoit des instructions de formes très variées ; le LLM les traduit en un langage formel standard, plus facile à apprendre.
- Concepteur de récompenses : dans un jeu, la victoire donne un signal clair. Quand les tâches sont longues et complexes, le LLM évalue le comportement de l’agent, ou écrit le code d’une fonction de récompense.
- Décideur : dans un jeu textuel, l’espace d’actions est immense ; le LLM le réduit en proposant des candidates raisonnables, ce qui accélère l’entraînement.
- Générateur : il simule des trajectoires pour que l’agent apprenne et planifie, comme dans des jeux vidéo.
Il peut aussi expliquer en langage naturel pourquoi un agent a pris telle décision, ce qui aide à vérifier sa sûreté.
Les domaines visés sont concrets : la robotique, la conduite autonome (capteurs visuels, lidar et radar combinés au code de la route, avec des récompenses qui tiennent compte de la sécurité mais aussi du confort des passagers), les recommandations en santé et la gestion de l’énergie.
Là où ça se gâte
Un agent qui agit peut se tromper en grand. Un agent d’achat peut dépenser de l’argent de façon inattendue ou divulguer une information sensible ; un agent de codage peut supprimer des fichiers importants ou pousser en production un dépôt plein de bogues. Deux principes y répondent : la transparence et le contrôle, pour que l’utilisateur puisse vérifier le résultat et la compréhension de la tâche.
Côté outils, le garde-fou est le moindre pouvoir : ne donner au modèle que les outils dont il a strictement besoin, journaliser chaque appel, et déclencher des alertes sur les motifs suspects comme les suppressions massives.
Quand l’agent écrit son propre code à la volée, trois soucis s’ajoutent : la qualité et la sécurité du code produit, la porte ouverte à un code nuisible, et la répétabilité. Qu’un appel réussisse ne garantit pas que le suivant réussira, et de petits changements d’invite mènent à des chemins de code différents, ce qui complique débogage, tests et conformité.
Enfin, un LLM placé dans une boucle d’apprentissage hérite de ses faiblesses : biais, hallucinations, mauvaise lecture de données complexes ou bruitées. Il s’adapte mal à un environnement absent de son pré-entraînement, et il ajoute coût de calcul et latence.
⚠️ Piège Les tâches très spécialisées n’ont souvent pas été vues pendant le pré-entraînement : sur ton domaine pointu, ne suppose pas que le modèle s’en sortira.
Repérer ton problème : étroit, mesurable, testé
Pour ne pas t’y perdre, rapproche ta situation de cette carte :
| Ton problème ressemble à… | Famille | Première vérification |
|---|---|---|
| Retrouver la bonne réponse dans tes documents | Embeddings et génération augmentée | Comparer les modèles d’embeddings, dont un modèle spécialisé de ton domaine |
| Comprendre ou légender des photos | ViT, CLIP, modèle vision-langage | CLIP retrouve et classe, mais ne rédige pas |
| Produire des images ou des voix | Modèles texte-image, synthèse vocale | Fidélité à la demande, mains, texte lisible |
| Discuter, écrire, coder avec l’utilisateur | Assistants et copilotes | L’utilisateur sait-il ce que l’outil sait faire ? |
| Exécuter des actions | Agents avec outils | Moindre pouvoir, appels journalisés |
| Piloter un robot ou un véhicule | LLM combiné à l’apprentissage par renforcement | Biais, coût, latence |
Dans tous les cas, la méthode est la même : démarrer sur une tranche étroite et mesurable, comme l’annulation de commande, plutôt que sur un périmètre vague ou démesuré. Un prototype devient fiable par une conception itérative, une évaluation rigoureuse et des tests en conditions réelles.
Même les équipes expertes se trompent en croyant progresser. D’où l’évaluation automatisée hors ligne : un jeu de cas qui grandit à chaque outil ajouté, et qui définit l’état d’entrée et le résultat attendu. Voici le cas de la tasse fêlée, où la commande compte deux articles et où seule la tasse doit être remboursée :
{
  "order": {
    "order_id": "A89268",
    ...
  },
  "conversation": [
    {"role": "customer", "content": '''Hi, my coffee mug arrived cracked. Can I
        get a replacement or refund?'''},
    {"role": "assistant", "content": '''I'm very sorry about that! Could you
        please send us a quick photo of the damage so we can process a full
        refund?'''},
    {"role": "customer", "content": "Sure, here's the photo."}
  ],
  "expected": {
    "final_state": {
      "tool_calls": [
        {"tool": "issue_refund", "params": {"order_id": "A12345",
         "amount": 19.99}}
      ],
      "customer_msg_contains": ["been processed", "business days"]
    }
  }
}
Le bloc order (élidé ici) décrit la commande ; conversation rejoue l’échange ; expected fixe ce qu’on doit observer : un appel à l’outil de remboursement pour 19,99, et un message final qui mentionne le traitement du remboursement et des jours ouvrés. Si l’agent remboursait la commande entière ou oubliait cette formulation, des métriques comme le rappel d’outils et l’exactitude des paramètres le signaleraient aussitôt.
Ces cas s’écrivent à la main, s’extraient des journaux de production ou se génèrent avec un modèle, puis des humains les relisent. Des référentiels publics comme MMLU, BBH ou HELM situent le modèle dans le paysage, mais un référentiel sur mesure reste indispensable pour un agent spécialisé.
📌 À retenir Ton problème est un bon candidat quand il s’exprime en jetons et que tu sais décrire à quoi ressemble une bonne réponse, avec assez de cas pour le vérifier.
Ta première étape est donc modeste : écris quelques cas comme celui de la tasse, avant de choisir quoi que ce soit d’autre.