Tu as branché ton produit d’IA sur une API facturée au token : une clé, quelques lignes de code, et ça tourne. Puis un jour, la facture grimpe avec l’usage, des utilisateurs trouvent les réponses lentes, ou la panne d’un fournisseur devient soudain ton problème.
Faut-il alors héberger toi-même un modèle derrière un moteur d’inférence, c’est-à-dire le logiciel de production qui fait tourner un modèle ouvert sur tes GPU (vLLM, SGLang ou TensorRT-LLM) ? Voici les signaux qui disent « maintenant », ceux qui disent « pas encore », et un calcul chiffré pour trancher.
Sommaire
- L’essentiel en 30 secondes
- L’API au token : un excellent point de départ
- Cinq réponses à avoir avant de décider
- Les signaux qui disent « il est temps »
- Faire le calcul : API contre GPU dédiés
- Latence ou débit : ce que ton usage réclame
- Ce que tu prends en charge en hébergeant
- Les signes qu’il est trop tôt
- Sans serveur dédié : hébergement géré et appareil local
- Quand le type de modèle change la réponse
- Trancher : une grille de décision
L’essentiel en 30 secondes
- Tant que ton produit est jeune et que tes besoins restent flous, l’API au token gagne : pas d’exploitation, pas de démarrage à froid, une clé suffit.
- Trois raisons justifient un déploiement dédié : le volume, la spécialisation du modèle et l’orchestration de plusieurs modèles.
- Les modèles ouverts peuvent alors t’apporter trois gains : une latence réglable pour le temps réel, quatre « neuf » de disponibilité au lieu de deux, un coût souvent inférieur d’au moins 80 % à grande échelle.
- Compare en dollars, sur une semaine ou plus, en ajoutant le temps d’ingénierie : dans l’exemple chiffré, 6 250 $ d’API contre 5 600 $ de GPU, avant ce coût humain.
- Un trafic léger et imprévisible sur une application sensible à la latence est le signe que tu n’y es pas encore.
L’API au token : un excellent point de départ
Il existe deux manières d’ajouter un modèle d’IA à un produit. Avec l’inférence partagée, tu envoies ton trafic vers un point d’accès public et tu paies au million de tokens. Avec un déploiement dédié, tu loues des GPU (ou tu les achètes et les installes chez toi) pour monter un service réservé à ton application, payé à l’heure de GPU.
Ne confonds pas cette distinction avec celle entre modèles ouverts et fermés. Beaucoup de points d’accès partagés servent des modèles ouverts, et certains laboratoires proposent à leurs grands clients des offres dédiées pour leurs modèles fermés. L’intérêt des modèles ouverts, c’est qu’ils débloquent le dédié sans restriction.
Au début, l’API est le bon choix : aucune charge d’exploitation, aucun démarrage à froid, très peu d’ingénierie. Le revers tient en trois points. Le coût croît linéairement avec l’usage. La disponibilité de ton produit est plafonnée par celle du fournisseur, avec des « voisins bruyants ». Et tu n’as aucun contrôle sur la latence, sur la qualité du modèle ni sur les limites de débit.
Ces limites sont concrètes : une API impose un nombre maximal de requêtes par minute, et ton code doit savoir gérer ces refus temporaires avec une stratégie de nouvelle tentative.
Cinq réponses à avoir avant de décider
Pour trancher, tu dois pouvoir répondre à cinq questions :
- Quels modèles veux-tu exécuter ?
- Quelle est l’interface de ton application : comment arrivent les entrées, comment la sortie doit-elle être formatée ?
- Quel est ton budget de latence de bout en bout ?
- Quelle est ton économie unitaire, c’est-à-dire ce qu’il est raisonnable de dépenser par requête, par utilisateur ou par mois ?
- Quels sont tes schémas d’usage : combien d’utilisateurs simultanés, et à quelles heures ?
Au début d’un produit, ces réponses sont floues, et il vaut mieux utiliser des API prêtes à l’emploi. À mesure que le produit grandit et que les besoins se précisent, l’ingénierie de l’inférence devient rentable.
Ton usage dicte surtout la deuxième et la troisième réponse. Une traduction vocale en temps réel exige une latence de bout en bout compatible avec une conversation naturelle. La complétion de code doit livrer le morceau complet à la vitesse de frappe. Des recommandations de produits réclament une latence constante malgré un fort volume. La modération de contenu, elle, a besoin d’un débit élevé pour des contrôles économiques. Quatre usages, quatre contraintes différentes.
Les signaux qui disent « il est temps »
Passer à un déploiement dédié se justifie, avec le temps, pour trois raisons : l’échelle, la spécialisation et l’orchestration.
Le volume
Quand ton trafic devient tel que payer au GPU coûte moins cher que payer au million de tokens, l’échelle plaide pour le dédié. Le calcul précis fait l’objet de la section suivante.
La spécialisation du modèle
La spécialisation recouvre un modèle personnalisé ou affiné, et des exigences de latence ou de disponibilité. Elle s’appuie sur un fait récent : les modèles ouverts ont rattrapé les fermés. Jusqu’en décembre 2024, un écart d’intelligence réel séparait les deux familles ; la sortie de DeepSeek V3 et R1 l’a fait disparaître. Un nouveau modèle fermé est aujourd’hui rattrapé par un modèle ouvert en quelques mois, parfois en quelques semaines.
Beaucoup d’équipes ont même affiné des modèles ouverts pour dépasser la qualité des modèles fermés sur leur domaine précis.
Passer à un modèle ouvert te permet alors de t’améliorer sur trois dimensions :
- Latence : les API fermées sont conçues pour le débit, alors qu’un modèle ouvert peut être optimisé pour le temps réel.
- Disponibilité : les API de GPT et de Claude restent bloquées à deux « neuf », tandis que des déploiements dédiés de modèles ouverts atteignent quatre « neuf » ou mieux.
- Coût : les modèles ouverts sont souvent au moins 80 % moins chers à grande échelle.
Le constat se retrouve ailleurs : à grande échelle, le coût selon le volume de requêtes fait souvent pencher vers l’open source, malgré un coût d’infrastructure initial.
L’orchestration de plusieurs modèles
Certains produits enchaînent plusieurs modèles et plusieurs étapes pour répondre à une seule requête. Chaque modèle du pipeline doit alors tourner dans le même cluster. Si envoyer un message dans un cluster prend 10 millisecondes et 50 entre clusters, l’écart de 40 millisecondes, sur cinq étapes, mange 20 % d’un engagement de service d’une seconde.
Grand public ou entreprise : ce qui prime
Le type de produit déplace les priorités. Les applications grand public sont très sensibles au coût et leur usage est imprévisible : beaucoup sont conçues pour devenir virales, et un lancement ou une campagne peut multiplier l’usage en une nuit. Leurs ingénieurs privilégient donc le coût marginal et la souplesse.
Les produits pour entreprises ont un usage plus stable, mais un logiciel critique dans le chemin du revenu exige une haute disponibilité et une latence toujours basse. La latence et la disponibilité passent alors avant le coût et l’échelle.
La conformité et la confidentialité
Dans les deux cas, la conformité peut limiter tes options d’infrastructure, surtout dans les secteurs réglementés. Trois questions se posent : tes GPU sont-ils dans une région où tu as le droit d’envoyer les données de tes utilisateurs ? Les entrées et les sorties du modèle restent-elles privées et sécurisées ? Et est-ce que tes fournisseurs et toi respectez les règles applicables ?
Une décision très simple améliore la sécurité : ne pas stocker les entrées des utilisateurs ni les sorties du modèle, quand rien n’oblige à les conserver.
Faire le calcul : API contre GPU dédiés
Sur une API publique, le coût est simple : un prix au million de tokens multiplié par le nombre de tokens utilisés. Quelques variables s’y ajoutent, comme les succès de cache sur les tokens d’entrée ou les remises pour gros utilisateurs, mais le coût reste une fonction linéaire de l’usage.
Avec un déploiement dédié, il dépend de nombreuses variables : la taille de lot (déploiement optimisé pour la latence avec de petits lots, ou pour le débit avec de grands lots), les motifs de trafic (le trafic sature-t-il régulièrement les GPU actifs, ou une capacité reste-t-elle inutilisée ?) et les longueurs de séquence. Cela donne du contrôle, mais complique l’estimation.
Plutôt que de retrouver un prix au token à partir de ce que tu paies pour tes GPU, il est généralement plus productif de convertir ton prix au token en coût total, puis de le comparer à celui du dédié.
Voici le calcul côté API, pour un trafic de 1 000 millions de tokens d’entrée et de 500 millions de tokens de sortie :
# Equation for estimating total cost from per-token APIs
total_input_tokens = 1000  # In millions
total_output_tokens = 500  # In millions
price_per_million_in = 1.25
price_per_million_out = 10
input_cost = (total_input_tokens * price_per_million_in)
output_cost = (total_output_tokens * price_per_million_out)
total_cost = input_cost + output_cost
# Total cost: $6250.00
Les tokens d’entrée coûtent 1 250 $ et ceux de sortie 5 000 $ : 6 250 $ au total. Pour le même trafic, voici le calcul côté GPU dédiés :
# Equation for estimating total cost from dedicated deployments
total_gpu_hours = 1600
price_per_gpu_hour = 3.50
total_cost = total_gpu_hours * price_per_gpu_hour
# Total cost: $5600.00
Pour 1 600 heures de GPU à 3,50 $ l’heure, le coût est de 5 600 $, un peu moins que le coût au token pour ce trafic.
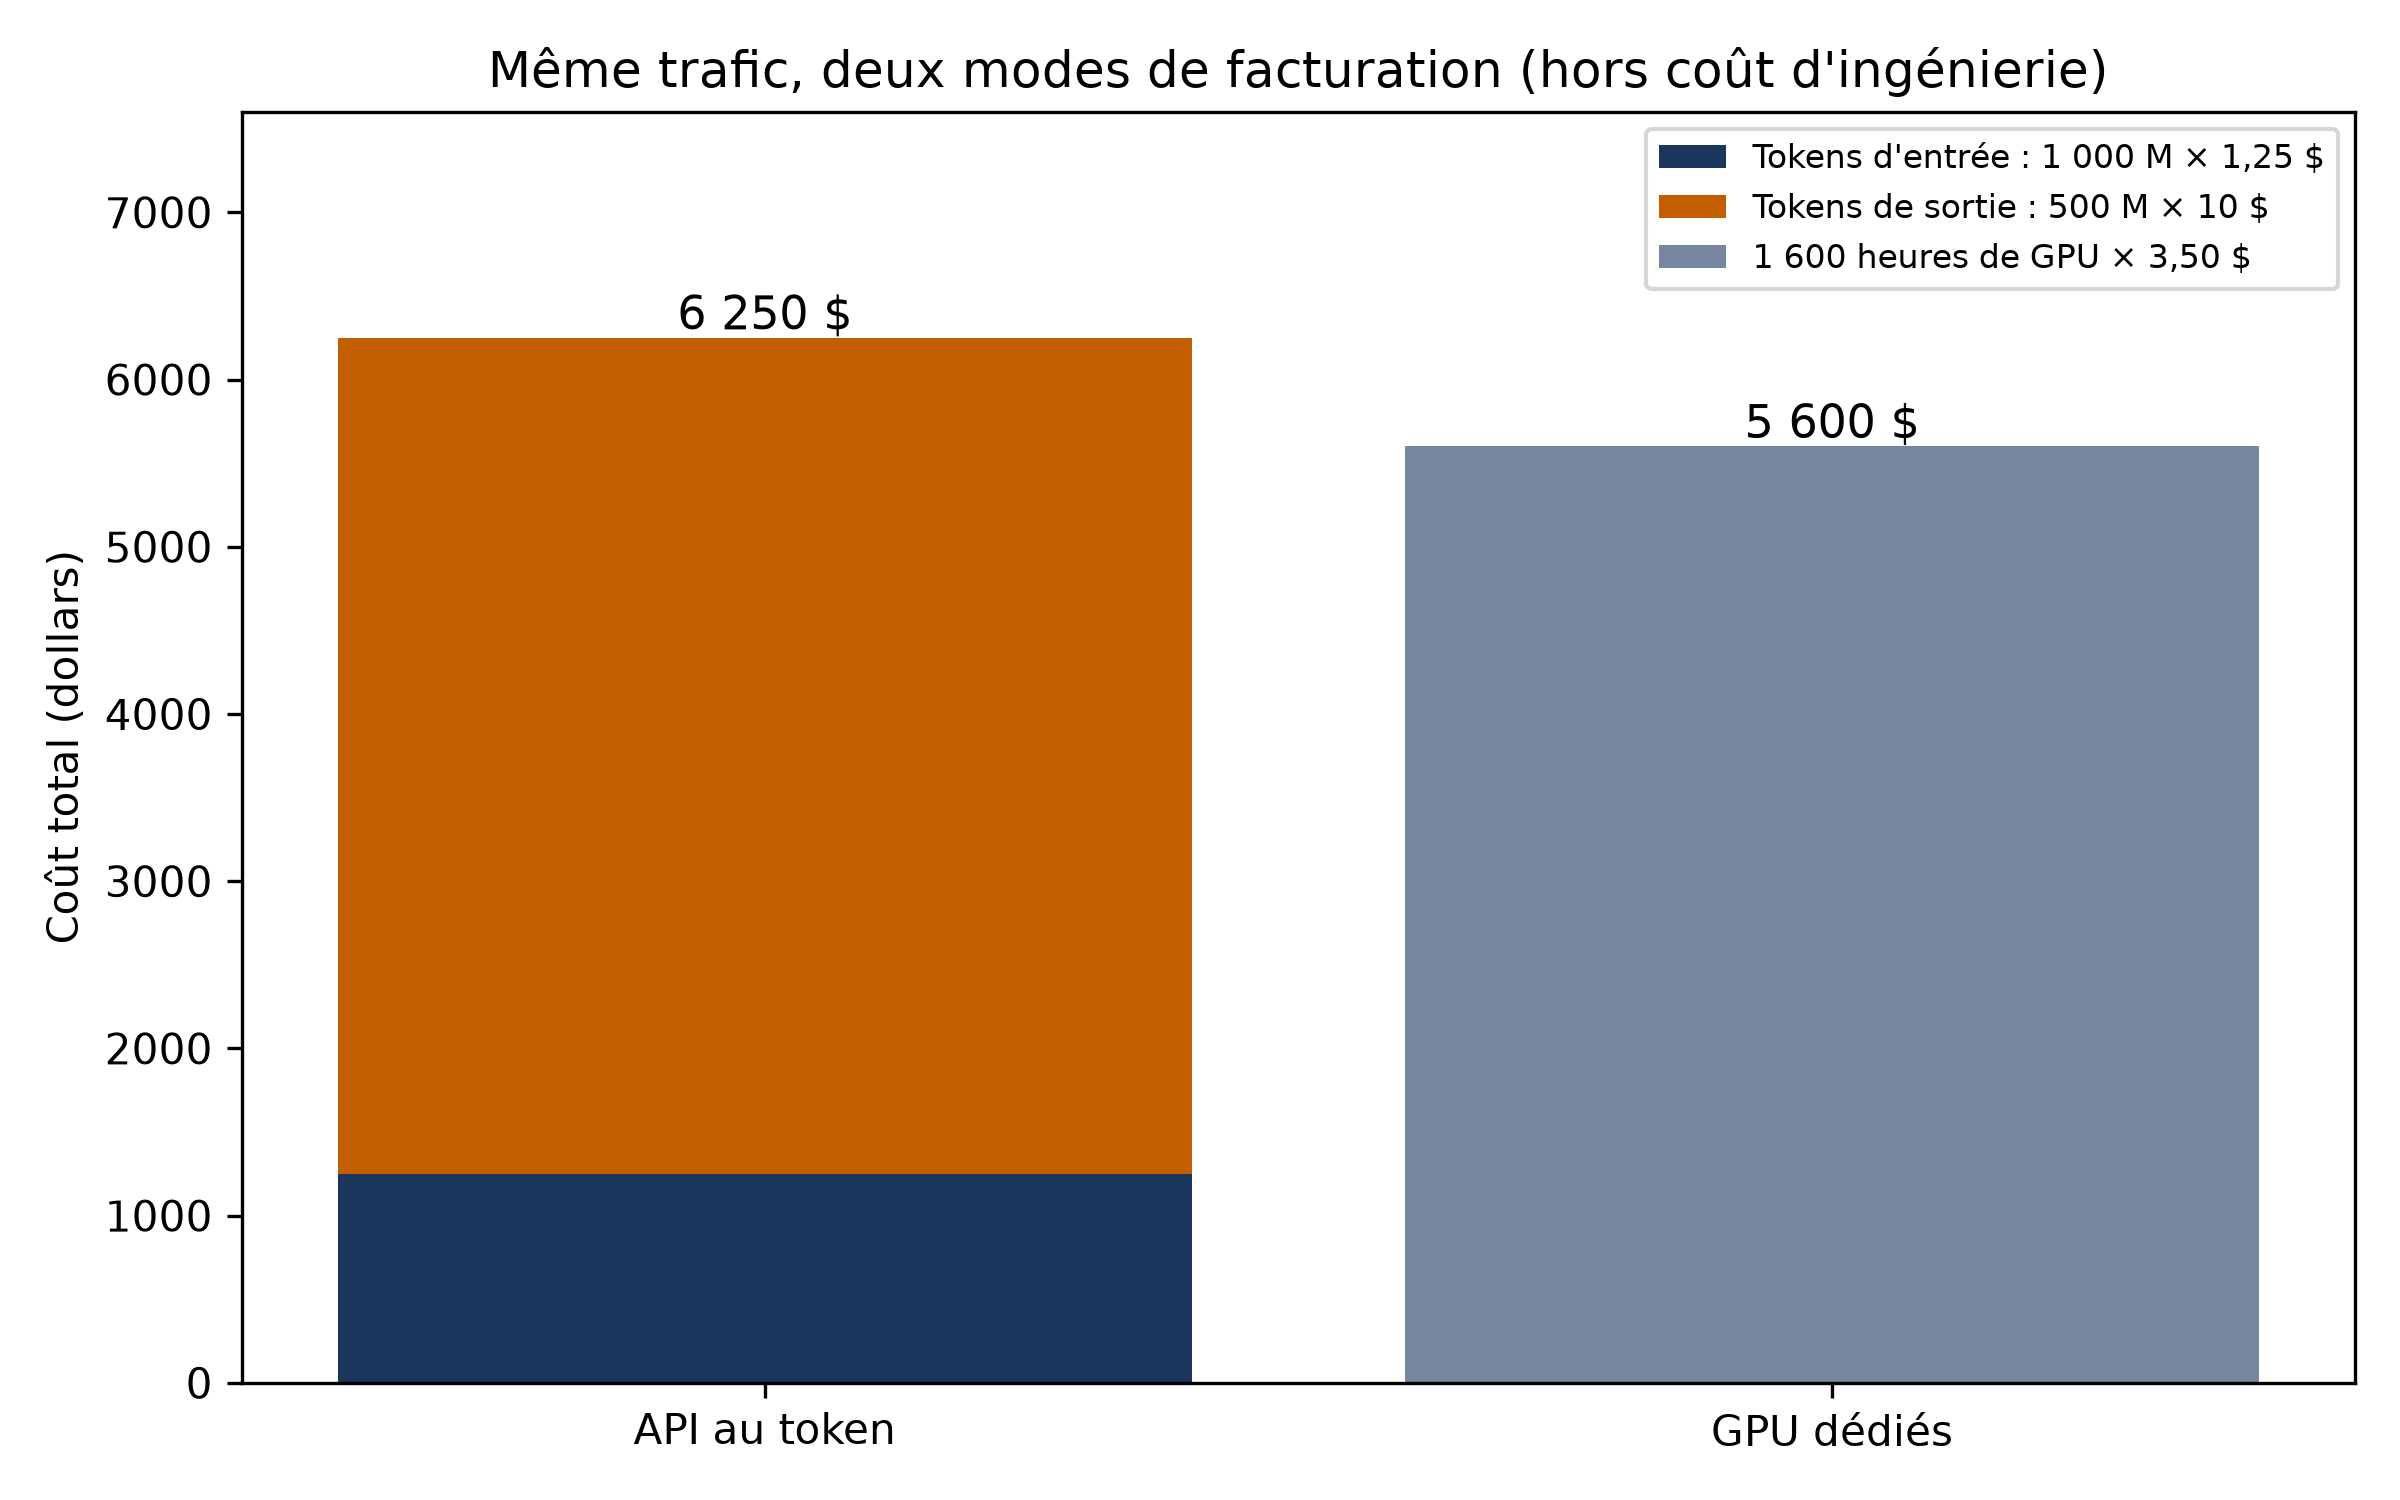
💡 Intuition L’écart est de 650 $ sur 6 250 $, soit environ 10 %. Il suffit que le temps d’ingénierie dépasse cette somme pour que l’avantage s’inverse : le chiffre des GPU seul ne dit pas encore quelle option coûte le moins.
Deux garde-fous complètent le calcul. Estime sur un horizon long, idéalement au moins une semaine, pour lisser les variations d’usage. Et ajoute le coût du temps d’ingénierie passé à construire et à maintenir les systèmes d’inférence : justifié par une fiabilité, une sécurité et un contrôle accrus, il s’ajoute aux coûts de GPU pour former le coût total de possession, le TCO.
Latence ou débit : ce que ton usage réclame
Une latence plus basse rend l’application plus rapide ; un débit plus élevé la rend moins chère à grande échelle, puisqu’il faut moins de GPU pour le même nombre d’utilisateurs. C’est l’un des principaux compromis de l’ingénierie de l’inférence.
Si ton usage est en ligne et en temps réel (complétion de code, chat, agents vocaux), un utilisateur impatient attend à chaque appel : optimise la latence. Si c’est un traitement par lots hors ligne, comme transcrire un catalogue de podcasts ou d’entretiens pour le rendre cherchable, préparer d’immenses corpus d’entraînement ou analyser régulièrement un ensemble de documents, chaque requête serait trop lente pour une bonne expérience, mais le système en traite bien plus par heure.
Un même modèle peut servir les deux usages. Whisper, un modèle de reconnaissance vocale, peut alimenter une application de dictée en temps réel comme une transcription par lots. Si chaque usage a assez de volume, il est plus rentable de créer deux déploiements distincts du même modèle, l’un optimisé pour la latence, l’autre pour le débit.
Les usages mixtes existent aussi : une recherche dans des documents juridiques distingue le remplissage hors ligne d’un corpus et les requêtes en ligne des utilisateurs.
Pour les charges peu sensibles à la latence, comme le traitement de documents en masse, passe à des requêtes asynchrones, de type « on lance et on oublie ». Une requête synchrone expire généralement après quelques minutes. Une tâche asynchrone accuse réception tout de suite et renvoie le résultat plus tard vers un point d’accès (webhook) que tu fournis ; ses limites de temps se comptent en heures. Avec une solide file d’attente côté serveur, ces systèmes sont plus robustes et plus efficaces.
Ce que tu prends en charge en hébergeant
Passer au dédié te rend responsable de ta propre ingénierie de l’inférence. Tu gagnes en flexibilité et en contrôle, mais tu hérites de plus de surface d’ingénierie et d’un plancher de dépenses mensuelles plus élevé. C’est pourquoi il ne faut le faire qu’en présence d’un besoin d’affaires clair et immédiat.
Première question concrète : où vivent tes GPU ? Il y a trois modes. Dans le cloud, tu loues des GPU dans le centre de données de quelqu’un d’autre : des hyperscalers comme AWS et GCP, ou des neoclouds comme Coreweave et Nebius. Sur site, tu achètes les GPU et tu les installes dans un centre de données que tu contrôles. En réseau isolé, les GPU sont sur site et il faut y accéder physiquement pour lancer l’inférence.
La plupart des ingénieurs utilisent des GPU dans le cloud : les grandes entreprises et les États exploitent des déploiements sur site et isolés, mais le cloud offre la flexibilité et l’accès dont les produits d’IA en forte croissance ont besoin pour passer à l’échelle.
Ensuite viennent les pannes. Les GPU sont réputés pour leur taux de défaillance élevé en production. Pendant que l’équipe de Llama 3 faisait tourner 16 000 GPU pendant 54 jours, elle a subi 419 interruptions imprévues, surtout dues au matériel : environ une panne pour 50 000 heures de GPU. Un seul nœud de huit GPU qui sert de l’inférence pendant une année entière représente plus de 70 000 heures : il faut s’attendre à des pannes.
Enfin, la mise à l’échelle soulève de nouvelles questions : où et comment obtenir des GPU, comment équilibrer le trafic entre eux, comment prévenir les pannes. La latence en production ne vient pas que du modèle : il faut évaluer le système de bout en bout, serveur, réseau et même client.
⚠️ Piège Passer du paiement au token au paiement de l’infrastructure brouille la comptabilité des coûts. Avant de comparer deux factures, assure-toi qu’elles contiennent les mêmes choses : des GPU d’un côté, des GPU et du temps d’ingénierie de l’autre.
Les signes qu’il est trop tôt
Quatre situations disent « pas encore » :
- Tes besoins ne sont pas fixés. Si tu ne sais pas répondre aux cinq questions plus haut, utilise des API prêtes à l’emploi.
- Ton trafic est léger et imprévisible, et ton application sensible à la latence. Les systèmes avancés savent redescendre à zéro réplica actif en l’absence de trafic, puis remonter dès qu’une requête arrive, mais cela suppose des démarrages à froid rapides et une file d’attente robuste. Si tu comptes sur cette réduction à zéro pour contenir le coût dans ce cas précis, ton application n’est probablement pas prête pour une infrastructure dédiée : reste sur des API au token jusqu’à une plus grande échelle.
- Tes GPU resteraient souvent inactifs. Sans mise à l’échelle automatique, les systèmes d’inférence gaspillent des ressources pendant les creux de trafic et manquent leurs engagements pendant les pics.
- Tu vises un modèle phare géant. DeepSeek-v3 et Llama 3.1 405B exigent au moins une douzaine de GPU pour de bonnes performances et tournent presque toujours dans de grands centres de données ; leurs éditeurs facturent l’accès au jeton, ce qui dispense de gérer des serveurs.
À l’inverse, la réduction à zéro convient bien aux applications qui ne reçoivent du trafic que périodiquement, comme un agent accessible seulement aux heures ouvrables dans un pays, ou un système hors ligne pensé pour des traitements quotidiens par lots.
Sans serveur dédié : hébergement géré et appareil local
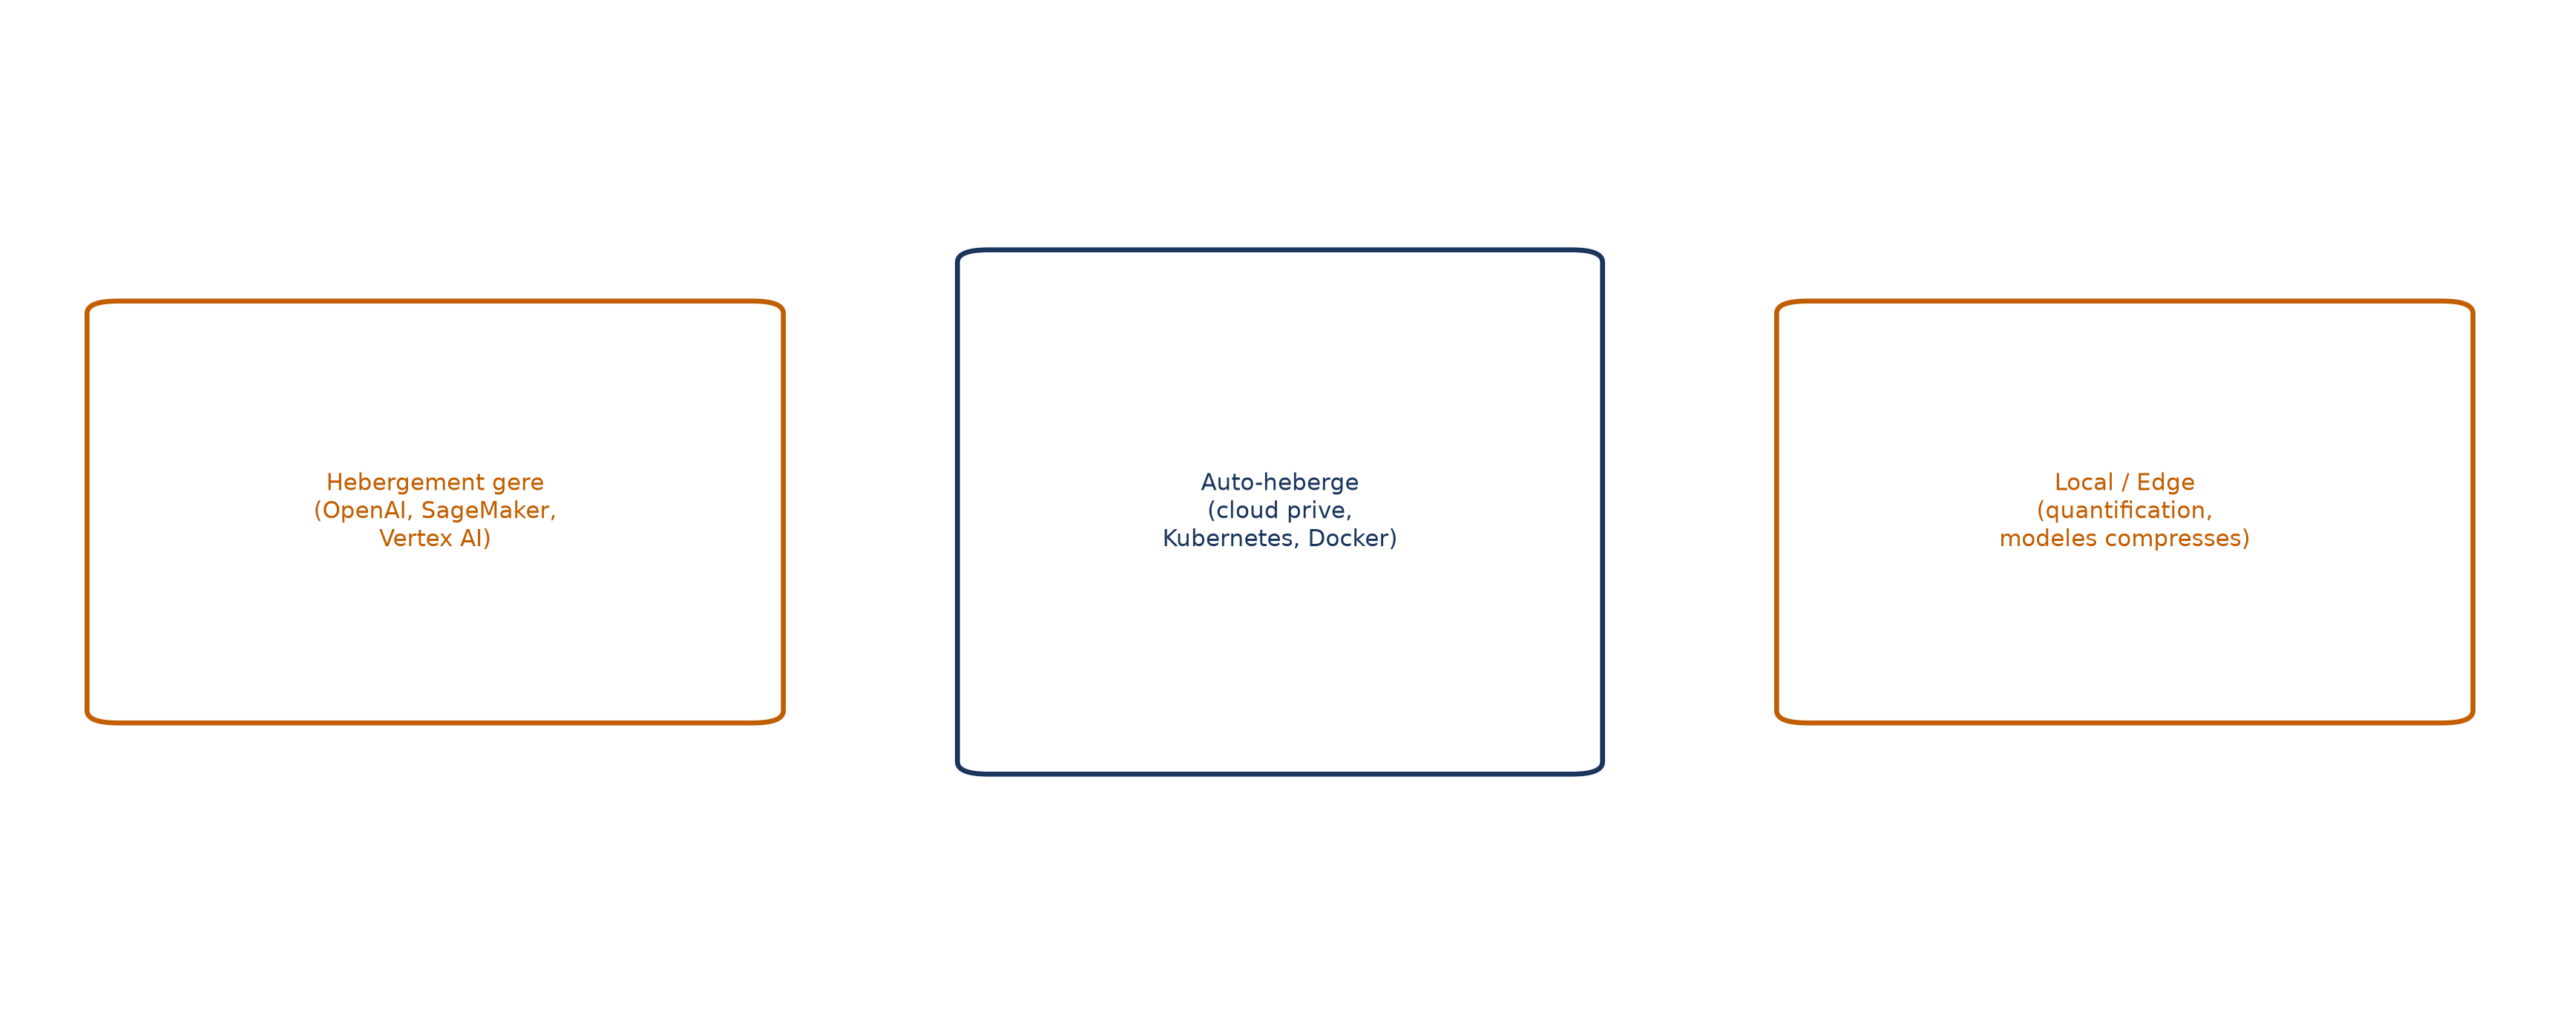
Entre l’API partagée et le serveur que tu opères toi-même, d’autres voies existent. Trois méthodes de déploiement se dessinent. L’hébergement entièrement géré confie toute l’infrastructure au fournisseur (OpenAI, Google, Anthropic, Cohere, ou des plateformes comme AWS SageMaker, Google Vertex AI et Amazon Bedrock). L’auto-hébergement te laisse gérer l’infrastructure avec Kubernetes et Docker, éventuellement optimisée par NVIDIA Triton Inference Server. Le déploiement local ou en périphérie exécute des versions optimisées (quantifiées, élaguées) du modèle directement sur l’appareil, avec confidentialité et faible latence.
L’inférence locale a quatre atouts : zéro latence réseau (on économise des dizaines, voire des centaines de millisecondes), l’indépendance vis-à-vis de la connexion et des pannes du serveur, une meilleure confidentialité, et un coût nul pour toi, puisque les GPU de centre de données sont chers alors que l’inférence en périphérie est gratuite pour le développeur.
Mais quatre faiblesses expliquent pourquoi la plupart de l’inférence se fait dans le cloud : les capacités matérielles, les contraintes thermiques, un support fragmenté et l’autonomie des batteries. Garde aussi ton public en tête : l’utilisateur médian a plutôt des appareils plus anciens et moins performants que ceux d’un passionné d’IA.
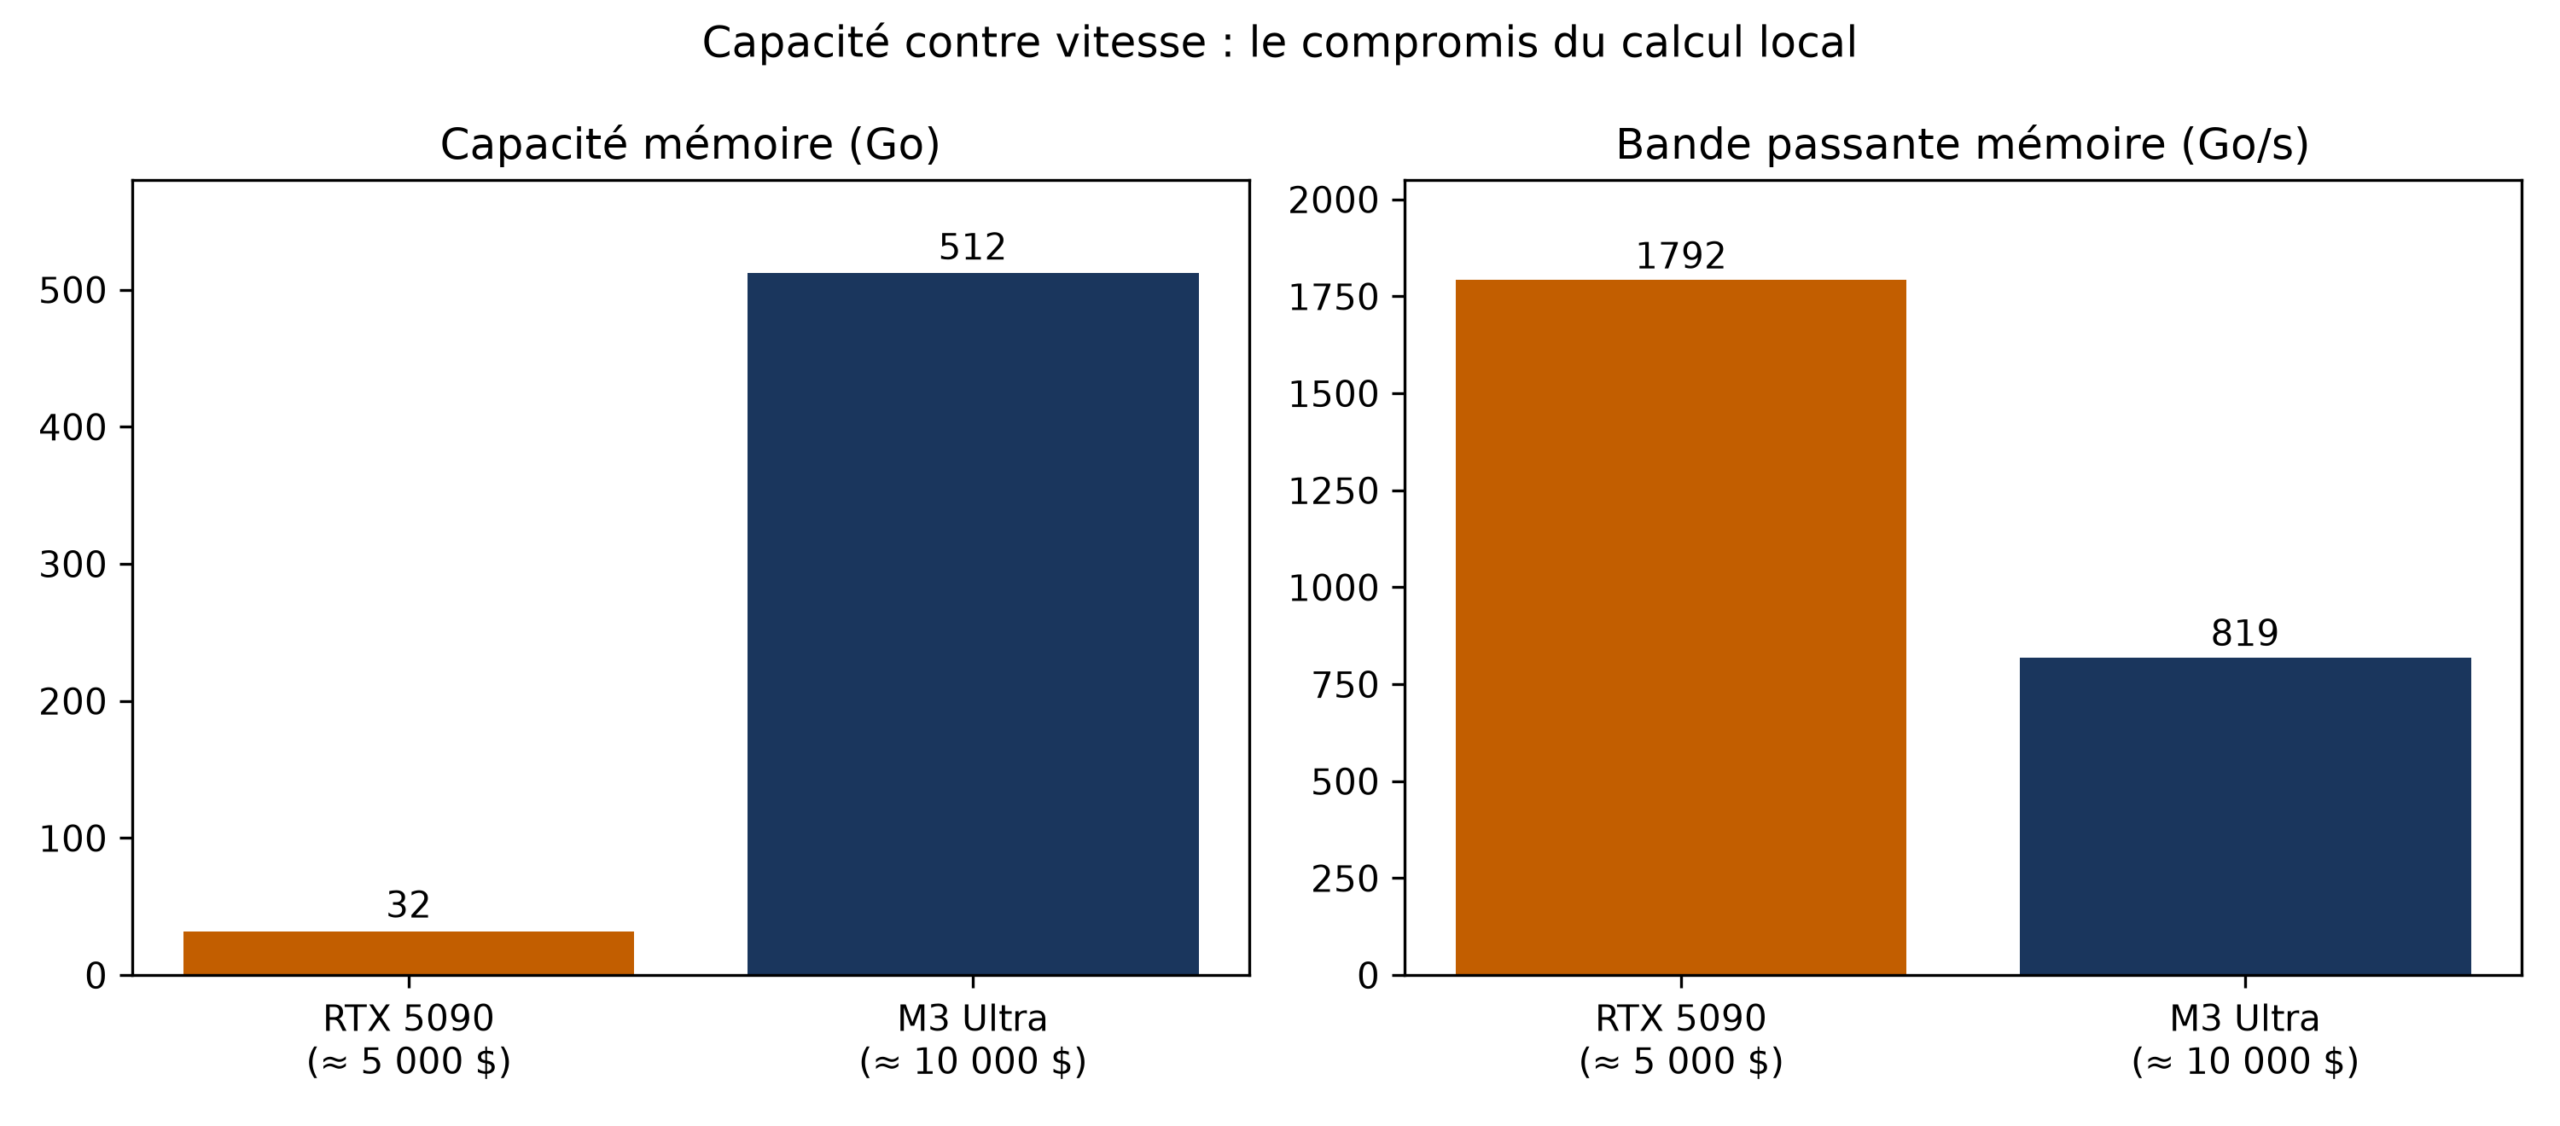
Sur ordinateur, la mémoire fixe vite le plafond. Un modèle d’environ 14 milliards de paramètres tient sur un seul GPU grand public comme la RTX 3090 (24 Go) ; au-delà, un GPU de serveur devient nécessaire. Avec Ollama et llama.cpp, on exécute même des modèles de plus de 100 milliards de paramètres, fortement quantifiés, sur du matériel personnel haut de gamme.
Sur mobile, même les téléphones haut de gamme peinent à exécuter des modèles de plus d’un ou deux milliards de paramètres. La transcription et la synthèse vocale, sensibles à la latence, s’y prêtent pourtant, et la traduction peut être confiée à de petits modèles affinés.
📌 À retenir L’avenir n’est pas « local ou cloud » mais les deux : les petits modèles et les requêtes rapides sur les appareils, les charges exigeantes sur les GPU de centre de données.
Quand le type de modèle change la réponse
La décision ne se pose pas de la même façon pour tous les modèles.
- Tu prototypes avec
transformersoudiffusers? Ces bibliothèques de Hugging Face sont des implémentations de référence pour apprendre et adapter, pas pour l’inférence de production à grande échelle. En production, il faut écrire et compiler directement du code PyTorch, ou utiliser un moteur d’inférence prêt pour la production. - Un modèle d’embedding ? Plusieurs exécutions existent (vLLM, SGLang, Infinity, TEI de Hugging Face), et TensorRT-LLM est le plus performant en latence comme en débit pour les modèles pris en charge. Comme ces modèles sont petits, le parallélisme multi-GPU est inefficace : les déploiements à fort trafic passent plutôt à l’échelle horizontalement, un GPU par réplica. Une requête peut regrouper des dizaines ou des centaines d’entrées, et une file d’attente robuste devient essentielle pour un gros remplissage ou un pic d’usage.
- Un modèle vision-langage ? Son encodeur de vision est petit mais critique, et le support des exécutions est fragmenté, ce qui accroît l’importance de vLLM et de SGLang. Règle empirique : une image haute résolution ajoute environ mille tokens visuels à la séquence d’entrée. En production, il faut souvent coordonner un pipeline de plusieurs modèles et étapes de prétraitement (extraction de PDF, reconnaissance de texte, transcription audio), chacun à optimiser et à faire évoluer indépendamment.
- Des images ou de la vidéo ? La plupart de ces modèles sont des débruiteurs itératifs et non des générateurs de tokens, avec un outillage différent : SGLang Diffusion et vLLM Omni étaient tout nouveaux à la publication, et la plupart des inférences sont implémentées plus bas dans la pile, directement avec PyTorch ou TensorRT. Les modèles d’images sont de dix à vingt fois plus petits que les modèles de langage de pointe, et leur inférence est contrainte par le calcul.
Trancher : une grille de décision
| Ta situation | Reste sur l’API au token | Passe au dédié |
|---|---|---|
| Produit jeune, besoins flous | Une clé suffit, sans exploitation | Trop tôt |
| Facture qui grimpe avec l’usage | Le coût croît linéairement | À comparer en coût total, ingénierie comprise |
| Disponibilité critique | Plafonnée par le fournisseur (deux « neuf » pour GPT et Claude) | Quatre « neuf » ou mieux avec un modèle ouvert |
| Trafic léger et imprévisible, latence sensible | Recommandé | Pas encore prêt |
| Plusieurs modèles enchaînés | Latence réseau entre les services | Tous les modèles dans le même cluster |
| Données à garder dans une région donnée | Options limitées par la conformité | Dédié, ou inférence locale |
Si ta réponse est « dédié », il reste à choisir le moteur et à le régler : ce sujet est traité dans « Optimiser un moteur d’inférence : les 6 techniques qui comptent ».