Quand tu appuies sur Ctrl+F dans ton navigateur, tu fais déjà de la recherche d’information : la page est la collection de documents, le mot que tu tapes est la requête, et le navigateur surligne ce qui correspond exactement. Un retriever fait le même métier, avec deux différences de taille : il ne fouille pas une page mais toute une base, et il doit retrouver ce que tu veux dire, pas seulement les lettres que tu tapes.
À la fin de cet article, tu sauras le définir en une phrase, distinguer ses grandes familles, lire quelques lignes de code qui en construisent un, et deviner ce qu’il ne faut surtout pas lui demander.
Sommaire
- L’essentiel en 30 secondes
- Une fonction : une requête en entrée, un classement en sortie
- Du Ctrl+F au sens : les familles de retrievers
- Sous le capot : un encodeur ou deux ?
- Voir un retriever dense tourner
- Quand la question ne ressemble pas aux documents
- Un retriever ne travaille pas seul
- Ce qu’un retriever ne fait pas
L’essentiel en 30 secondes
- Un retriever est une fonction de recherche : il reçoit une requête et renvoie une liste de documents classés par pertinence.
- On peut le fabriquer avec des mots exacts (TF-IDF, BM25), avec des vecteurs de sens (embeddings), ou avec un mélange des deux : le cadre du RAG n’impose aucune méthode.
- Les embeddings contextuels sont les plus utilisés en RAG, malgré un coût de calcul plus élevé que le comptage de mots.
- Il travaille rarement seul : reformulation de la requête, recherche hybride, reranking l’entourent avant et après.
- Sa notion de « proche » vient de ses données d’entraînement : proche ne veut pas dire pertinent, et un retriever généraliste peut se tromper de domaine.
Une fonction : une requête en entrée, un classement en sortie
En recherche d’information, récupérer consiste à retrouver les documents qui correspondent le mieux à une requête. Le retriever est le composant qui remplit ce rôle : une requête entre, une liste de documents classés par pertinence sort.
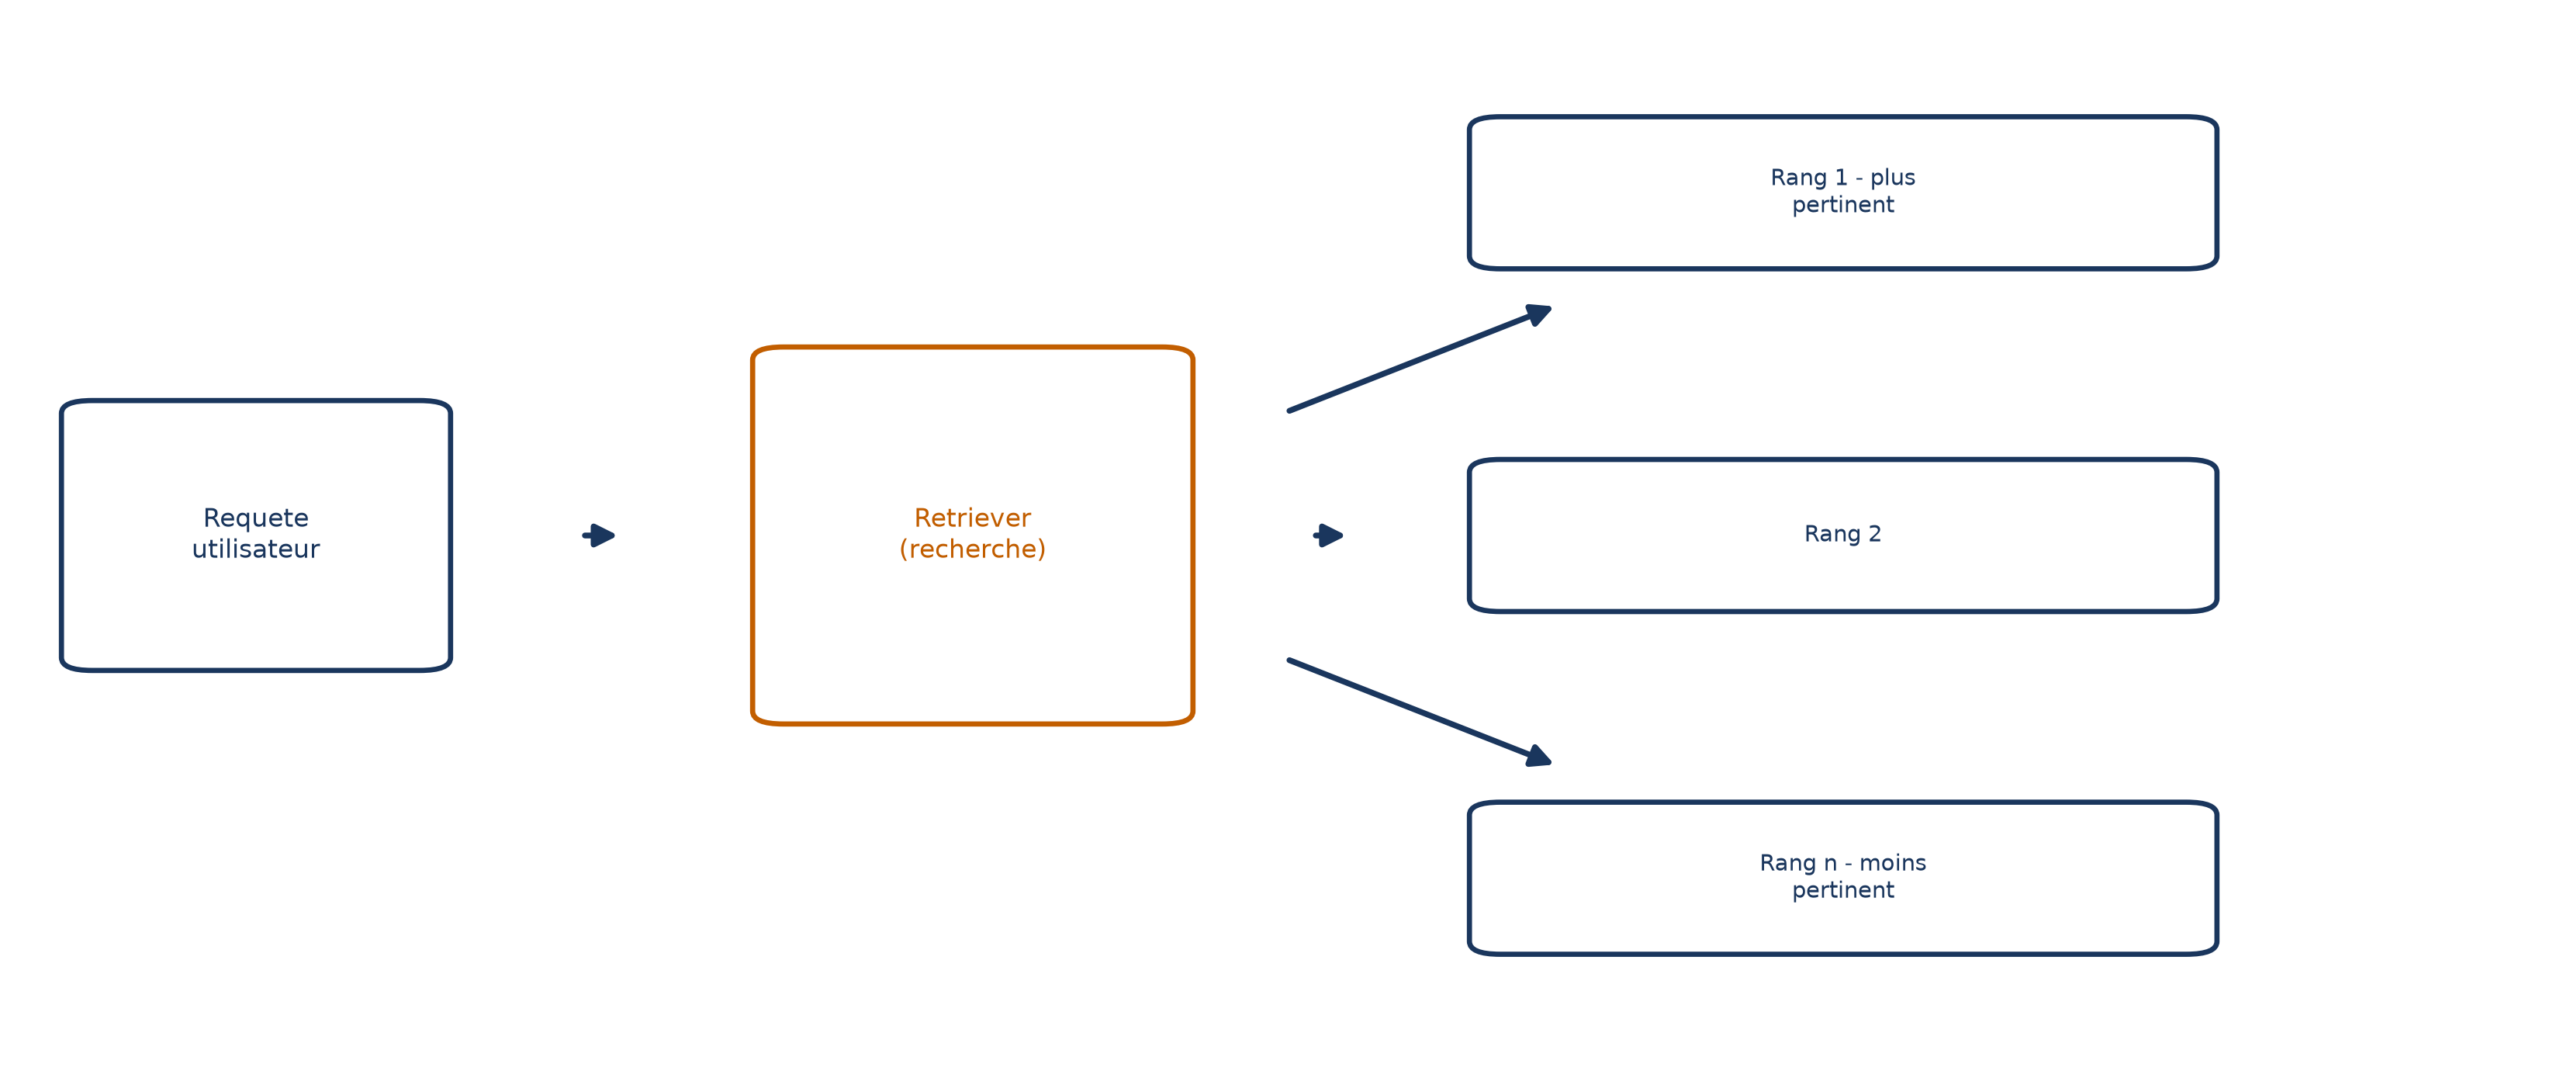
Ce que le retriever fouille dépend de la collection : des documents entiers, ou des passages à l’intérieur de documents, souvent accompagnés de métadonnées (taille, sujet, mots-clés…). Retrouver le passage qui permet de répondre est la tâche centrale des systèmes de questions-réponses. La collection est indexée une fois pour toutes ; chaque requête est convertie en vecteur, et ce vecteur sert à repérer les documents les plus pertinents, rendus dans l’ordre.
Une conséquence mérite d’être dite tout de suite : le mot « retriever » désigne un rôle, pas une technique. Une application de ce type se compose d’un retriever, qui trouve l’information, et d’un générateur, qui l’utilise pour produire la réponse. La façon dont le retriever trouve l’information n’est pas imposée ; la recherche par similarité vectorielle est la plus courante, sans être la seule.
💡 Intuition Imagine un bibliothécaire à qui tu tends une question et qui te rend une pile de fiches triée, la plus utile au-dessus. Toute la différence entre deux retrievers tient à sa manière de trier : au mot près, ou au sens près. C’est l’objet de la suite.
Du Ctrl+F au sens : les familles de retrievers
La recherche d’information a une longue histoire, et chaque étape a laissé une famille de retrievers toujours en service.
Compter les mots : booléen, TF-IDF, BM25
La plus simple est la recherche booléenne : un document correspond si les termes de la requête y figurent exactement, éventuellement combinés par AND, OR, NOT. C’est ton Ctrl+F. Le sac de mots (Bag of Words) va un cran plus loin : chaque document devient un vecteur qui indique la présence de chaque mot du vocabulaire, mais l’ordre et le sens des mots sont ignorés.
Reste un défaut : tous les mots ne se valent pas. Le TF-IDF pondère un terme selon sa fréquence dans le document et sa rareté dans le corpus. Le TF compte les occurrences du terme dans le document, rapportées au nombre total de termes ; l’IDF prend le logarithme du rapport entre le nombre de documents du corpus et le nombre de ceux qui contiennent le terme. Un mot qui revient partout (« le », « et ») pèse donc peu, un mot rare et fréquent dans un document pèse lourd.
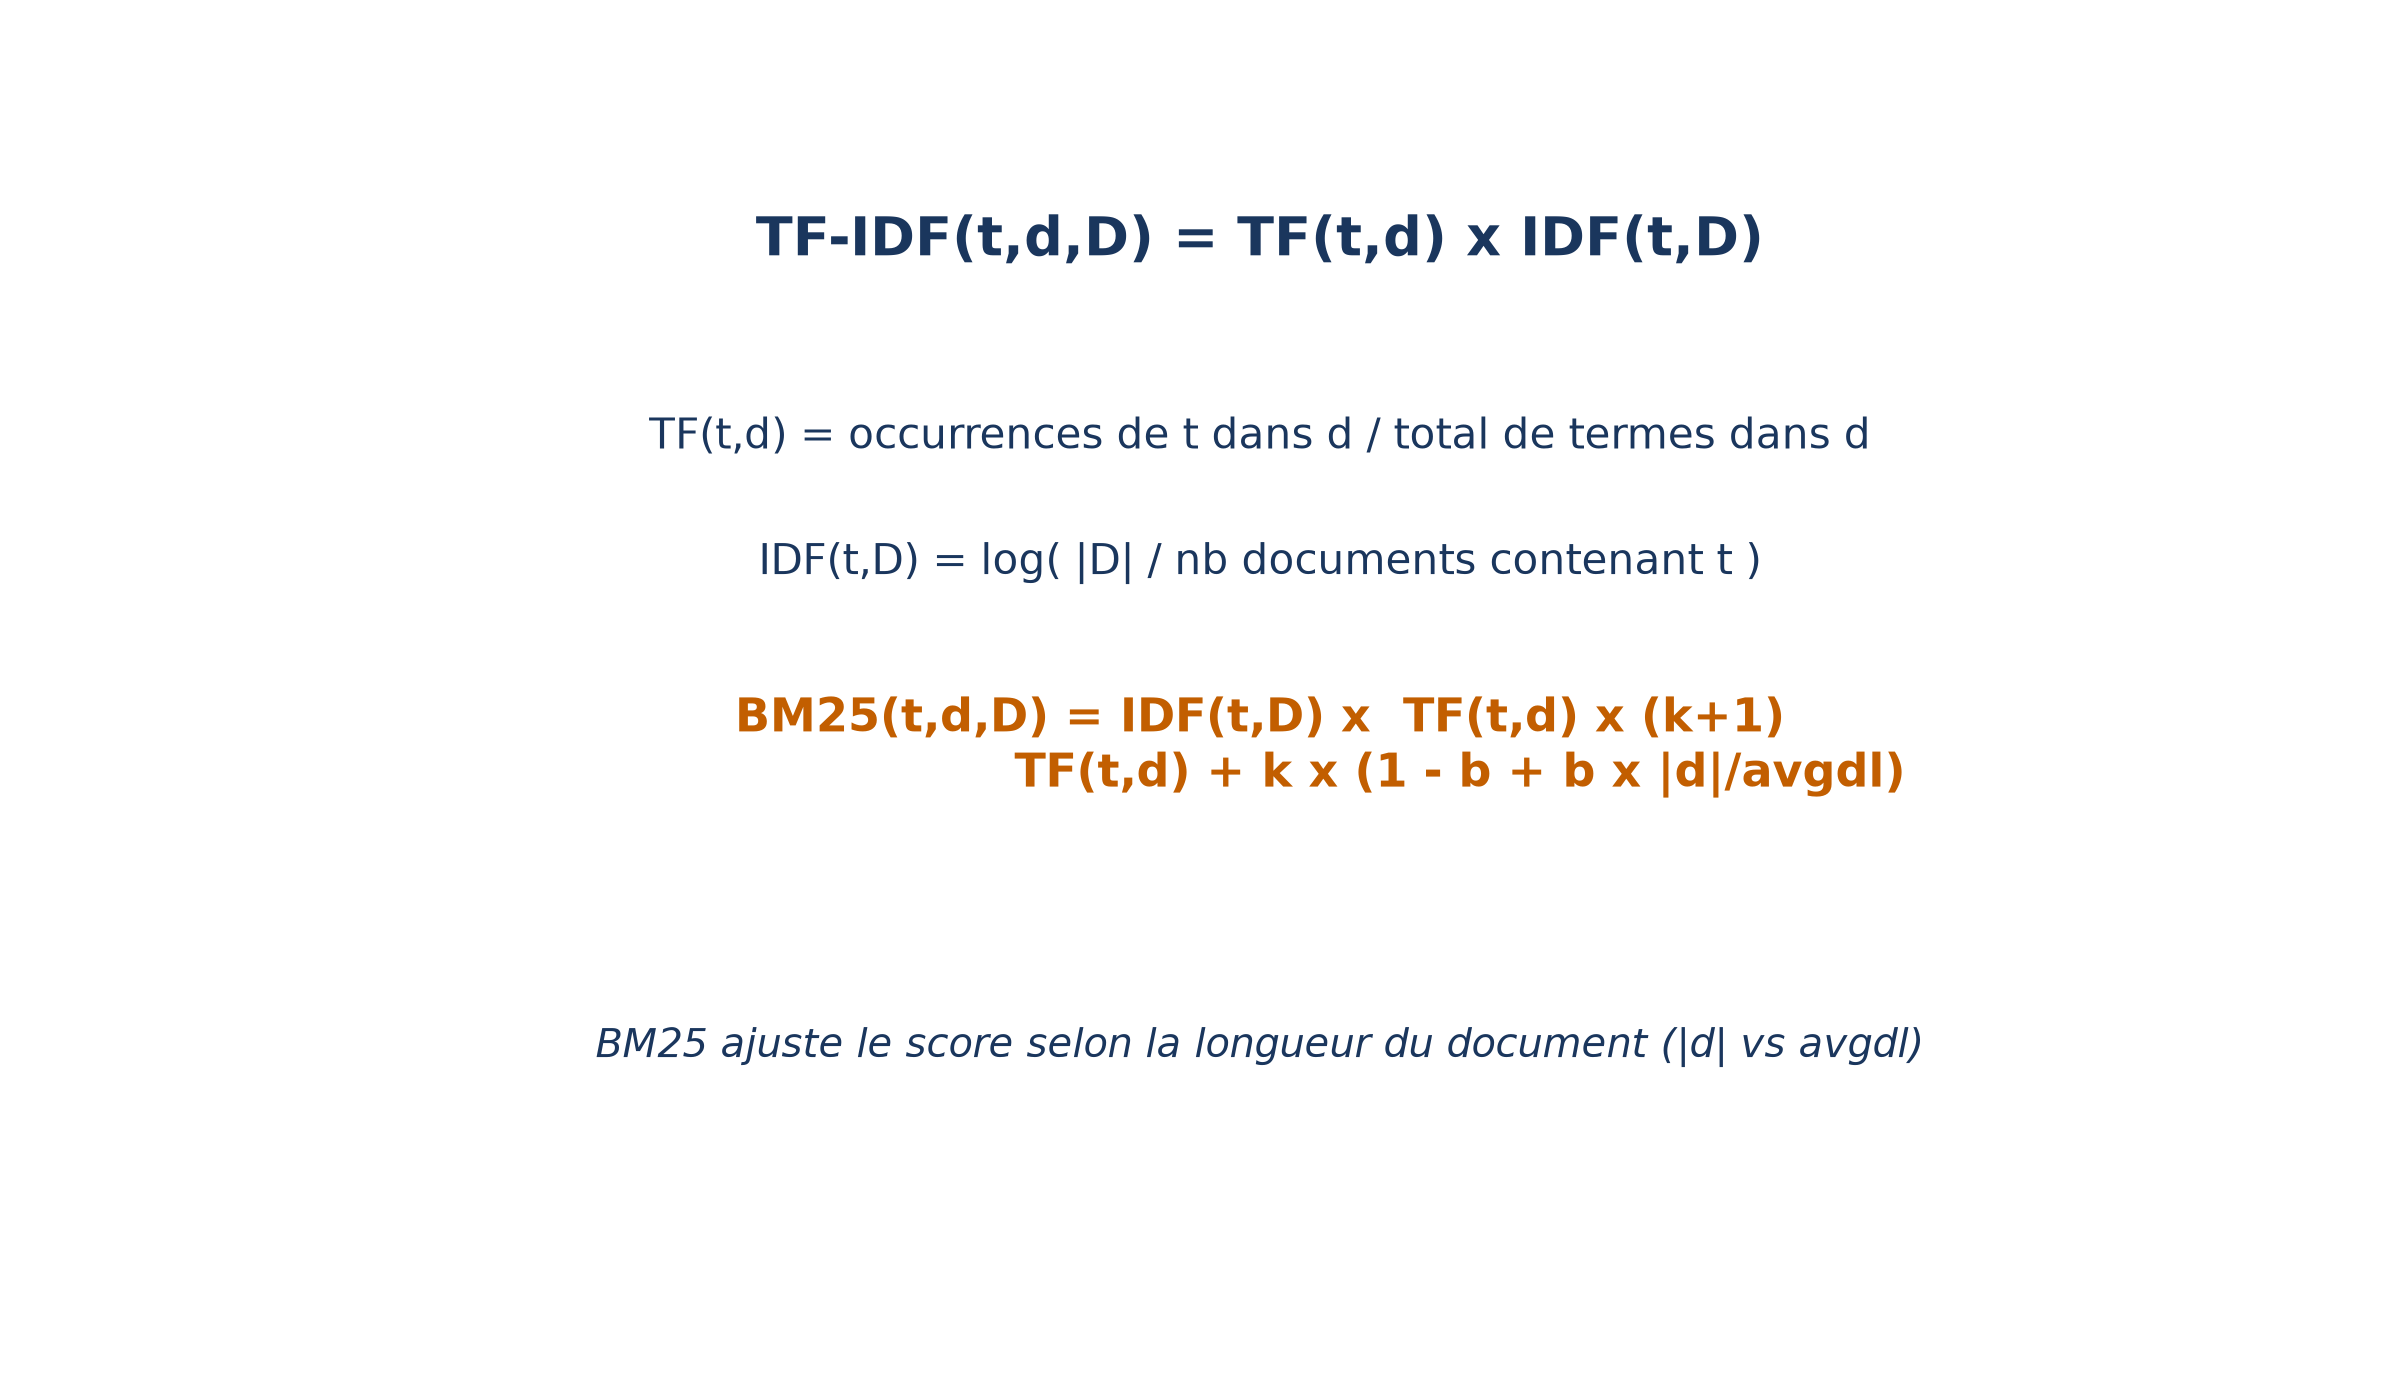
Car TF-IDF reste insensible au contexte et à l’ordre des mots, et rien ne l’empêche de favoriser les longs documents. BM25 l’améliore en normalisant selon la longueur, pour qu’un document long ne soit pas avantagé artificiellement.
Pour voir la différence, prends une base minuscule de trois phrases : « Australia won the Cricket World Cup 2023 », « India and Australia played in the finals » et « Australia won the sixth time having last won in 2015 ». Voici un retriever TF-IDF construit dessus avec LangChain, interrogé avec le seul mot « won ». La commande %pip installe d’abord la bibliothèque scikit-learn dont il dépend.
%pip install --upgrade scikit-learn

from langchain_community.retrievers import TFIDFRetriever

retriever = TFIDFRetriever.from_texts(
    ["Australia won the Cricket World Cup 2023",
     "India and Australia played in the finals",
     "Australia won the sixth time having last won in 2015"]
)
result = retriever.invoke("won")
print(result)
from_texts construit le retriever à partir des trois phrases ; invoke lui soumet la requête et renvoie la liste des documents retenus. La deuxième phrase ne contient pas « won » : pour un retriever qui compte des mots, elle n’a aucune raison de passer devant les deux autres.
Le même mini-corpus fonctionne avec BM25. Cette fois la requête est une vraie question en langage naturel.
%pip install --upgrade rank_bm25

from langchain_community.retrievers import BM25Retriever

retriever = BM25Retriever.from_texts(
    ["Australia won the Cricket World Cup 2023",
     "India and Australia played in the finals",
     "Australia won the sixth time having last won in 2015"]
)
result = retriever.invoke("Who won the 2023 Cricket World Cup?")
print(result)
Remarque que l’interface ne bouge pas : seul le nom de la classe change. C’est le signe qu’on est bien devant un rôle, pas devant une technique. En pratique, BM25 sert souvent de première récupération rapide, que l’on fait suivre d’un ré-ordonnancement par une méthode plus puissante.
Comparer des sens : les embeddings
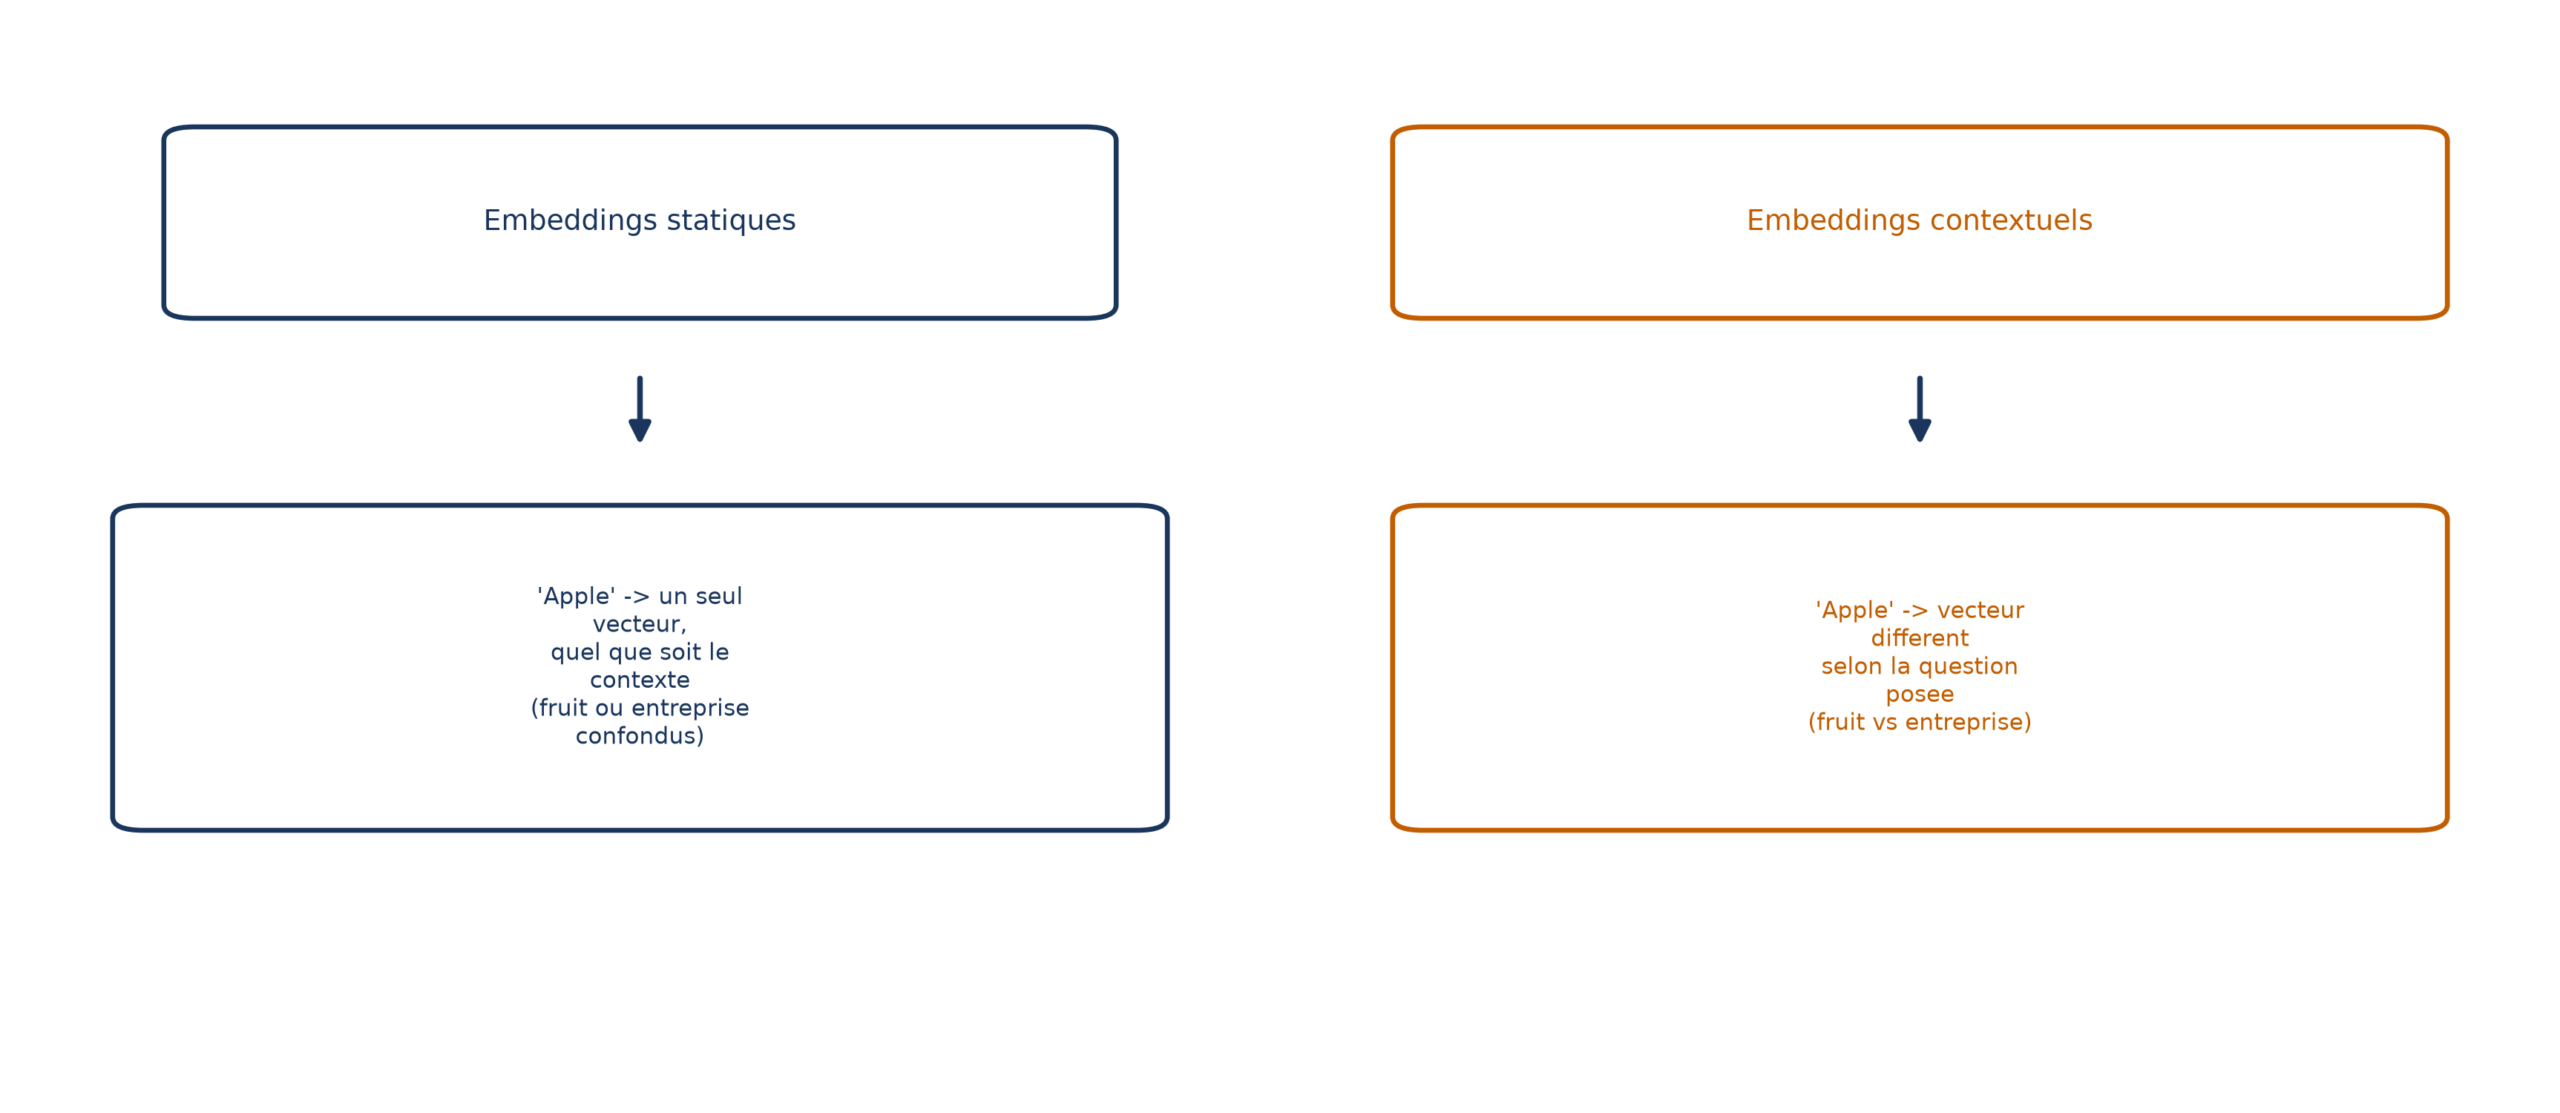
Les retrievers lexicaux ont un angle mort : si ta question dit « gagner » et que le texte dit « remporter », aucun mot ne coïncide. Les embeddings répondent à ce problème en représentant les textes par des vecteurs denses, bâtis pour que des textes de sens voisin soient proches.
Il en existe deux générations. Les embeddings statiques (Word2Vec, GloVe) donnent à chaque mot un vecteur qui capte des relations de sens (« roi » moins « homme » plus « femme » se rapproche de « reine »), mais ce vecteur ne change jamais, ce qui pose problème pour les mots polysémiques. Les embeddings contextuels, produits par des modèles comme BERT ou ceux d’OpenAI, calculent une représentation qui varie avec le contexte.
Une fois les vecteurs obtenus, le classement est le même pour toutes les familles. Pour une requête  et un document
 sous forme de vecteurs, le score le plus courant est la similarité cosinus :
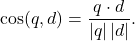
Ici  est le produit scalaire des deux vecteurs, et
 ,
 leurs normes (leurs longueurs). Diviser par les normes retire la longueur du calcul : il ne reste que l’angle entre les deux vecteurs, et l’on classe les documents selon ce score.
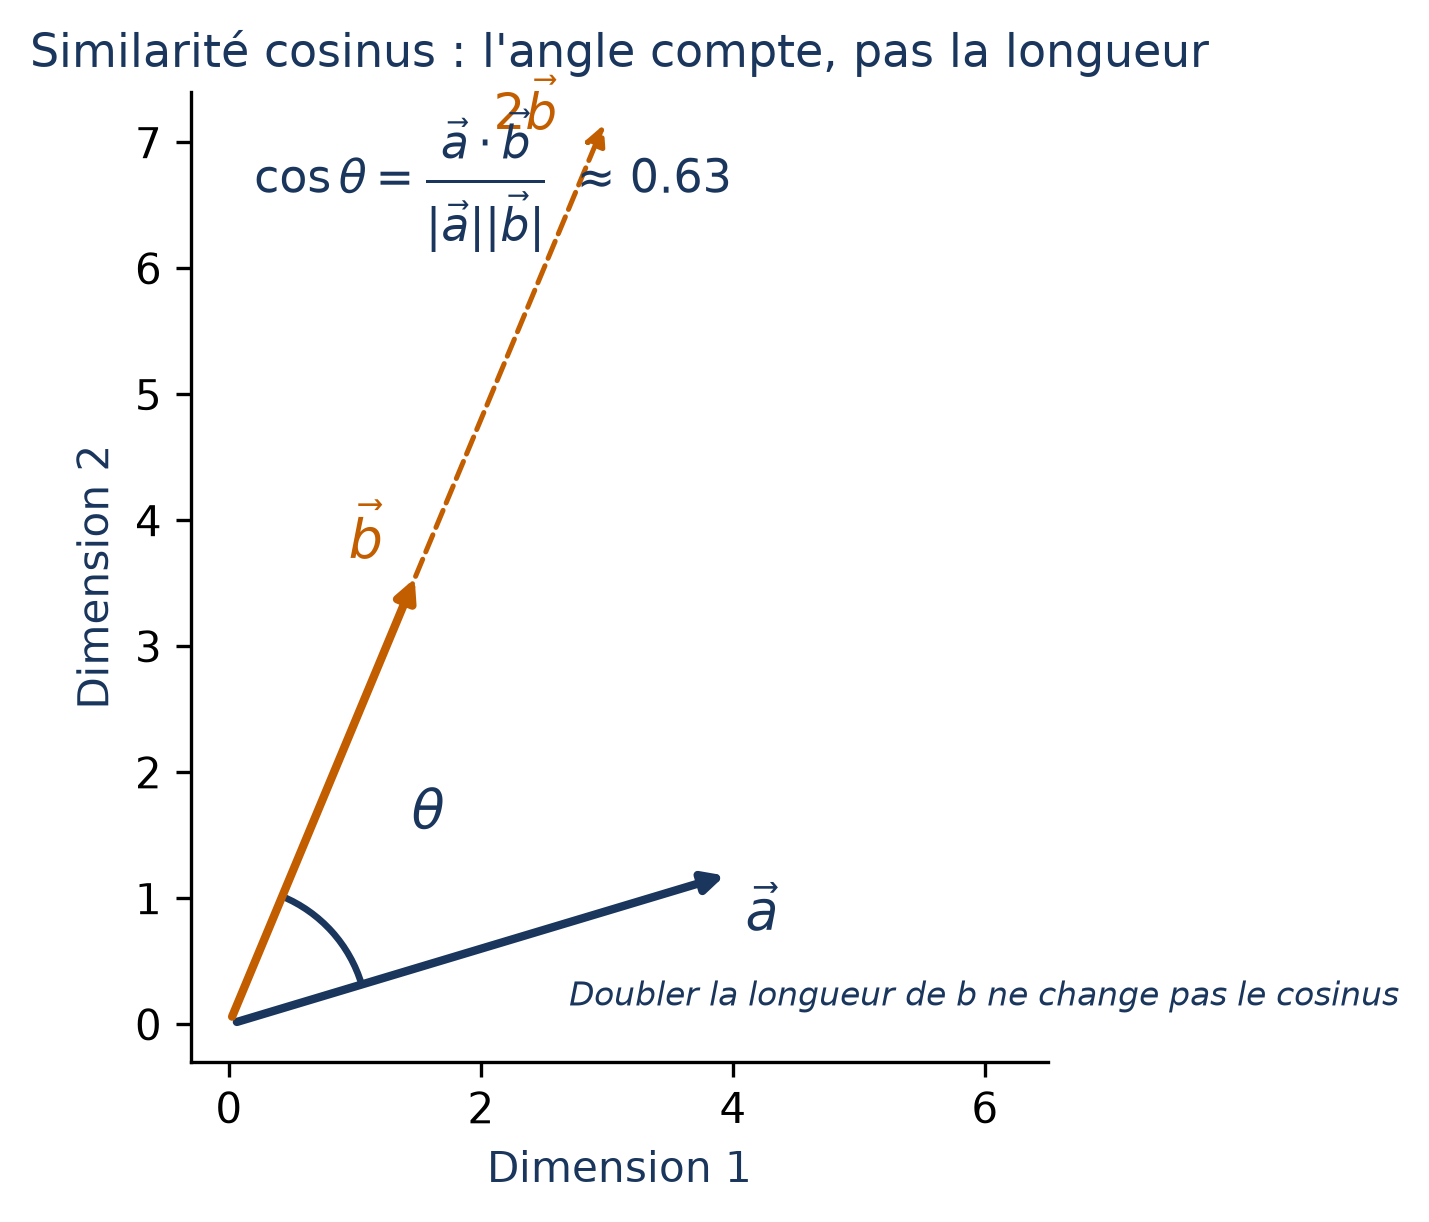
Un détail qui relie les deux familles : dans sa forme la plus simple, un retriever peut très bien calculer des TF-IDF pour tous les documents, puis le cosinus entre chacun et la requête, et classer selon ce score. La mécanique du classement est donc la même ; ce qui change, c’est la manière de fabriquer les vecteurs.
Le reste de la famille
Les embeddings contextuels suffisent pour bâtir un système de base, mais d’autres méthodes existent :
- la récupération sparse apprise (SPLADE, DeepCT) et la récupération dense (DPR, ANCE) ;
- la récupération qui combine sparse et dense (ColBERT) ;
- le cross-encoder, qui compare directement la paire requête-document ;
- la récupération par graphes, qui interroge les relations entre entités plutôt que des vecteurs de texte.
Tu n’as pas à tout coder : LangChain propose des retrievers déjà intégrés. Ce sont les bases vectorielles elles-mêmes (FAISS, Pinecone, Milvus, Weaviate, ces deux derniers offrant une recherche hybride), les services des fournisseurs cloud (Amazon Kendra, Azure AI Search, Google Vertex AI Search) ou des connecteurs vers des ressources web (Wikipédia, Arxiv, AskNews).
Sous le capot : un encodeur ou deux ?
Comment un retriever dense calcule-t-il son score ? Deux architectures s’opposent, et leur différence explique une bonne part de ce qui suit.
Avec un encodeur unique, on donne au modèle la requête et le document en même temps. Il peut alors faire jouer l’auto-attention entre tous leurs mots, et la sortie est un score de similarité. C’est précis, mais le texte entier (requête plus document) doit tenir dans la fenêtre du modèle, 512 jetons pour BERT, et il faut repasser la requête avec chacun des documents du corpus : le coût devient prohibitif.
Le bi-encodeur coupe le problème en deux : un encodeur lit la requête, un autre lit chaque document. Les vecteurs des documents sont calculés une fois et rangés dans une base ; à chaque requête, il ne reste qu’à comparer son vecteur à ceux de la base par le cosinus. C’est bien plus rapide, mais moins précis, car on perd une partie des interactions entre les termes de la requête et ceux du document.
| Architecture | Ce qu’elle lit | Atout | Limite |
|---|---|---|---|
| Encodeur unique | Requête et document ensemble | Interaction fine entre leurs mots | Il faut le repasser sur tout le corpus |
| Bi-encodeur | Requête d’un côté, chaque document de l’autre | Vecteurs de documents calculés d’avance, recherche rapide | Interactions mot à mot perdues |
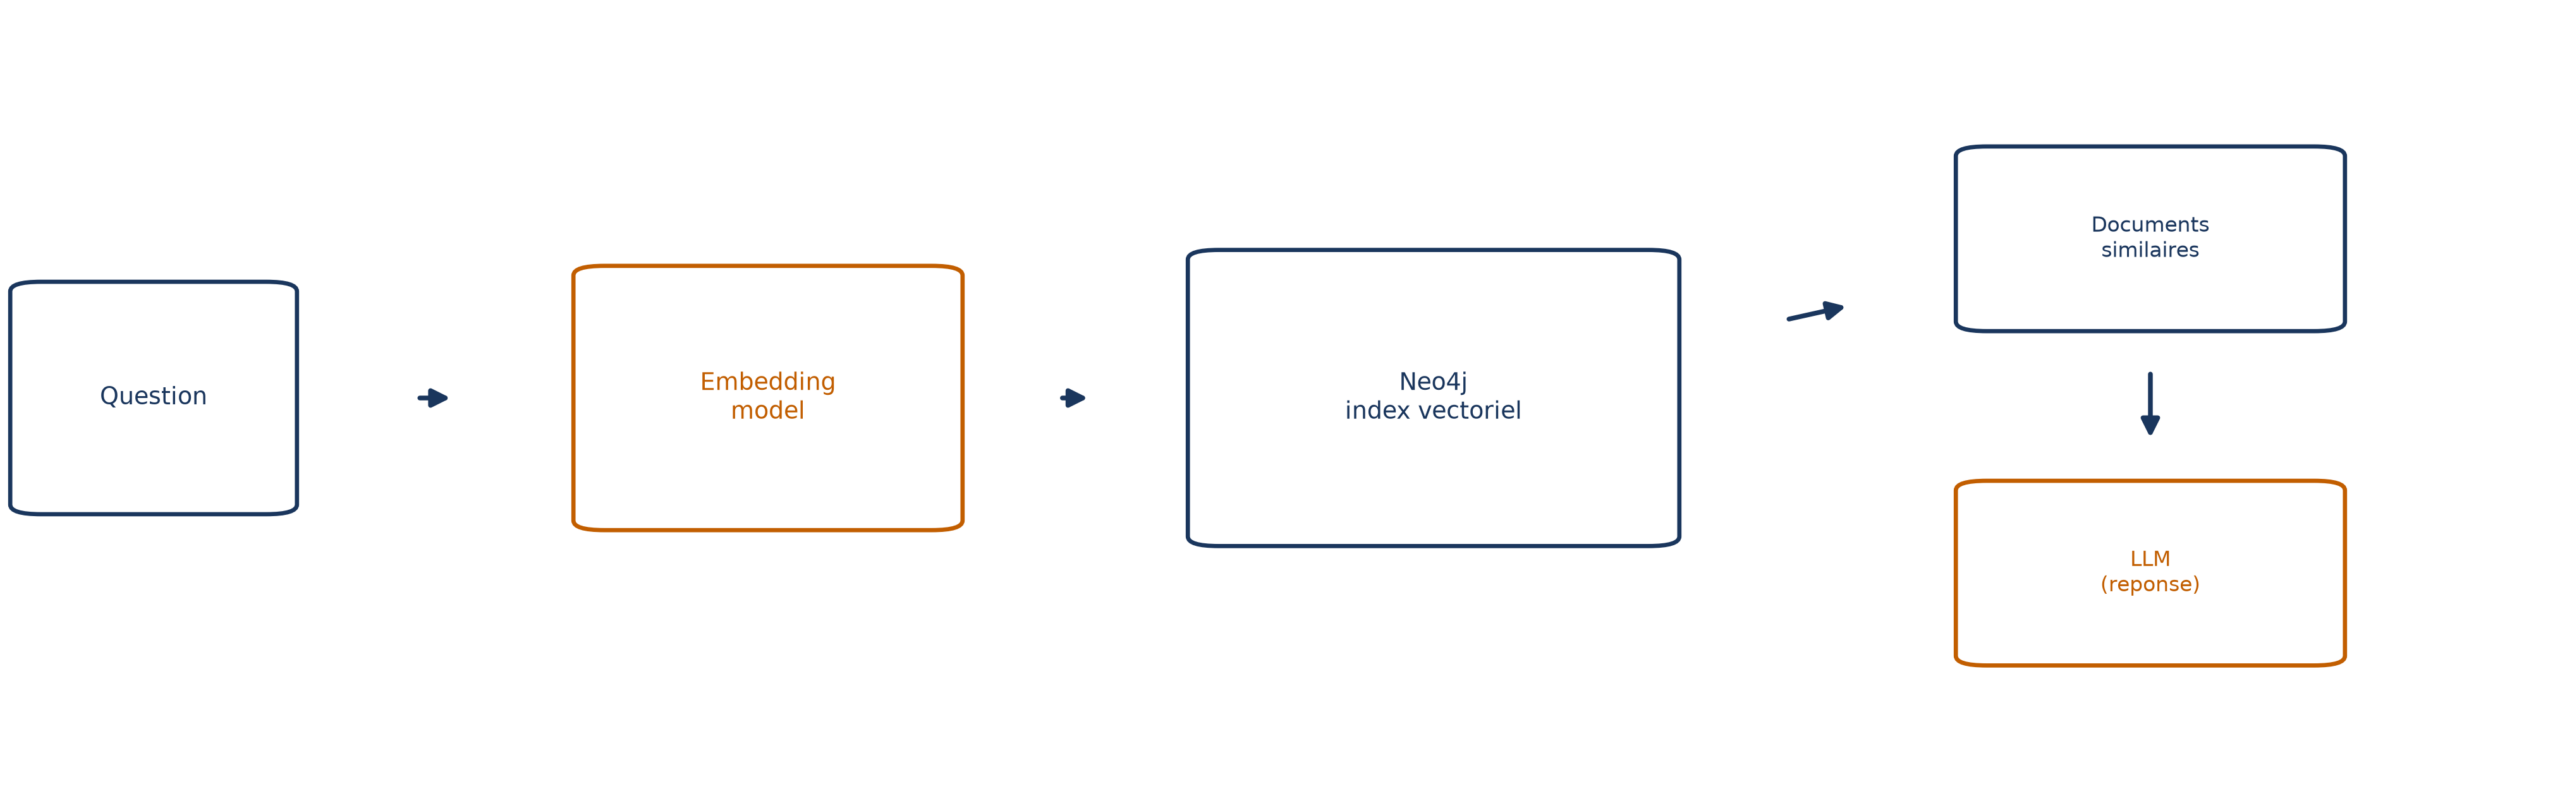
Le choix de l’encodeur n’est pas anodin. Il pèse sur le coût (un embedder est un Transformer : plus il est grand, plus le calcul coûte, et un encodeur fermé facture son API à l’usage), sur le stockage (plus les vecteurs sont grands, plus il coûte), sur la latence, et sur la performance. Certains encodeurs sont spécialisés (finance, médecine, science, code) et certains gèrent une centaine de langues. Un bon point de départ est le classement MTEB de Hugging Face, mais ses résultats sont souvent auto-déclarés et peuvent surestimer les capacités d’un modèle si des données de test ont fui dans son entraînement : teste plusieurs modèles sur tes propres données.
Reste à stocker ces vecteurs. FAISS n’est pas conçu pour créer, modifier ou supprimer des données : il convient si la base est immuable. Les bases SQL qui acceptent les vecteurs passent mal à l’échelle. Les bases dédiées sont en général la meilleure solution pour la performance, grâce à la recherche approchée des plus proches voisins, dont HNSW sacrifie un peu de précision mais va bien plus vite qu’une recherche exacte comme l’indexation Flat.
Voir un retriever dense tourner
Voici la fonction de récupération d’un agent qui recommande des films. Les descriptions de films ont été découpées en passages, transformées en vecteurs par un encodeur embedder et rangées dans une collection Chroma, collection. Au moment de la requête, on réutilise le même encodeur pour la question.
def retrieve_documents(query, collection, top_k=5):
    query_embedding = embedder.encode(query).tolist()
    results = collection.query( query_embeddings=[query_
embedding], n_results=top_k )
    chunks = []
    titles = []
    for document in results['metadatas'][0]:
        chunks.append(document['chunk'])
        titles.append(document['original_title'])
    return chunks, titles
Lis la fonction comme une définition de retriever : elle prend une requête, un nombre top_k, et rend une liste de passages avec leurs titres, rangés du plus proche au plus lointain. results['metadatas'][0] désigne les métadonnées de notre unique requête, d’où l’on extrait le texte du passage et le titre du film d’origine.
Une question en langage courant passe donc par exactement la même porte que le mot « won » de tout à l’heure : requête en entrée, liste classée en sortie. Seule la définition de « proche » a changé.
Quand la question ne ressemble pas aux documents
Le retriever compare une requête à des documents. Si les deux ne sont pas formulés de la même façon, la bonne réponse peut dormir au fond de la liste. On agit alors sur la requête avant de la lui confier, souvent avec l’aide d’un LLM.
- La décomposition découpe une question complexe en sous-requêtes indépendantes. Aucun passage ne répond peut-être à « qui a inventé le télégraphe et le téléphone ? », mais chacune des deux moitiés trouvera le sien.
- La réécriture reformule un énoncé en requête de recherche exploitable : « je n’arrive pas à envoyer d’e-mails depuis mon téléphone » devient « étapes de dépannage pour résoudre les problèmes d’envoi d’e-mails sur smartphone ».
- L’expansion ajoute des termes ou génère plusieurs variantes de la requête (cinq, par exemple), ce qui augmente le rappel. Mal maîtrisée, elle peut réduire la précision et diluer l’intention d’origine.
La plus surprenante est HyDE (Hypothetical Document Embeddings). On demande au LLM d’écrire une réponse hypothétique à la question, sans consulter la base, puis on utilise le vecteur de cette réponse pour la recherche. L’idée : même imparfaite, une réponse inventée ressemble davantage aux vrais passages pertinents que la question brute.
original_query = "How does climate change affect polar bears?"
system_prompt = "You are an expert in climate change and arctic life."
hyde_prompt = f"Generate an answer to the question: {original_query}"

from openai import OpenAI
client = OpenAI()
response = client.chat.completions.create(
    model="gpt-4o-mini",
    messages=[
        {"role": "system", "content": system_prompt},
        {"role": "user", "content": hyde_prompt}
    ]
)
hy_answer = response.choices[0].message.content

embeddings = OpenAIEmbeddings(model="text-embedding-3-large")
hyde = embeddings.embed_query(hy_answer)
Le code fait deux choses : le LLM gpt-4o-mini rédige hy_answer, puis embed_query convertit cette réponse en vecteur hyde. C’est ce vecteur, et non celui de la question, qui sert à interroger l’index. OpenAIEmbeddings est la classe de la bibliothèque langchain_openai déjà croisée dans les exemples de retrievers intégrés.
Le LLM n’a pas besoin de connaître la vraie réponse, ce n’est même pas le but : il sait seulement reconnaître dans la question des motifs pertinents, et ce sont eux qui font remonter les bons passages. HyDE aide surtout quand le rappel est faible, ou quand les documents viennent d’un domaine que l’encodeur n’a jamais vu.
Un retriever ne travaille pas seul
Quand le retriever est entouré, ses défauts se compensent.
Mots et sens, ensemble
Les retrievers lexicaux et denses ont des angles morts opposés : certains passages ne sont pertinents que parce qu’ils contiennent un mot-clé précis (un nom de produit, de personne), alors que tous les passages qui contiennent ce mot ne le sont pas, surtout pour une requête qui vise un concept. La recherche hybride combine les deux et choisit combien de passages prendre à chaque type de recherche ; c’est l’un des composants les plus utilisés dans les pipelines actuels.
Dans l’implémentation vue en exemple, la fonction calcule l’embedding de la requête, interroge ChromaDB d’un côté et Elasticsearch de l’autre, puis concatène les deux listes de résultats. On peut aussi aiguiller la requête avant de chercher : s’il y a des mots-clés précis, une recherche par mots-clés, sinon une recherche sémantique. La règle ci-dessous en est la version la plus simple, où "specific_keyword" est un mot-clé fictif à remplacer par le tien.
def advanced_query_routing(query):
    """
    Determines the retrieval method based on the presence of specific
keywords in the query.
    Args:
        query (str): The user's query.
    Returns:
        str: 'textual' if the query requires text-based retrieval,
'vector' otherwise.
    """
    if "specific_keyword" in query:
        return "textual"
    else:
        return "vector"
Chercher large, puis trier
Voici un dilemme : augmenter k fait monter le rappel de la récupération, mais donne trop de matière au LLM. Le reranking le résout en deux temps. D’abord une récupération classique d’un grand nombre de passages ; ensuite un second modèle, le reranker, réordonne cette présélection et ne garde que les k meilleurs.
Le reranker prend en compte l’information contrastée avec la requête et lit chaque passage en contexte avec elle, ce que ne fait pas un bi-encodeur. On en rencontre plusieurs types :
- les cross-encodeurs (comme BGE), qui lisent la requête et un passage à la fois et renvoient une similarité entre 0 et 1 ;
- les rerankers multi-vecteurs (comme ColBERT), moins gourmands en calcul, car l’interaction entre les deux textes intervient en fin de traitement ;
- les LLM utilisés comme rerankers : pointwise (un document à la fois), pairwise (deux documents, lequel est le plus pertinent ?) ou listwise (une liste à classer, avec un risque de coût élevé) ;
- des LLM ajustés au classement, comme RankT5.
Le cross-encodeur n’est donc rien d’autre que l’encodeur unique de tout à l’heure : trop lent pour balayer un corpus entier, il trouve sa place sur une présélection courte. Après le reranking, on peut encore filtrer les passages dont la similarité est sous un seuil, qui ne contiennent pas certains mots-clés, ou qui sont plus anciens qu’une date.
Ce qu’un retriever ne fait pas
Il ne distingue pas toujours « proche » de « pareil ». La similarité entre deux embeddings vient du fait que des mots apparaissent dans la même fenêtre de contexte : le modèle ne distingue donc pas les synonymes des antonymes. Cette limite est décrite pour les embeddings de mots, mais elle rappelle que « proche » n’est pas « pertinent ».
Il ignore ton domaine. Les benchmarks généralistes mesurent une performance générale, qui peut être mauvaise dans ton domaine ou pour ta tâche. Quand le modèle d’embeddings et le modèle de génération sont développés et ajustés séparément, leurs résultats peuvent être incohérents dans les domaines spécialisés ; les ajuster conjointement pour un domaine de niche corrige ce décalage. L’entraînement peut prendre trois formes : ajuster d’abord le retriever puis le geler (retriever-first, adapté quand la précision de la recherche prime, comme dans un moteur de recherche juridique), laisser un LLM superviser l’entraînement du retriever (LLM-first), ou entraîner les deux ensemble de bout en bout.
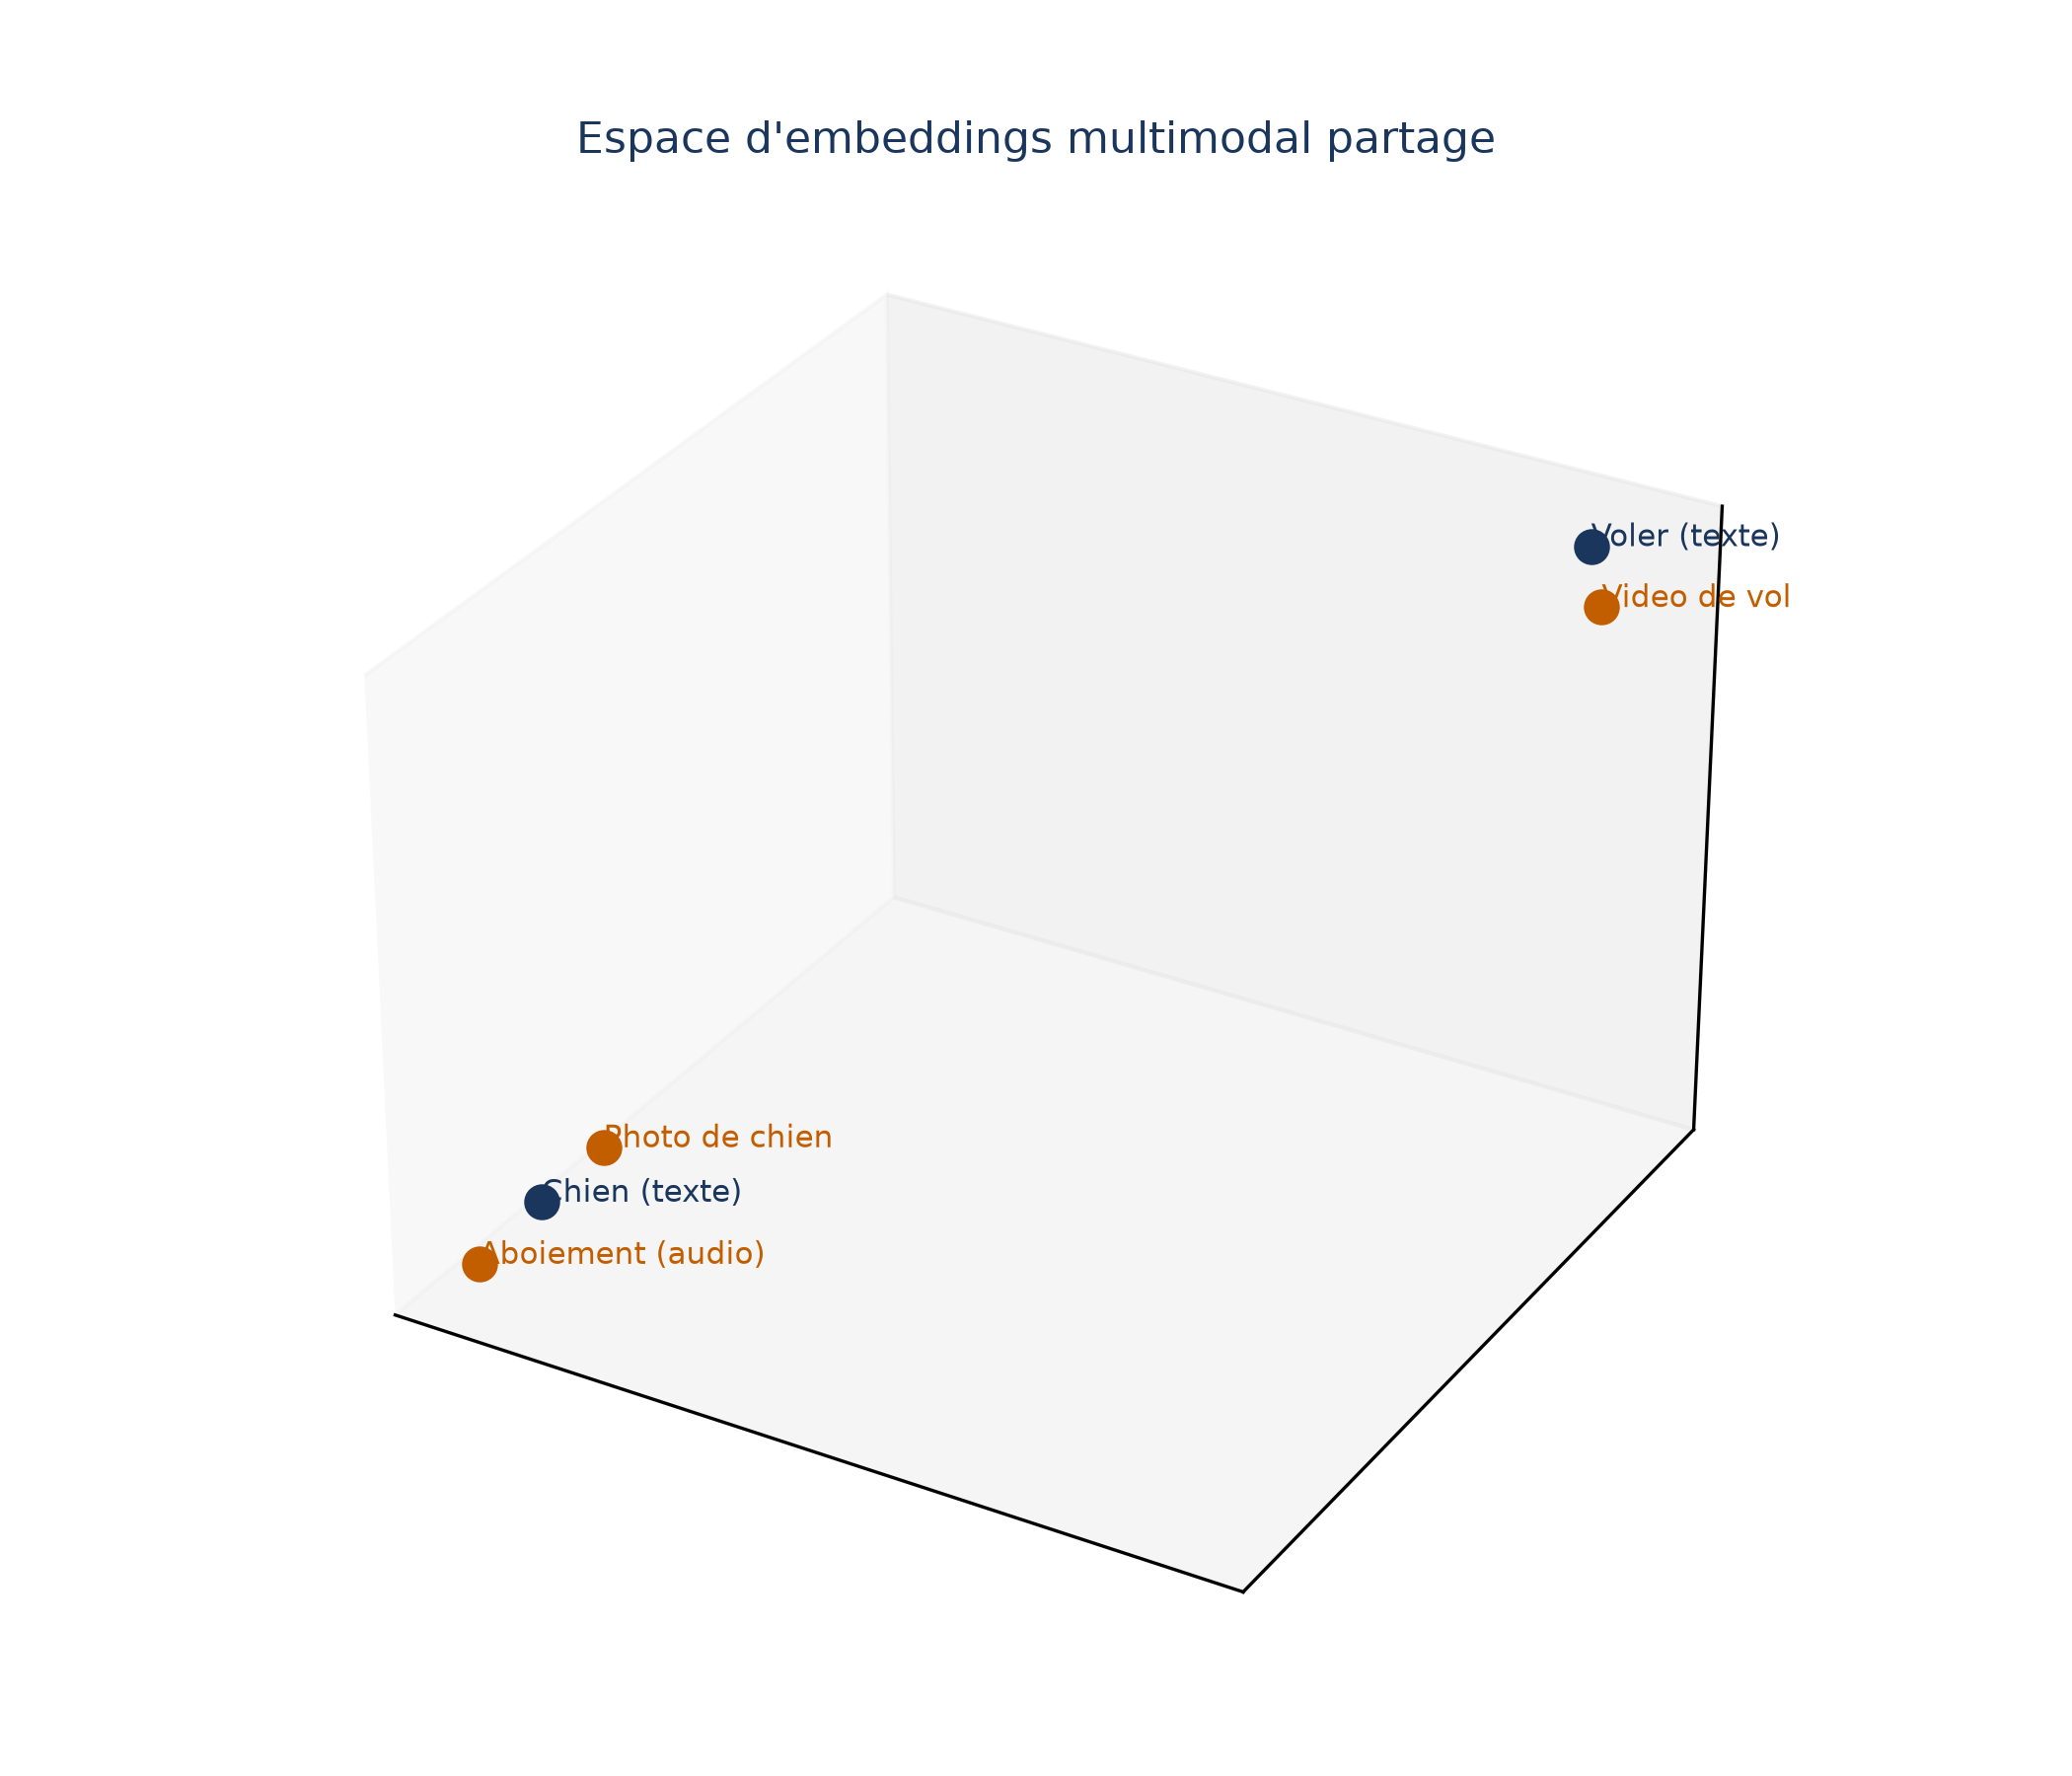
Il ne cherche pas que du texte. Pour des contenus mêlant image, son et vidéo, la récupération dépend de la stratégie d’embeddings : similarité classique avec des embeddings partagés, récupération multi-vecteurs qui interroge chaque espace d’embeddings propre à une modalité, ou récupération textuelle suivie de la récupération des fichiers bruts associés.
Il ne s’améliore pas seul. Chacun de ses défauts a sa rustine, que tu as déjà croisée dans cet article :
| Ce que le retriever rate | Ce qu’on ajoute |
|---|---|
| Requête complexe, faible rappel | Transformation de la requête : décomposition, réécriture, expansion |
| Mots-clés précis non retrouvés | Recherche hybride : BM25 plus vecteurs, score pondéré |
| Types de requêtes très variés | Routage de la requête vers le bon outil |
| Passages pertinents perdus par un top-k arbitraire | Reranking |
| Documents d’un autre domaine | Réponse hypothétique (HyDE) ou questions hypothétiques par passage |
📌 À retenir Un retriever est une fonction qui transforme une requête en liste classée. Mots exacts, vecteurs ou graphe changent la façon de trier, jamais le contrat : de l’ordre dépend tout ce qui passe ensuite.