Un chercheur en pharmacie connaît le poids moléculaire de trois composés et la capacité de chacun à faire passer un médicament à travers la peau. Il veut prédire celle d’un quatrième composé dont il ne connaît que le poids, et trace pour cela une droite au plus près de ses trois points. Une seule question décide alors de tout : de combien cette droite se trompe-t-elle ? Le RSS y répond par un seul nombre. Tu vas voir comment il se fabrique, à quoi il sert en coulisses et pourquoi un RSS minuscule ne prouve presque rien.
Sommaire
- L’essentiel en 30 secondes
- Un résidu, un carré, une somme : la fabrique du RSS
- Du total à la moyenne : le même score à une autre échelle
- Ce que le RSS fait en coulisses de la régression
- Pourquoi un RSS minuscule ne prouve presque rien
L’essentiel en 30 secondes
- Le RSS (residual sum of squares) est la somme des carrés des résidus : l’erreur totale d’un modèle sur ses données.
- Un résidu est l’écart entre la valeur observée et la valeur prédite ; les moindres carrés choisissent la droite qui minimise le RSS.
- Divisé par le nombre d’observations, le RSS devient l’erreur quadratique moyenne, la mesure d’ajustement la plus répandue en régression.
- Sous un bruit gaussien, minimiser le RSS équivaut au maximum de vraisemblance, et le RSS fournit l’estimation de la variance du bruit.
- Calculé sur les données d’entraînement, il ne peut que baisser quand le modèle s’enrichit : un petit RSS ne garantit donc aucun bon modèle.
Un résidu, un carré, une somme : la fabrique du RSS
Reprends la droite du chercheur. Pour chaque composé, elle annonce une valeur ; l’écart entre la valeur mesurée et celle que la droite prédit s’appelle le résidu du point, noté  , où
 est la valeur observée et
 la valeur prédite par le modèle.
Reste à condenser ces écarts en un unique nombre. Les additionner tels quels laisserait les écarts positifs compenser les négatifs, et prendre leur valeur absolue donne une fonction non dérivable, incommode pour la suite du calcul. La solution retenue, de loin la plus répandue, consiste à sommer leurs carrés.
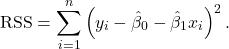
Cette somme porte sur les  observations ;
 et
 sont l’ordonnée à l’origine et la pente estimées de la droite, de sorte que chaque parenthèse n’est autre que le résidu
 . Les trois lettres viennent de residual sum of squares, littéralement la somme des carrés des résidus.
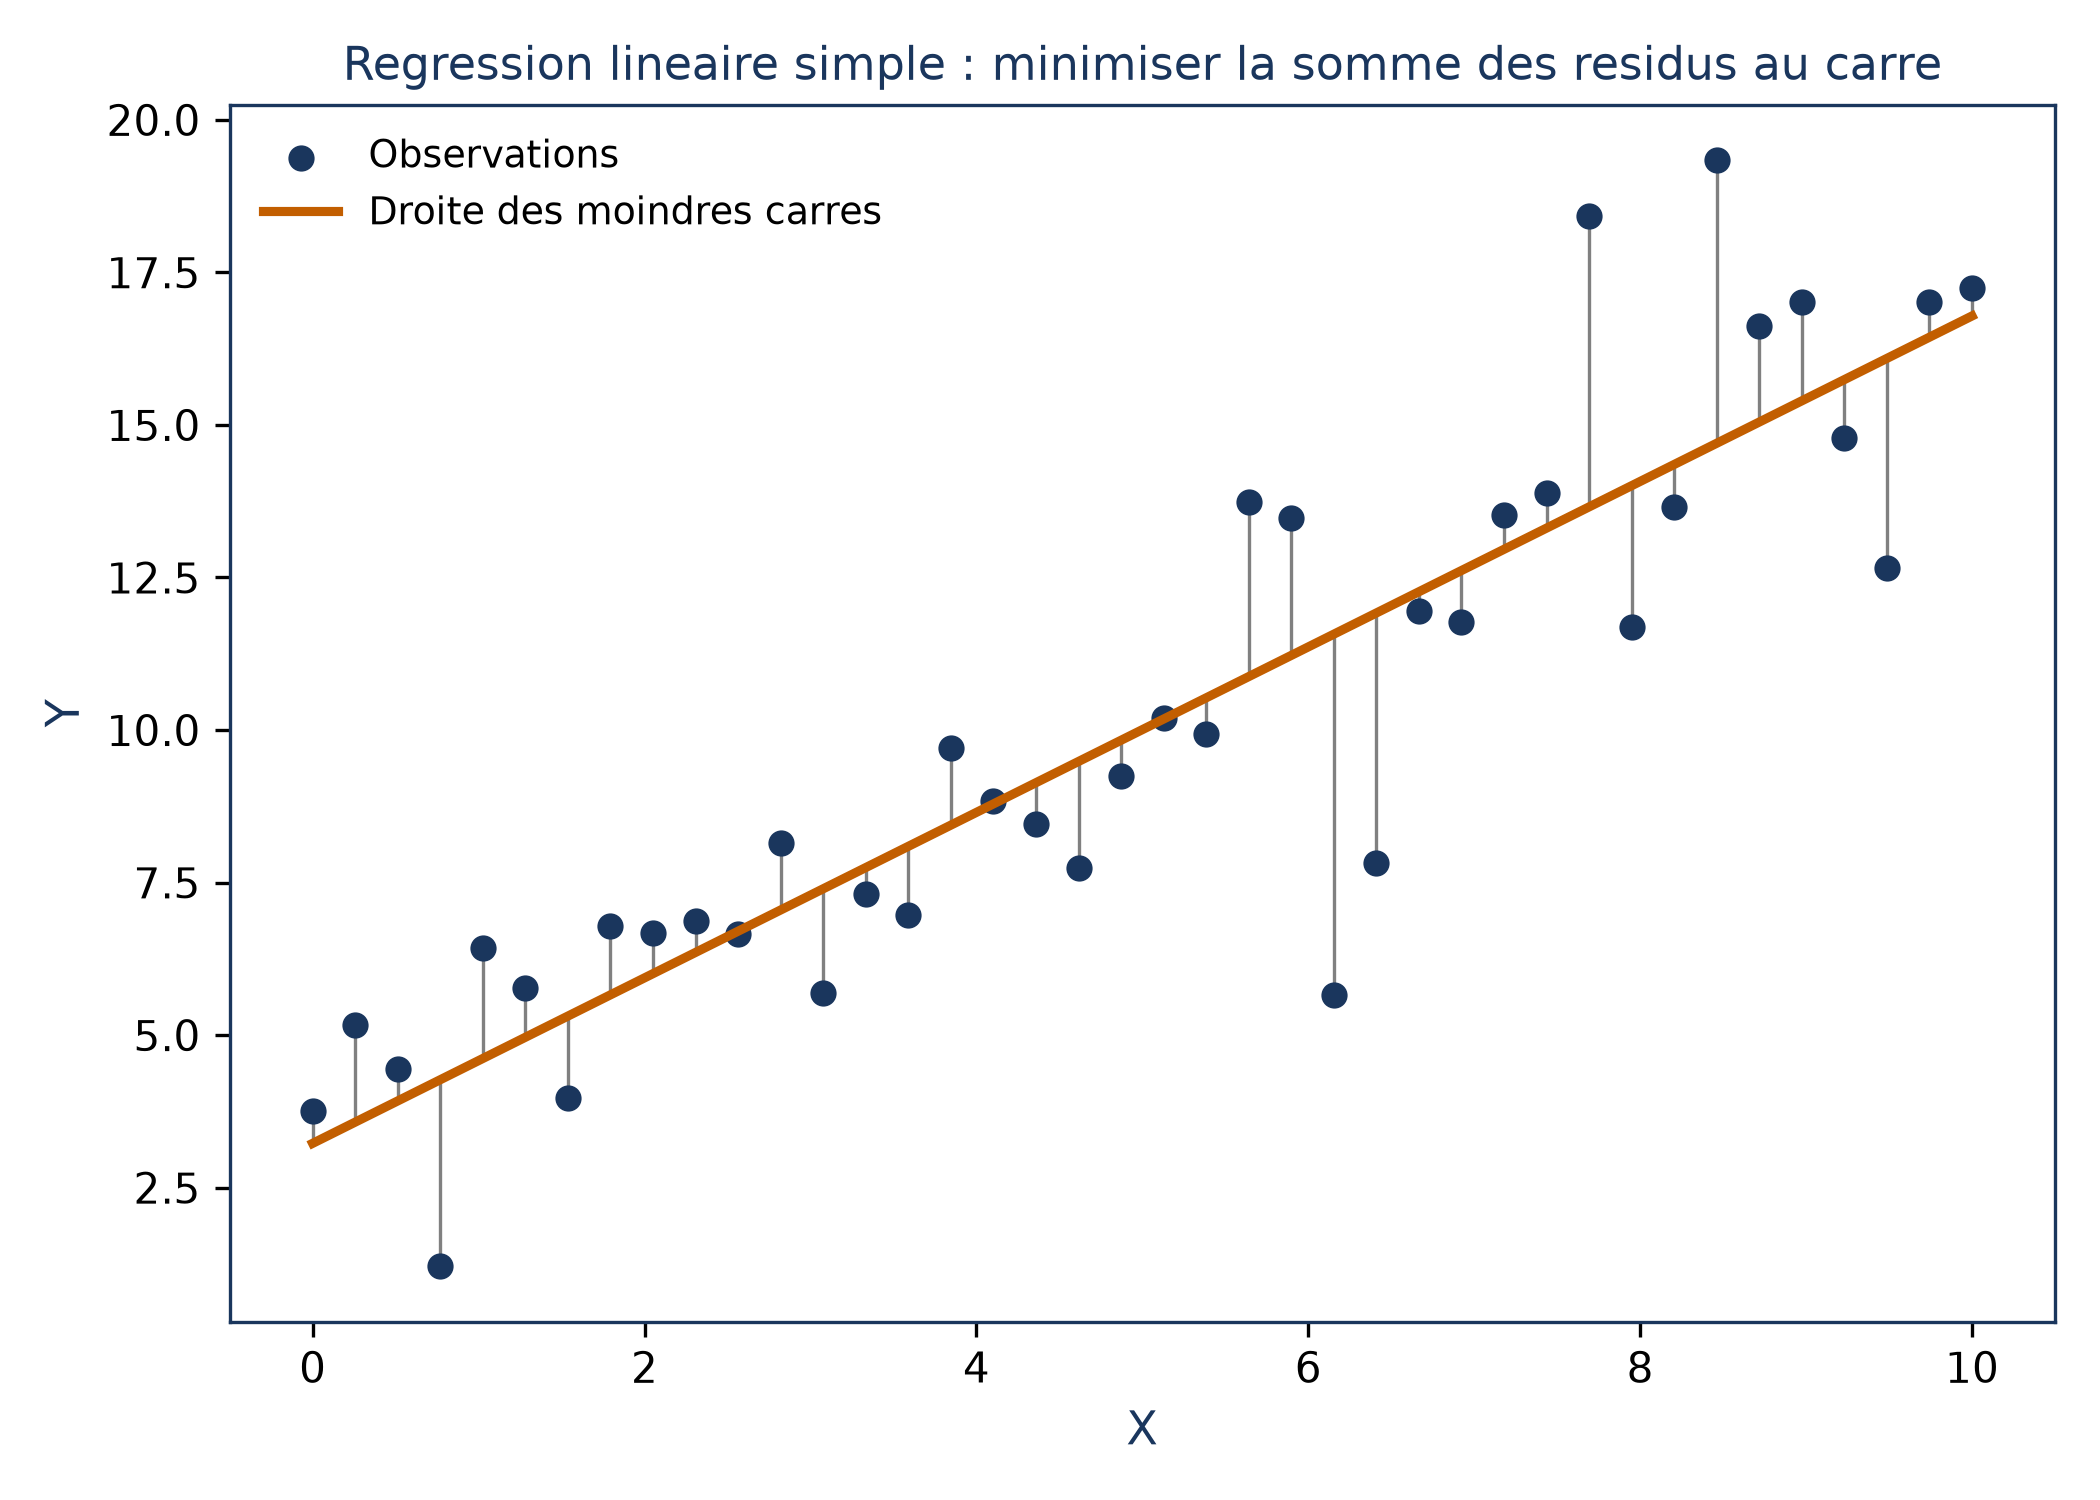
💡 Intuition Le RSS est un score de ratage : il vaut zéro quand le modèle colle exactement aux points, et il grandit à mesure que les prédictions s’en éloignent.
Du total à la moyenne : le même score à une autre échelle
Le RSS additionne les carrés des écarts sans les moyenner. Divise-le par le nombre d’observations et tu obtiens l’erreur quadratique moyenne (MSE, pour mean squared error), la mesure de qualité d’ajustement la plus utilisée en régression.
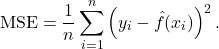
Ici  désigne la prédiction du modèle pour le point
 , ce que tu as noté plus haut : on retrouve la même somme de carrés d’écarts, ramenée à une moyenne. Sa racine carrée est exprimée dans l’unité de la cible, ce qui la fait souvent préférer en pratique.
Reste à savoir sur quels points la calculer. Calculée sur les points qui ont servi à construire le modèle, elle s’appelle MSE d’entraînement ; mais cette valeur n’intéresse presque jamais, puisqu’on connaît déjà ces réponses. Ce qu’on veut, c’est prédire des observations nouvelles : la MSE de test est celle qu’on cherche réellement à minimiser.
Ce que le RSS fait en coulisses de la régression
Le RSS ne sert pas qu’à classer des droites. Deux rôles discrets en découlent, puis un troisième dès qu’on veut contrôler la souplesse d’un modèle.
Il justifie le choix du carré
La méthode des moindres carrés s’est d’abord appuyée sur une intuition purement géométrique. Elle trouve une justification plus profonde : le maximum de vraisemblance choisit les paramètres qui rendent les données observées les plus probables, et, sous l’hypothèse d’un bruit gaussien, il redonne exactement la solution des moindres carrés. Cette équivalence ouvre la porte aux intervalles de confiance autour des coefficients eux-mêmes.
Il donne la taille du bruit
Une fois la droite ajustée, une question demeure : de combien les observations s’écartent-elles de la vraie relation ? L’estimateur de la variance du bruit tient en une fraction :
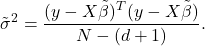
Le numérateur est le RSS écrit avec des vecteurs :  regroupe les
 réponses observées,
 les prédictions, et le produit du vecteur d’écarts par lui-même additionne ses carrés. Le dénominateur compte observations moins les
 paramètres du modèle, soit les
 pentes et l’ordonnée (on trouve aussi les coefficients notés
 ).
Cette variance résiduelle se retrouve dans l’intervalle de confiance de chaque coefficient :
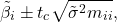
où  est la valeur critique de la loi de Student et
 le -ième élément diagonal de
 . À nombre d’observations égal, quand le RSS grandit, l’intervalle s’élargit.
Il se glisse dans les critères pénalisés
Pour contrôler la souplesse d’une courbe, on ne cherche plus le seul RSS minimal : on lui ajoute une pénalité. La spline de lissage minimise
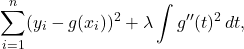
où le premier terme est le RSS de la courbe  et le second pénalise sa courbure totale,
 réglant l’équilibre entre les deux. Quand
 , rien n’empêche de passer par chaque observation : un RSS nul, mais une courbe absurdement irrégulière. Quand
 , toute courbure est interdite et redevient la droite des moindres carrés. La régression ridge et le lasso procèdent de même, en ajoutant au RSS une pénalité sur la taille des coefficients.
Pourquoi un RSS minuscule ne prouve presque rien
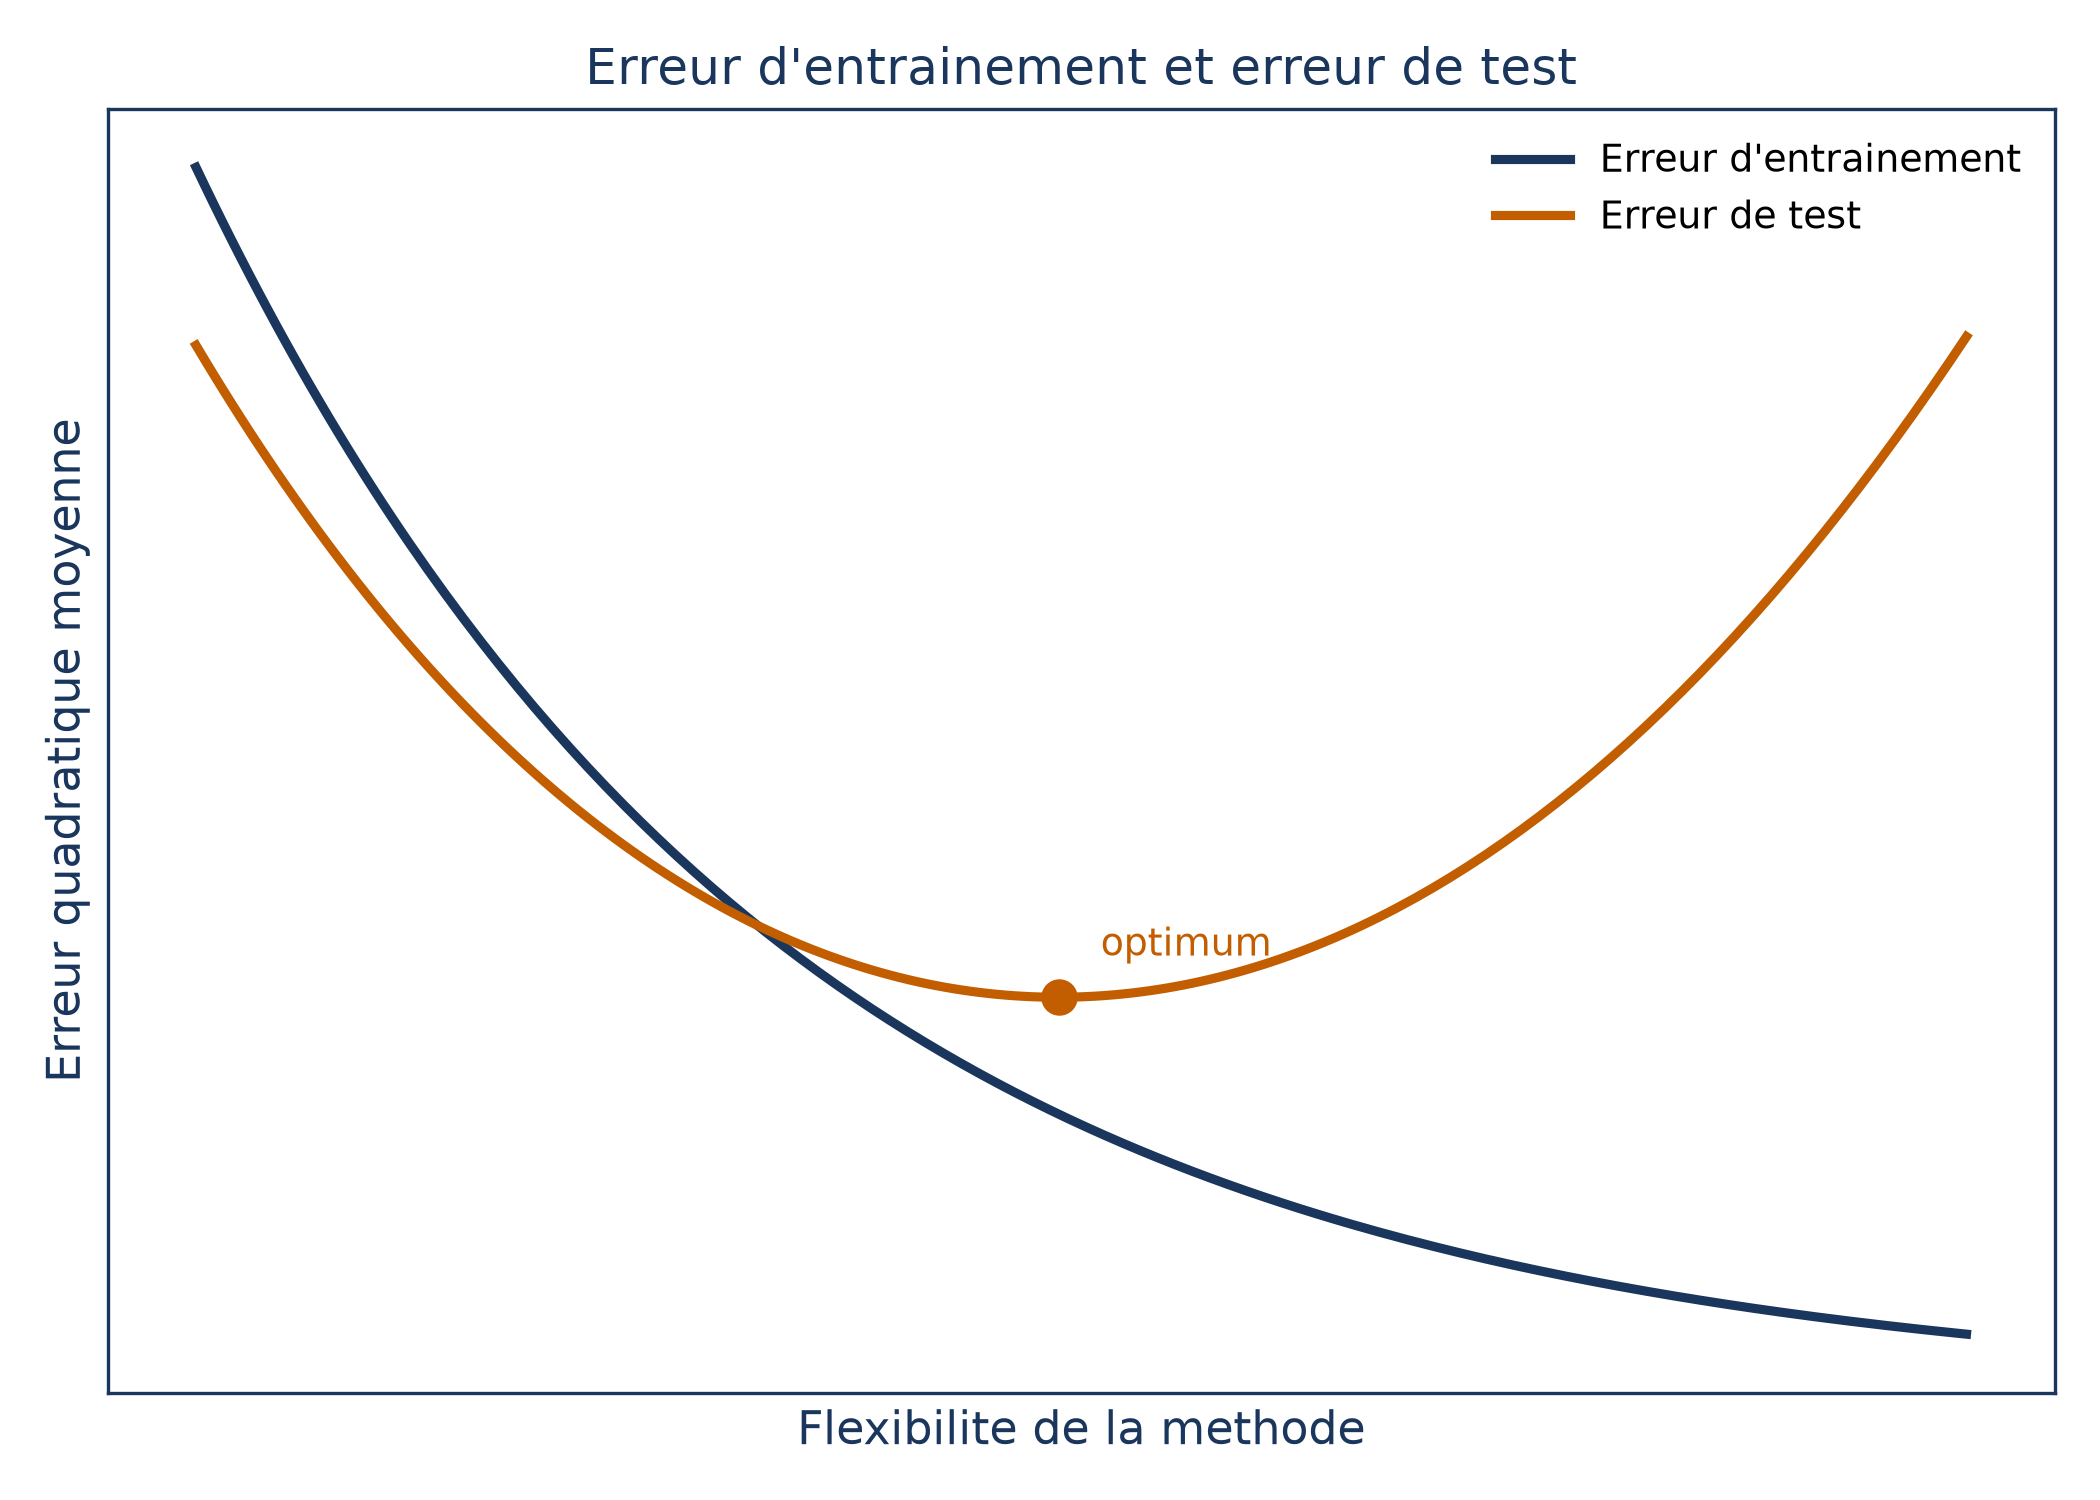
Le réflexe est de croire que le meilleur modèle affiche le plus petit RSS. C’est une tentation dangereuse : ajouter un prédicteur ne peut jamais faire remonter le RSS d’entraînement, même si la variable n’a aucun lien avec la réponse, si bien que le modèle le plus riche gagne toujours ce concours.
Rends un modèle plus flexible et son erreur sur les points d’entraînement diminue sans relâche. L’erreur sur des points neufs dessine, elle, une courbe en U : elle baisse, puis remonte quand le modèle se met à épouser le bruit propre à l’échantillon d’entraînement. Ce basculement s’appelle le surajustement : une méthode plus rigide aurait fait mieux sur les points neufs.
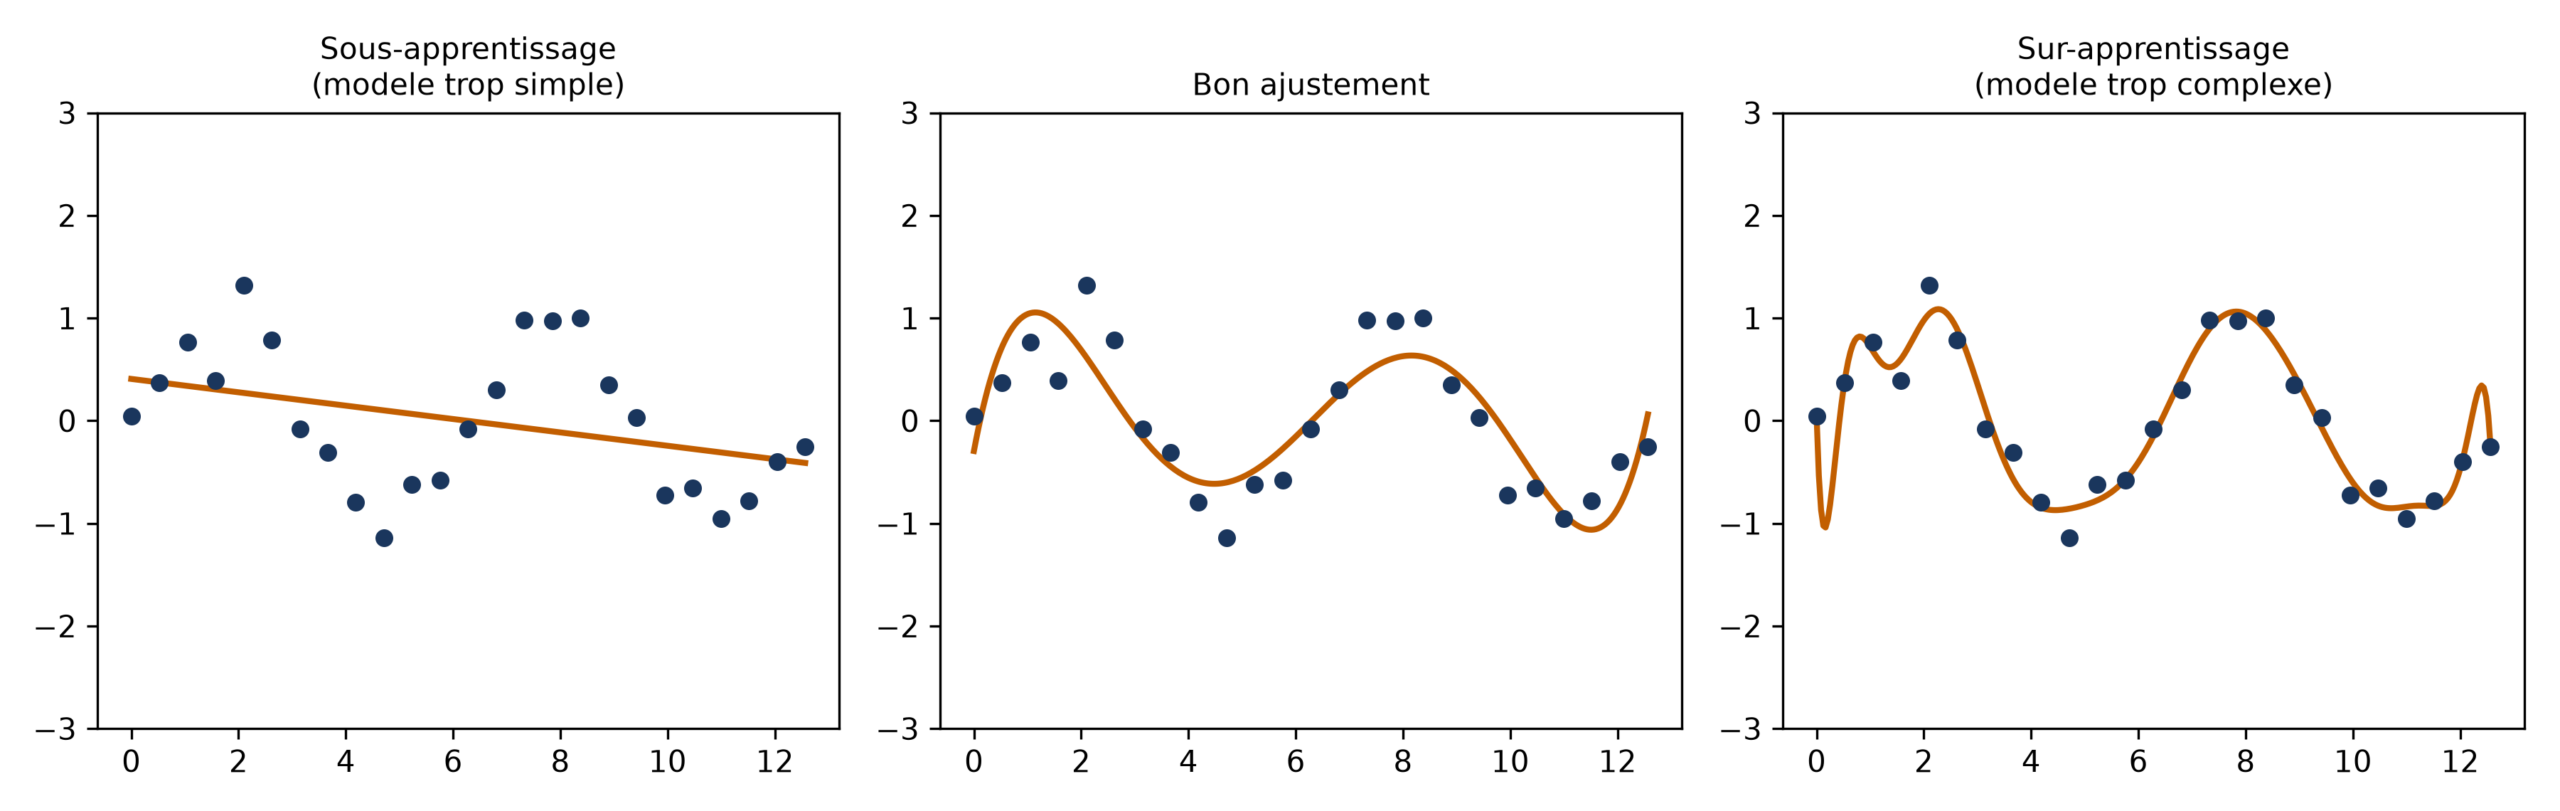
Le cas extrême existe. Quand le nombre de paramètres atteint le nombre d’observations, au seuil d’interpolation, le modèle peut ajuster les données d’entraînement de façon exacte, sans aucune erreur résiduelle. Sur certains réseaux de neurones très sur-paramétrés, l’erreur de test se remet même à diminuer après le pic : c’est la double descente, qui bouscule l’intuition classique.
⚠️ Piège Un RSS nul ne dit ni « modèle parfait » ni « modèle inutile » : il dit seulement que le modèle colle aux points qu’il a déjà vus. Pour juger un modèle, calcule l’erreur sur des données qu’il n’a pas vues.
📌 À retenir Le RSS additionne les carrés des écarts entre la réalité et les prédictions : il fonde les moindres carrés, fournit l’estimation du bruit et se retrouve dans les critères pénalisés. Lu sur les points d’entraînement, il ne peut que baisser : un modèle se juge sur des données neuves.