Un modèle réussit son examen de test, puis, quelques mois après sa mise en service, ses prédictions se dégradent sans qu’aucune erreur ne s’affiche. Ce scénario ne tient pas à l’algorithme : il tient à ce qu’on a vérifié, ou non, avant de se lancer. Voici les contrôles à passer, de la colonne qu’il faut remplir jusqu’à la dérive qu’il faut surveiller, et les chemins à prendre quand l’un d’eux échoue.
Sommaire
- L’essentiel en 30 secondes
- Premier contrôle : une colonne à prédire, déjà remplie
- Deuxième contrôle : combien coûte de remplir la colonne
- Troisième contrôle : ton modèle peut-il dire « je ne suis pas sûr » ?
- Quatrième contrôle : le monde reste-t-il le même ?
- Quand un autre chemin est plus malin
- Feu vert, orange, rouge
L’essentiel en 30 secondes
- Il te faut une cible déjà remplie : une colonne à prédire, connue pour des cas passés. Sans elle, il n’y a rien à faire apprendre.
- Remplir la cible a un prix : des spécialistes, ou un modèle de langage qui annote moins cher mais moins fiable.
- Fixe un seuil de certitude : sous 0,7 ou 0,8, la décision passe à un humain.
- Le monde bouge après l’entraînement : surveille la dérive et prévois le réentraînement.
- Si un contrôle échoue, réutilise un modèle préentraîné ou écris un prompt plutôt que de partir de zéro.
Premier contrôle : une colonne à prédire, déjà remplie
Imagine un tableur : une ligne par cas passé, une colonne par variable et, tout à droite, une colonne dont tu voudrais deviner la valeur pour un cas nouveau. C’est la forme exacte d’un problème supervisé : construire un modèle qui prédit ou estime une sortie à partir d’une ou plusieurs entrées.
Efface cette dernière colonne et le problème change de nature. Il ne reste que des entrées, sans sortie à prédire : tu peux encore y chercher des relations et des regroupements, mais plus de modèle supervisé. Le supervisé exploite des données étiquetées, alors que le non supervisé révèle une structure sans étiquette.
Regarde aussi le type de tes colonnes. Qu’une donnée soit structurée ou non, quantitative ou qualitative, cela conditionne directement les méthodes statistiques qui lui sont applicables.
Deuxième contrôle : combien coûte de remplir la colonne
Parfois la cible existe déjà. Souvent il faut la fabriquer, et c’est là que le budget part. Collecter un jeu étiqueté coûte cher et exige, dans plusieurs cas, des spécialistes : pour des scénarios éducatifs, il a fallu un jeu annoté, puis évalué et édité par du personnel spécialisé, des psychologues par exemple.
Autre exemple : pour apprendre à un agent à choisir des produits, on a rassemblé 1,2 million de produits d’un site marchand, bâti un site de commerce simulé, puis enregistré des comportements humains pendant la navigation. Le jeu d’entraînement est né de ces traces.
Une alternative consiste à confier l’étiquetage à un modèle de langage. C’est un compromis entre qualité et coût : le jeu est moins bon que celui annoté par des humains, mais il coûte beaucoup moins. Plus de 16 000 interfaces de programmation réelles ont ainsi été annotées avec ChatGPT, puis un modèle ajusté sur ce jeu est devenu bien plus performant dans leur usage.
| Qui remplit la colonne | Ce que tu gagnes | Ce que tu risques |
|---|---|---|
| Des humains, parfois spécialistes | précision, nuances, fiabilité | coût élevé ; annotateurs à sélectionner pour éviter une qualité inégale |
| Un modèle de langage | coûts très réduits, couverture plus large, itération plus rapide | précision, nuances et fiabilité moindres, donc performance affectée |
| Un modèle pour le gros du travail, des humains pour valider | équilibre entre qualité et coût | les enjeux élevés restent à la charge des humains |
Compte aussi la qualité du jeu. Il doit mêler des tâches, des sujets, des contextes, des longueurs et des styles variés ; ses exemples doivent être corrects ; et il lui faut des cas simples pour apprendre la structure, mais aussi des cas difficiles, à raisonnement en plusieurs étapes. Sans gouvernance rigoureuse ni tests sur données réservées, tu risques de surajuster à des exemples périmés ou peu représentatifs.
Troisième contrôle : ton modèle peut-il dire « je ne suis pas sûr » ?
Un modèle supervisé répond toujours. Pour les cas à fort enjeu, il faut donc décider à l’avance quand il ne tranche pas seul. On y intègre un score de certitude et un seuil : on escalade vers un humain si la certitude passe sous 0,7. Dans un exemple de tri de menaces, les classements dont le score est inférieur à 0,8 sont escaladés automatiquement, ce qui filtre les cas de routine à forte confiance.
D’autres signaux d’incertitude existent : la variance sur plusieurs exécutions (de trois à cinq inférences, escalade si les sorties divergent de plus de 20 %) ou un modèle critique secondaire qui note la cohérence. Pour les conséquences lourdes, on multiplie l’incertitude par la gravité et on escalade au-delà d’un seuil.
Les critères d’escalade les plus nets sont :
- des erreurs persistantes sans explication technique claire ;
- des anomalies dans des flux à implications réglementaires ou éthiques ;
- des échecs dans des tâches critiques ou de grande valeur ;
- des diagnostics contradictoires venant d’outils automatisés.
⚠️ Piège Un seuil trop bas noie les humains. Les seuils s’optimisent hors ligne à partir de données historiques, en simulant les taux d’escalade, avec une cible de moins de 10 % de cas escaladés pour éviter la fatigue.
Quatrième contrôle : le monde reste-t-il le même ?
Un modèle entraîné fige une photographie. Or les propriétés statistiques de l’environnement évoluent : le langage des utilisateurs change, une nouvelle terminologie de produit apparaît, les réponses d’une interface se modifient, un modèle de fondation est mis à jour. On parle de décalage de distribution.
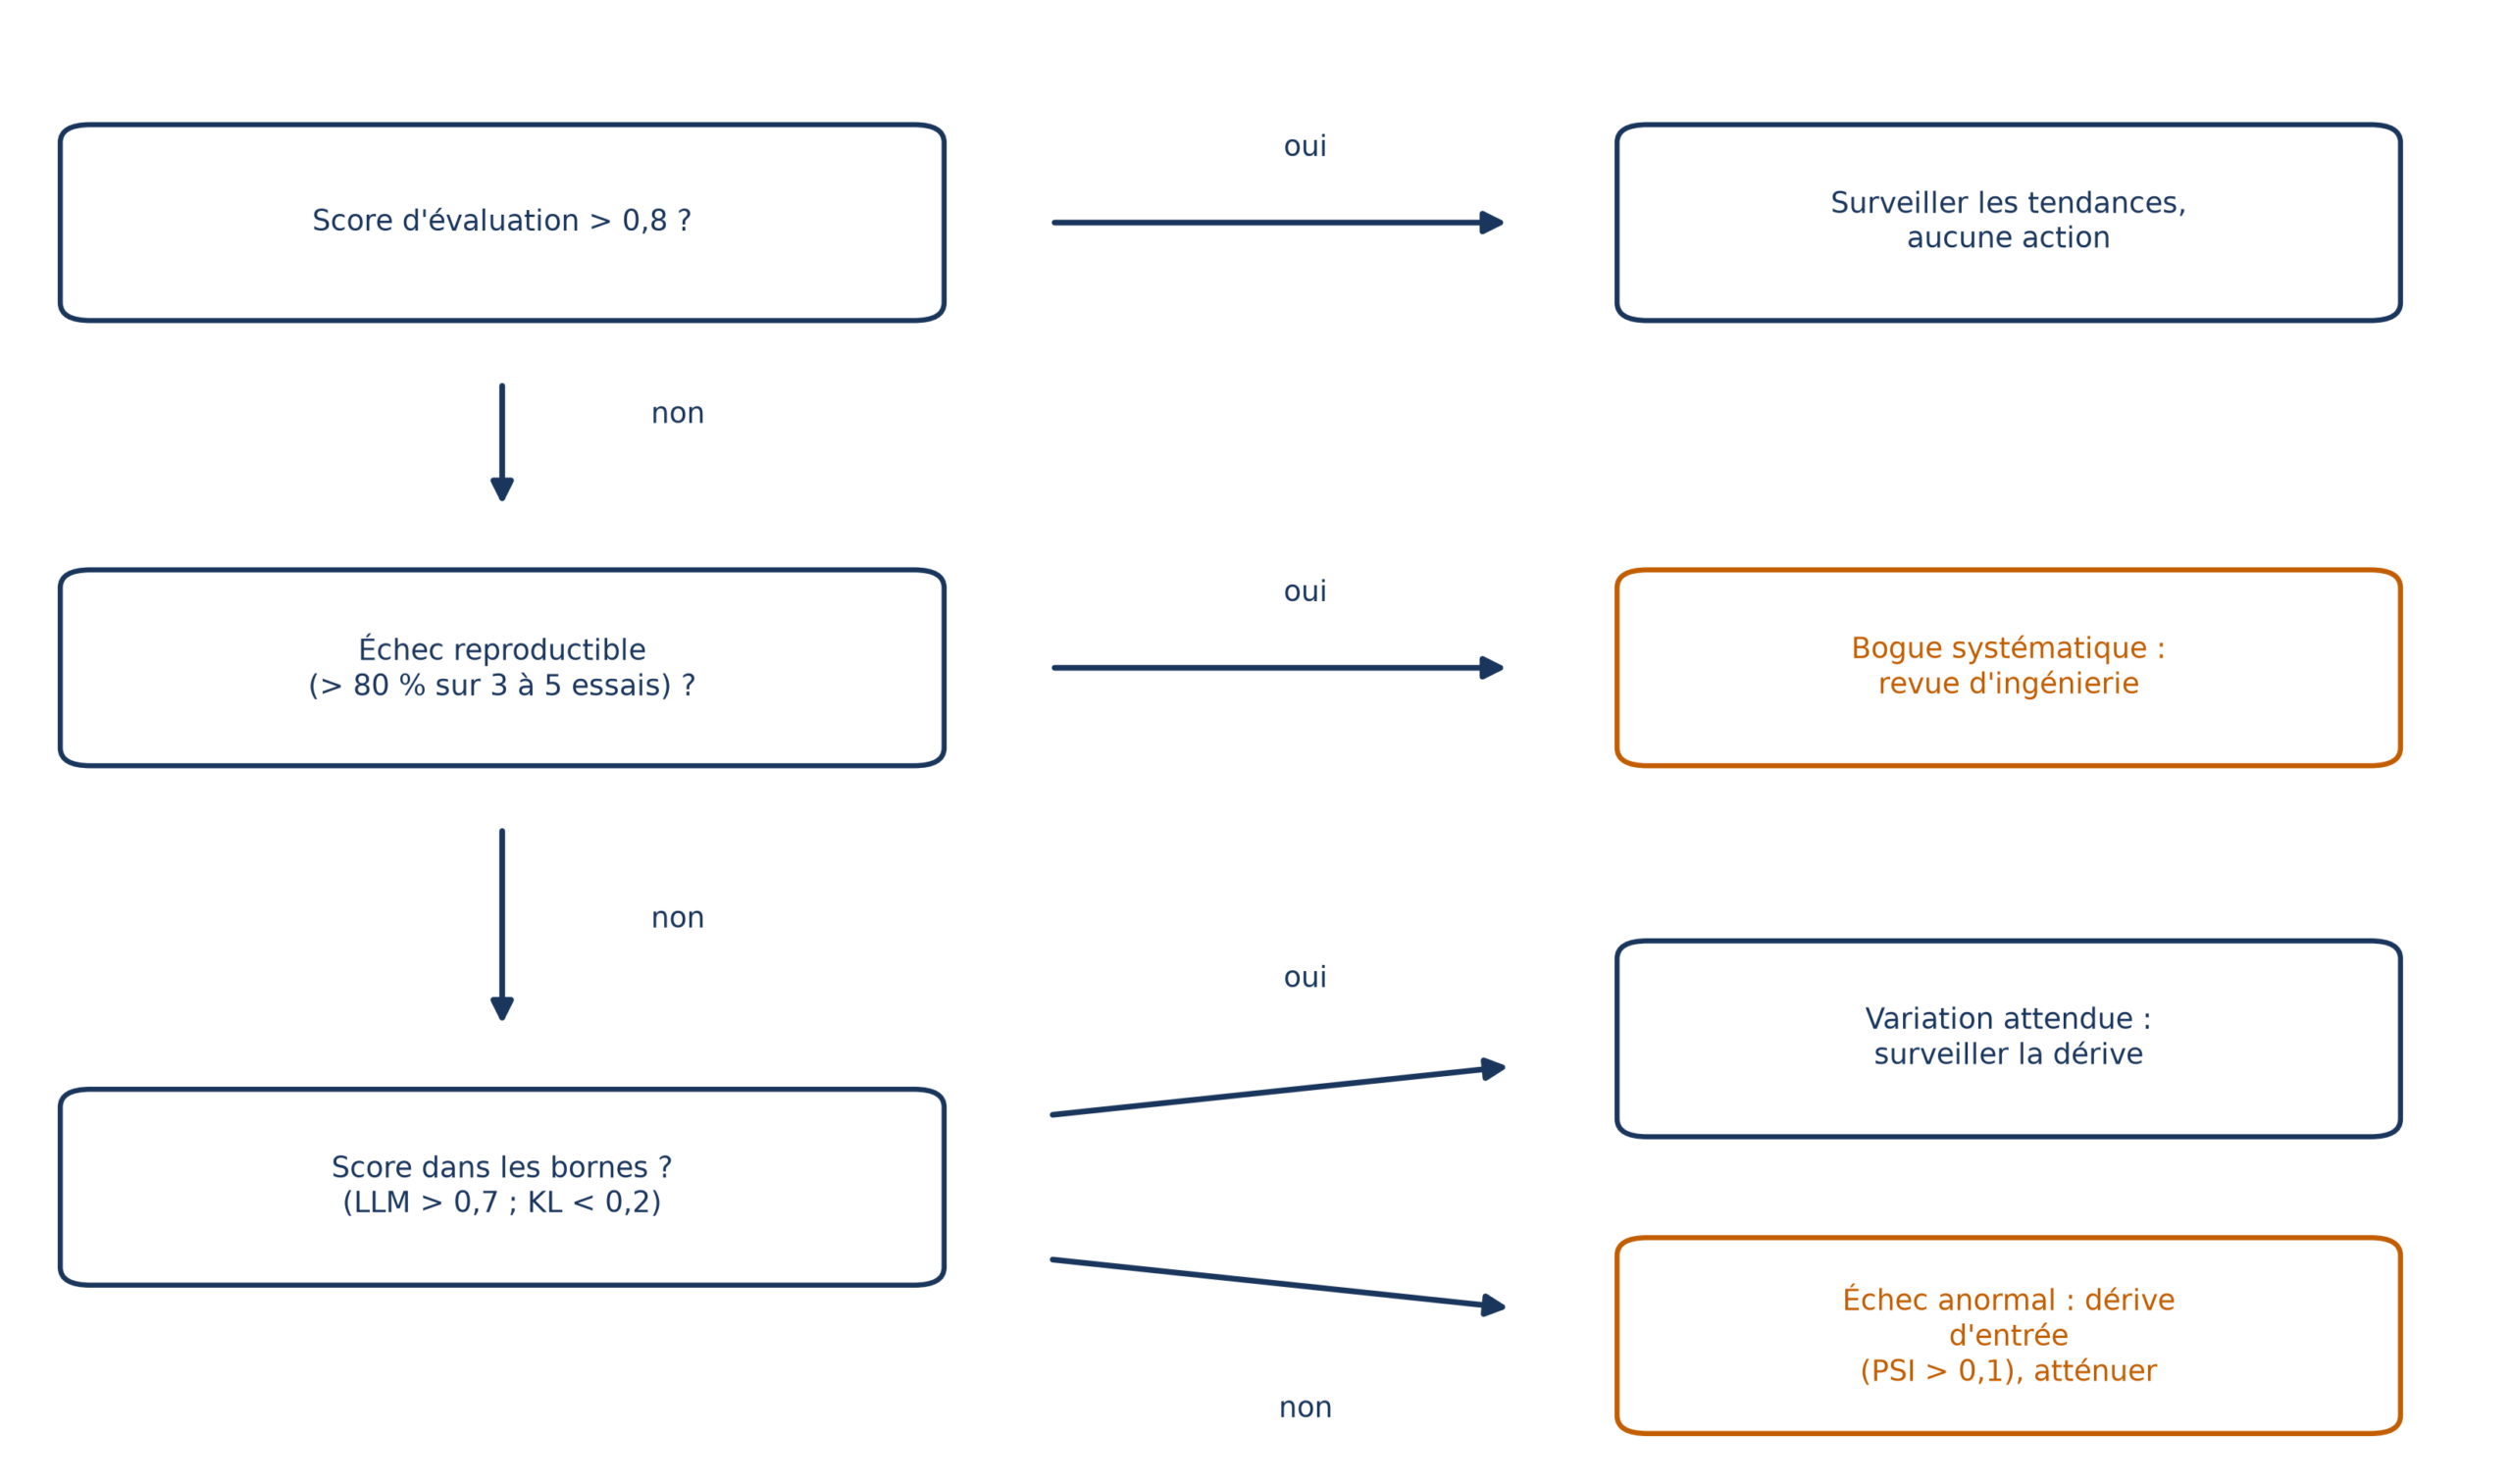
Il ne déclenche pas forcément d’erreur explicite. Il se manifeste par une performance dégradée, des sorties mal alignées ou un recours accru aux solutions de repli. Avant la mise en service, teste donc sur des scénarios nouveaux, hors distribution : jeux réservés, exemples synthétiques, cas adverses construits pour défier les réponses mémorisées, et décalages simulés.
Mesurer l’écart
On compare un échantillon historique à un échantillon courant avec le test de Kolmogorov-Smirnov. Il confronte les fonctions de répartition empiriques des deux jeux et retient leur distance verticale maximale, sans supposer de normalité. Une statistique supérieure à 0,1, souvent associée à une valeur-p inférieure à 0,05, signale une divergence significative et déclenche l’alerte de dérive.
Trier les échecs
Face à une sortie décevante, trois questions successives disent s’il s’agit d’un bogue, d’une variation normale ou d’une dérive.
Prévoir le réentraînement
La réponse au décalage est de réentraîner hors ligne, en trois étapes : rassembler et étiqueter des exemples issus de la production en veillant à leur diversité et à leur équilibre, mettre le modèle à jour, puis le valider contre des références avant de le déployer.
Cette routine apporte de la durabilité, du passage à l’échelle et une réduction du risque, puisque tout se teste hors ligne. Elle réclame en revanche une gestion attentive : il faut éviter le surajustement aux données historiques et l’oubli des tendances émergentes. Son coût de calcul s’atténue avec des méthodes comme LoRA, et elle suppose un calendrier périodique.
Quand un autre chemin est plus malin
Sans cible, c’est le terrain du non supervisé ; avec des décisions qui s’enchaînent et un verdict tardif, celui du renforcement. Deux autres chemins se contentent de réutiliser ce qui existe déjà.
Ne réentraîner que la dernière couche
Un modèle préentraîné de type Transformer n’a pas été entraîné à classer des séquences. Pour l’adapter, on retire sa dernière couche, propre à la tâche d’origine, on en ajoute une nouvelle initialisée au hasard et on réunit des exemples pour la nouvelle tâche.
Chaque exemple (ici, des avis positifs et négatifs) traverse le modèle gelé en passe avant, et seuls les poids de la nouvelle couche sont mis à jour par rétropropagation, avec l’entropie croisée. Un tout petit ajustement du reste, avec un taux d’apprentissage très faible, peut même améliorer le résultat. Avec Hugging Face, quelques lignes de code suffisent pour ajuster DistilBERT.
Peut-être rien à entraîner
De nombreux développeurs se contentent de l’ingénierie de prompt, sans réentraînement. La connaissance nécessaire existe déjà dans les paramètres du modèle ; il s’agit d’écrire un prompt qui lui permette de s’en servir au mieux.
Feu vert, orange, rouge
Classe ton projet contrôle par contrôle.
| Contrôle | Feu vert | Feu orange | Feu rouge |
|---|---|---|---|
| Cible | colonne remplie pour des cas passés | étiquettes produites par un modèle de langage, à valider | pas de colonne à prédire |
| Coût des étiquettes | jeu déjà disponible | humains pour valider, modèle pour le volume | spécialistes introuvables, exemples périmés |
| Cas à fort enjeu | seuil de certitude fixé, moins de 10 % d’escalades | seuil non calibré sur l’historique | le modèle tranche seul sur des tâches critiques |
| Stabilité | écart de distribution sous 0,1 | tests hors distribution encore à faire | écart au-dessus de 0,1 et valeur-p sous 0,05 |
| Réentraînement | calendrier et validation prévus | calendrier sans validation hors ligne | aucun plan |
Un feu rouge ne ferme pas la porte : il te dit où chercher, du côté d’un modèle préentraîné, d’un simple prompt ou d’une autre famille de méthodes. Et un tableau tout vert reste provisoire, car la dérive se mesure sur la durée, pas le jour du lancement.